EP57. 突破計算瓶頸:存算一體 (Compute-in-Memory) 技術解析
EP57. 突破計算瓶頸:存算一體 (Compute-in-Memory) 技術解析
- Source: Ted Yu
- Published: 2026-08-12T08:03:16+08:00
- URL: https://ytyuted.substack.com/p/ep57-compute-in-memory
中文翻譯與英文原文(雙語)
(1) EP57. 突破計算瓶頸:存算一體 (Compute-in-Memory) 技術解析 - Ted Yu
Pledge your support

EP57. 突破計算瓶頸:存算一體 (Compute-in-Memory) 技術解析

Aug 12, 2026
當前人工智慧與高效能運算領域正面臨兩大核心技術限制:「記憶體之牆 (Memory Wall)」與「能源效率問題 (Efficiency Problem)」。隨著 AI 模型的運算量呈現指數型攀升,動態隨機存取記憶體 (DRAM) 頻寬的成長速度已無法跟上,導致處理器必須耗費大量時間等待資料載入。此外,傳統馮·紐曼架構中「資料搬運」所產生的能耗遠大於「運算」本身,成為系統功耗急劇上升的根本物理限制。為了解決巨量資料移動造成的瓶頸,「存算一體(Compute-in-Memory,CIM)」技術應運而生。基於 Prof. J. Kulkarni 在 ISSCC26 的演講《Fundamentals of Compute-in-Memory: From Circuits to Systems》,本文將介紹CIM如何將運算功能直接內建於記憶體中,藉由消除記憶體與運算單元間的界線,大幅減少資料傳輸並提升能源效率與運算頻寬,進而探討其技術原理與系統級應用。
1. 背景知識
1.1. 記憶體之牆與能源效率問題
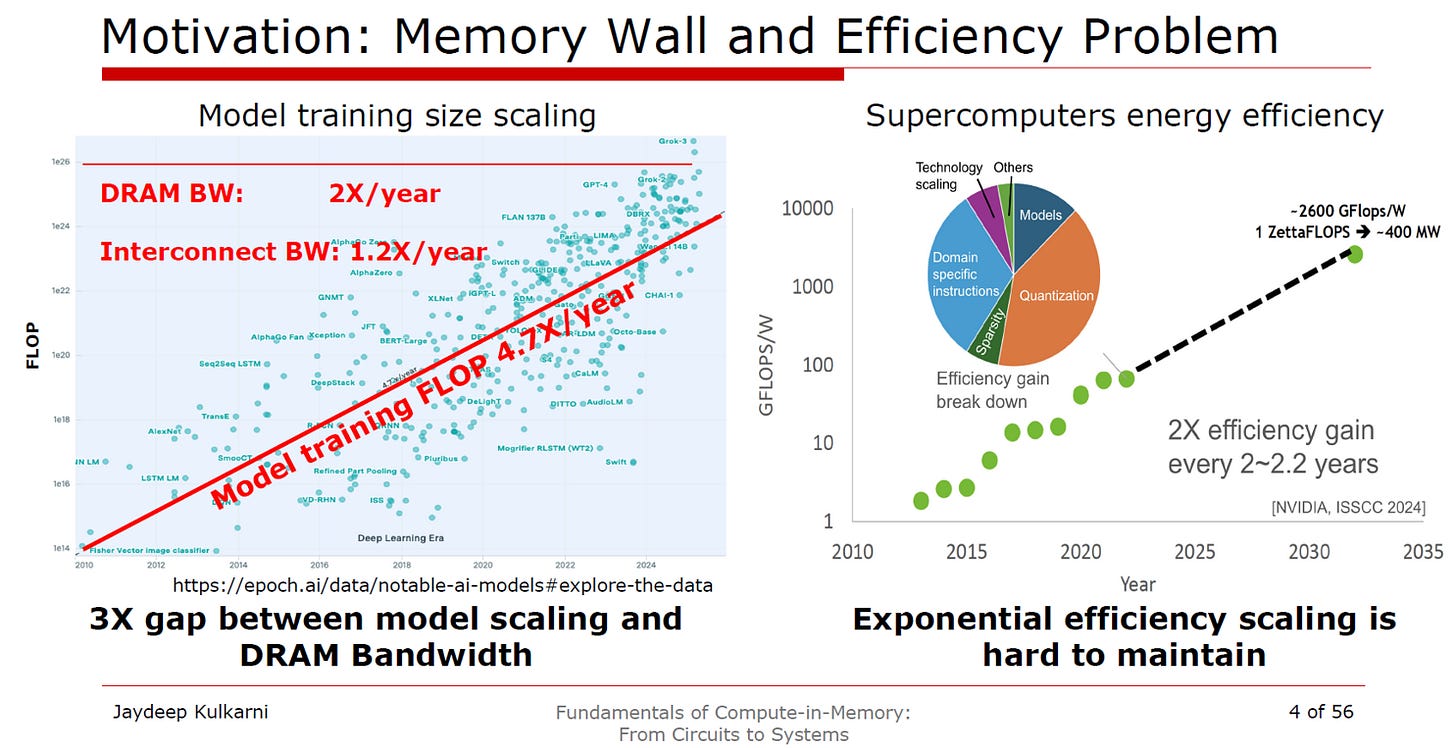
目前人工智慧與高效能運算領域面臨的兩大核心技術限制:記憶體之牆 (Memory Wall) 與能源效率問題 (Efficiency Problem)。
source: Prof. J. Kulkarni, ISSCC26
記憶體之牆 (Memory Wall)
運算需求高速成長:AI 模型的訓練運算量 (FLOP) 呈現指數型攀升,每年約以4.7倍的速率增加。
硬體頻寬成長受限:動態隨機存取記憶體頻寬 (DRAM BW) 每年僅成長 2 倍,而互連頻寬 (Interconnect BW) 每年僅成長 1.2 倍。
效能瓶頸成形:這種不對等的發展速度,導致模型規模擴展與 DRAM 頻寬之間產生了 3 倍的發展差距 (3X gap)。
這表示處理器的運算能力遠超過資料從記憶體傳輸至運算單元的速度,運算核心必須耗費大量時間等待資料載入,導致整體系統效能受限,此現象即為「記憶體之牆」。
能源效率問題 (Efficiency Problem)
圖表探討了每瓦效能 (GFLOPS/W) 上的發展困境:
歷史效率提升的來源:過去AI系統的能源效率大約每 2 到 2.2 年可提升2 倍。圓餅圖指出,這些效率增益主要來自於技術層面的多管齊下,包含:稀疏性 (Sparsity)、領域特定指令 (Domain specific instructions)、量化技術 (Quantization)、模型最佳化 (Models) 以及半導體製程微縮 (Technology scaling)。
功耗擴展的挑戰:儘管有上述技術加持,但要長期維持指數型的能源效率提升非常困難 (Exponential efficiency scaling is hard to maintain)。圖中引用 NVIDIA 於 ISSCC 2024 的資料預測,若系統運算力要達到1 ZettaFLOPS,即使在2600 GFlops/W的高能源效率下,整個系統仍將消耗約400 MW的龐大電力。這凸顯了在現有馮·紐曼架構下,供電與散熱將成為擴展AI 叢集規模的硬性阻礙。
傳統運算架構中「運算」與「資料搬運」之間的能耗巨大落差,這正是導致「傳輸頻寬不足」與「系統功耗急劇上升」現象的根本物理限制。

圖表的 Y 軸使用的是對數座標(Logarithmic scale),展示了不同元件進行一次存取或運算的「正規化能耗(Normalized Energy)」
核心數據解析
運算操作本身的能耗極低:藍色柱狀圖顯示,執行一次 64-bit 浮點運算(Floating Point)的正規化能耗僅為2.5。
晶片內記憶體(On Die Memory)存取效率高:綠色柱狀圖顯示,存取最靠近運算單元的暫存器檔案(Register File)和 L1 快取(L1 Cache),能耗分別只有1和1.5,比浮點運算還要節能。即使是稍微遠一點的 L2 快取,能耗為17.5,仍在相對較低的範圍。
外部記憶體(DRAM)存取代價高昂:黃色柱狀圖顯示,當晶片需要向外部 DRAM 讀取或寫入資料時,能耗瞬間飆升至256。這表示從 DRAM 搬運一次資料的耗能,大約是執行一次浮點運算的 100 倍。
資料移動(Data Movement)是系統最大的能耗來源:紅色柱狀圖揭示了資料在不同物理距離移動的巨大代價。晶片間相鄰傳輸(Off Die Neighbour)的能耗高達826,而透過外部交換器傳輸(Off Die switch)的能耗更是達到驚人的1879。
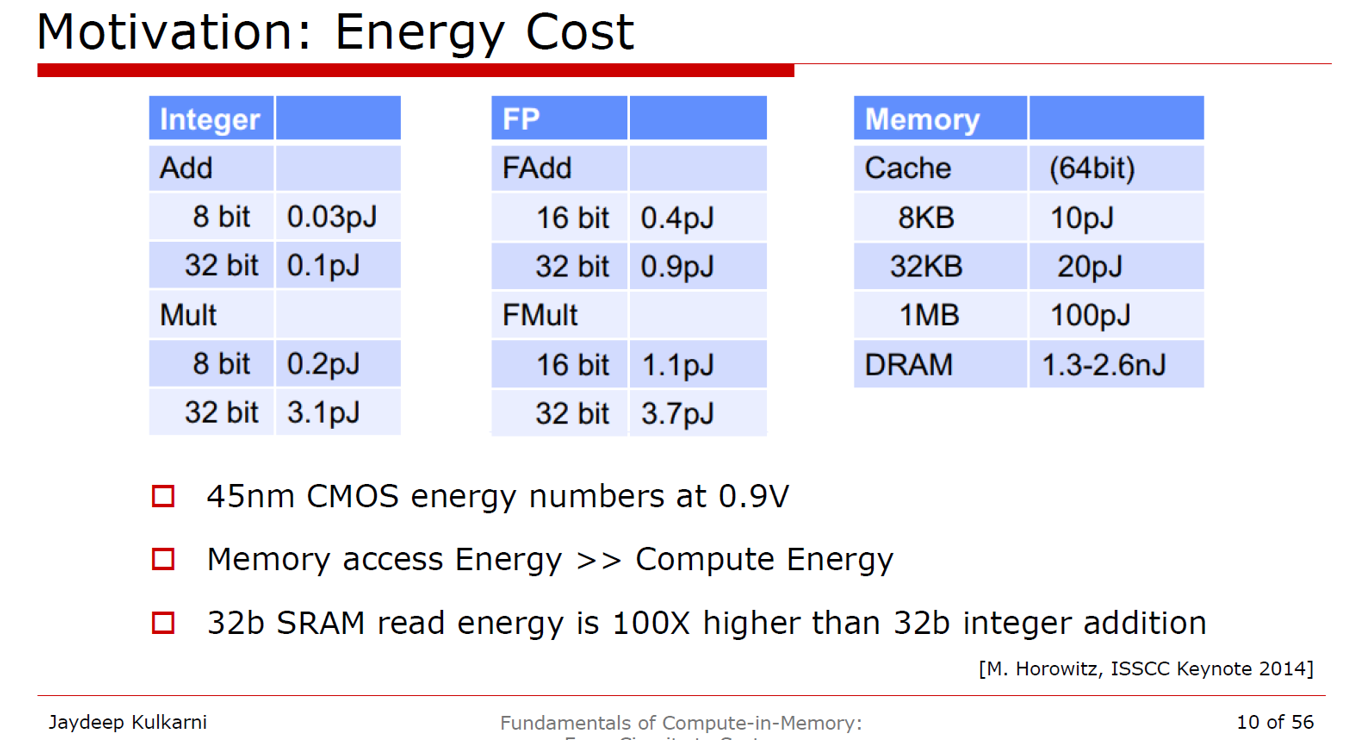
基於45nm CMOS工作電壓為0.9V量測數據說明:
source: Prof. J. Kulkarni, ISSCC26
運算操作能耗極低:執行純邏輯或數學運算的耗能多在個位數 pJ 以下。例如,一次 32-bit 整數加法 (Integer Add) 僅需 0.1pJ,而 32-bit 浮點加法 (FP FAdd) 僅需 0.9pJ。
晶片內記憶體存取能耗顯著增加:隨著快取 (Cache) 容量與物理距離增加,資料搬移成本隨之上升。讀取 64-bit 資料時,8KB 快取需 10pJ,1MB 快取則需 100pJ。32-bit SRAM 讀取的能耗是 32-bit 整數加法的100 倍。
外部記憶體 (DRAM) 存取耗能最為劇烈:存取 DRAM 的能耗高達 1.3 至 2.6 nJ (等同於 1300 至 2600 pJ)。
Memory access Energy >> Compute Energy:若將 DRAM 的存取能耗 (1300 至 2600 pJ) 與 32-bit 浮點加法 (0.9 pJ) 相比,從外部記憶體搬運一次資料的能耗,高達執行該次運算的千倍以上。
結論:為何會產生頻寬瓶頸與功耗危機?
功耗急劇上升的主因是「資料搬運」,而非「運算」:在處理龐大的現代 AI 模型時,系統需要頻繁地將海量的參數與資料從外部 DRAM 搬移到晶片內的運算核心。由於這段「Off Die」與「DRAM」存取的能耗極高,導致整個系統絕大多數的電力與廢熱,都產生於資料在線路上的來回移動,而不是產生於真正有價值的邏輯運算上。
頻寬擴展的物理極限(記憶體之牆):為了解決運算單元處理速度過快、只能閒置等待資料傳入的問題,硬體設計必須不斷提升 DRAM 到晶片的傳輸頻寬。但在傳統架構下,大幅提升頻寬就意味著必須在單位時間內進行更多次高耗能的「資料移動(Data Movement)」。這會直接推升系統的整體功耗,並帶來嚴峻的供電與散熱挑戰,導致頻寬無法無限制地向上擴展。
在資料主導的高效能運算時代,資料搬移的成本已經遠大於運算本身。這也是為何先進封裝(如 CoWoS 縮短晶片間距)或是存算一體(Compute-in-Memory)等新技術,成為產業界突破此瓶頸的關鍵發展方向。
1.2. Compute-In-Memory(存算一體)
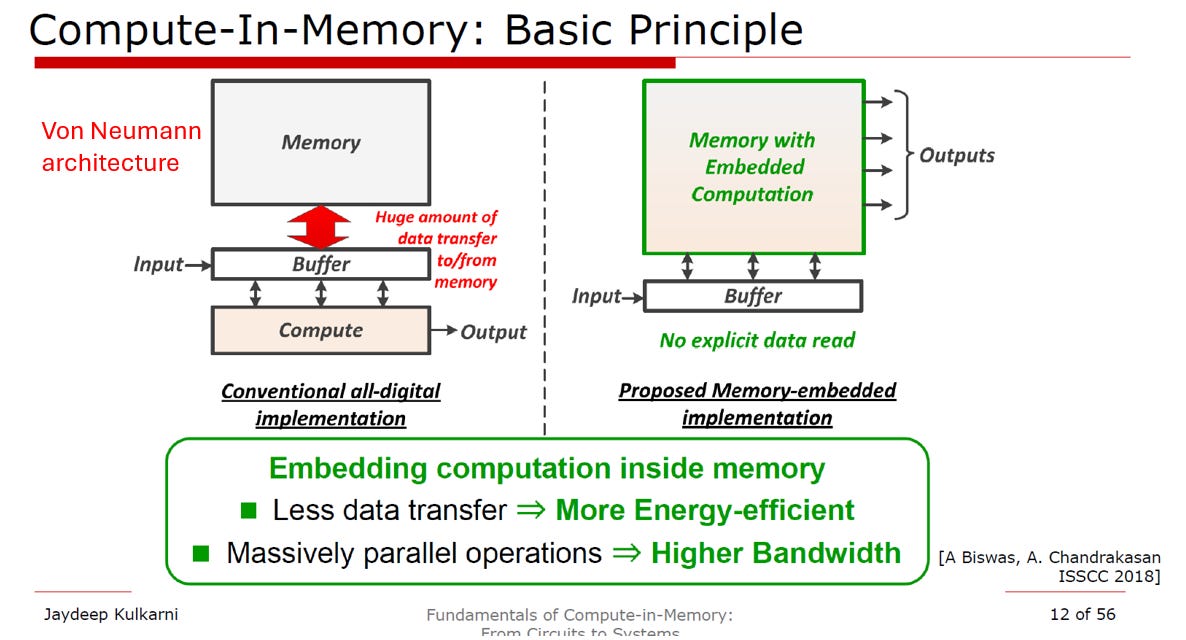
傳統馮·紐曼架構與存算一體 (CIM) 比較
source: Prof. J. Kulkarni, ISSCC26
傳統架構 (Conventional all-digital implementation):在此架構中,記憶體 (Memory) 與運算單元 (Compute) 是完全分離的硬體區塊。運算時,系統必須透過緩衝區 (Buffer) 在記憶體與運算單元之間進行「大量的資料傳輸 (Huge amount of data transfer to/from memory)」。這正是造成高能耗與傳輸延遲的主因。
存算一體架構 (Memory-embedded implementation):CIM 架構則是將運算功能直接內建於記憶體中 (Memory with Embedded Computation)。在這種設計下,系統不需進行明確的資料讀取動作 (No explicit data read) 來將資料搬移至外部運算單元,而是直接由記憶體端輸出運算結果。
將運算功能嵌入記憶體內部可帶來兩大核心優勢:
更高的能源效率 (More Energy-efficient):因為大幅減少了資料的搬移與傳輸 (Less data transfer)。
更高的頻寬 (Higher Bandwidth):記憶體陣列的特性允許系統執行大規模的平行運算 (Massively parallel operations)。
以記憶體為中心的運算架構演進過程
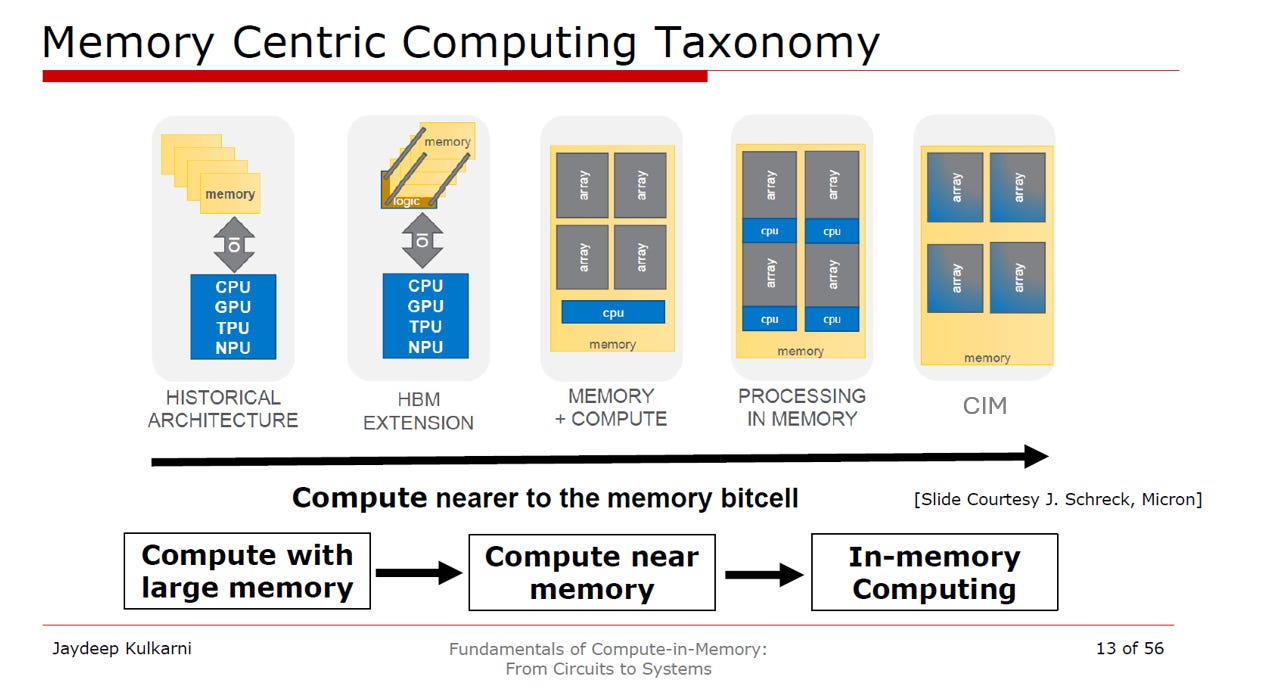
為了克服資料移動造成的瓶頸,運算架構的發展趨勢是讓「運算越來越靠近記憶體位元單元 (Compute nearer to the memory bitcell)」
source: Prof. J. Kulkarni, ISSCC26
階段一:與大型記憶體協同運算 (Compute with large memory)
歷史架構 (Historical Architecture):傳統的 CPU、GPU、TPU 或 NPU 透過標準 I/O 介面與外部記憶體連接,兩者物理距離最遠。
HBM 擴充 (HBM Extension):採用高頻寬記憶體技術,將記憶體晶片與基礎邏輯層堆疊,縮短了與運算處理器的實體距離,但本質上運算與記憶體仍是分開的。
階段二:近記憶體運算 (Compute near memory)
記憶體加運算 (Memory + Compute):將 CPU 等運算單元與記憶體陣列整合在更緊密的封裝或同一晶片基礎上。
記憶體內處理 (Processing in Memory, PIM):進一步將 CPU 運算單元分散並交錯配置於記憶體陣列 (array) 之間,使運算邏輯極度靠近資料儲存區。
階段三:記憶體內運算 (In-memory Computing)
存算一體 (CIM):演進的最終型態,直接由記憶體陣列 (array) 本身執行運算工作,徹底消除了記憶體與運算單元之間的界線。在技術實作上,主要分為類比存算一體 (Analog CIM, ACIM) 與數位存算一體 (Digital CIM, DCIM) 兩大發展路徑。
CIM 與數位加速器 (Digital Accelerator) 的比較
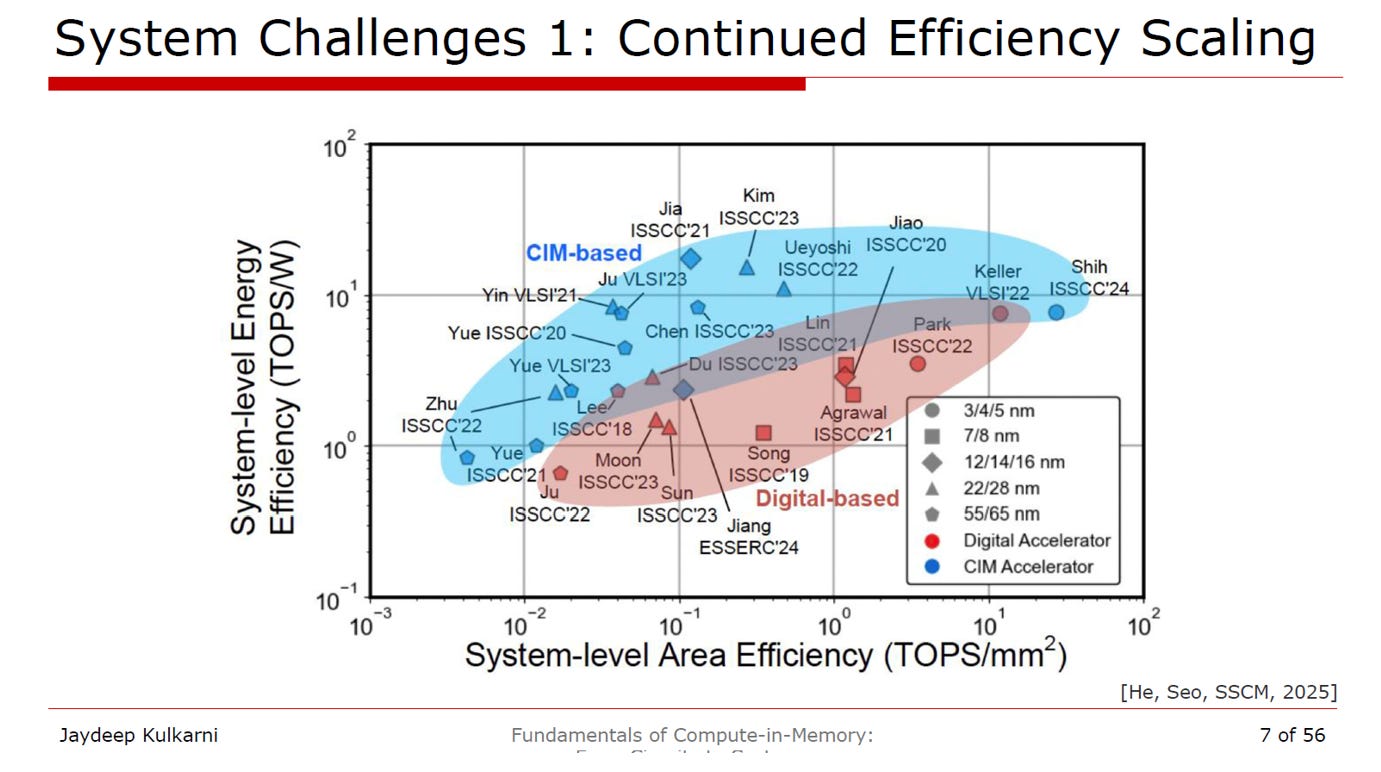
source: Prof. J. Kulkarni, ISSCC26
系統級能源效率 (System-level Energy Efficiency):基於 CIM 的加速器 (CIM-based) 在每瓦效能 (TOPS/W) 上的表現普遍優於數位加速器 (Digital-based)。大部分的數位加速器其能源效率集中在較低的區間 (多低於10 TOPS/W),而多數 CIM 加速器則分佈在 10 到100 TOPS/W的高能源效率藍色區塊內。
製程微縮與效率發展:該圖表統計了從 65nm 到先進的 3/4/5nm 製程在多項國際研討會 (如 ISSCC, VLSI) 的發表成果。數據客觀顯示,在追求更高的系統級面積效率 (TOPS/mm2) 與能源效率的雙重指標下,CIM 架構提供了比傳統數位架構更佳的擴展潛力與能耗優勢。
1.3. 存算一體的應用
LLM 推論解碼階段的記憶體限制
在大型語言模型 (基於 Transformer 架構) 的運作中,矩陣乘法 (Matrix multiplication) 是最常見的運算操作。在推論的解碼階段 (Token generation stage),系統需要處理長序列並儲存龐大的KV Cache。
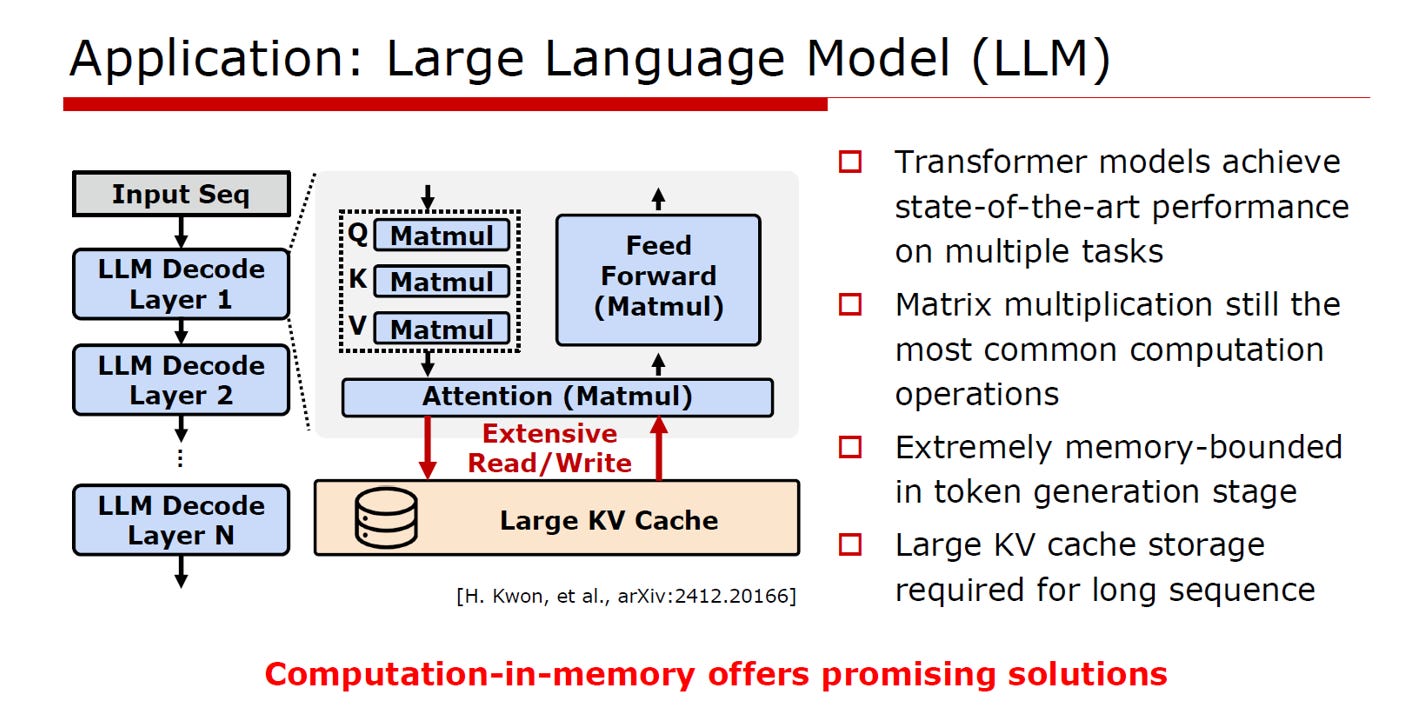
source: Prof. J. Kulkarni, ISSCC26
記憶體瓶頸 (Memory-bounded):運算單元必須與大型KV Cache之間進行極大量的讀寫操作 (Extensive Read/Write)。這導致系統在此階段受到嚴重的記憶體頻寬限制,成為效能瓶頸。
CIM 的優勢:存算一體 (Computation-in-memory) 架構被視為解決此大量資料搬移問題的有效方案。
CIM 處理 QKV 矩陣運算 (以數位存算一體為例)
在 Transformer 模型的推論過程中,生成Query (Q)、Key (K)、Value (V)向量的投影矩陣屬於靜態的模型權重。若硬體容量允許,CIM 架構會將這些資料常駐於記憶體中,其處理機制如下:
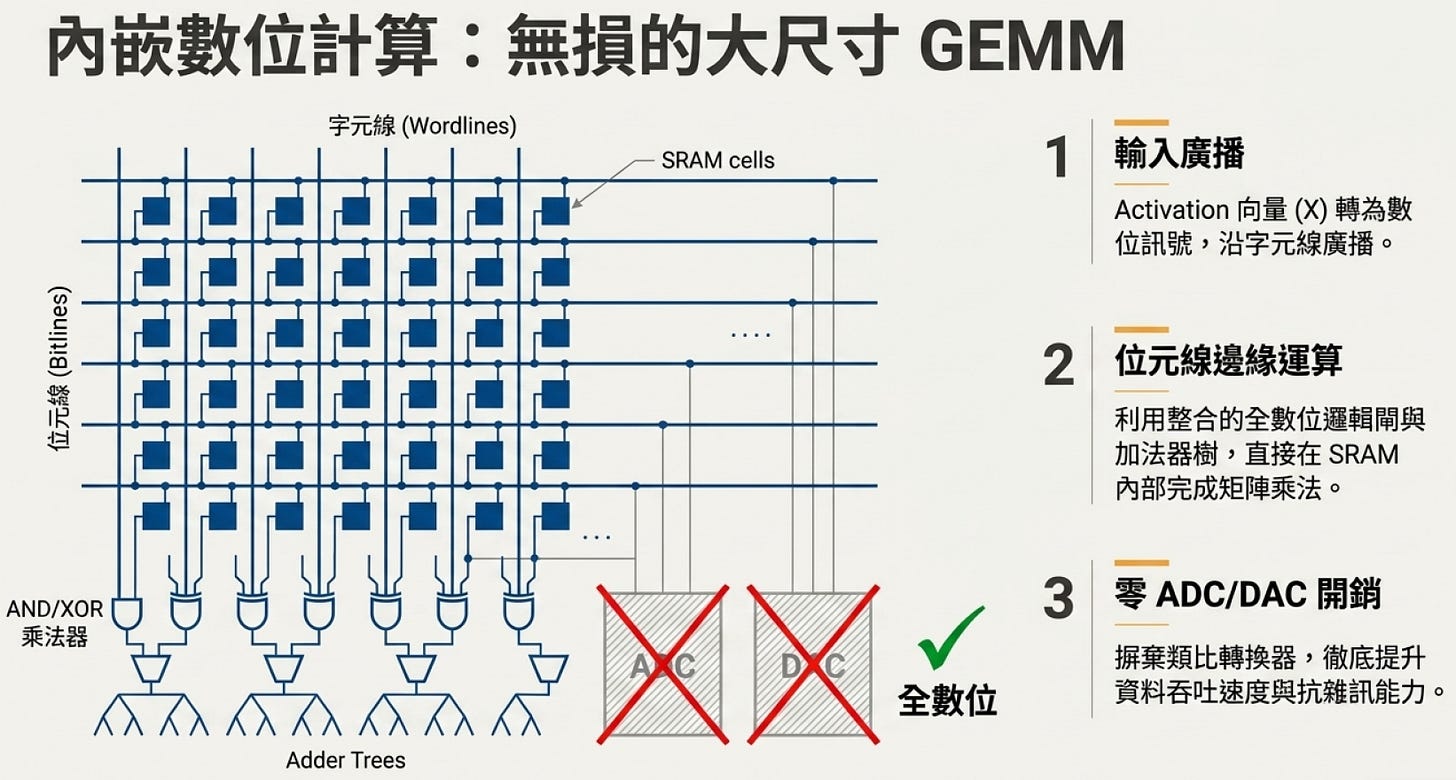
全數位內嵌計算 (Digital CIM):根據數位 CIM 架構設計,系統可利用整合在 SRAM 內部的全數位邏輯閘(如 AND/XOR 乘法器)與加法器樹 (Adder Trees),直接在位元線 (Bitlines) 邊緣完成矩陣乘法運算。
消除資料搬運:當前步驟的輸入向量 (Activation X) 會轉換為數位訊號,並沿著字元線 (Wordlines) 向陣列廣播。這意味著不需要將龐大的權重資料頻繁讀出,徹底消除了 Weight 讀取的記憶體頻寬牆 (Memory Wall)。
零類比轉換開銷:這種全數位設計摒棄了類比轉換器 (ADC/DAC),大幅提升了資料吞吐速度與抗雜訊能力,實現無損的大尺寸通用矩陣乘法 (GEMM)。
CIM 處理注意力機制 sm(QKT)V
在字詞生成階段 (Token generation stage),注意力機制的運算是極度受限於記憶體頻寬的 (Extremely memory-bounded),因為它需要對大型 KV Cache 進行大量的讀寫操作 (Extensive Read/Write)。CIM 針對此機制的解決方案如下:
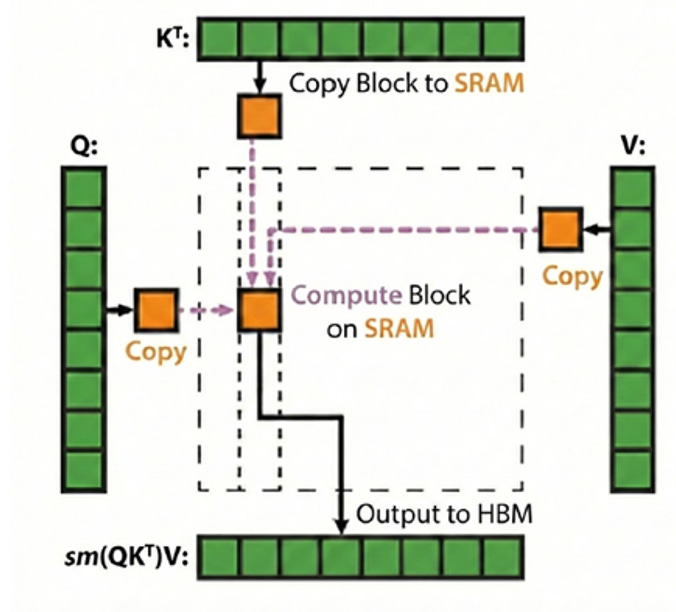
SRAM 原地運算:系統會將 Q、KT以及 V 的資料分塊 (Block) 複製並載入到 SRAM 的運算區塊 (Compute Block) 中。
降低外部 I/O:Q 與 KT的乘法、Softmax(sm)轉換,以及後續與 V 的乘法,皆直接在該 SRAM 運算區塊內部完成。
結果輸出:最終完成的sm(QKT)V運算結果才會被輸出回高頻寬記憶體 (Output to HBM)。此流程將巨量的歷史資料傳輸轉化為內部計算,大幅減輕了系統匯流排的負擔。
Weight vs. KV Cache 雙軌體系對比
為了最大化效能,CIM 系統會針對「權重」與「KV 快取」的不同屬性,採用雙軌的處理機制:

2. Analgo CIM(ACIM)
2.1. ACIM的簡介
ACIM 架構 (Architecture)
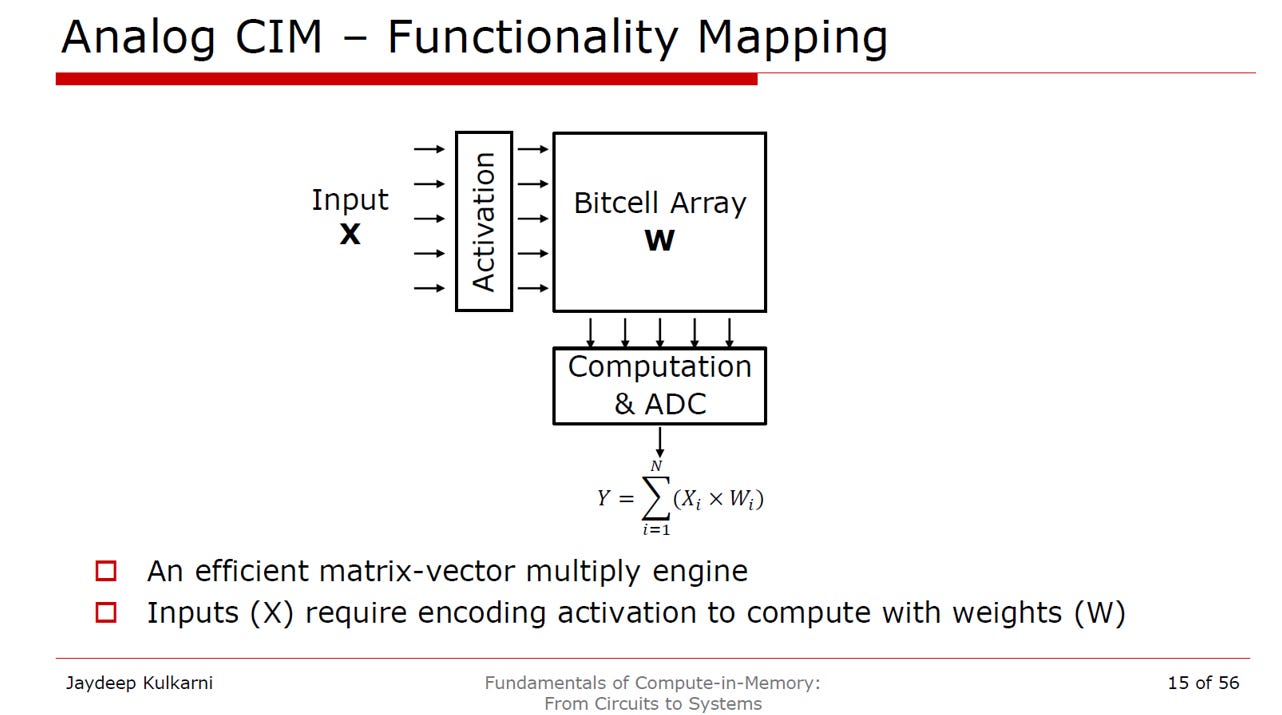
類比存算一體 (ACIM) 被定位為一個高效率的矩陣與向量乘法引擎。
source: Prof. J. Kulkarni, ISSCC26
系統硬體架構主要包含輸入端 (Input X)、儲存模型權重的位元單元陣列 (Bitcell Array W),以及後端的計算與類比數位轉換模組 (Computation & ADC)。
輸入資料 (X) 在與權重 (W) 進行運算前,必須先經過編碼或激發 (Activation) 程序的處理。
系統的最終輸出結果 (Y) 等同於所有輸入值與對應權重乘積的總和,即 Y = 總和(Xi * Wi)
ACIM Example: Ohm's law and Kirchhoff's law
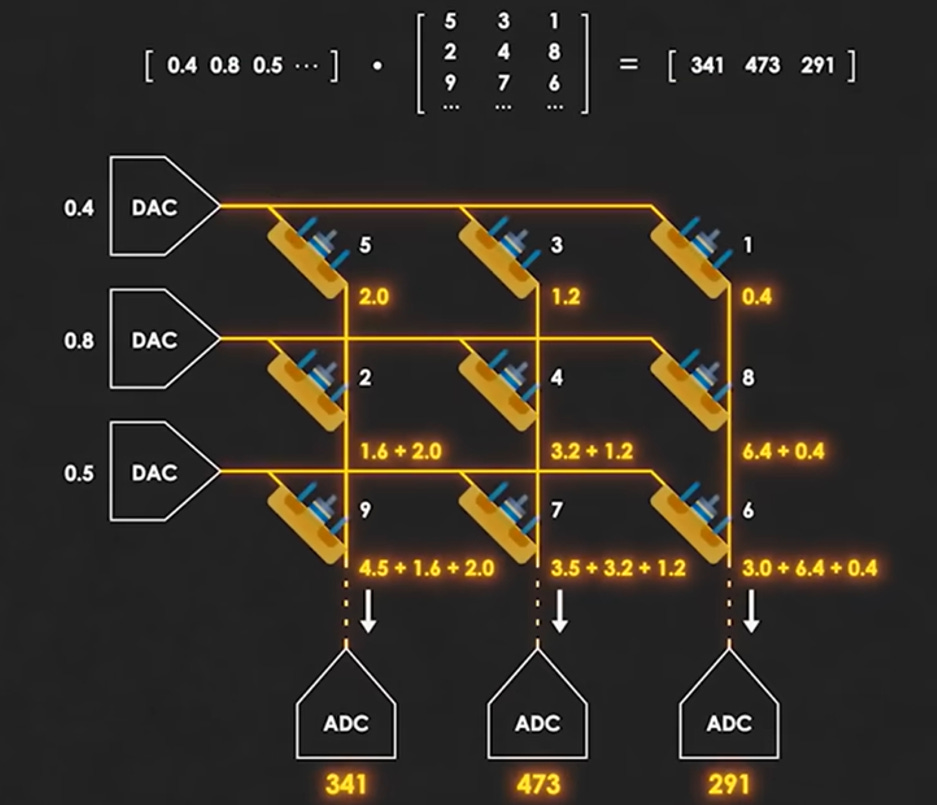
在硬體執行矩陣運算時,數位類比轉換器 (DAC) 會將輸入的數值轉換為電壓訊號傳遞至陣列中。
記憶體陣列內的單元負責儲存矩陣權重數值,並在電路中表現為特定的電導值。
歐姆定律 (Ohm’s law) 應用:單一節點的乘法是透過輸入電壓與單元電導相乘產生對應的電流來完成,例如輸入 0.4 乘上權重 5,在該節點產生 2.0 的電流值。
克希荷夫電流定律 (Kirchhoff’s law) 應用:陣列中同一垂直線上的電流會匯集並自然進行物理加總,例如將 4.5、1.6 與 2.0 的電流值相加。
加總完成的類比電流訊號,最終會流入類比數位轉換器 (ADC),將結果轉回數位數值輸出。
ACIM 種類 (Devices for Weight Storage)
ACIM 使用的權重儲存載體主要分為「電荷基礎記憶體 (Charge-based memory)」與「電阻基礎記憶體 (Resistance-based memory)」兩大類別。

source: Prof. J. Kulkarni, ISSCC26
電荷基礎記憶體包含SRAM、DRAM 與 Flash記憶體,此類載體通常採用電荷域 (Charge-domain)、電流域 (Current-domain) 或是數位運算方法。
電阻基礎記憶體包含RRAM、PCM 與 STT-MRAM記憶體,此類載體主要採用電流域運算方法。
在數學式的對應上,電荷域運算的總和 Y 表現為電壓變化量 (∆Vi) 的總和;而電流域運算的總和 Y 則表現為電流 (Ii) 的總和。
2.2. ACIM的運作機制
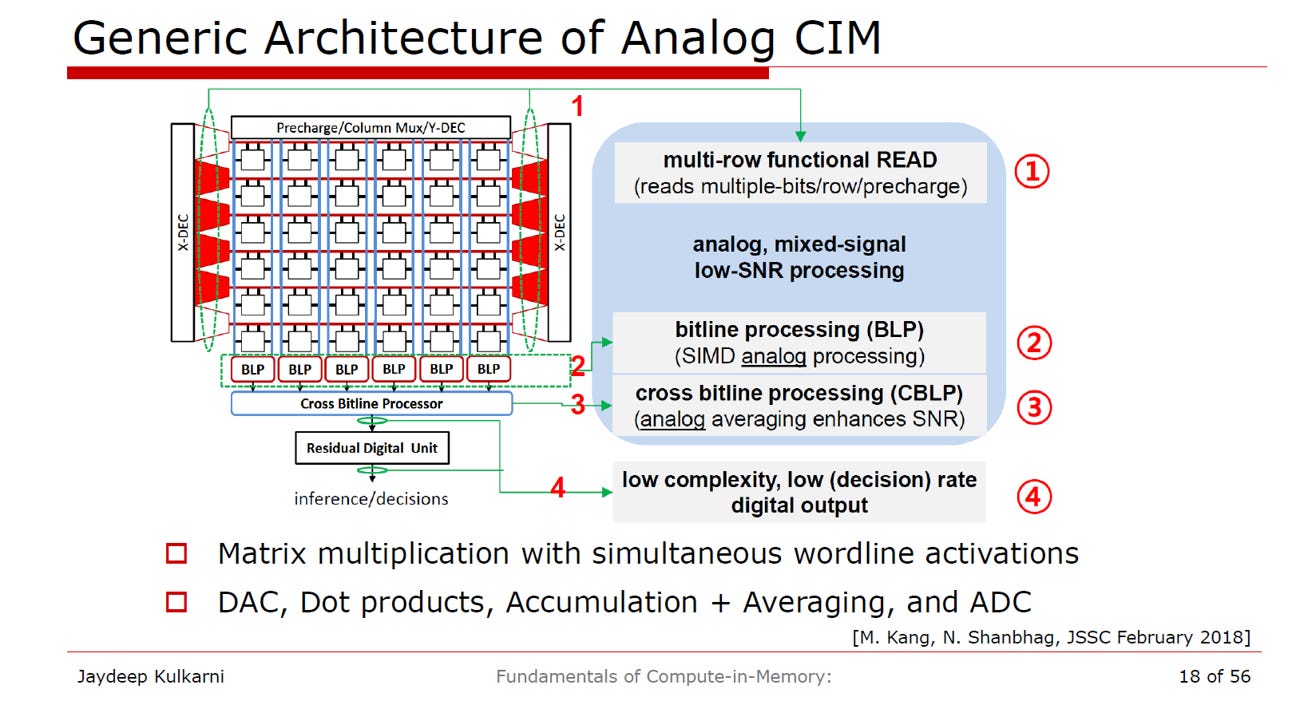
類比存算一體 (Analog CIM, ACIM) 的通用架構主要是透過「同時啟動多條字元線 (simultaneous wordline activations)」的方式,直接在二維記憶體陣列內部完成矩陣乘法運算。
該架構的核心運作邏輯,是將數學上的乘加運算 (Multiply-Accumulate, MAC) 直接映射到底層電路的物理定律。以下結合物理運作機制,介紹 ACIM 的處理流程:
核心物理運作機制
在進入系統流程前,需先釐清 ACIM 如何利用物理特性完成基礎數學運算:
乘法的物理機制 (歐姆定律):矩陣的靜態權重預先儲存於記憶體位元單元中,並在電路上表現為特定的電導值 (或電阻值)。當輸入資料轉換為類比電壓並施加於字元線時,根據歐姆定律 (電流 = 電壓 x 電導),單元內產生的放電電流大小,即代表了輸入值與權重值的乘積(Dot products)。
加法的物理機制 (克希荷夫電流定律):傳統記憶體一次只讀取一列,而 ACIM 會同時啟動多列字元線。這使得同一行 (Column) 上多個單元同時產生的放電電流,會全部流入同一條共用的位元線 (Bitline)。根據克希荷夫電流定律 (KCL),這些電流會在位元線上自然匯集與疊加,藉由物理現象瞬間完成了數學上的加法累加(Accumulation)。
ACIM 架構與處理流程拆解
結合上述的物理機制,圖中的架構將整體資料處理 (包含DAC、內積、累加、平均與 ADC) 劃分為四個主要階段:
source: Prof. J. Kulkarni, ISSCC26
多列功能性讀取 (multi-row functional READ):對應圖中標號 1。系統透過兩側的列解碼器 (X-DEC) 同時驅動多條字元線,將輸入訊號廣播至陣列中。在每個位元單元內部,輸入電壓與儲存權重透過物理機制完成「乘法」運算。此階段處理的是類比與混合訊號,屬於低訊噪比 (low-SNR) 的處理過程。
位元線處理 (bitline processing, BLP):對應圖中標號 2。這是一個單指令多資料流的類比處理階段 (SIMD analog processing)。各單元的乘法電流結果在垂直的位元線上進行物理疊加,直接在硬體線上完成了矩陣運算中的「加法」步驟。
跨位元線處理 (cross bitline processing, CBLP):對應圖中標號 3。由於類比訊號容易受到干擾,從位元線收集到的累加訊號會進入跨位元線處理器,透過類比平均技術 (analog averaging) 來進一步提升訊號雜訊比 (enhances SNR),確保運算結果的穩定性。
數位輸出 (digital output):對應圖中標號 4。處理完成的高品質類比訊號最終會進入殘差數位單元 (Residual Digital Unit) 進行類比數位轉換 (ADC),用以執行最終的推論或決策 (inference/decisions),並提供低複雜度、低決策率的數位輸出結果。
2.3. ACIM的挑戰
運算精度較低與平行化限制
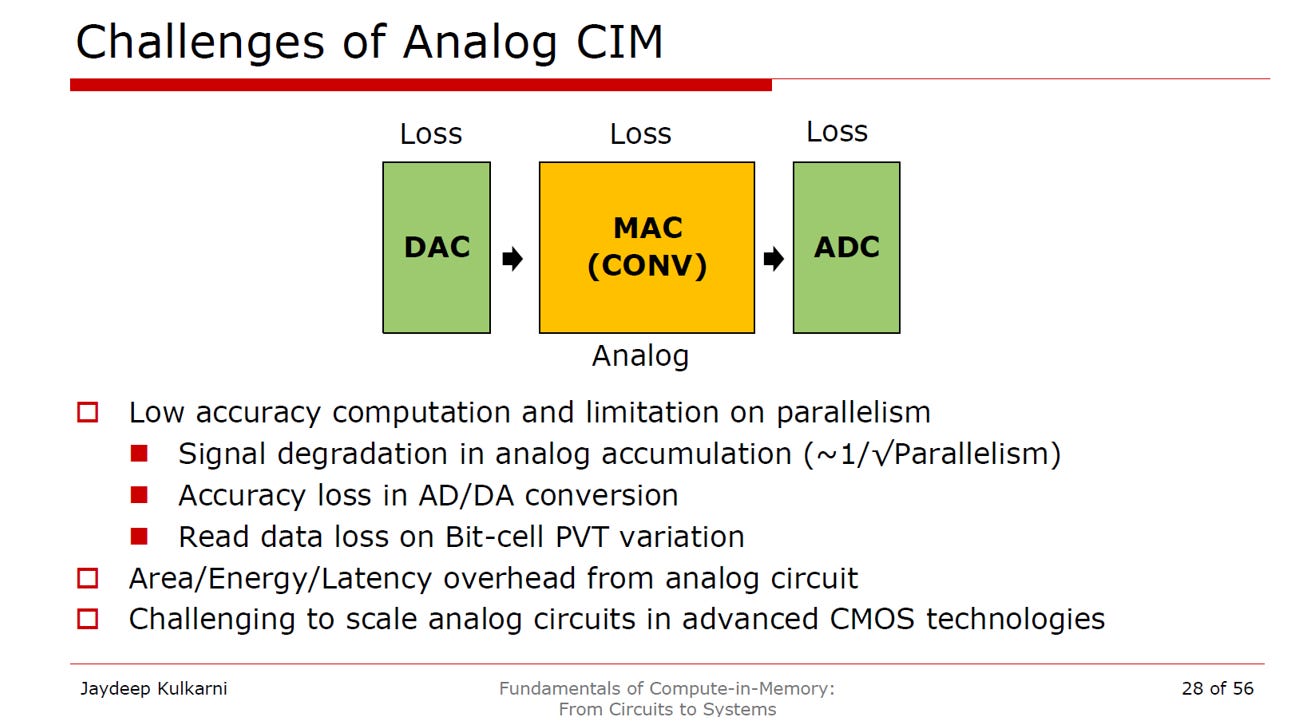
資料在流經數位類比轉換器 (DAC)、類比乘加運算核心 (MAC/CONV) 以及類比數位轉換器 (ADC) 的每一個階段時,都會產生訊號損耗 (Loss)。這些損耗直接限制了運算的精準度與系統能負荷的平行處理規模,具體原因包含:
類比累加的訊號衰減:在進行類比累加 (analog accumulation) 時會發生訊號衰減 (Signal degradation),其衰減程度大約與平行度大小的平方根成反比 (~ 1∕√Parallelism)。
轉換精度損失:在進行 AD/DA (類比數位/數位類比) 訊號轉換的過程中,無可避免地會產生精度損失 (Accuracy loss)。
物理環境變異影響:記憶體位元單元 (Bit-cell) 容易受到製程、電壓與溫度變異 (PVTvariation) 的干擾,導致讀取資料時產生損耗 (Read data loss)。
source: Prof. J. Kulkarni, ISSCC26
類比電路帶來的額外硬體開銷
為了解決類比訊號的轉換與雜訊問題,系統必須配置龐大的 ADC 與 DAC 等周邊類比電路,這會直接產生額外的晶片面積 (Area)、能耗 (Energy) 以及運算延遲 (Latency) 開銷 (overhead)。
先進製程微縮困難
隨著半導體製程不斷推進,傳統數位電路能順利縮小體積,但類比電路在先進 CMOS 製程技術中要進行微縮 (scale) 卻充滿挑戰。這使得 ACIM 難以充分享受先進製程帶來的面積與效能紅利。
2.4. ACIM的應用
傳統耳機晶片的矛盾與 DSP 限制
在傳統架構下,智慧耳機的發展面臨著一個無法跨越的死胡同:
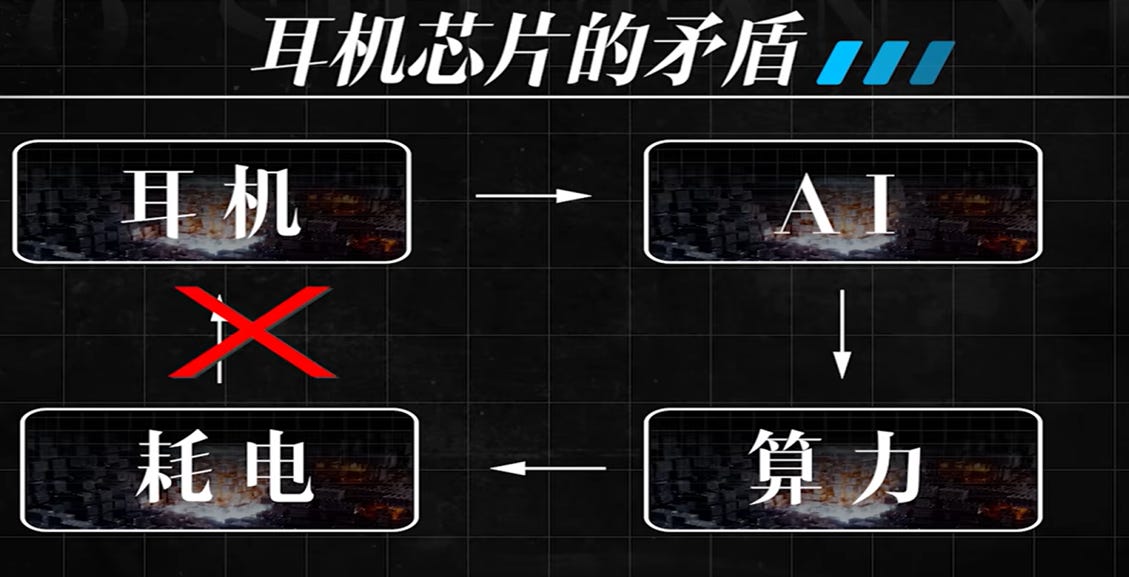
算力與耗電的矛盾:根據「耳機芯片的矛盾」圖表指出,耳機若要導入先進的 AI 功能,就必須大幅提升硬體的算力。然而,高算力必然伴隨著嚴重的耗電問題,這對於電池容量極小、對續航力要求極高的無線耳機來說是致命傷(即圖中「耗電」無法回饋給「耳機」的紅色打叉)。
傳統降噪的極限:過去的耳機晶片受限於算力,多半只能依賴基於規則 (rule-based) 的傳統噪音濾波器來處理通話與環境音。
解決方案:Analog CIM
Anker與知存科技 (Witmem) 合作開發的Thus A1是一顆基於 NOR Flash 技術的存算一體 (Compute-in-Memory) AI 音訊晶片。針對其參數規模與算力表現的關鍵數據(請參考: Reference [3][4]):
模型參數規模:Thus A1 晶片原生支援400 萬 (4 Million)參數級別的 AI 模型。在極度受限的耳機內部空間與功耗要求下,這使得耳機能夠真正在設備端 (On-device) 運行具備百萬級參數的大型神經網路,跳脫以往只能依賴微型模型或傳統規則濾波器的困境。
峰值算力 (FLOPS):傳統藍牙耳機晶片的算力大約落在30MFLOPS,而 Thus A1 晶片的算力大幅躍升至5G FLOPS。
效能提升倍數:相較於傳統藍牙耳機晶片,Thus A1 帶來了最高達150 倍的 AI 峰值算力提升。

基於 Thus 晶片的新產品四大 AI 應用
極致清晰通話 (Clear Calls):徹底捨棄傳統的規則濾波器,Thus 晶片直接在設備端運行基於龐大音訊資料集訓練而成的 AI 模型,能即時且全面地抑制環境噪音,確保語音清晰度。
強大的主動降噪 (Active Noise Cancellation):支援多達 8 個麥克風的陣列,且所有處理皆在晶片內完成 (On-chip processing),達到讓外界噪音「徹底消失」的高階降噪體驗。
離線語音控制 (Voice Control):過去語音辨識高度依賴雲端連線,現在憑藉 150 倍的終端算力,耳機可支援 20 種語音指令,且「零雲端參與 (Zero cloud involved)」,兼顧反應速度與隱私。
專屬音效處理 (Signature Sound):單一晶片即可同時運行多個 AI 模型。系統內建 HearID 5.0,能平行處理聽力特徵分析、音訊細節修復與環境適應;過去這些複雜運算必須依靠手機處理,現在全部轉由耳機端的 Thus 晶片在地完成。
3. Digital CIM
3.1. DCIM簡介
核心概念與運作原理

source: Prof. J. Kulkarni, ISSCC26
數位存算一體 (Digital CIM) 的核心技術,是使用數位加法器樹 (digital adder trees) 來取代傳統的類比累加 (analog accumulation)。
這種全數位化的架構,有效避免了類比 CIM 容易產生的運算不精確 (inaccuracy) 以及難以隨著先進製程微縮 (poor scaling) 的問題。
在運作上,DCIM 透過位元串列 (bit-serial) 或位元平行 (bit-parallel)乘法,並結合平行加法器來執行高能源效率的乘加運算 (MAC operation)。
資料處理流程包含數位乘法 (Digital multiply),產生數位部分總和 (Digital Partial Sum) 後透過加法器傳遞,最終經由移位與相加 (shift/add) 模組完成數位累加 (Digital Accumulation)。
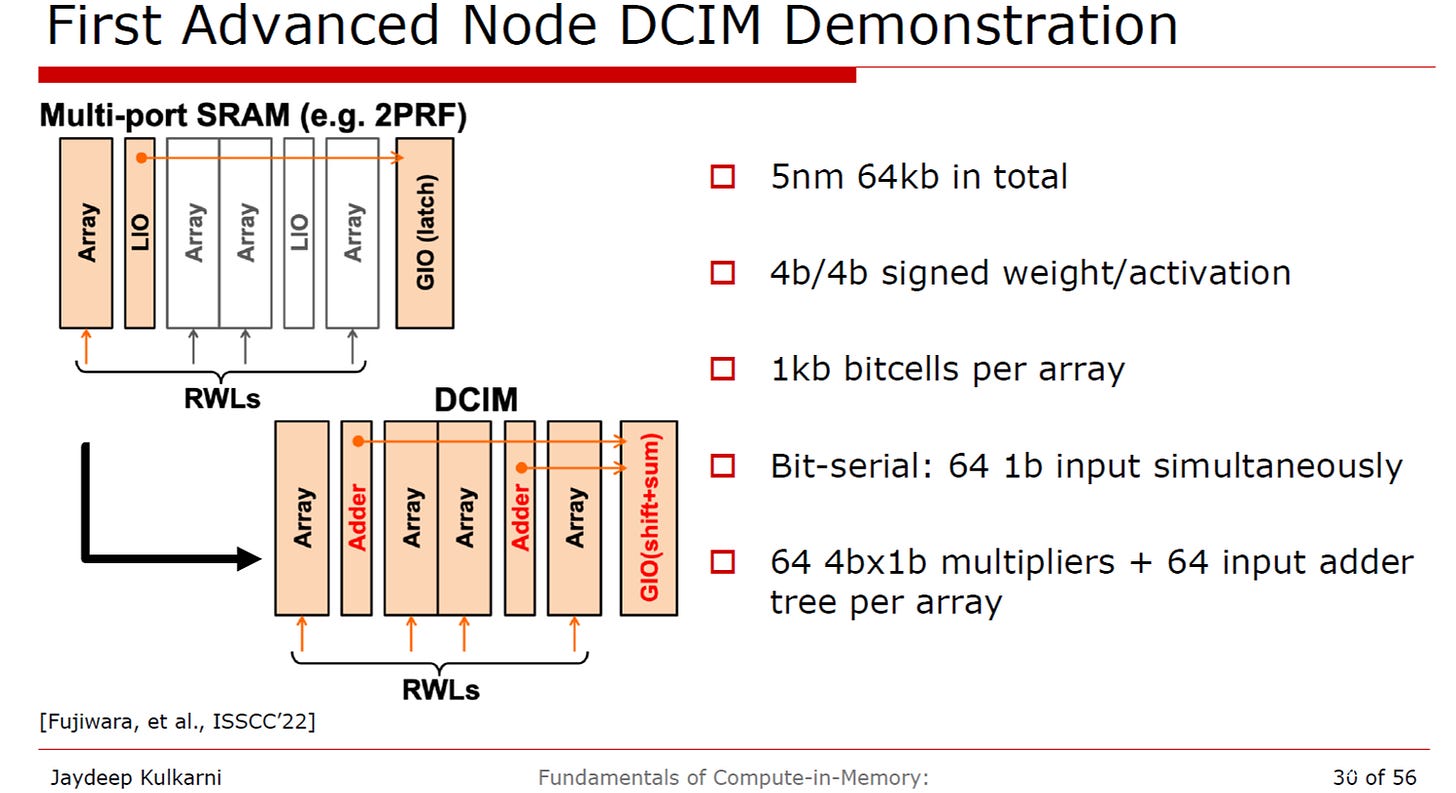
先進製程 (5nm) 實體展示規格
採用TSMC5nm 製程,晶片總容量為 64kb。(Fujiwara, TSMC; ISSCC 22)
支援 4位元/4位元 (4b/4b) 的帶符號權重與激發值 (signed weight/activation)。
在陣列配置上,每個陣列 (array) 包含 1kb 的位元單元 (bitcells)。
運算採用位元串列 (Bit-serial) 方式,可同時處理 64 個 1位元 (1b) 輸入。
每個陣列內部整合了 64 個 4bx1b 乘法器以及 64 輸入的加法器樹 (input adder tree)。
source: Prof. J. Kulkarni, ISSCC26
傳統 SRAM 與 DCIM 在硬體運作上的差異如下:
傳統 SRAM(單線作動):系統每次僅啟動單一條讀取字元線 (紅色RWL),執行單純的資料讀取與儲存任務。
DCIM 架構(多線平行作動):系統會同時啟動多條 RWL 讀出大量資料,並將原有的單純傳輸通道替換為加法器 (Adder) 與移位累加模組 (GIO shift+sum),藉此在記憶體周邊直接完成高平行度的數位運算。
配置專屬數位運算電路:DCIM 改變了傳統記憶體的周邊電路佈局,在每個陣列外圍新增了 64 個專屬的4bx1b數位乘法器與64輸入的加法器樹 (Adder Tree)。同時,原本用於單純資料傳輸的通道 (LIO 與 GIO) 也被替換為具備「移位與累加 (shift+sum)」功能的數位邏輯模組。
位元串列 (Bit-serial) 乘法機制:運算時不一次輸入完整的 4 位元數值,而是將輸入拆解,每次同步輸入 64 個「1 位元」訊號。這些 1 位元訊號會直接送入專屬乘法器中,與陣列讀出的4 位元權重進行基礎的數位邏輯相乘,最後再經由加法器與移位模組逐步累加,組合出最終的完整運算數值。
它是透過犧牲單筆運算的延遲時間 (Latency),換取極佳的硬體面積利用率與極高的整體平行處理吞吐量 (Throughput)
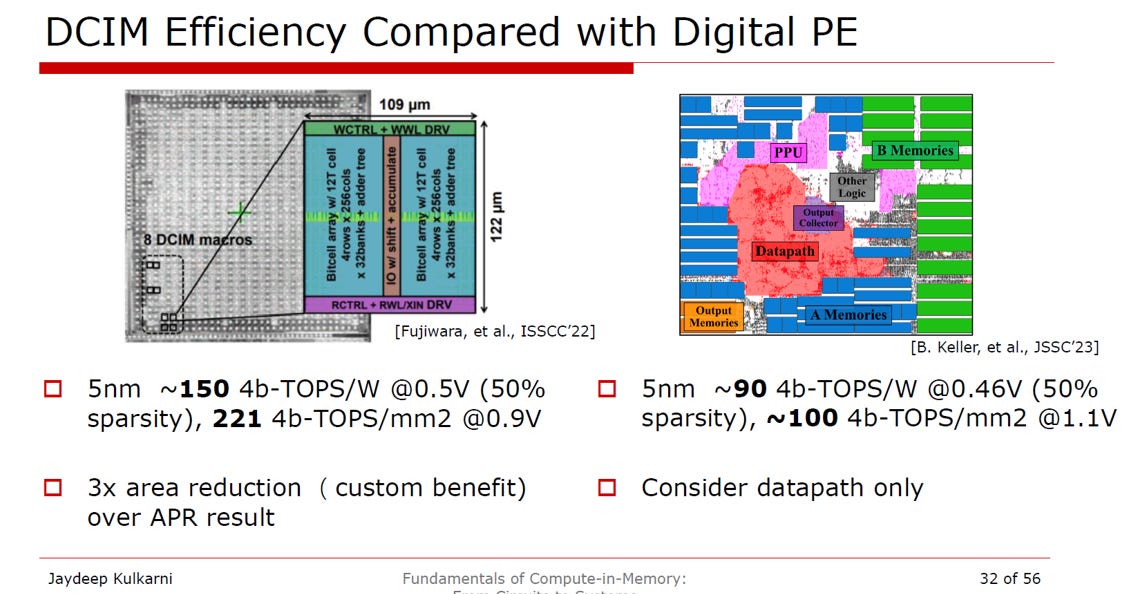
DCIM 與傳統數位處理單元 (Digital PE) 的效能比較
在同樣採用 5nm 製程且設定為 50% 稀疏度 (sparsity) 的基礎下,DCIM 展現了顯著的硬體優勢:
source: Prof. J. Kulkarni, ISSCC26
能源效率:DCIM 在 0.5V 工作電壓下,能源效率高達約1504b-TOPS/W;而傳統 Digital PE (僅考量資料路徑 datapath) 在 0.46V 下的能源效率僅約904b-TOPS/W。
面積效率:DCIM 在 0.9V 下的面積算力密度達到2214b-TOPS/mm2;相對地,Digital PE 在 1.1V 下約為1004b-TOPS/mm2。
面積縮減:透過客製化設計,DCIM 相較於標準自動佈局與繞線 (APR) 結果,實現了 3 倍的面積縮減 (3x area reduction)。
3.2. DCIM的挑戰
數位存算一體(DCIM)在發展上面臨的主要挑戰在於晶片面積的巨大開銷(Area Problem),為此學界與業界提出了多種針對加法器與電路架構的最佳化解決方案。
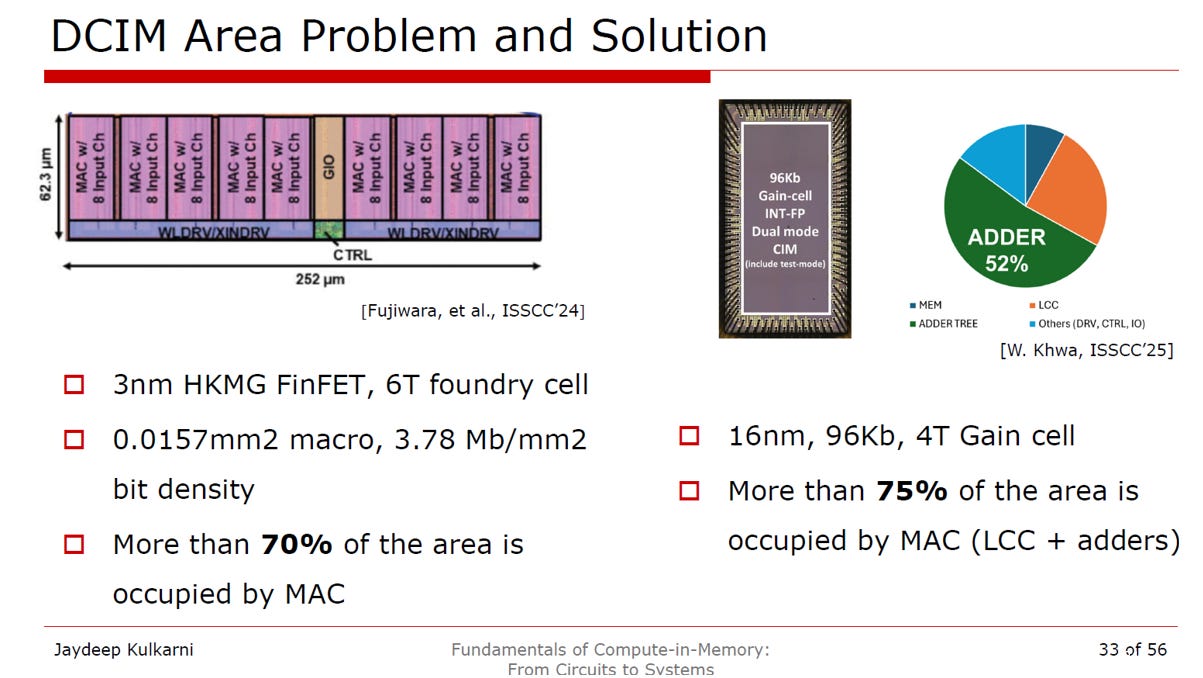
核心問題:MAC 單元佔用過大面積 (DCIM Area Problem)
DCIM 為了解決類比運算的精度問題,引入了大量的數位乘加運算(MAC)單元與加法器樹,這導致了嚴重的面積負擔
source: Prof. J. Kulkarni, ISSCC26
在 3nm HKMG FinFET(6T foundry cell)的設計中,雖然實現了 0.0157mm² 的 macro 面積與 3.78 Mb/mm² 的位元密度,但超過 70% 的面積被 MAC 單元所佔據。
在另一項 16nm、96Kb(4T Gain cell)的設計中,超過 75% 的面積被 MAC(包含 LCC 與加法器)佔據。其中,單單是加法器樹(Adder Tree)就佔了總體面積的 52%。
解決方案 (Solutions)
為了解決上述的面積瓶頸,研究人員主要從加法器設計、查找表替換,以及電路繞線最佳化等三個維度著手
加法器樹的面積與速度權衡設計 (Adder Tree Optimization)
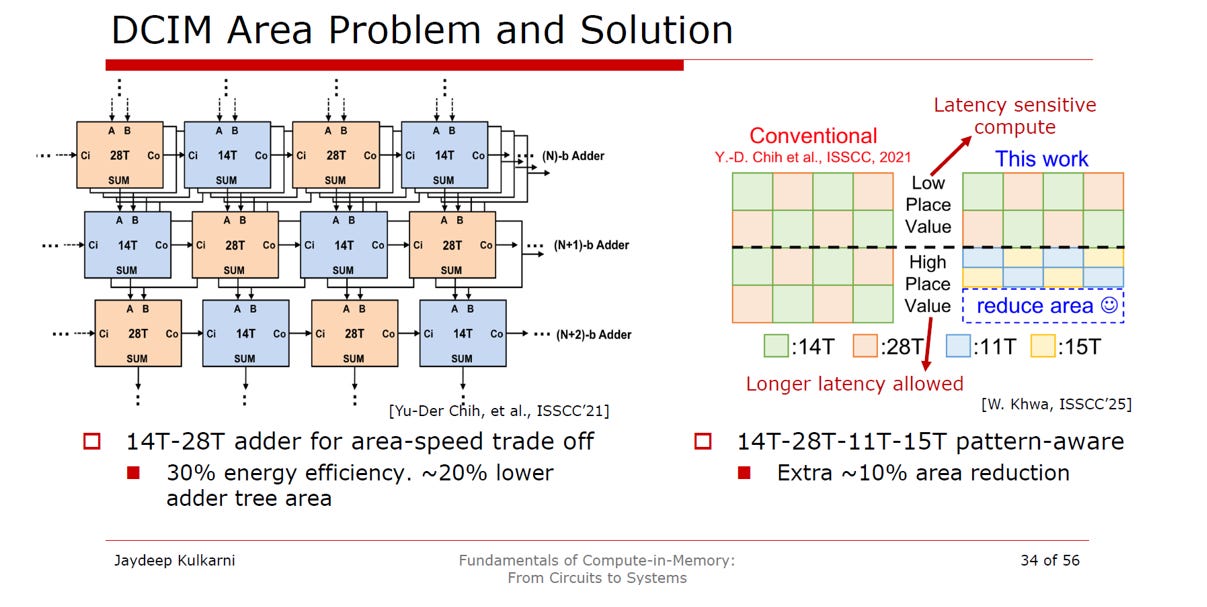
source: Prof. J. Kulkarni, ISSCC26
替換第一級加法器樹 (Replacing first stage adder tree)
將傳統架構中的第一級加法器樹替換為查找表(LUT)。
這種架構上的改變不僅能減少 7% 的元件數量(smaller device count),還能提升 5% 的運算速度。
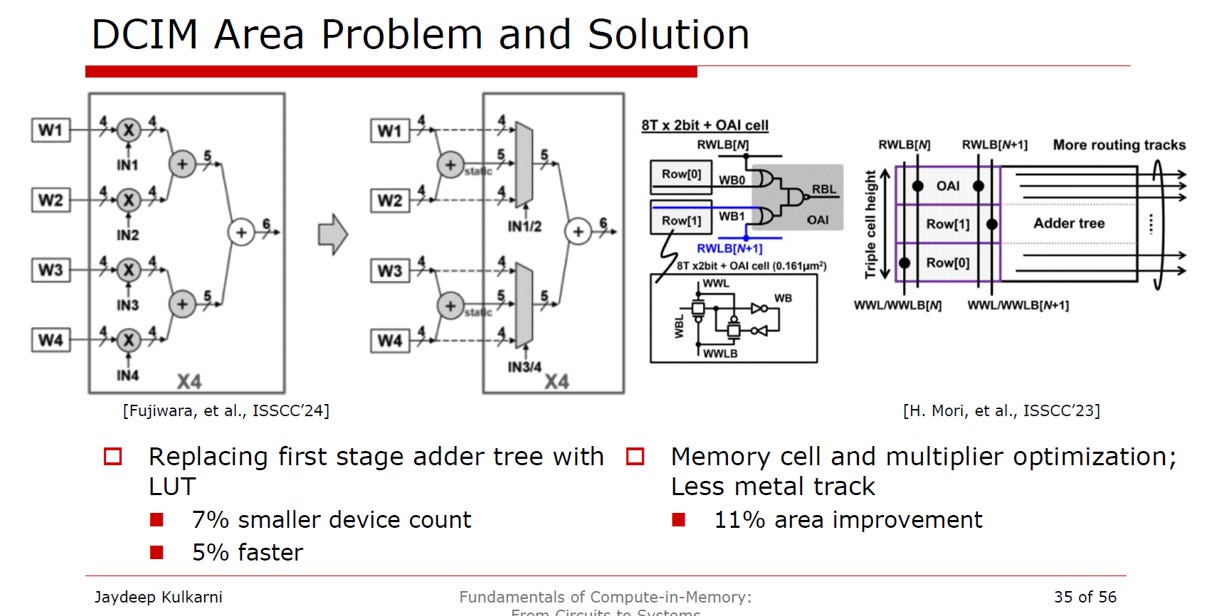
source: Prof. J. Kulkarni, ISSCC26
記憶體單元、乘法器與繞線最佳化
透過最佳化記憶體單元與乘法器設計(例如採用 8T x 2bit + OAI cell),能夠有效減少金屬走線(Less metal track)的需求。
這使得加法器樹能獲得更多的繞線軌道(More routing tracks),最終達成了 11% 的面積改善(area improvement)。
圖表中引用(Yu-Der Chih, W. Khwa, Hidehiro Fujiwara, H. Mori )的研究成果,四位研究人員皆隸屬於TSMC。
TSMC在數位存算一體 (DCIM) 領域的深耕與貢獻,可簡要歸納為以下三個重點:
領先驗證先進製程微縮:率先在=等先進製程上證明 DCIM 的高能效與高算力密度,確立了「全數位架構能完美受惠於先進 CMOS 製程微縮」的技術路線。
突破面積物理限制:針對 DCIM 加法器佔用面積過大的致命痛點,提出包含混合型加法器樹、LUT 替換與電路繞線最佳化等多維度的創新解決方案,有效縮減硬體開銷。
建立持續的技術藍圖:研發佈局從 5nm 一路推進至 3nm,連年於頂級學術會議 (ISSCC) 發表成果。因 DCIM 高度契合台積電在先進邏輯製程的優勢,已成為其解決 AI 晶片「記憶體之牆」的主力發展方向。
4. d-Matrix
d-Matrix 是一家專注於人工智慧推論加速的新創半導體公司,其核心技術結合了數位記憶體內運算(DIMC, Digital In-Memory Computing)與小晶片(Chiplet)架構,主要用於優化大型語言模型(LLM)在資料中心端的運算效能並降低能耗。
4.1. Corsair:基於 Chiplet 的推論加速平台
d-Matrix 開發的 Corsair 是一個專為推論加速設計的平台。
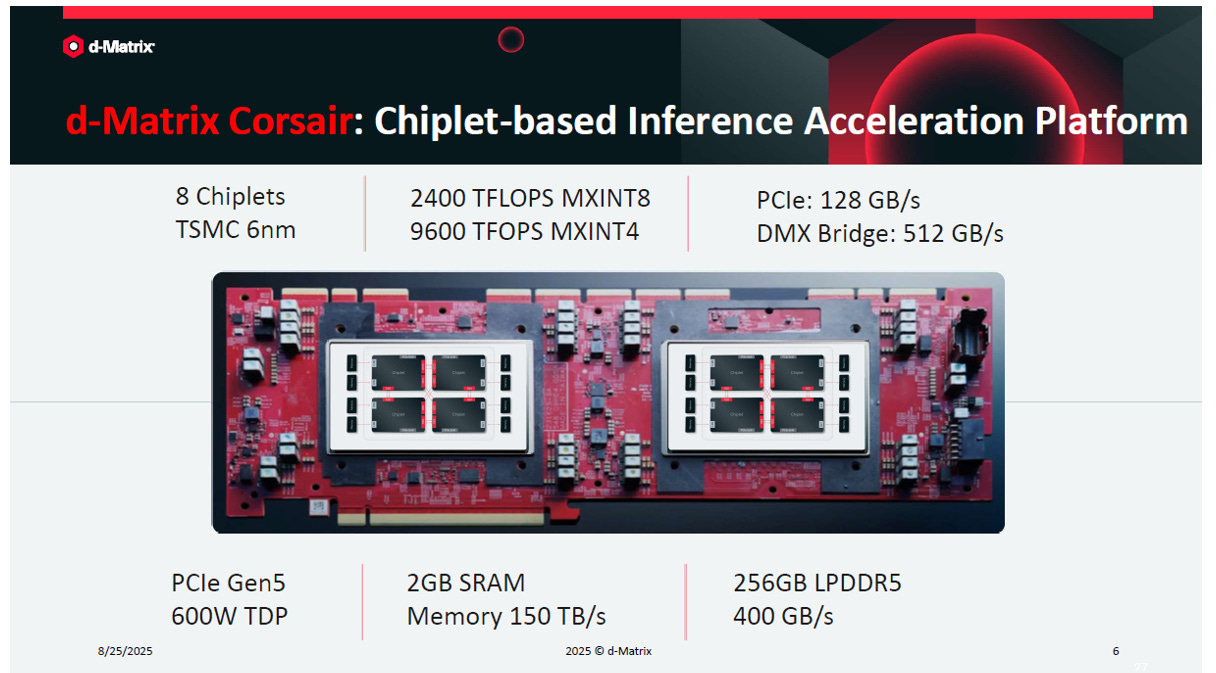
source: S. Bhoja, d-Matrix, Hotchips 25
該平台採用 TSMC 6nm 製程,單一配置包含 8 個小晶片 (Chiplets)。
具備強大的運算能力,可提供 2400 TOPS (MXINT8) 與 9600 TOPS (MXINT4) 的算力。
記憶體系統整合了高頻寬的 2GB SRAM (頻寬達 150 TB/s) 以及 256GB 的 LPDDR5 (頻寬達 400 GB/s)。
功耗與介面方面,支援 PCIe Gen5 規格,熱設計功耗 (TDP) 為 600W。
Corsair Chiplet 架構簡介
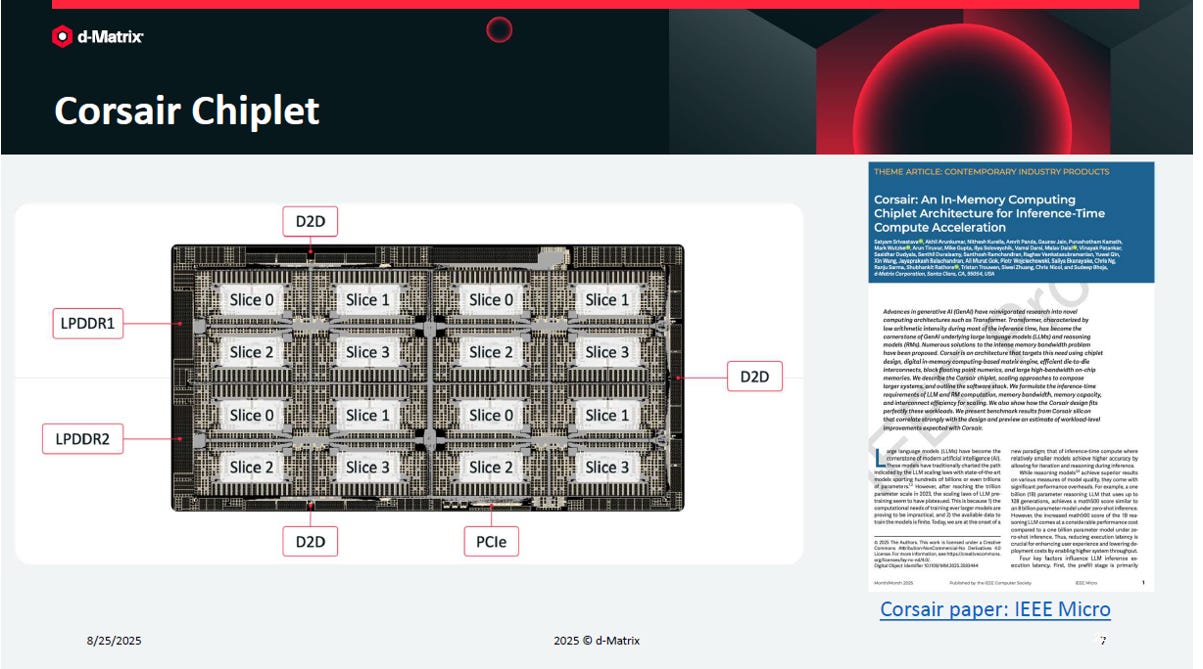
source: S. Bhoja, d-Matrix, Hotchips 25
該架構是專為推論階段 (Inference-Time) 加速所設計的存算一體小晶片。
晶片內部佈局包含多個運算切片 (Slice 0 至 Slice 3)。
具備完整的對外介面,包含晶片間互連 (D2D)、PCIe 介面,以及兩組 LPDDR 記憶體控制器 (LPDDR1, LPDDR2)。
雙 PCIe 卡擴展與 DMX Bridge 互連
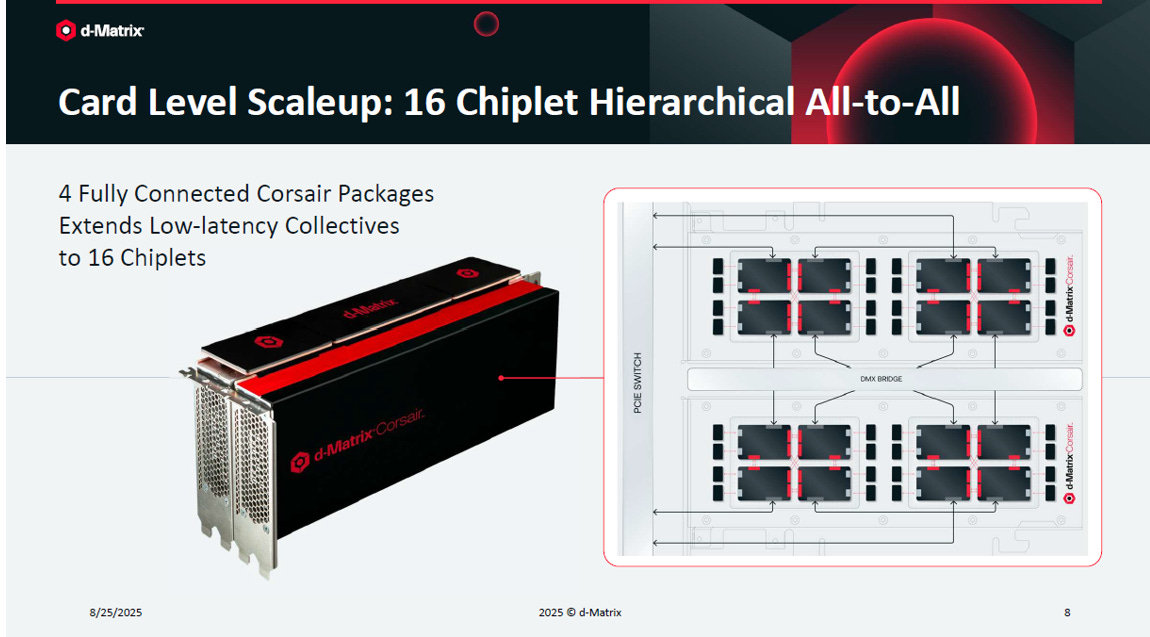
source: S. Bhoja, d-Matrix, Hotchips 25
系統支援卡級擴展 (Card Level Scaleup),能透過 4 個全互連的 Corsair 封裝,實現 16 個 Chiplet 的階層式全互連 (Hierarchical All-to-All) 架構,以擴展低延遲的集合運算。
雙 PCIe 卡之間透過DMX Bridge進行橋接,該橋接器可提供高達 512 GB/s 的傳輸頻寬
伺服器層級 64 晶片 Scale-up 與 Scale-out 能力
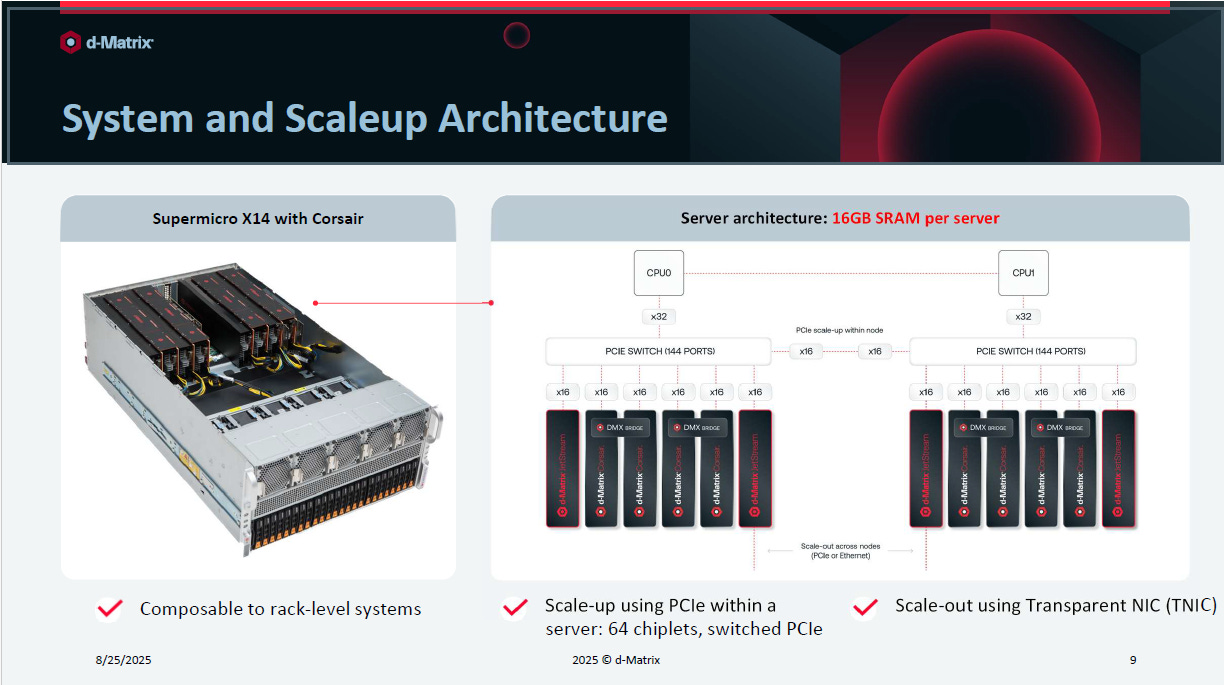
source: S. Bhoja, d-Matrix, Hotchips 25
向上擴展 (Scale-up):在單一伺服器節點內,可透過 PCIe 交換器 (Switched PCIe) 將系統擴展至最高64個 Chiplets。
滿載的伺服器架構可提供高達16GB(= 64x256MB)的SRAM總容量。
向外擴展 (Scale-out):系統支援跨節點的擴展,透過通透式網卡 (Transparent NIC,TNIC by d-Matrix) 搭配 PCIe 或乙太網路 (Ethernet) 實現向外擴充。
能源效率表現 (TOPS/W)
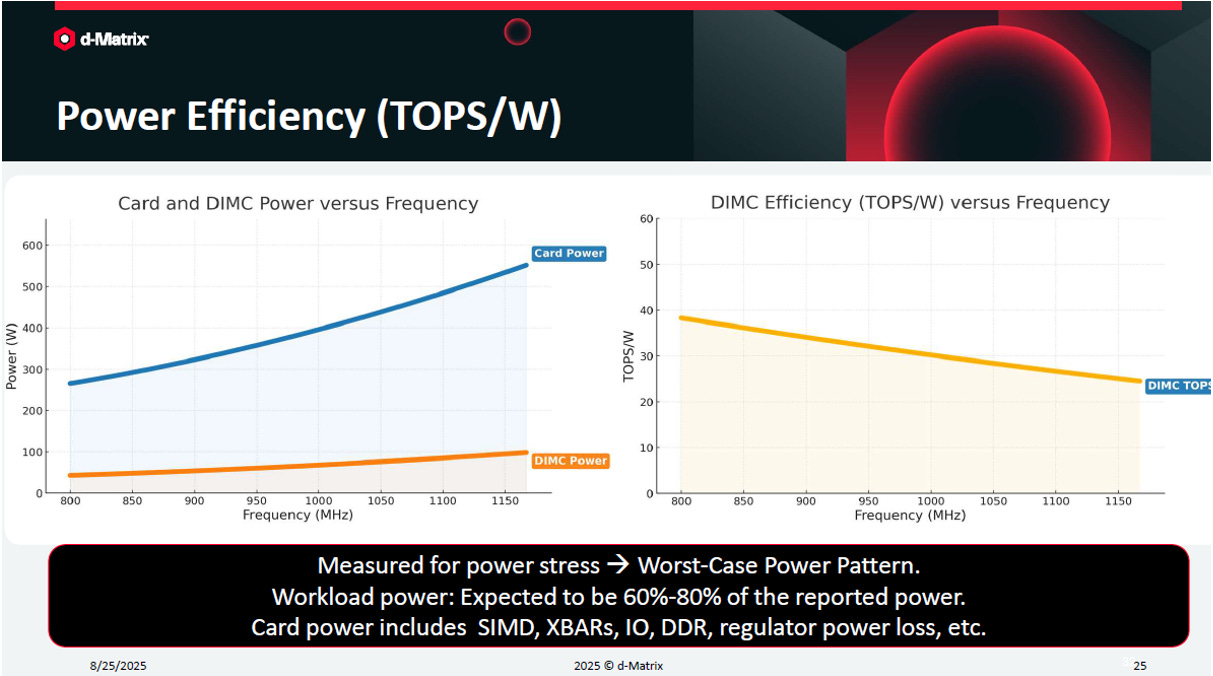
source: S. Bhoja, d-Matrix, Hotchips 25
d-Matrix 的DIMC(數位存算一體) 能源效率會隨運作時脈頻率變動;在 800 MHz 頻率下,其效率可達近40 TOPS/W,而在 1150 MHz 頻率下則約為 24 至 25 TOPS/W。
這些數據是在最嚴苛的功耗模式 (Worst-Case Power Pattern) 下測得,實際工作負載的功耗預期僅為測試報告的 60% 至 80%。
Card power遠大於DIMC power 的核心原因在於:系統中「非存算一體核心」的周邊與基礎設施產生了巨大的額外功耗 (Overhead)。
資料搬移與外部記憶體 (IO & DDR):存取外部 LPDDR 與對外介面傳輸資料所消耗的巨大能量。
內部互連網路 (XBARs):負責晶片內部資料路由與各運算單元之間通訊的 Crossbars 架構。
輔助運算單元 (SIMD):處理非矩陣運算或特殊網路層的額外邏輯運算單元。
電源轉換損耗 (Regulator power loss):穩壓器在大電流供電與電壓轉換時必然產生的物理熱損耗。
效能表現 (Tokens Per Second, TPS)
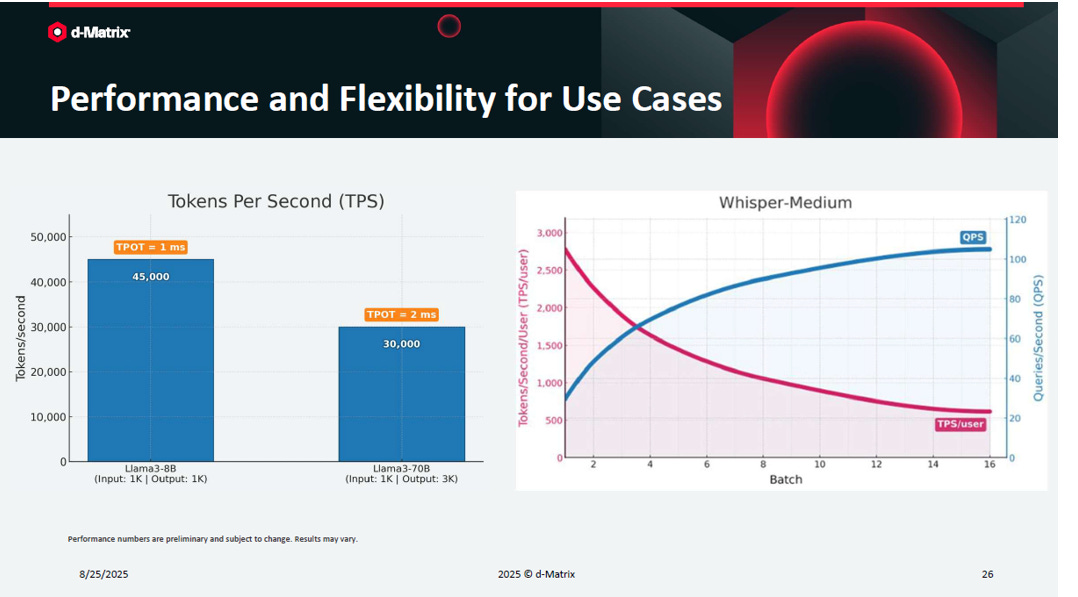
source: S. Bhoja, d-Matrix, Hotchips 25
在生成式 AI 模型的推論效能基準測試中,運行Llama3-8B模型 (設定為輸入 1K、輸出 1K),系統可達到每秒 45,000 Tokens (TPS) 的吞吐量,且每生成一個輸出 Token 的時間 (TPOT) 僅需 1 毫秒 (ms)。
運行較大型的Llama3-70B模型 (設定為輸入 1K、輸出 3K),系統仍能維持每秒 30,000 Tokens (TPS) 的表現,TPOT 為 2 毫秒 (ms)。
4.2. 3D DRAM堆疊
為了解決傳統架構中存取外部 LPDDR 與 IO 介面傳輸所帶來的巨大功耗瓶頸,d-Matrix 提出了將運算邏輯直接與 DRAM 進行 3D 堆疊的解決方案。這將長距離的水平資料搬移轉換為極短距離的垂直傳輸。
3D DRAM 架構
d-Matrix 透過將邏輯晶片 (logic) 堆疊在 DRAM 中介層 (interposer) 上,大幅縮短了運算與記憶體之間的物理距離:
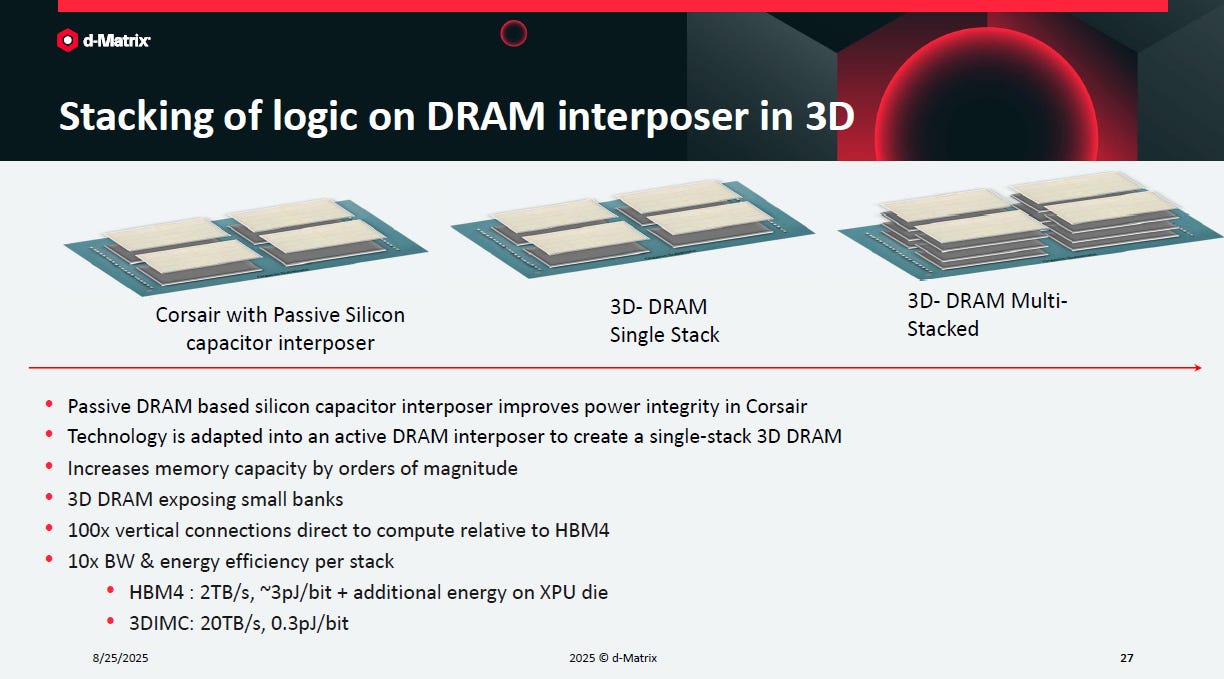
source: S. Bhoja, d-Matrix, Hotchips 25
技術演進路徑:Corsair 架構使用了被動矽電容中介層,來改善電源完整性 (power integrity)。隨後這項技術被升級為「主動式 DRAM 中介層 (active DRAM interposer)」,藉此打造出單層堆疊的 3D DRAM,未來還將進一步朝向多層堆疊 (Multi-Stacked) 發展。
容量與微架構優勢:這項技術能讓記憶體容量呈現數量級的增加,並且能將小型記憶體庫 (small banks) 直接給運算單元使用。
超高連線密度:相較於下一代的 HBM4 記憶體,此 3D DRAM 架構提供了高達100倍的垂直連接 (vertical connections),讓資料直接直達運算核心。
頻寬與能效的跨世代突破:與 HBM4 相比,每層堆疊可提供10倍的頻寬與能源效率。
HBM4 的規格基準約為 2TB/s 頻寬,能耗約為 3pJ/bit(且還需加上 XPU 晶片端產生的額外能耗)。
d-Matrix 的 3DIMC 架構則可達到20TB/s的超高頻寬,且能耗大幅降低至僅0.3pJ/bit。
3D DRAM 測試晶片 (Test Vehicle) 簡介
為了驗證這項 3D 堆疊架構,d-Matrix 推出了名為PavehawkOne 的測試晶片,具體實作細節如下:
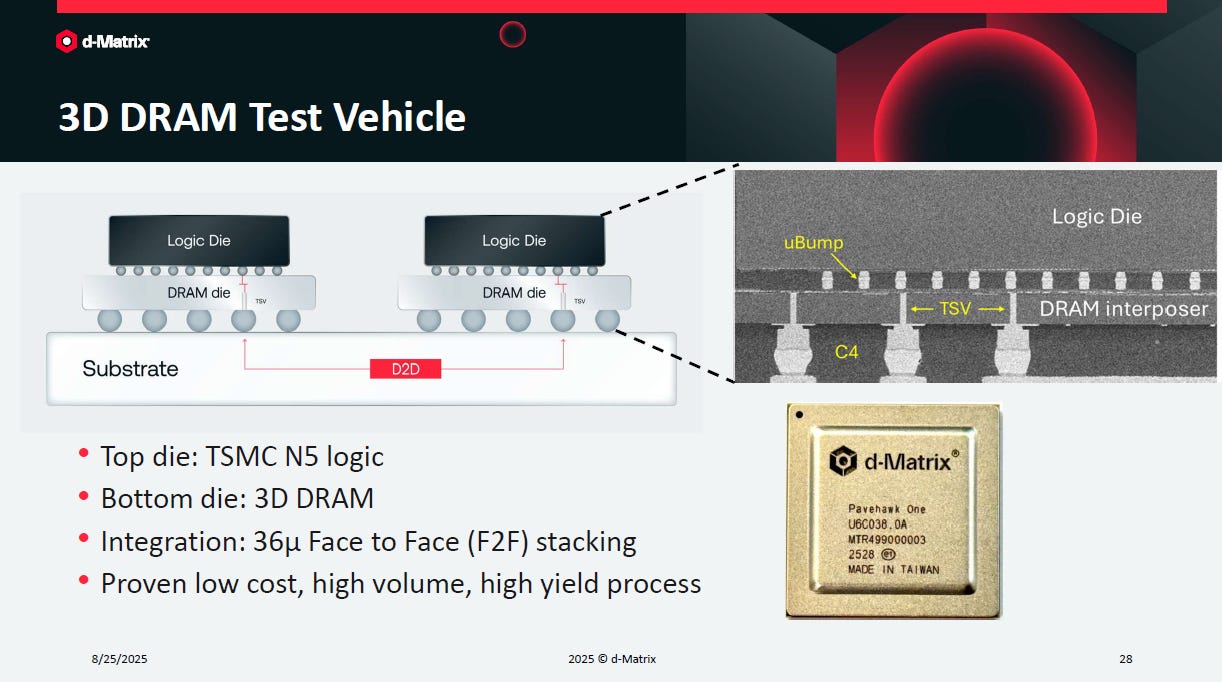
source: S. Bhoja, d-Matrix, Hotchips 25
異質晶片堆疊配置:頂層晶片 (Top die) 採用了台積電 (TSMC) 的 N5 先進邏輯製程,而底層晶片 (Bottom die) 則配置為 3D DRAM。
先進封裝整合技術:兩層晶片之間採用了 36 微米 (36u) 的面對面 (Face to Face, F2F) 堆疊技術進行高密度整合。
實體電路連接結構:從電子顯微鏡剖面圖可以觀察到,頂層的邏輯晶片透過微凸塊 (uBump) 與下方的 DRAM 中介層連接,並利用矽穿孔 (TSV) 貫穿中介層,最終透過 C4 凸塊連接至底層基板 (Substrate)。同時,基板上也支援晶片對晶片 (D2D) 的通訊設計。
具備量產可行性:官方指出,這項封裝技術已是經過驗證的製程,具備低成本 (low cost)、適合大批量生產 (high volume) 以及高良率 (high yield) 等商業化優勢。
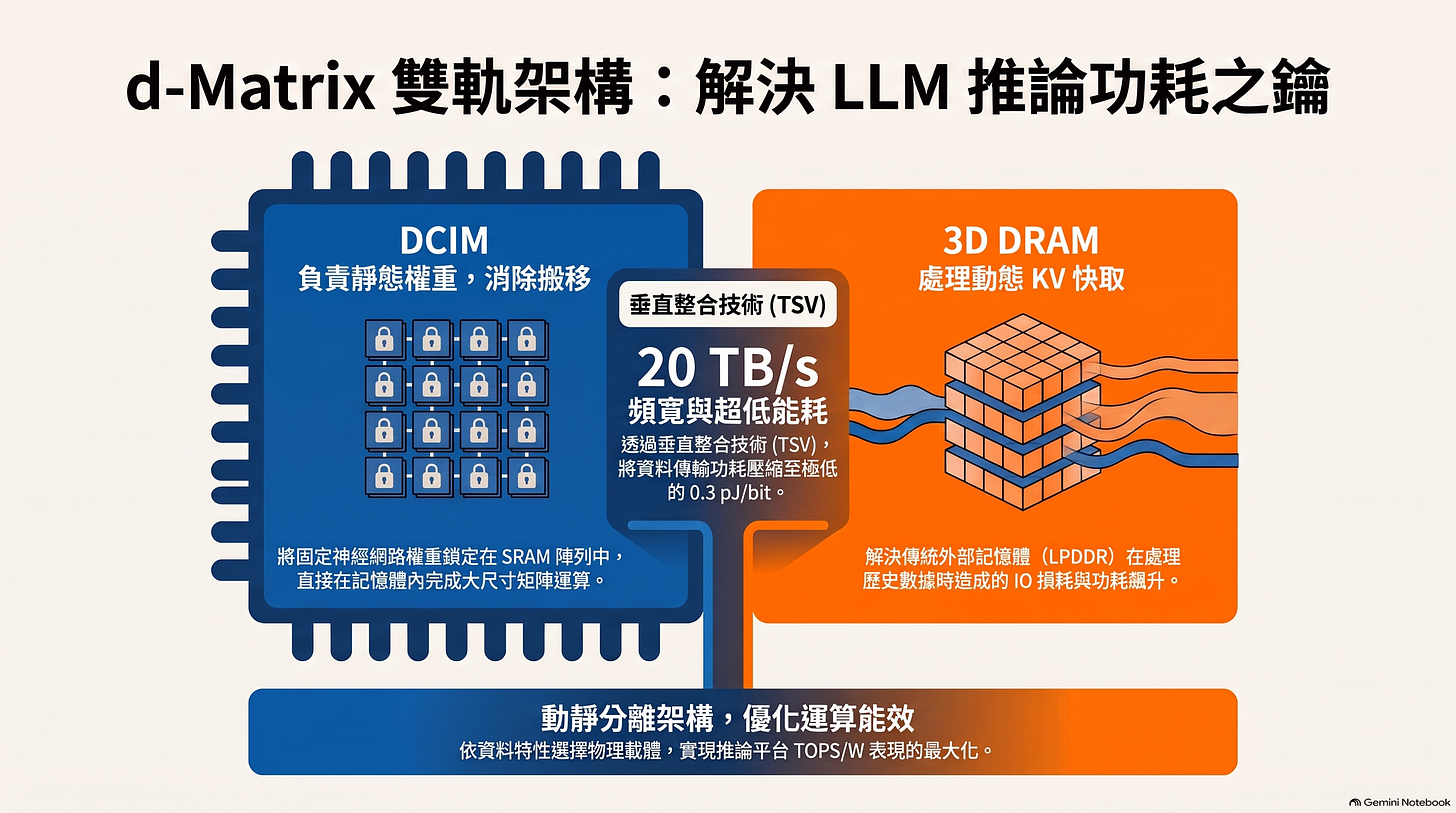
整合 d-Matrix 未來在 DCIM 與 3D DRAM 的雙軌架構,此應用模式精準對應了大型語言模型 (LLM) 推論階段的物理與資料特性,有效解決系統層級的功耗鴻溝,其核心運作邏輯可整理如下:
靜態權重常駐於 DCIM:在推論階段,模型權重(Weights)是唯讀且固定不動的。將其分佈並儲存於 DCIM 的分散式記憶體陣列中,可以直接利用記憶體周邊的數位運算單元進行原地處理,徹底消除了權重在運算過程中不斷搬移所產生的巨大能耗。
動態 KV Cache 放置於 3D DRAM:在 LLM 的生成(Decode)階段,每一輪迭代都需要頻繁讀寫不斷增長的歷史鍵值快取(KV Cache)。這是傳統架構中造成外部記憶體頻寬枯竭與 IO 功耗飆升的主因。將其改存於透過 3D 垂直堆疊(如 F2F 與 TSV)緊鄰運算核心的 3D DRAM 中,能將資料搬移距離縮短至微米級,實現高達 20 TB/s 的頻寬與極低的傳輸能耗(0.3 pJ/bit),從根本上解決了系統層級的功耗鴻溝。
5. 結論
存算一體 (CIM) 技術已成為突破當前資料主導的高效能運算瓶頸之關鍵發展方向。在硬體實作上,類比存算一體 (ACIM) 運用歐姆定律與克希荷夫電流定律等物理機制直接在記憶體陣列內完成矩陣運算,成功為終端設備(如 Anker 智慧耳機晶片)帶來極致的低功耗與高倍數 AI 算力提升。
另一方面,為克服類比電路在先進製程微縮上的困難與運算精度限制,數位存算一體 (DCIM) 透過數位加法器樹取代類比累加,在台積電等 5nm 先進製程中展現了卓越的能源效率與面積算力密度。
展望未來,面對大型語言模型 (LLM) 嚴苛的記憶體頻寬挑戰,新創公司 d-Matrix 展示了先進的雙軌體系解方:將靜態模型權重鎖定於 DCIM 中以徹底消除資料搬移能耗,並將動態的 KV Cache 配置於垂直堆疊的 3D DRAM 中以提供超高頻寬。這種結合 CIM 與先進封裝小晶片 (Chiplet) 的架構,從根本上解決了系統層級的功耗鴻溝,完美展示了 CIM 技術從單一電路設計邁向龐大系統應用的無限潛力。
[Reference]
Jaydeep Kulkarni, “Fundametals of Compute-in-Memory: From Circuits to System”, ISSCC26
Sundeep Bhoja, “CORSAIR: An In-Memory Computing Chiplet Architecture for Inference-Time Compute Acceleration“, Hotchips 25
秘密研发三年!安克这颗存算一体芯片,如何违背了所有祖宗的决定?
28纳米反超1000倍?不需要EUV的芯片黑魔法:对话知存科技王绍迪
Support Ted Yu
Launched a year ago
EE Master's degree holder. 30+ years of extensive experience in telecom and high-speed data (BB CPE, 5G Wireless). Focused on high-speed communication solutions for data centers and telecom, with interest in advanced process and packaging now.
Pledge your support


