AI 加速器的功耗正呈現非線性增長。從 2020 年的 400W 躍升至預計 2027 年突破 3700W 甚至上看 5kW,單機櫃總功耗更將達到史無前例的 700kW 。在極端電流需求下,傳統的橫向供電網路 (Lateral PDN) 面臨了難以跨越的物理限制:急劇增加的 I2R 傳輸損耗與電壓驟降…
AI 加速器的功耗正呈現非線性增長。從 2020 年的 400W 躍升至預計 2027 年突破 3700W 甚至上看 5kW,單機櫃總功耗更將達到史無前例的 700kW 。在極端電流需求下,傳統的橫向供電網路 (Lateral PDN) 面臨了難以跨越的物理限制:急劇增加的 I2R 傳輸損耗與電壓驟降…
- Source: Ted Yu
- Published: 2026-06-24T07:31:06+08:00
- URL: https://ytyuted.substack.com/p/ep50-5kw-gpu-intel-ivr EP50. 突破 5kW GPU 供電極限:解析 Intel 垂直供電與 IVR 發展藍圖 - Ted Yu
Pledge your support

EP50. 突破 5kW GPU 供電極限:解析 Intel 垂直供電與 IVR 發展藍圖

Jun 24, 2026
AI 加速器的功耗正呈現非線性增長。從 2020 年的 400W 躍升至預計 2027 年突破 3700W 甚至上看 5kW,單機櫃總功耗更將達到史無前例的 700kW 。在極端電流需求下,傳統的橫向供電網路 (Lateral PDN) 面臨了難以跨越的物理限制:急劇增加的I²R傳輸損耗與電壓驟降 (Voltage Droop),不僅嚴重侵蝕了實際可用的運算功率,更帶來了棘手的熱管理難題 。
為了解決這「最後一吋」的傳輸瓶頸,供電架構的典範轉移勢在必行 。產業界正致力於將電壓轉換模組極致地推近運算核心,促使供電路徑從橫向 (Lateral) 走向垂直 (Vertical) 甚至直接嵌入封裝內部 。本文將藉由 ISSCC 2026 的技術論壇內容,剖析 Intel 的整合式電壓調節器 (IVR) 技術演進,探討如何透過先進封裝、電容/電感結構微縮以及混合式拓撲,突破次世代 AI 硬體的供電天花板
1. Background
1.1. 電能需求
針對AI硬體對電能的需求: 從晶片層級、機架層級到整體資料中心,三個維度剖析,了解目前供電遇到的瓶頸。
晶片層級(Device Level): GPU功耗直逼4kW 帶來的PDN 挑戰
AI 加速器的功耗正呈現非線性增長。從 2020 年 Tesla A100 的 400W,到 Blackwell B200 的1200W,再到預計 2027 年的 Rubin Ultra 飆升至3700W,表中提及的 MI450x 也呈現同樣的陡升趨勢。

source: ISSCC26 F3.1
技術瓶頸:當單一晶片功耗逼近KW時,傳統的供電網路 (Power Delivery Network, PDN) 會面臨極大的電流傳輸損耗與壓降問題。
解決方案方向:必須將電壓轉換模組盡可能推近晶片,甚至進行垂直堆疊,才能在極低電壓下提供數千安培的穩定電流。整合式電壓調節器 (Integrated Voltage Regulator, IVR)設計, 才能支援高耗能的GPU。
機架層級 (Rack Level):700kW 機櫃與 OCP Diablo 計畫
「機架即晶片 (Rack as a Superchip)」的架構演進,這對系統硬體與機構設計帶來顛覆性的改變。

source: ISSCC26 F3.1
密度躍升:Blackwell 世代的機櫃 (容納 72 顆 GPU) 總功耗約為120kW。而到了 Rubin Ultra 世代,不僅單晶片功耗增加,機櫃密度更翻倍至 144 顆 GPU,使得單機櫃總功耗達到史無前例的700kW。
巨集層級 (Macro Level):基礎設施能源消耗的指數型增長

source: ISSCC26 F3.1
電網佔比激增:美國資料中心的能源消耗佔比,預計將從 2023 年前的約 1.9%,在 2028 年激增至基準的 6.7%,極端預測甚至高達12.0%。
發展瓶頸的轉移:這意味著 AI 算力的擴張瓶頸,已經從半導體製程的物理極限,正式擴大到總體基礎設施的供電與冷卻能力。高耗能將驅動如何設計電能傳輸,高效的給運算核心。
1.2. from Lateral to Vertical
下張圖表解構了AI 伺服器的供電網路 (Power Delivery Network, PDN) 拓撲,展示電能從電網一路轉換並降壓至運算核心的物理路徑。整體架構可明確劃分為「高壓配電 (High voltage)」與「最後一吋 (Last inch)」兩個主要階段,反映了當前系統架構在功率與電流傳輸上的工程挑戰。

source: ISSCC26 F3.5
高壓配電 (High voltage)
伺服器電源供應器 (Server PSU):負責將交流電轉為直流電。未來單一 PSU 功率需求將突破 20kW,必須採用具備更高散熱能力的先進封裝技術。
備用電池模組 (BBU):在高功率架構下,BBU 的核心任務已擴展至「削峰 (Peak shaving)」,用於即時補償 AI 運算產生的瞬態功率突波,因此其能量密度與充放電效率至關重要。
最後一吋 (Last inch)
中間匯流排轉換器 (IBC):為降低大電流傳輸產生的損耗,系統架構將 48V 高壓路徑盡可能延伸,再透過 IBC 模組進行初步降壓。
處理器供電 (Processor Power):隨著運算核心電壓持續降低且總電流急速攀升,傳統橫向供電在進入晶片前的「最後一吋 (Last inch)」會產生嚴重的壓降與熱耗損。這迫使業界必須開發新型態的供電架構來解決此瓶頸。
傳統橫向供電 (Lateral PD) 面臨的極限與 I²R 損耗問題
在傳統橫向供電中,主機板級的電壓調節模組 (MBVR,負責將 12V 降至晶片所需的 0.7V) 被放置在晶片封裝的周圍。電流必須「橫向」穿過 PCB 的銅箔走線,才能抵達晶片底部的錫球。

source: ISSCC26 F3.1
1KW 時代的隱患:當 GPU 功耗為1KW(約需1428安培電流) 時,傳輸路徑上的銅箔電阻 (R) 會產生I²R 損耗。從圖中可見,MBVR 輸出 1089W,但經過 PCB 走線的 I²R損耗 (89W) 和壓降 (Droop, 174W) 後,真正用於運算的「有用功率 (Useful Power)」僅剩826W。
5KW 時代的崩潰:當 GPU 功耗飆升至 5KW 時,由於電流增加至 5 倍,I²R 損耗會呈平方倍數暴增。圖中顯示,為了讓晶片獲得 5000W 的功率,MBVR 必須輸出高達 7222W 的能量。其中驚人的2222W完完全全浪費在 PCB 走線發熱上,而壓降造成的無效功率更達到 1528W。這意味著超過一半的總輸入電能都被浪費,這在散熱與能源效率上是完全無法接受的。
註: 計算是基於 43.6 μΩ 的 PCB 走線阻抗與 87% 的電源轉換效率。
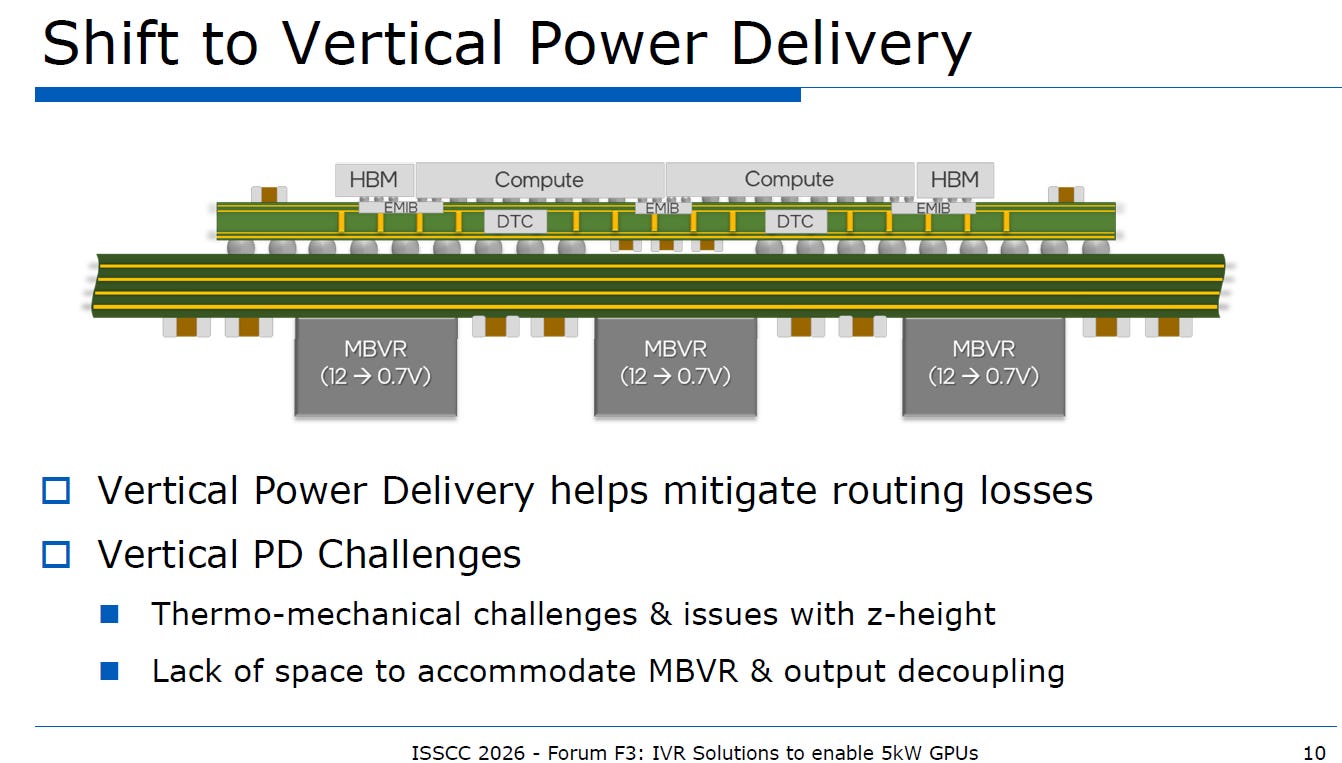
轉向垂直供電 (Vertical Power Delivery, VPD)
垂直供電(VPD)提出了最直觀的物理改善方案:縮短傳輸距離。
source: ISSCC26 F3.1
架構改變:VPD 將 MBVR 直接移至主機板的背面,正對著運算晶片的正下方。電流不再需要橫向跋涉,而是直接「垂直」穿過 PCB (透過 Via 孔) 進入晶片。
優勢:大幅縮短了高電流的傳輸路徑,有效減輕了 PCB 走線造成的I²R路由損耗 (Routing losses)。
面臨的挑戰:
熱力學與機械應力 (Thermo-mechanical challenges):MBVR 本身也是個發熱源,將其直接放在高溫 GPU 的正下方,會讓散熱變得極度複雜。同時,這也增加了整體 Z 軸的厚度。
空間限制 (Lack of space):晶片正下方通常佈滿了用於穩定電壓的高頻去耦電容 (Decoupling capacitors)。將 MBVR 移至此處,會與這些關鍵電容爭搶極其有限的物理空間。
Marvell 的封裝內建電壓調節 (PIVR) 實例
將供電模組直接整合進晶片封裝內部 (Package-Integrated Voltage Regulation,PIVR),這是解決「最後一吋」損耗的終極方案。

source: Marvell
架構差異:不同於 VPD 只是將 供電模組放在主機板背面,Marvell 的 PIVR 是將供電模組直接做在加速器晶片封裝的底部 (underside),物理距離縮到最短。
技術效益:
降低 85% 的 IR 功耗損耗:因為傳輸距離幾乎為零,徹底消除了 PCB 走線帶來的電阻損耗,這直接轉化為降低15% 的整體產品功耗。
減少 60% 的電源雜訊 (Power Noise):從右側的暫態響應圖可以看出,當晶片負載瞬間變化時,傳統做法 (Standard practice,灰線) 會產生極深的電壓驟降 (Voltage Droop) 與劇烈震盪。而採用 PIVR 後 (藍線),由於供電模組離核心極近,能極速響應電流變化,使電壓驟降幅度大幅縮減 60%,確保晶片在高頻運作時的穩定性。
總結來說,從 Lateral PD 到 Vertical PD,再演進至 PIVR,這條技術路線的核心邏輯就是對抗I²R 物理法則,透過極致縮短大電流的傳輸距離,來改善系統的效能。
1.3. Intel 工藝
Intel 透過先進封裝技術與微觀被動元件的整合,來解決高階 AI 晶片 (XPU) 面臨的供電(IVR)與去耦 (Decoupling)的挑戰:
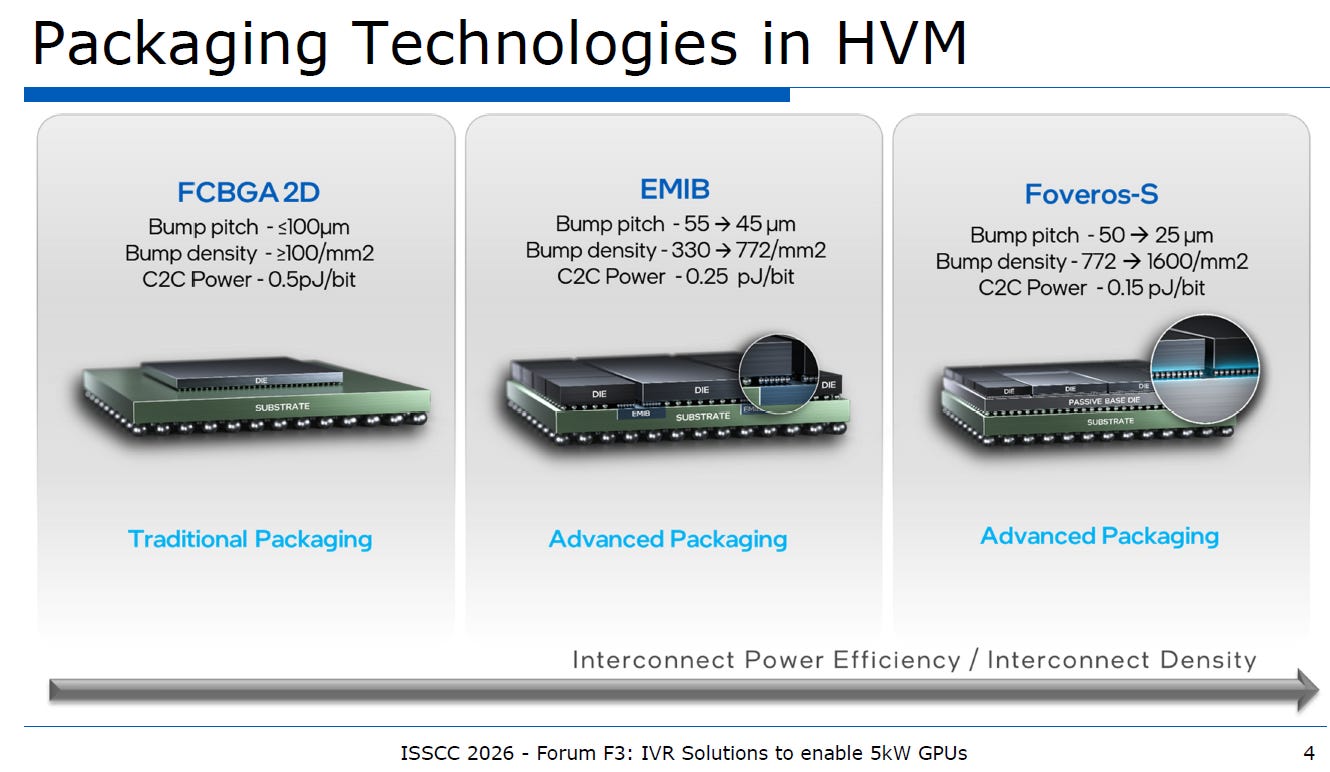
Intel 先進封裝工藝與 TSMC 家族對比
在提升互連密度與降低 C2C (Chip-to-Chip) 傳輸功耗的發展上,Intel 與 TSMC 採取了不同但目標一致的技術路徑:
source: ISSCC26 F3.1EMIB (2.5D 局部矽橋) vs. TSMC CoWoS 家族
技術特徵:EMIB (Embedded Multi-die Interconnect Bridge) 是將微小的矽橋埋入有機載板中,僅在需要高頻寬晶片互連 (如 XPU 之間,或 XPU 與 HBM 之間) 的局部區域提供高密度佈線。其 Bump pitch 正朝 45μm 推進,C2C 功耗降至 0.25 pJ/bit。
TSMC 對標:EMIB 的架構最接近 TSMC 的CoWoS-L。CoWoS-L 同樣捨棄了昂貴的大面積全矽中介層 (CoWoS-S),改採用局部矽橋 (LSI) 搭配重佈線層 (RDL),解決單一大面積矽中介層在製造的良率問題。
Foveros-S (3D 堆疊) vs. TSMC SoIC
技術特徵:Foveros 屬於 3D 異質整合技術,透過微凸塊 (Microbumps) 進行晶片堆疊。Foveros-S 的 Bump pitch 推進至 25μm,C2C 功耗極低 (0.15 pJ/bit)。
TSMC 對標:IntelFoveros-S對標 TSMCSoIC-P(微凸塊 (Microbump) 架構),此層級著重於良率控制與供應鏈的成熟度;而在無凸塊 (Bumpless) 架構方面,TSMC 採用銅對銅混合鍵合 (Hybrid Bonding) 的SoIC-X能提供小於 10 微米的極小間距與優異的寄生電容表現,Intel 則是透過同屬無凸塊架構的高階Foveros Direct進行直接對標。
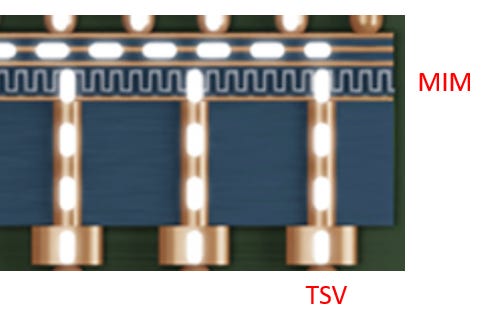
供電架構演進:從 EMIB 到 EMIB-T

source: ISSCC26 F3.1
第一代 EMIB:僅作為訊號傳輸的橋樑。在供電路徑上,電流必須繞過 EMIB,這在 KW 等級的高功率密度下,會造成顯著的 IR Drop (壓降) 與路徑擁擠。
EMIB-T (包含 MIM & TSV):透過在矽橋中打穿矽穿孔 (TSV),電源可以直接垂直穿透EMIB供應給上方的 XPU。同時,內部整合了MIM(金屬-絕緣體-金屬) 電容,進一步縮短去耦電容與運算核心的物理距離。
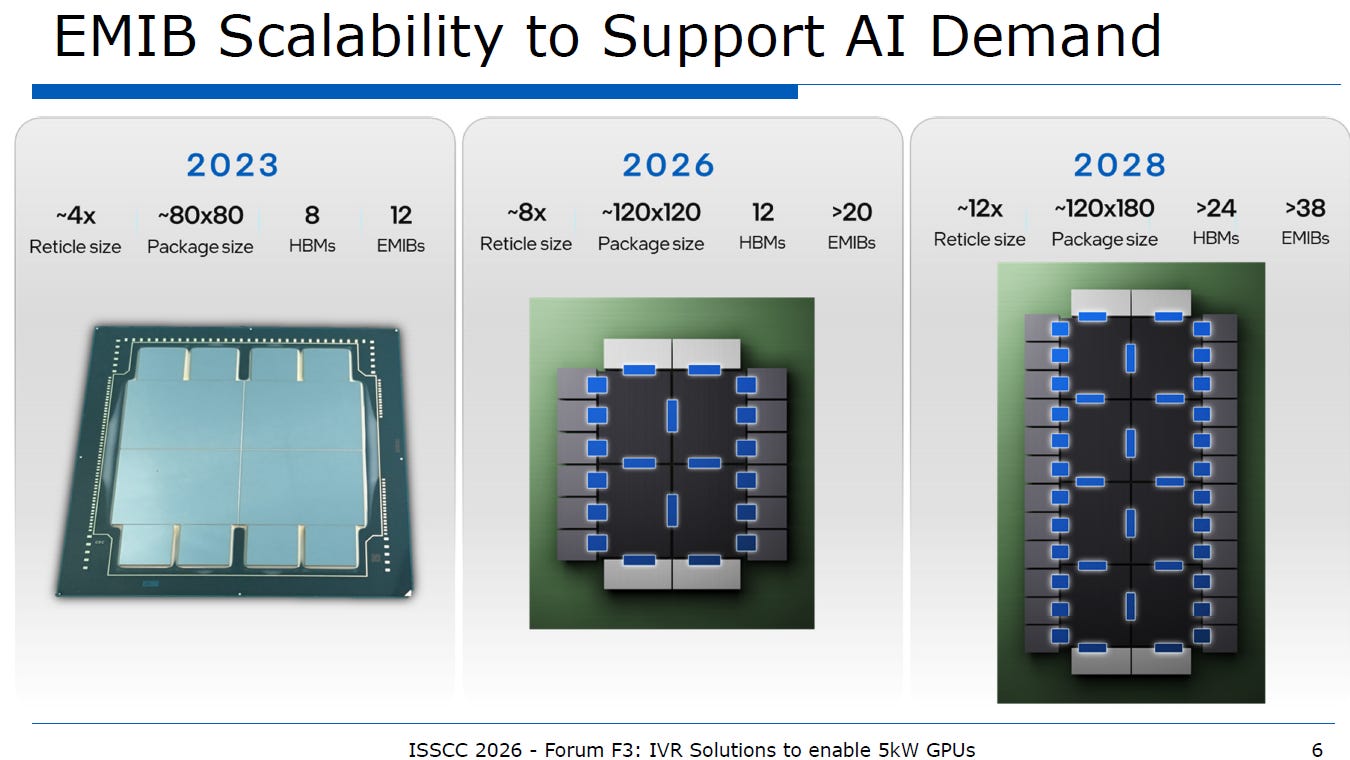
AI 算力驅動的 EMIB 擴展性 (Scalability)
面對 AI 模型參數量的暴增,封裝尺寸 (Package size) 正以驚人的速度擴張:
source: ISSCC26 F3.1
擴展趨勢:從 2023 年約 4 倍光罩極限 (Reticle size)、支援 8 顆 HBM,預計到 2028 年將擴展至12 倍光罩極限(120x180 mm)、支援超過 24 顆 HBM,並需要植入超過38顆 EMIB 矽橋。
與 TSMC 的競爭態勢:這與 TSMC 發展 CoWoS-L 擴展版 (從 3.3X, 5.5X 到未來的 8X 甚至更大) 的軌跡完全一致。當封裝尺寸超越 100x100 mm 時,有機載板的翹曲 (Warpage) 控制與大電流供電網路的佈局,將成為所有晶圓代工廠面臨的共同物理極限。
先進封裝級去耦 (Decoupling) 解決方案:HD MIM 與 DTC
為了解決大電流瞬間抽載產生的電壓驟降 (Voltage Droop),Intel 在不同層級配置了不同特性的電容元件:
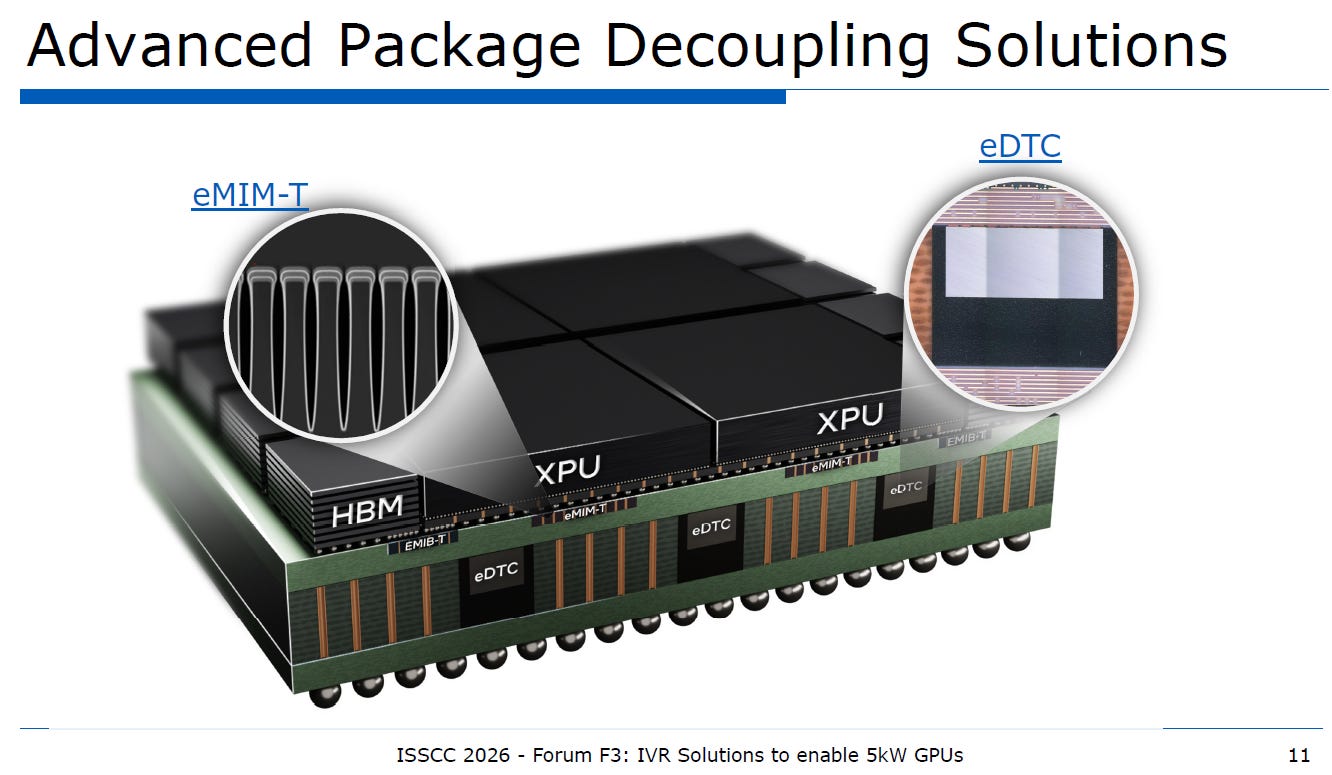
source: ISSCC26 F3.1DTC (Deep Trench Capacitor / 深槽電容):
位置與特性:前段矽基板 (FEOL) 製程,通常嵌在獨立的矽晶粒或中介層底部 (如圖中的 eDTC)。
任務:耐壓較高 (1.8V - 2.4V),主要負責大能量的儲存與搬運,適合做為電壓穩壓器的飛電容 (Flying capacitor)。採用成熟的 22nm 製程即可製造,兼顧經濟效益與良率。
HD MIM (High Density MIM / 高密度金屬電容):
位置與特性:直接整合於最先進邏輯製程的後段金屬層 (BEOL) 或背面供電層中。
任務:工作電壓極低 (< 1.0V),負責處理 nanosecond (ns) 等級的極高頻瞬態突波去耦。它向上生長形成密集的梳狀網絡,極度昂貴且製程複雜,但因距離電晶體閘極最近,是維持運算穩定度「最後一微米」的關鍵。

Intel 18A將高密度金屬電容 (HD MIM) 整合於背面供電網路 (BSPDN/PowerVia) 的核心效益,可歸納為以下三點:
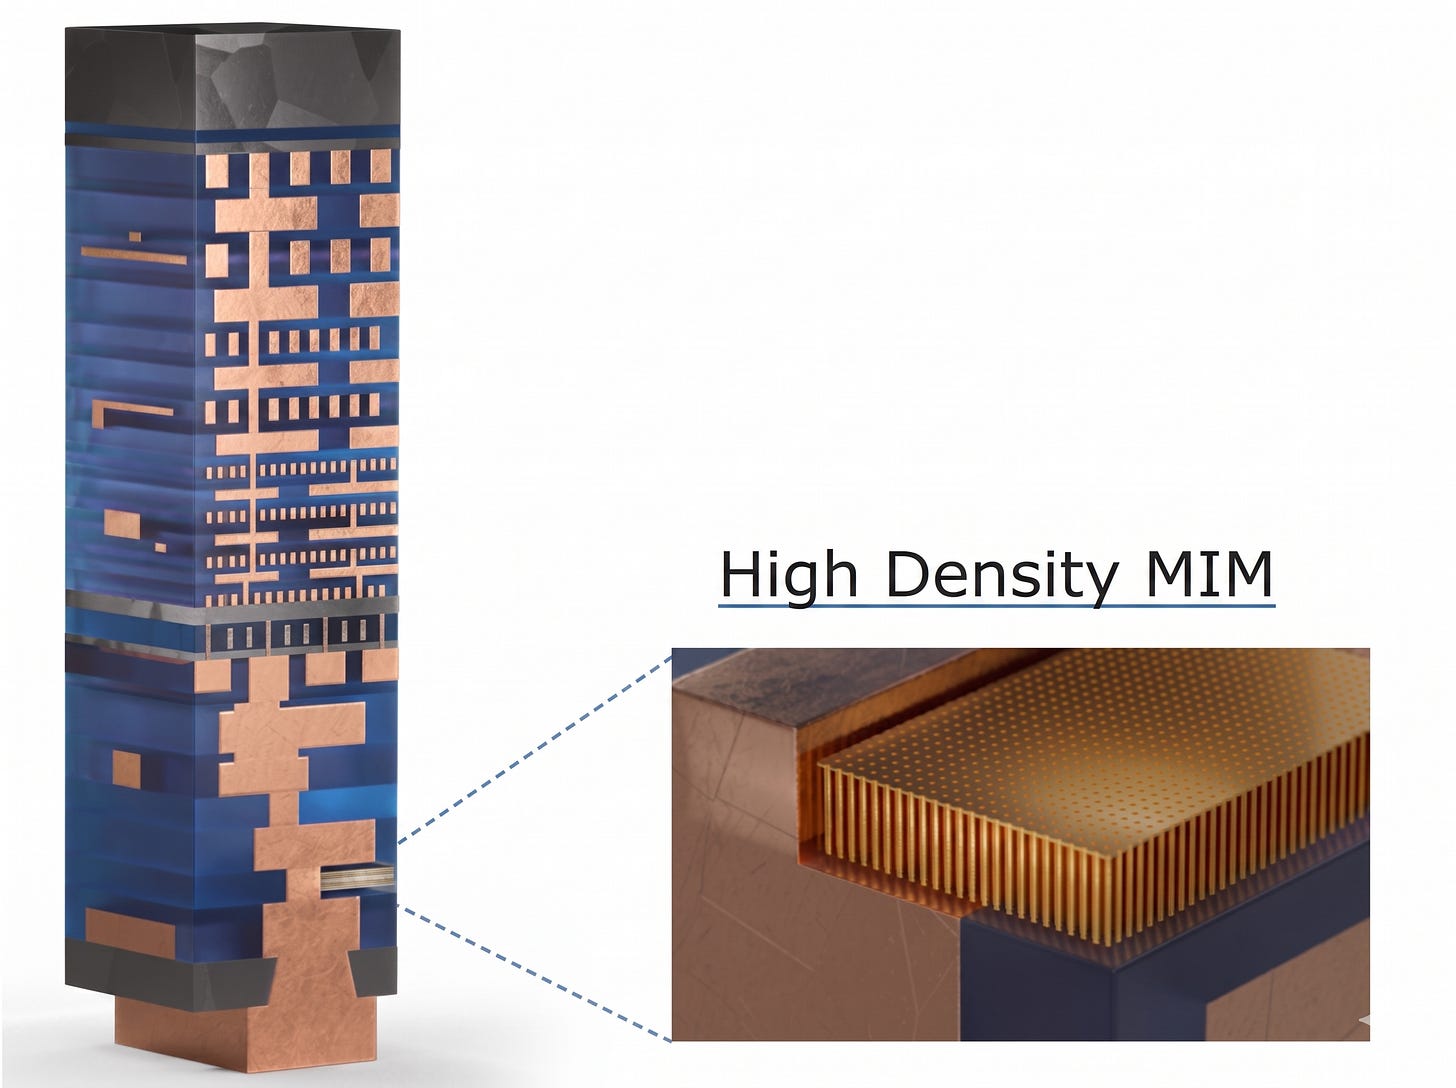
空間佈局最佳化:將供電網路移至晶片背面,徹底分離電源與訊號佈線,釋放晶片正面 (BEOL) 寶貴的訊號傳輸資源,避免去耦電容佔用空間。
瞬態響應極大化:讓電容在物理位置上極度貼近電晶體層,大幅降低傳輸路徑的寄生電阻與電感,實現奈秒 (ns) 級的電壓驟降 (Droop) 瞬間補償。
電容密度極致化:採用微觀的 3D 梳狀金屬結構,在極微小的體積內最大化相對表面積,確保在極低工作電壓下仍能提供龐大的電容值。
2. Inductive IVR
2.1. Fundamental
Buck DC-DC Converter (降壓型直流轉換器) 簡介
降壓轉換器是將較高電壓 (如 48V 或 12V) 降至處理器所需低電壓 (<1V) 的基礎拓撲結構:
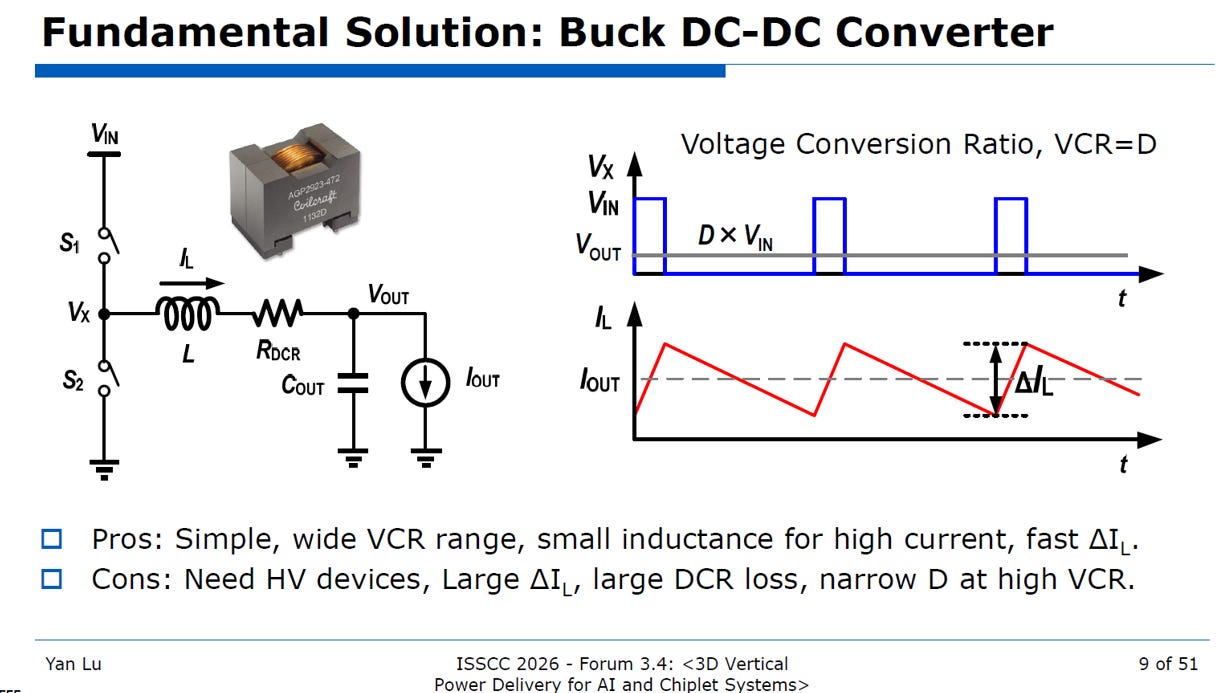
source: ISSCC26 F3.4
工作原理:透過開關S1與S2的高頻切換,將輸入電壓VIN斬波。配合電感L儲能與濾波,輸出平滑的直流電壓VOUT。
電壓轉換比 (VCR):VOUT=DxVIN,其中D為工作週期 (Duty Cycle,即開關導通時間佔總週期的比例)。
優勢 (Pros):架構簡單、轉換電壓範圍廣。為了因應高電流與快速的瞬態響應需求,通常會採用較小的電感值,以換取較快的電流爬升率 (ΔIL)。
挑戰 (Cons):在高壓降比(High VCR,例如 48V 降至 1V) 時,D值會變得極窄,控制難度高。此外,快速的電流變化ΔIL會帶來較大的漣波,且電感本身的直流電阻 (RDCR) 也會造成能量損耗。
用於 VPD 的電感器技術評估 (Inductors for VPD)
在垂直供電架構中,電壓調節模組 (VRM) 被移至主機板背面或直接整合於封裝內,這對電感器的體積與效能提出了極端要求。下圖評估了不同電感技術在「功率密度 (Po/footprint)」與「直流品質因數 (Qdc)」上的表現:
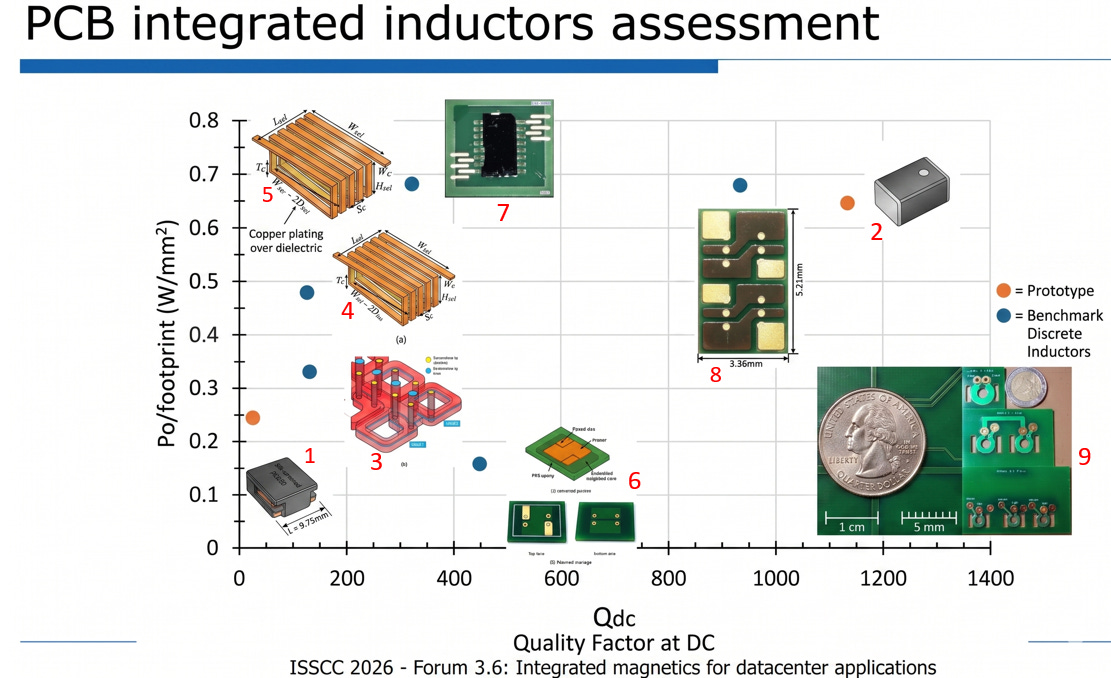
source: ISSCC26 F3.6離散元件的侷限:
圖中編號 1, 2 。代表基準的離散型電感 (Benchmark Discrete Inductors)。雖然效能穩定,但體積過大,難以塞入晶片正下方的狹小空間。
空心電感 (Air-core Inductor):
圖中編號 3,4,5。這類電感不使用磁芯材質。
優點:沒有磁飽和問題,適合極高頻操作。
缺點:為了達到足夠的電感值,通常需要較大的體積或更多圈的線圈,導致直流電阻 (DCR) 增加,且容易產生嚴重的電磁干擾 (EMI)。
PCB 整合型磁芯電感 (PCB Integrated Magnetic Core Inductors):
如圖中編號 6,7,8,9 所示的結構,這是目前發展的重點方向。
技術特徵:將磁性材料直接嵌入或電鍍 (Copper plating over dielectric) 於 PCB 的介電層中,並利用 PCB 的銅箔走線形成線圈。
優點:大幅縮小了 Z 軸厚度與整體佔地面積 (Footprint),能夠直接埋入主機板中,完美契合 VPD 縮短供電路徑的需求。從圖表也可看出,這類技術正努力在有限的體積下,推升其功率密度表現。
2.2. Intel inductive FIVR solutions
Intel 在全整合電壓調節器 (FIVR, Fully Integrated Voltage Regulator) 技術上,從早期的架構探索到現今應對極端伺服器算力的演進路線。以下介紹這過程的工程物理挑戰與技術突破:
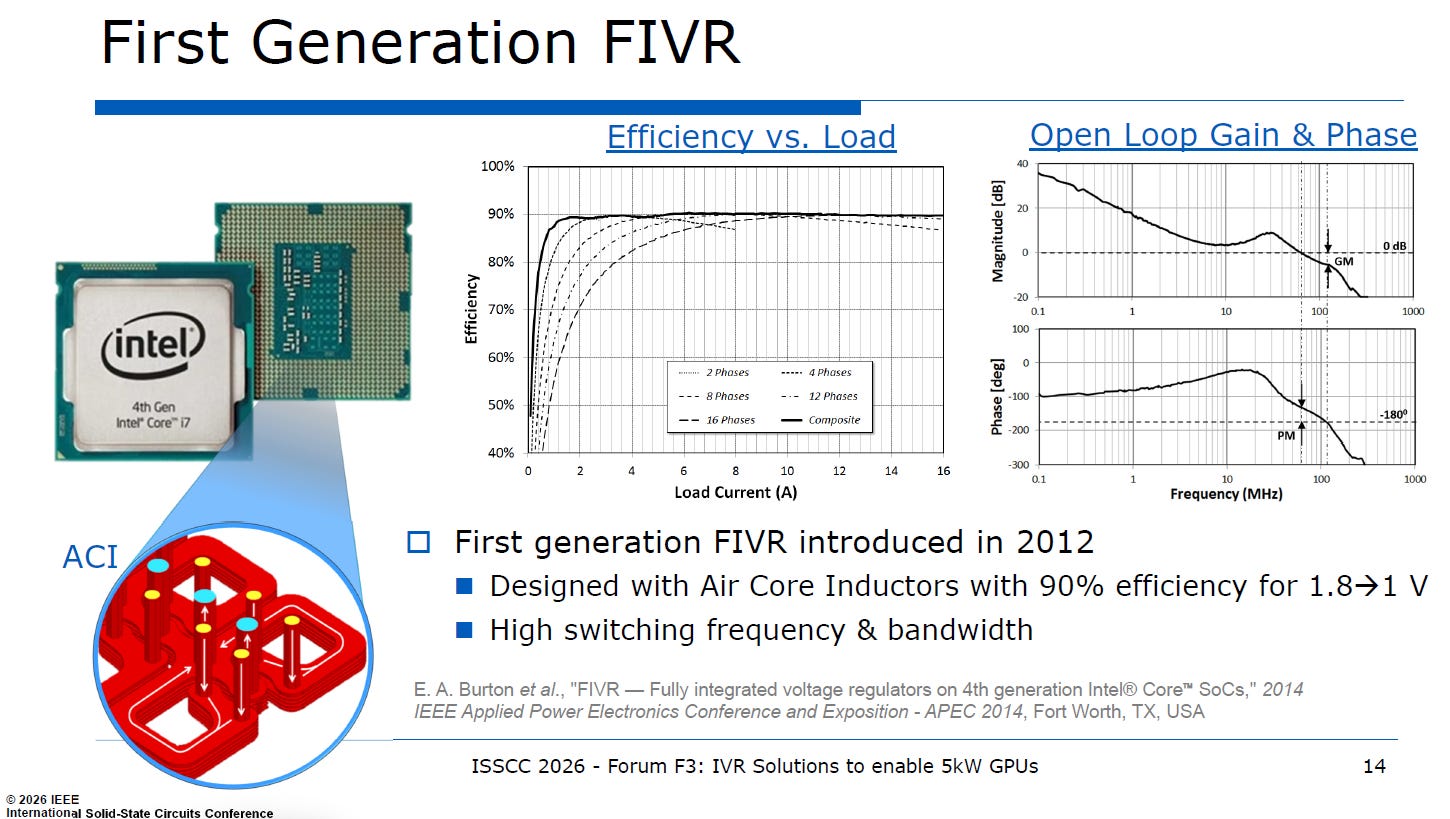
第一代 FIVR 與空心電感 (Air Core Inductor) 的瓶頸
source: ISSCC26 F3.1
開創性的第一步:Intel 在2012年的第 4 代 Core 處理器上首度引入 FIVR,成功將電壓切換開關整合進 SoC 內部,並在封裝載板中設計了空心電感 (ACI)。這在當時達成了 1.8V 降壓至 1V 約 90% 的轉換效率,展現了高頻切換的優勢。
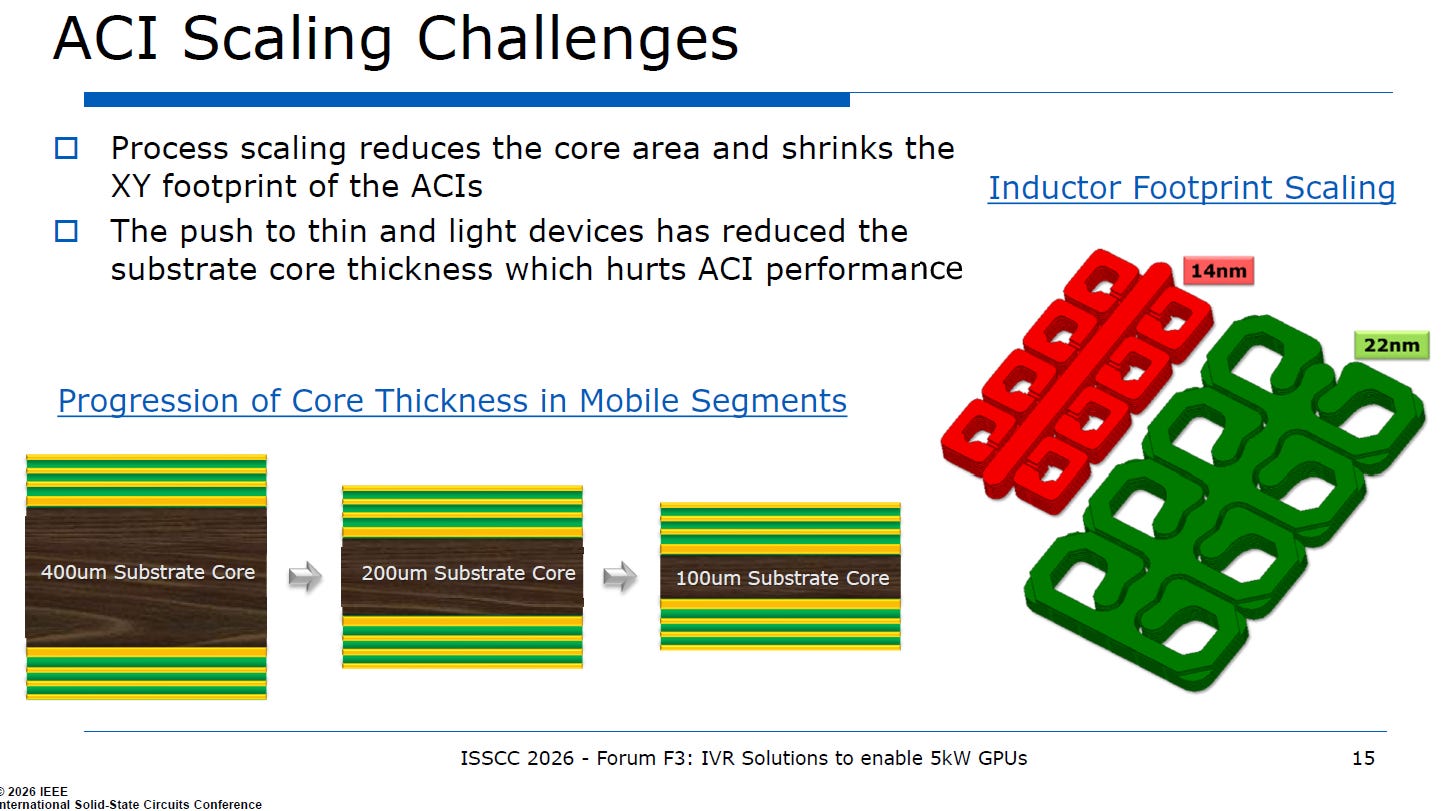
微縮挑戰 (叫好不叫座的主因):從下圖「ACI Scaling Challenges」可以清楚看到其發展撞牆的原因。空心電感沒有磁芯,完全依賴「物理空間」的線圈來產生電感量。但隨著終端裝置追求輕薄,封裝載板核心厚度從 400 微米被大幅壓縮至 100 微米,加上晶片 XY 軸面積縮小,導致 ACI 的效能急速劣化,無法應付未來倍增的電流需求。
source: ISSCC26 F3.1
轉向磁性電感:CoaxMIL (同軸磁性整合電感)

source: ISSCC26 F3.1
材料架構的革新:為了解決空心電感極度依賴體積的致命傷,Intel 轉向開發CoaxMIL技術。從剖面圖 (Cross-section) 可以觀察到,這項技術是在封裝載板核心的電鍍通孔 (PTH Via) 外圍,直接包覆了一層磁性材料 (Magnetic Material)。
突破物理限制:透過導入高導磁率的磁性材料,系統得以在極度受限的 Z 軸厚度與微小的 footprint 中,創造出足夠的電感量。這不僅大幅提升了電流密度,也進一步優化了整體 FIVR 的轉換效率 (如圖表所示的不同電壓與電流負載曲線),完美契合資料中心CPU的需求。
產品化實力:第 6 代 Xeon 處理器的垂直供電 (VPD)
source: ISSCC26 F3.1
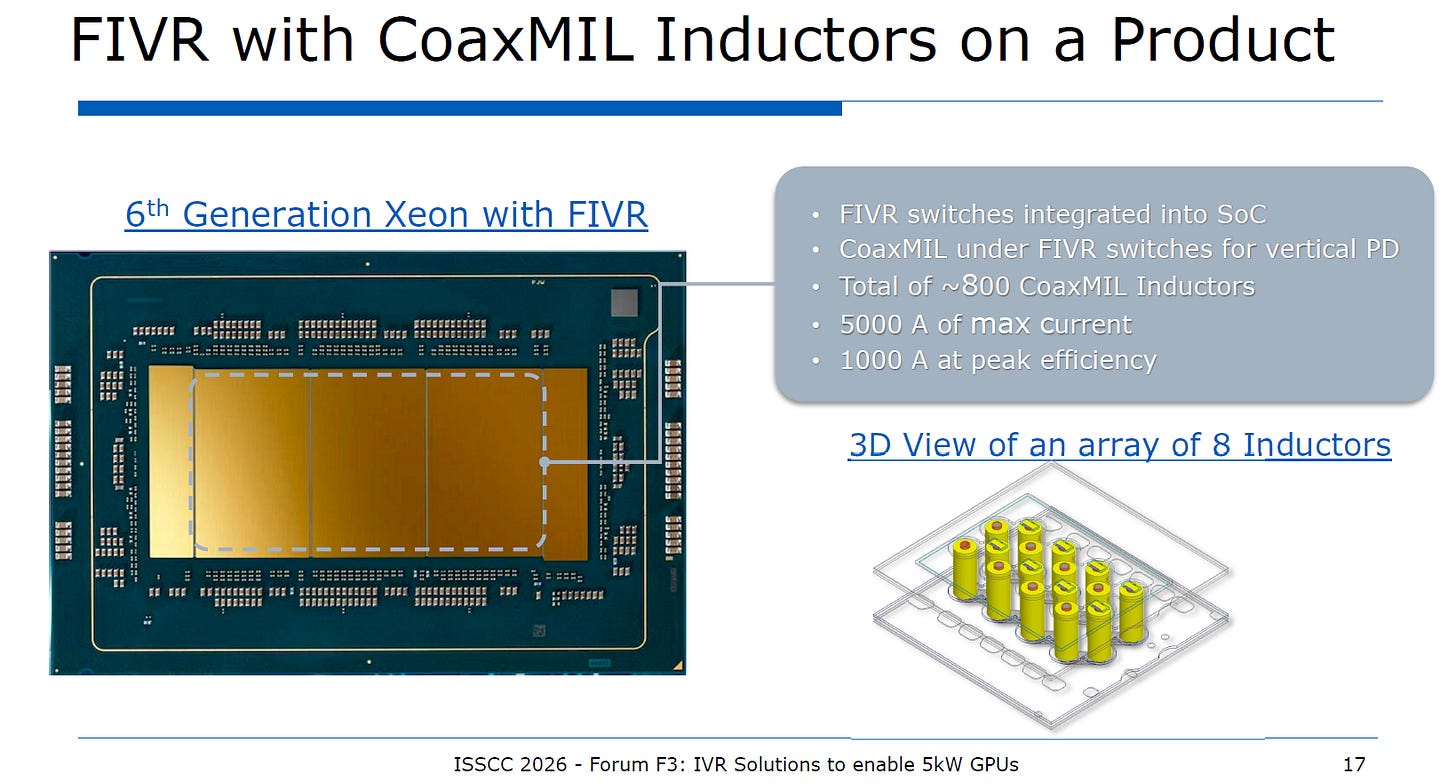
架構大成:在最新的第 6 代 Xeon Granite Rapids處理器上,Intel 將這項技術推向了極致。FIVR 的切換開關維持在 SoC 內部,而數量龐大的 CoaxMIL 電感則緊貼配置於開關正下方的封裝載板內,達成了真正意義上的垂直供電 (Vertical Power Delivery),將大電流的傳輸路徑與寄生電阻降至最低。
供電規模:單一處理器封裝內部署了高達約 800 顆的 CoaxMIL 電感陣列,能夠應付高達 5000 安培 (5000 A) 的極端瞬態最大電流,並在 1000 安培的重度負載下依然維持峰值效率。這證明了磁性整合電感已經完全具備支撐下一代高階 AI 與 HPC 運算核心的實力。
雖然Intel沒正式說Neon 6+ClearWater Forest(18A製程, 3D Foveros封裝 )是否用相同VPD技術,基於以下推論,應該也是用FIVR with CoaxMIL的垂直供電架構:
封裝平台共用:Xeon 6+ 延續使用 Xeon 6 的實體插槽與基礎設施(如 LGA 7529 插槽),因此必然繼承封裝基板內已建置的 CoaxMIL 磁性電感陣列。
垂直傳輸效率:為了讓頂層 18A 運算核心的背面供電 (PowerVia) 達到最佳效率,將 FIVR 整合於正下方的 Base Die 中,形成最短的直線降壓路徑,能將物理傳輸損耗降至最低。
小晶片模組化:Intel 的 3D 封裝策略允許保留負責供電網路與訊號路由的Base Die,僅升級頂層的運算晶片,這符合半導體迭代的標準架構設計。

僅供參考
2.3. IVR Requirement for GPU
CPU 與 GPU 在供電架構設計上有本質的差異,Intel 在 CPU 上成功的 FIVR (Fully Integrated Voltage Regulator,整合於 SoC 內) 架構,並不適合直接套用於高階 GPU。
為何 FIVR (整合於 SoC 內) 適合 CPU,卻不適合 GPU?

source: ISSCC26 F3.1CPU 的特性 (適合 SoC 內建 IVR)
細粒度控制需求:CPU 運作強調單執行緒效能,常常需要針對單一核心 (Per core granularity) 進行獨立的頻率與電壓動態調整 (DVFS)。
供電區域小:其供電區域 (Domains) 相對較小且分散。
架構匹配:將 IVR 的切換電路直接做在 SoC 內部,搭配封裝載板內的 CoaxMIL 電感,能最快響應各別核心的瞬態需求。
GPU 的特性 (需採用解耦合的獨立 IVR Chiplet)
大面積同步運算:GPU (尤其是 AI 加速器) 的架構是成千上萬個核心同時執行相同的指令。它不需要針對單一微小核心做獨立電壓控制,而是需要極大面積的單一供電區域 (Large domains)。
極端高溫與空間排擠:GPU 核心發熱極大。若將 IVR 切換電路整合進 GPU SoC 內部,不僅會加劇晶片本身的散熱負擔,還會佔用極其昂貴的先進製程晶粒面積 (排擠運算邏輯的空間)。
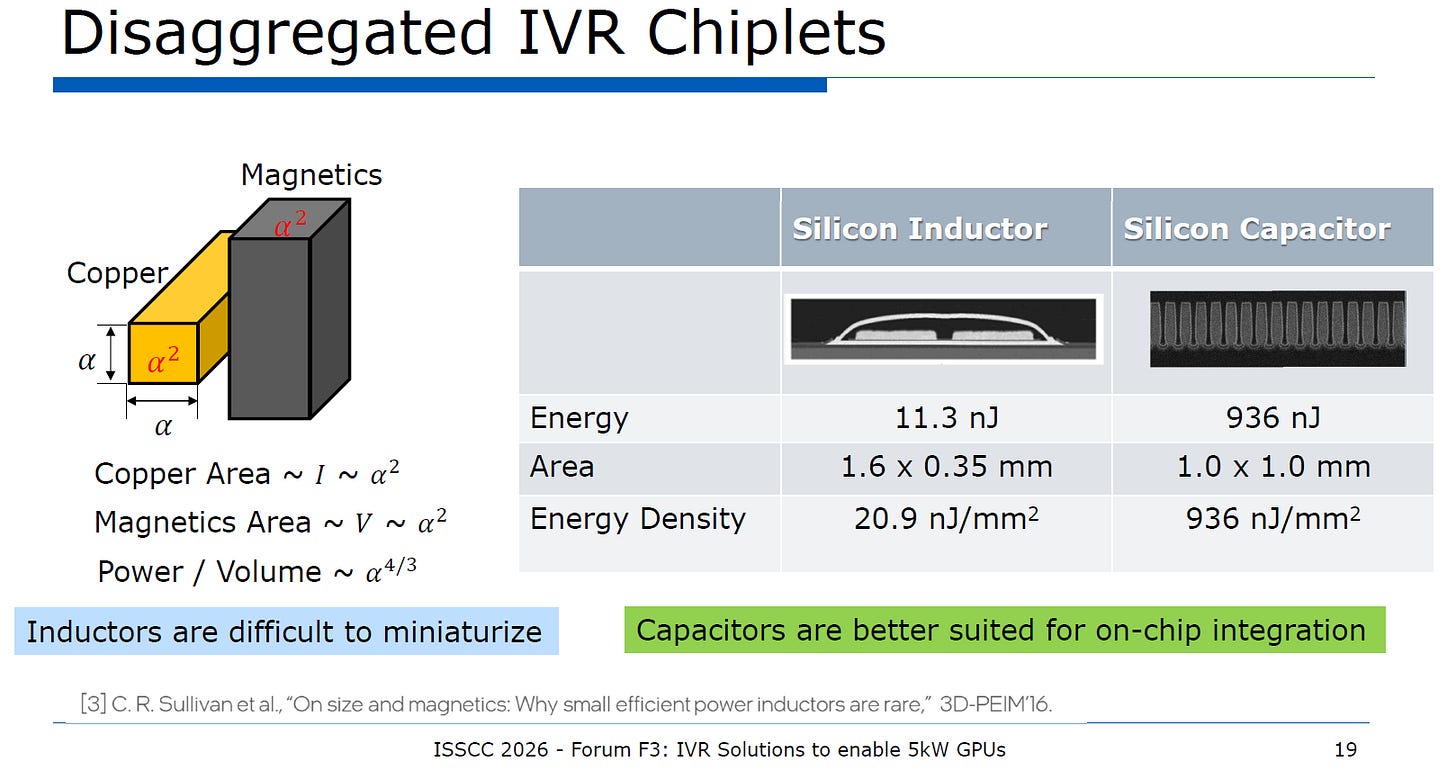
解決方案:Disaggregated VR Chiplet:因此,針對 GPU 必須採用「解耦合 (Disaggregated)」架構。也就是將 IVR 做成獨立的小晶片 (VR Chiplet),並將其垂直安裝在 GPU 封裝載板的背面 (Landside attach)。這樣既能實現垂直供電縮短路徑,又能避免與 GPU 核心爭搶先進製程空間與散熱餘裕。
IVR Chiplet 的元件選擇:矽電感 vs. 矽電容
source: ISSCC26 F3.1矽電容 (Silicon Capacitor) 的優勢
電容的能量儲存機制不涉及磁場,其能量密度極高。從表格中可見,同樣面積下,矽電容的能量密度高達936 nJ/mm²。
結論:電容非常適合微縮,並容易整合到晶片 (on-chip) 內部或 IVR Chiplet 中。
矽電感 (Silicon Inductor) 的物理天花板
電感依賴體積來儲存磁能。銅線面積與電流成正比 (與 α² 相關),磁芯面積與電壓成正比 (與 α² 相關),而整體「功率對體積」的比例則呈現非線性的α4/3縮減。
簡單來說,當電感的物理尺寸縮小 (α 變小) 時,它能處理的功率會以更快的速度急遽下降。
從表格數據也能證實這點:矽電感的能量密度僅有20.9 nJ/mm²,遠遠落後於矽電容。
3. Capacitive IVR
3.1. Fundamental
透過下面兩張圖,說明開關電容電壓調節器 (Switched-Capacitor Voltage Regulator,SCVR) 的運作機制,以及它最致命的物理限制:電荷共享損耗 (Charge Sharing Loss)。
SCVR 運作機制與水桶模型
利用水桶模型生動地解釋了 SCVR 的基本原理。不同於依賴電感的 Buck Converter,SCVR 完全依靠「電容」與「開關」來傳遞能量。

source: ISSCC26 F3.4核心元件對應:
飛電容 (CFLY):就像一個用來舀水的「杯子」。它在輸入端與輸出端之間不斷切換,負責搬運電荷。
負載電容 (CL):就像一個「大水桶」。它負責儲存電荷,穩定輸出電壓。
負載電流 (IL):如同水桶底部的「破洞」,代表運算核心正在消耗電荷(水)。
運作週期:
充電階段 (S2 導通,S1 斷開):飛電容 (CFLY) 連接到輸入電壓 (VIN),像杯子接水一樣充滿電荷。
放電階段 (S2 斷開,S1 導通):飛電容 (CFLY) 連接到負載電容 (CL),將杯子裡的水倒進大水桶中。
理想轉換與瓶頸:
圖中顯示這是一個VCR = 1/2的架構,代表理想情況下,它可以將電壓精準砍半。
當系統需要極大的電流時,就必須加快「舀水」的頻率 (Fast switching)。但圖中明確指出,當頻率拉高時,「開關 (Switch)」本身就成了最大的瓶頸,就像杯口太小,水倒不快一樣。
致命硬傷:電荷共享損耗 (Charge Sharing Loss)
SCVR 在非理想狀態下,會產生嚴重的熱能耗散。

物理本質:
這是一個純物理定律的限制。當兩個電壓不相等的電容(就像圖中水位不同高的水塔 1 與 2)被強行連接在一起時,電荷會劇烈流動直到兩者電壓(水位)平衡。
在這個電荷重新分佈的瞬間,必然會產生能量損耗。這與水流衝擊產生的亂流或摩擦生熱非常相似。
損耗公式解密:
圖中給出了關鍵公式:Energy Loss = ½ x [C1C2/(C1+C2)] x (∆V)2
這裡最致命的是(∆V)2。它代表兩個電容連接瞬間的「電壓差的平方」。
重要的是,「不論 MOSFET 的導通電阻 (Rds_on) 多低,只要存在壓差,這個損耗就無法避免。」這意味著就算你用了全世界最好的開關,只要設計上出現壓差,能量就會憑空變成熱能燒掉。
完美效率與效率崩塌的分水嶺
當剛好是整數比例轉換 (例如精準的 2:1):如果輸入電壓剛好是輸出電壓的兩倍 (VIN= 2xVOUT),飛電容在充電與放電切換時,與目標端之間幾乎沒有電壓差 (∆V ≈ 0)。此時 Charge Sharing Loss 趨近於零,SCVR 可以展現出極其驚人的高轉換效率。
當偏離理想比例 (出現壓差):如果輸入電壓變動,或者負載需要非 2:1 的電壓(例如需要 1.8:1),飛電容在切換瞬間就會與系統產生電壓差 (∆V> 0)。由於損耗與壓差的平方成正比(如前圖右下角的拋物線圖),此時 Charge Sharing Loss 會急速飆升,導致轉換效率暴跌,並引發嚴重的熱暴走。
3.2. Intel C2VR solutions
C2VR 架構介紹:以 CSCR 解決傳統 SCVR 的調變瓶頸
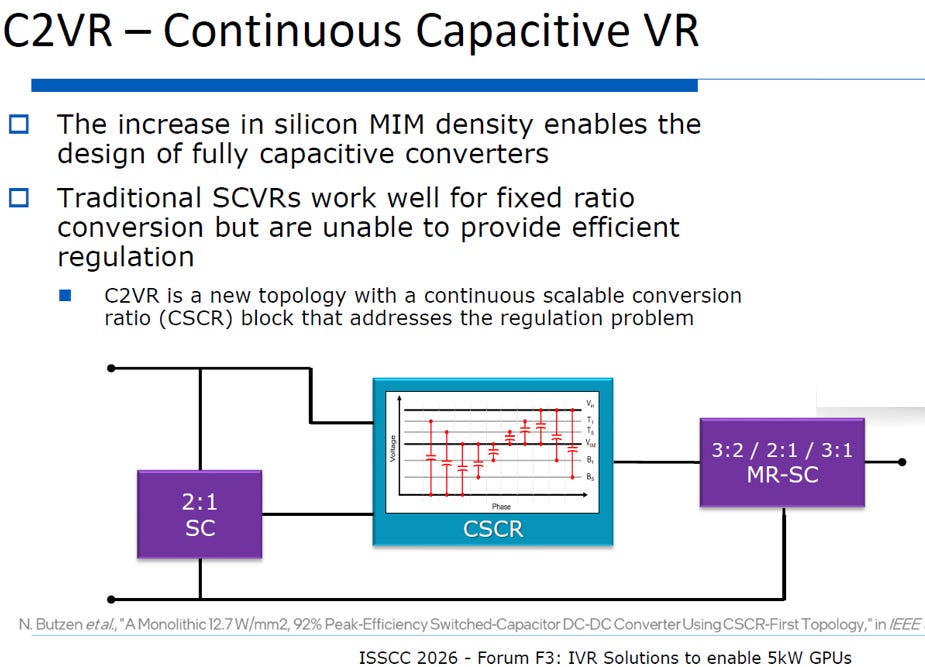
傳統的開關電容電壓調節器 (SCVR) 在「固定轉換比例 (Fixed ratio)」下具有極高的轉換效率,但缺乏連續調節電壓的能力。當系統需要偏離固定比例的電壓時,傳統 SCVR 會產生嚴重的電荷共享損耗,導致效率大幅下降。
為了克服此限制,Intel 提出了C2VR (連續電容式電壓調節器)拓撲:
source: ISSCC26 F3.1
核心技術 (CSCR):C2VR 架構導入了連續可調轉換比例 (Continuous Scalable Conversion Ratio,CSCR) 區塊。
運作機制:如前圖所示,系統將CSCR區塊配置於固定的 2:1 轉換模組與多比例 (3:2 / 2:1 / 3:1) 轉換模組之間。CSCR區塊能提供平滑且連續的電壓調變能力,有效解決了純電容式轉換器無法進行高效能電壓調節 (Regulation) 的根本問題。
晶圓製造合作:Intel 與 UMC 的 12nm C2VR Chiplet
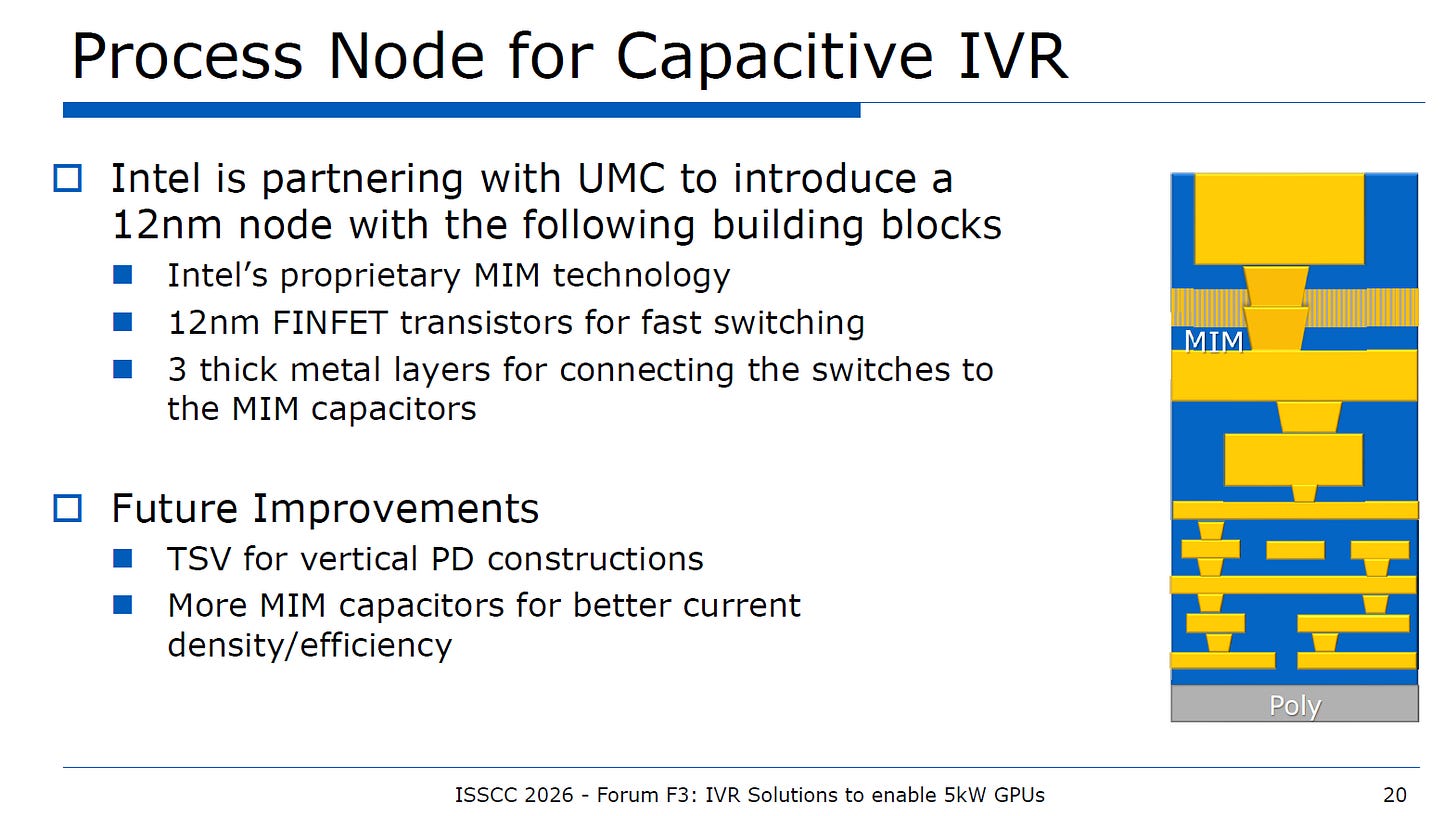
為了將 C2VR 實體化為獨立的供電小晶片,Intel 選擇與聯電 (UMC) 進行製程合作,開發專屬的12nm節點。此製程結合了雙方的技術優勢:
source: ISSCC26 F3.1
12nm FinFET 電晶體:提供極快的開關切換速度,滿足高頻運作需求。
Intel 專利 MIM 技術:在晶片中整合高密度MIM(金屬-絕緣體-金屬) 電容,做為能量傳遞與儲存的核心。
厚金屬層設計:採用 3 層厚金屬層,以極低的電阻連接電晶體開關與 MIM 電容,減少內部傳輸損耗。
未來發展 (Future Improvements):藍圖中規劃將導入矽穿孔 (TSV) 技術以建構真正的 3D 垂直供電,並進一步增加 MIM 電容密度來提升電流密度與轉換效率。
測試晶片效能表現 (Test Chip Performance)
C2VR 採用了「Landside Implementation (載板底部安裝)」的配置方式,將 C2VR 小晶片直接安裝於 GPU 封裝載板的正下方,實現最短路徑的垂直供電。其實際測試數據展現了高度的實用性:

source: ISSCC26 F3.1
峰值效率 (Peak Efficiency):在輸入電壓 2.4V 的條件下,達到了 90.3% 至 90.7% 的峰值轉換效率。
高電流密度:受惠於高密度 MIM 電容,其電流密度可達 10.4 至 10.8 A/mm2,充分滿足高階 GPU 的微縮空間需求。
瞬態響應 (Transient Response):面對 0.2 A/mm2瞬間躍升至 7.5 A/mm2的極端負載變化,系統仍能維持穩定的電壓輸出,展現了優異的動態響應能力。
系統級效率比較:MBVR vs. Landside C2VR (針對 5kW GPU)
導入 IVR 前後的系統總體效率差異,證明了即使增加一級轉換,總體效率依然能獲得提升:

source: ISSCC26 F3.1
傳統橫向供電 (Lateral PD with MBVR):
為提供 GPU 5000W 的功率,主機板上的 MBVR 需輸出高達 7222W 的能量。其中,高達2222W的能量以 I2R 形式消耗在主機板銅箔佈線上,加上壓降產生的無效功率,最終實際用於運算的有用功率僅為 3472W。
C2VR 垂直供電 (Landside C2VR):
導入 C2VR 後,主機板端以較高電壓傳輸,使主機板上的I2R佈線損耗大幅驟降至476W。雖然 C2VR 本身在降壓過程中會產生 556W 的轉換損耗 (IVR Losses),但由於大幅消除了長距離傳輸的佈線損耗與壓降影響,系統最終提供的有用功率提升至 4083W。
結論:
即便多了一道 IVR 轉換關卡,C2VR 垂直供電架構透過「大幅減少主機板I2R損耗」與「降低晶片端電壓驟降 (Droop)」,從系統巨觀角度來看,能有效提升實際交付給 GPU 的可用功率,是解決 5kW 以上運算節點供電瓶頸的關鍵技術路徑。
3.3. Embedded IVR
目前主流:Landside IVR 面臨的物理與架構挑戰
目前主流採用 Landside IVR(如 MPS 等基於 Buck 降壓架構的解決方案)在應對 KW 級別 GPU 時所遭遇的瓶頸。

source: ISSCC26 F3.1
架構配置:Landside IVR配置於封裝載板(Substrate)底部,透過 48V 輸入後進行降壓,再垂直向主晶片供電。
面臨挑戰:
散熱路徑衝突:必須在 PCB 上開孔或加入散熱導通孔(Thermal vias)及銅塊(Copper Slug),以便將 IVR 的廢熱引導至底部的冷卻板(Cold Plate)。
佈線資源與阻抗:Landside IVR 會佔用大量的 BGA 腳位與 PCB 佈線資源,這不僅排擠了 I/O 空間,也導致 IVR 輸入端的寄生阻抗(Resistance)增加。
空間受限:背面散熱板(Backside cold-plate)的存在,壓縮了可用於傳遞輸入電壓的 MBVR(Motherboard Voltage Regulator)面積。
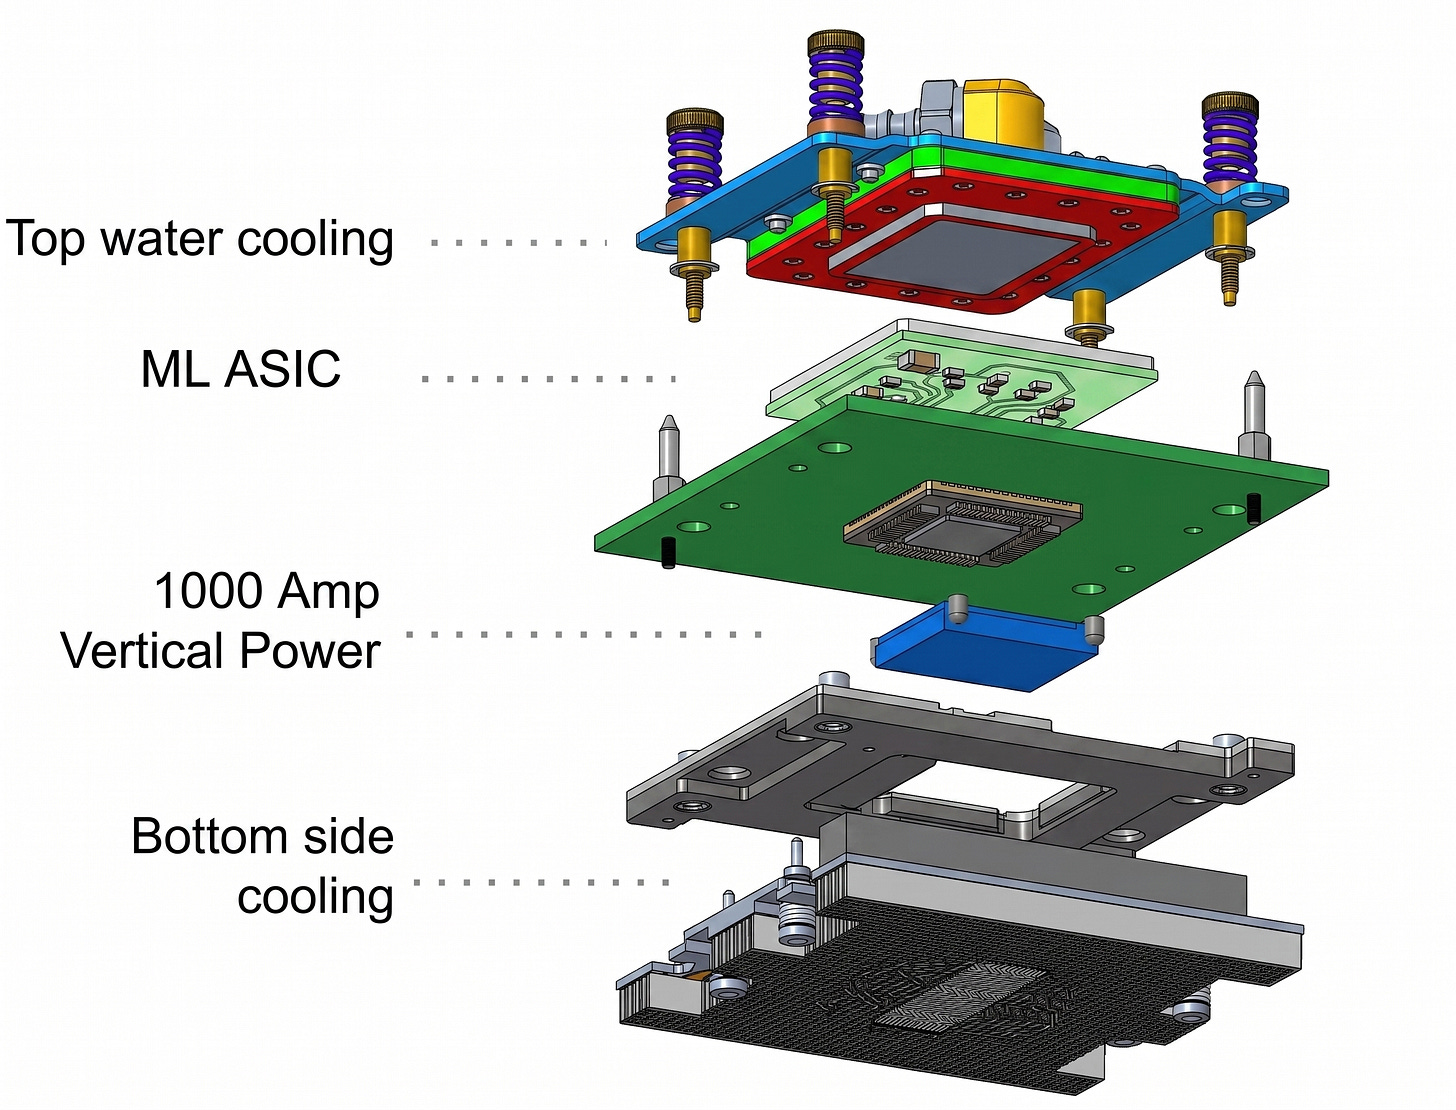
散熱解決方案的複雜化 (Thermal / Cooling Solutions)
source: ISSCC26 F3.2
頂部散熱(Top water cooling):主要負責帶走 ML ASIC 運算核心與周邊 HBM 記憶體的高密度熱能。
底部散熱(Bottom side cooling):專門針對底部的垂直供電模組(如 Landside IVR)進行散熱。
這意味著在系統設計上,必須在極有限的 Z 軸空間內,同時解決大電流傳輸與雙面水冷管線配置的機構挑戰。
頭部廠家積極開發 Embedded IVR:以 Intel C2VR 為例
為了解決 Landside IVR 的上述痛點,次世代的解決方案:將 IVR 嵌入至封裝內部(Embedded IVR Solution)。

source: ISSCC26 F3.1
技術特徵:採用如 Intel 的 C2VR(具有 TSV 矽穿孔設計),其具備極低的 Z 軸高度(Low z-profile),使其能夠直接嵌入載板的增層(Build-up layer)中,位於 Compute Die 與 HBM 的正下方。
架構優勢:
大幅縮短供電路徑,有效降低 IVR 輸入端的阻抗(Reduces resistance to IVR input)。
因為 IVR 更靠近頂部的冷卻系統,消除了對底部背面散熱板的需求(Eliminates the need for cooling from the backside),簡化了系統機構。
供電端與負載端(Compute Die)的物理距離極短,改善了瞬態響應(Transient response),從而可以免除或大幅減少對輸出端大電容(Output capacitors)的依賴。
TSMC 與合作夥伴的先進封裝整合:RDL Interposer
台積電(TSMC)針對未來 HPC/AI 所規劃的「TOMORROW」技術平台,展現了更高階的異質整合藍圖。

source: TSM
Interposer 級別的整合:有別於前述嵌入於基板(Substrate)的方案,TSMC 的架構將 IVR、主動裸晶(Active die)、LSI 以及被動元件,直接嵌入至大型 RDL 中介層(Large RDL Interposer)之內。
系統級協同設計:在此平台上,Embedded IVR 與上方的 3D 堆疊晶片(SoIC / Chip 1, 2, 3)、高頻寬記憶體(High Performance Memory),以及側邊的共同封裝光學(Co-Packaged Optics, CPO)形成完整的生態系。
供電網路(PDN)極致化:將 IVR 推進至 RDL Interposer 層,代表電源轉換單元與邏輯運算單元之間的物理距離達到極致最小化,這對於未來超高頻率、大電流且對電壓突降(Voltage Droop)極度敏感的先進製程晶片而言,是不可或缺的基礎設施。
4. Future Plans
Intel 提出的LEGO Converter(樂高轉換器)混合式拓撲架構規劃,目的在於解決次世代高算力晶片(如 5kW 級別的 AI GPU/ASIC)在電源供應上面臨的極端物理限制。

source: ISSCC26 F3.1
階段式降壓機制:此架構透過模組化的堆疊設計來分攤電壓與熱能,包含:
串聯堆疊 (Series stack) 處理 48V 至 16V 的轉換。
2:1 開關電容電壓調節器 (SCVR) 處理 16V 至 8V 的轉換。
多相降壓調節器 (Multi-phase Buck Regulator) 負責 6V 至 1V 的最終降壓。
封裝級實現:在封裝實作上,LEGO 拓撲採用低壓氮化鎵 (LV GaN) 半橋電路搭配離散場效電晶體 (Discrete FETs)、大型積層陶瓷電容 (MLCCs) 以及客製化磁性元件,以堆疊的方式建構高密度的供電模組。
封裝上高壓 IVR (On-Package HV-IVR) 的具體結構

source: ISSCC26 F3.1
適用條件:同時使用電感與電容的 Hybrid 拓撲,最適合用來實現電流密度大於 5 A/mm2的封裝上 HV-IVR。
關鍵建構單元 (Key Building Blocks):
核心開關採用高頻 LDMOS (橫向擴散金屬氧化物半導體) 或 LV-GaN (低壓氮化鎵) 元件。
採用多層核心 (Multi-layer core, MLC) 技術,允許將電感元件直接堆疊於電容之上,極大化 Z 軸的空間利用率。
垂直堆疊圖解:晶片剖面圖顯示完整的垂直供電架構,由上至下依序為頂層的 XPU 與 HBM 運算記憶體陣列,其正下方緊密連接 eMIM-T 進行負載端去耦,中層配置 CoaxMIL (同軸磁性電感) 與作為輸入電容的 eDTC (嵌入式深溝槽電容),最底層則為 HV-IVR 基礎模組。
Intel IVR 技術發展藍圖 (Roadmap)
Intel 揭露了其 IVR 技術跨越二十年的演進時程表:

source: ISSCC26 F3.1
2012年:首次於高量產 (HVM) 產品中導入 IVR,應用於 Intel 第 4 代 Core i7 處理器。
2020年:導入磁性電感 (Magnetic Inductors) 技術 CoaxMIL。
2025年:導入高密度 MIM (High Density MIM) 電容結構(Intel 18A)。
2028年 (預期):預計推出電容式 IVR (Capacitive IVR),將高密度電容進一步整合至運算晶片下方的封裝載板中。
2032年 (預期):計畫實現高壓 IVR (High Voltage IVR),即整合前述 Hybrid 拓撲、LDMOS/GaN 開關與 eDTC/CoaxMIL/eMIM-T 的終極垂直供電架構,以應對未來 5kW 級別的 GPU 功耗需求。
5. 結論
隨著GPU 功耗突破KW級大關,傳統主機板級別的供電設計已走到物理極限 。回顧 Intel IVR 技術的發展,從早期受限於物理空間的空心電感 FIVR,到利用先進封裝整合高密度 MIM 與 TSV 的 C2VR,再到未來旨在克服極端高壓的 LEGO 混合式拓撲 (Hybrid Topologies) ,技術演進的核心邏輯非常明確:極致縮短大電流的傳輸距離、最大化局部能量密度,並將電源模組與運算核心進行深度的 3D 異質整合 。
這場供電架構的革命,已不再僅是單一晶片層級的電路設計問題,它將直接牽動整體資料中心的底層基礎設施佈局 。未來,從 TSMC 的RDL Interposer系統級協同設計,到OCP Diablo計畫針對 700kW 超高功率機櫃所制定的散熱與配電標準 ,硬體架構的解耦與再整合將成為常態。能夠在「電能傳輸效率」與「熱力學限制」之間取得最佳平衡的技術路徑,將決定下一代 AI 算力擴張的真實邊界。
[Reference]
ISSCC2026_Forums_F3.1 Integrated Voltage Regulator Solutions to enable 5kW GPUs
ISSCC2026_Forums_F3V Powering the Future of AI, HPC, and Chiplet Architectures_From Dies to Package and Rack
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


