隨著人工智慧叢集規模急遽擴張,資料中心間(DCI)的Scale-Across流量需求已攀升至 20 Peta bps 等級 。在面對極端頻寬挑戰時,通訊系統的發展受限於夏農定理(Shannon Theorem)所定義的絕對物理極限…
隨著人工智慧叢集規模急遽擴張,資料中心間(DCI)的Scale-Across流量需求已攀升至 20 Peta bps 等級 。在面對極端頻寬挑戰時,通訊系統的發展受限於夏農定理(Shannon Theorem)所定義的絕對物理極限…
- Source: Ted Yu
- Published: 2026-06-17T07:37:24+08:00
- URL: https://ytyuted.substack.com/p/ep49-shannon-cienascale-across EP49. 從Shannon定理探討 Ciena的Scale-Across佈局 - Ted Yu
Pledge your support

EP49. 從Shannon定理探討 Ciena的Scale-Across佈局

Jun 17, 2026
1. Background
1.1. 數位通訊的天花板: Shannon Theorem
克勞德·夏農 (Claude Shannon) 在 1948 年提出的這項定理,就像是為數位通訊設定了宇宙中的「光速」一樣,劃定了一個無法被超越的物理極限。

核心公式:通訊的「物理天花板」
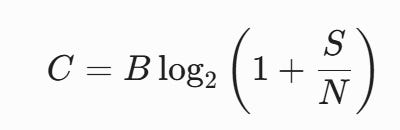
這個公式說明了在一個受到雜訊干擾的通訊通道中,資料傳輸的最大極限速率是由哪些因素決定的:
C (Capacity - 容量極限):代表通訊通道的「絕對物理天花板」,也就是在該通道上能夠實現的最大無誤傳輸速率(通常單位為bps,每秒位元數)。
B (Bandwidth - 頻寬):圖片中稱為「空間橫向擴張」。這是通道可以通過的訊號頻率範圍(單位為 Hz)。頻寬越大,就像馬路越寬,能同時容納的車流(資料)就越多。
S/N(Signal-to-Noise Ratio - 訊噪比):圖片中稱為「能量縱向攀升」。這是訊號功率 (S) 與雜訊功率 (N) 的比例。訊噪比越高,代表有用的訊號在嘈雜的背景中越清晰,傳輸的資訊就越不容易出錯。
(註) 對數項 log2(1 + S/N): 在資訊理論中,以 2 為底的對數,結果代表的是「在給定訊噪比下,訊號的每一個週期所能攜帶的最大資訊量」。因此,這對數項具有一個明確的資訊單位,即「每週期位元數」(bits)。等式右邊的計算結果單位為 bps,與等式左邊通道容量 (C) 的單位 bps 相同。公式兩邊的單位保持一致。
兩大核心結論
物理天花板(不可超越的上限):在給定的頻寬 (B) 與訊噪比 (S/N) 條件下,系統的資料吞吐量存在一個絕對上限 (C)。無論工程師發明多麼先進的調變技術或天線,傳輸速率都不可能超過這個極限。
無誤碼傳輸證明(希望的曙光):雖然有上限,但夏農也給出了一個極具建設性的證明:只要實際的傳輸速率低於容量極限C,我們就一定能找到某種編碼方式(例如前向糾錯FEC),讓傳輸的錯誤率趨近於零。這奠定了現代通訊系統中錯誤控制編碼的理論基礎。
這項定理雖然誕生於將近 80 年前,但至今仍是所有通訊工程師在設計系統時的最高指導原則。
1.2. 頻譜效率 (Spectral Efficiency, SE)
頻譜效率 (SE)是衡量通訊系統利用有限頻率資源效率的指標。其定義為:在每單位頻寬內,系統能夠達到的資料傳輸速率。
根據夏農定理的推導,理論上的極限頻譜效率(SE)由訊噪比決定:
SE = C/B = log2(1 + S/N)(bps/Hz)
將其比喻為「道路的使用效率」:若頻寬(Hz)是馬路的寬度,資料傳輸率(bps)是車流量,頻譜效率就是衡量在這條固定寬度的馬路上,每秒能擠進並安全通過多少輛車。
1.2.1. 提高SE的方法: 高階調變
為了在有限的頻寬內最大化資料吞吐量並逼近傳輸極限,轉向採用高階調變技術,例如4096-QAM。隨著星象圖的密度增加,系統對訊噪比 (SNR) 的要求大幅攀升,例如 4096-QAM 需要高達41 dB的 SNR。
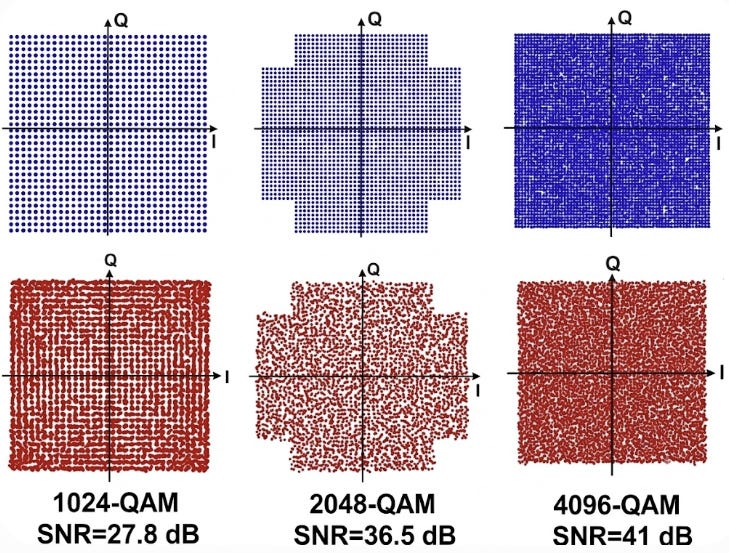
要支撐如此高的訊噪比,必須人為創造極端的物理傳輸條件以獲取「降噪與距離紅利」。實務上的作法包含:

DOCSIS 4.0(同軸電纜):具備高強度的物理屏蔽,且傳輸頻段與衰減特性穩定,能建立4096-QAM所需的極低雜訊環境。
Wi-Fi 7(無線射頻):依賴極短的無障礙傳輸距離,並透過波束成形技術集中訊號能量來保障超高 SNR,藉此在少數空間串流下達成4096-QAM
光通訊系統無法像 DOCSIS 4.0 和 Wi-Fi 7 一樣追求極高階調變,主要因為以下的物理限制:
OSNR 提升的物理天花板:光纖長距傳輸必須依賴光放大器(如EDFA)來補償衰減,這會無可避免地沿途累積自發輻射(ASE)雜訊。加上雷射光源固有的相位雜訊,使得系統無法維持極高階 QAM 星狀圖所需的極限光訊噪比(OSNR)。
光纖非線性效應(Kerr Effect):若為了達到高階調變的 OSNR 門檻而強行推高發射光功率,會觸發光纖折射率的非線性變化(如自相位調變、交叉相位調變)。超過此極限後,光功率越高,訊號波形失真反而越嚴重。

邊際效應遞減與經濟斷點

當單一通道的頻譜效率越靠近夏農極限,系統為提升訊噪比或強化 DSP (數位訊號處理) 演算法所投入的資源,其獲得的效益將呈現斷崖式下跌。如曲線圖所示,跨越「經濟可行性斷點」後,DSP 運算負荷、硬體成本與功耗將呈現指數級攀升。
當通道 SNR 的提升失去商業層面的經濟效益時,單純依賴頻譜擴展與高階調變的系統架構便會觸及天花板。這迫使硬體架構必須往其他維度發展,例如空間多工,以延續頻寬的擴展。
實務範例: 光通訊 (Optics) SE = 5.33 bps/Hz
目前的光傳輸網路(如 OIF 400G ZR 規範或長途相干光網)中,為了在單一光纖中塞入更多通道 (DWDM,密集分波多工),工程師會為每個通道分配特定的頻譜寬度。
單一通道的資料傳輸率:400 Gbps
分配給該通道的標準通道間隔 (Channel Spacing / Bandwidth):75 GHz
計算結果:SE = 400Gbps/75Ghz = 5.33 bps/Hz
1.2.2. 提升總容量: 空間擴展
通訊系統面對「單一通道頻譜效率極限」時必然的發展軌跡:從「頻譜擴展 (Spectral Scaling)」走向「空間擴展 (Spatial Scaling)」。
當提高單一通道的訊噪比 (S/N) 變得在實體物理或經濟成本上不可行時,工程師們轉向了另一個維度:空間。
空間擴展的核心原理:乘數效應
在空間擴展的架構下,夏農極限公式被賦予了一個新的乘數:

K(獨立空間通道數):這是空間擴展的關鍵。透過創造多個「相互獨立、互不干擾」的傳輸路徑,我們能在不改變頻寬 (B) 或訊噪比 (S/N) 的前提下,將系統總容量 (C) 提升K倍。

實務應用一:5G 的 Massive MIMO
5G 網路是空間擴展技術的最佳範例。

空間復用 (Spatial Multiplexing):透過基地台端龐大的天線陣列 (Antenna Array),5G 系統能同時向不同的使用者發送獨立的資料流。
波束成形 (Beamforming, BF):這項技術是實現K條獨立通道的魔法。系統能精確控制天線陣列發射訊號的相位與振幅,將電磁波能量集中成極窄的波束,精準指向特定使用者(如圖中的 User 1, User 2, User 3)。
創造獨立通道:透過Precoding與波束成形,原本共享同一片空氣的頻率資源,在「空間」上被切割開來,成功創造了K個虛擬的獨立通道,成倍地提升了基地台的總吞吐量。
實務應用二:光通訊 (Optical) 的極限壓榨與實體擴展
在光通訊領域,空間擴展的策略略有不同,通常分為兩個階段:
階段一:榨乾單根光纖的光譜資源 (C+L 波段演進)
在增加實體光纖之前,工程師會先試圖最大化單根光纖內可用波長(頻譜擴展)。
傳統 C+L Band:利用傳統的摻鉺光纖放大器 (EDFA),開發出9.6 THz的總頻寬,可提供約96個通道(通道間隔=100Ghz)。
Super C+L Band:透過新型放大器技術,將可用頻譜拓展至12.2 THz。如圖所示,若單波速率為1.6 Tbps(BW=300Ghz),總通道數增加至40個,單根光纖的總容量便能從51.2 Tbps躍升至64.0 Tbps。
恆定的頻譜效率:值得注意的是,無論是400Gbps(BW=75Ghz)還是1.6Tbps(BW=300Ghz)系統,其核心的頻譜效率 (SE) 依然維持在約5.33 bps/Hz。系統總容量的提升,純粹是因為開發了更寬的可用頻譜。

階段二:實體空間擴展 (Space-Division Multiplexing, SDM)
當單根光纖的 C+L 被榨乾,且單一波長的傳輸速率因非線性效應觸及極限時,唯一的出路就是實體的空間擴展。多芯光纖 (Multi-Core Fiber) 或 增加光纖束數量:這就是最直接的K值倍增。例如,採用包含 4 個獨立纖芯的光纖,直接將傳輸容量提升 4 倍。
1.3.射頻通訊和光通訊
現代光通訊的發展軌跡確實高度借鏡了射頻 (RF) 通訊的基礎理論:
基礎振幅調變:Simple ASK (RF) vs. IMDD (Optics)

source: ISSCC26僅利用載波的「振幅大小(或光強度)」來傳遞 0 與 1 的數位訊號。
發射端 (Tx) 的對應:
RF (ASK):使用本地振盪器 (Oscillator) 產生射頻載波,並透過一個由輸入資料 (Din) 控制的開關 (Switch/Mixer) 來決定載波的輸出與否。
光學 (IMDD):使用雷射 (Laser) 作為光學載波源,並透過外部調變器 (External Modulator,如 Mach-Zehnder 調變器) 扮演開關的角色,根據輸入資料改變光束的穿透強度。
接收端 (Rx) 的對應:
RF (ASK):天線接收訊號後,利用整流器 (Rectifier / 封包偵測器) 將高頻載波轉換為基頻的振幅變化,再透過濾波與決策電路 (Decision) 還原資料。
光學 (IMDD):利用光電偵測器 (Photodetector, PD) 取代整流器,將光強度的變化直接轉換為電流變化。接著由轉阻放大器 (TIA) 將電流轉為電壓,最後由時脈與資料恢復電路 (CDR) 進行訊號判決。
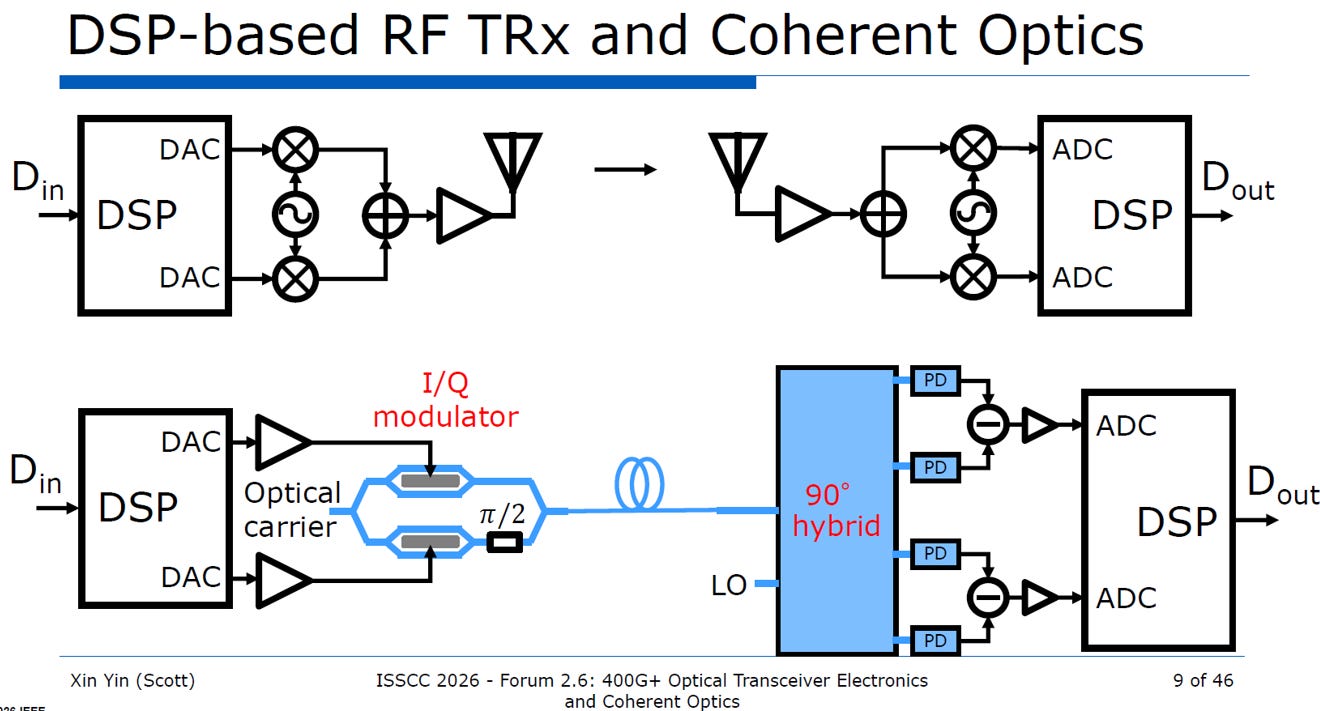
相位與振幅複合調變:DSP-based RF vs. Coherent Optics
source: ISSCC26
當系統需要較高的頻譜效率時,單純的振幅調變已不敷使用。兩者皆轉向使用I/Q 調變(同相與正交相),同時控制載波的振幅與相位,且高度仰賴數位訊號處理器 (DSP)。
發射端 (Tx) 的對應:
RF:DSP 產生數位的 I 與 Q 訊號,經 DAC 轉為類比後,分別與相差 90 度的射頻載波進行混波 (Mixer) 並疊加,最後透過天線發射。
光學 (Coherent):架構邏輯一致,但混波器換成了光學 I/Q 調變器。它將雷射光源分為兩道,其中一道經過 90 度 (π/2) 的光學相位移,接著分別接收來自 DAC 的電氣訊號進行調變,最後將兩道光波重新結合匯入光纖。
接收端 (Rx) 的對應:
RF:接收到的訊號分為兩路,分別與本地振盪器產生的高頻載波進行混波,降頻還原出類比的 I 與 Q 訊號,經 ADC 數位化後交由 DSP 處理。
光學 (Coherent):光學系統無法使用簡單的電氣混波器,因此導入了90度光學混波器 (90° hybrid)與一組本地振盪雷射 (LO, Local Oscillator)。它讓接收到的微弱光訊號與高功率的 LO 雷射發生干涉,透過光電偵測器 (PD) 陣列輸出對應 I 與 Q 向量的差分電流。後續同樣經由 TIA 放大、ADC 取樣,最後由強大的 DSP 執行色散補償與載波相位恢復,精準還原出數位資料。
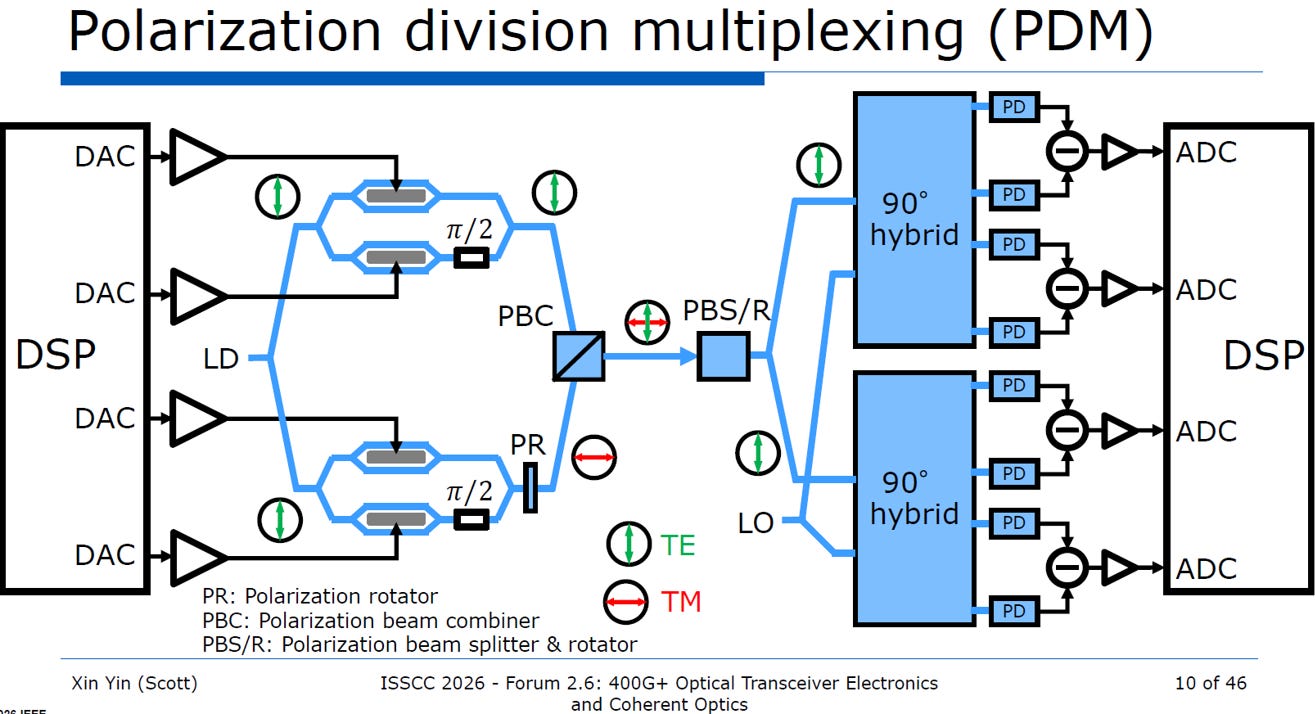
現代光通訊能達高頻譜效率 (SE) 的最後一塊關鍵拼圖:偏振多工 (Polarization Division Multiplexing, 簡稱 PDM),可視為廣義Spatial Multiplexing的一種特殊形式。
前面提到的「空間擴展 (創造獨立通道K)」,PDM就是在單一根光纖、單一個波長內部,完美實現K=2的空間擴展魔法。
source: ISSCC26
核心概念:利用光波的「3D 幾何特性」
光是一種電磁波,它不僅有振幅和頻率,還有「震盪方向」。 PDM 的原理是:在三維空間中,垂直震盪的光波與水平震盪的光波是正交 (Orthogonal)的。這意味著即使它們在同一根光纖的同一個波長中同時傳輸,兩者也完全不會互相干擾。
發射端 (Tx) 的巧思:無中生有的雙倍通道
DSP 送出了4 組DAC 訊號,代表有兩路完全獨立的資料流。
來自同一個雷射 (LD) 的光源被分為上下兩路。此時兩路光波的震盪方向相同(圖中標示綠色的TE,垂直偏振)。
上下兩路各自通過一個 I/Q 調變器,編碼不同的資料。
關鍵步驟:下方的光波在調變後,通過了一個偏振旋轉器 (PR, Polarization Rotator),將其震盪方向旋轉 90 度,變成了水平震盪(圖中標示紅色的TM,水平偏振)。
最後,透過偏振光束結合器 (PBC)將 TE 與 TM 合併進入光纖。原本只能載送一組 I/Q 訊號的波長,現在同時載送了兩組。
接收端 (Rx) 的解碼:精準分離
帶有雙重資訊的光束抵達接收端後,首先進入偏振光束分光/旋轉器 (PBS/R)。
它的物理特性可以將垂直光 (TE) 與水平光 (TM) 乾淨俐落地拆分開來,並將 TM 旋轉回TE狀態(矽光子(SiPH)元件多半只處理TE信號)。
拆分後的兩道光波,分別進入上下兩個獨立的 90° hybrid (光學混波器) 進行同調接收,最後交由 DSP 處理。
頻譜效率 (SE) 的實質躍升
透過 PDM在完全不增加頻寬的情況下,將資料吞吐量直接翻倍。 以前述提到的400G傳輸為例,它實際上使用的就是DP-16QAM (Dual-Polarization 16-QAM)。16-QAM 本身每個符元提供4 bits,加上雙偏振 (DP/PDM) 的乘數效應,最終達成每個符元傳遞8 bits的極高效率,才能有5.33 bps/Hz頻譜效率。
1.4. Data Rate, Symbol Rate and Bandwidth關係
資料傳輸率 (Data Rate) 與符元率 (Symbol Rate) 之間的關係,可以透過以下核心公式來表達:
Data Rate = Symbol Rate * (Bits per Symbol)
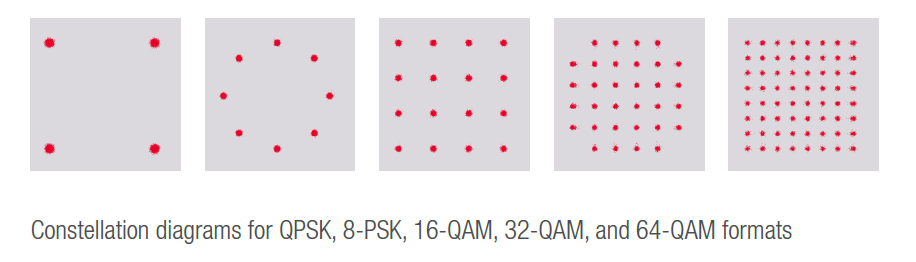
符元率 (Symbol Rate/Baud Rate):硬體每秒能打出多少個物理訊號變化(受限於實體電路)。
每個符元的位元數:由調變格式決定,也就是每個物理訊號能夾帶多少資料(例如 16-QAM 夾帶 4 bits,64-QAM 夾帶 6 bits)。
結論:當硬體速度(符元率)達到極限時,只能靠升級調變格式(增加每個符元的位元數),來倍增整體的資料傳輸率。
Nyquist ISI 準則與頻寬限制 (Bandlimit Condition)
在理想狀態下,傳輸數位訊號最直觀的方式是使用「方形波」,但方形波在頻譜上會佔用無限大的頻寬。在現實中,任何實體傳輸通道(如電路板、光纖)都有頻寬限制 (Bandlimit)。當方形波通過受限的頻寬時,波形會散開變形,導致前後符號互相干擾,這稱為符號間干擾 (ISI, Inter-Symbol Interference)。
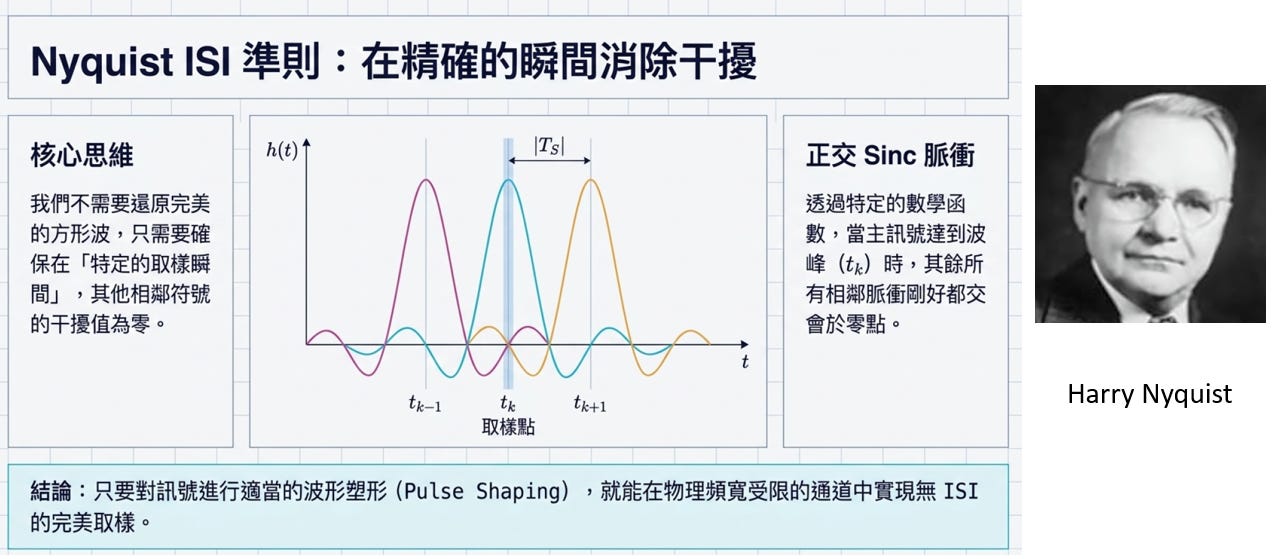
Nyquist ISI 準則提出了一個極具啟發性的解方:不需要在接收端還原出完美的方形波。只需要對波形進行塑形 (Pulse Shaping),確保這個波在「特定的取樣瞬間 (tk)」達到峰值,而在「其他所有相鄰符號的取樣瞬間」振幅剛好都交會於0即可。數學上最完美的解是Sinc 函數(完美的磚牆頻譜),它能用最窄的絕對頻寬實現無 ISI 傳輸。
實務解方:升餘弦濾波器 (Raised Cosine Filter) 與滾降係數
雖然理論上的Sinc脈衝最省頻寬,但在工程上是無法實現的(它需要無限長的時間,且對取樣時序的誤差極度敏感)。
為了解決這個問題,工程界引入了升餘弦濾波器 (Raised Cosine Filter)。它透過一個關鍵參數——滾降係數 (Roll-off Factor, α),在「頻寬佔用」與「硬體容錯率」之間取得妥協:
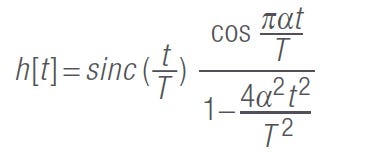
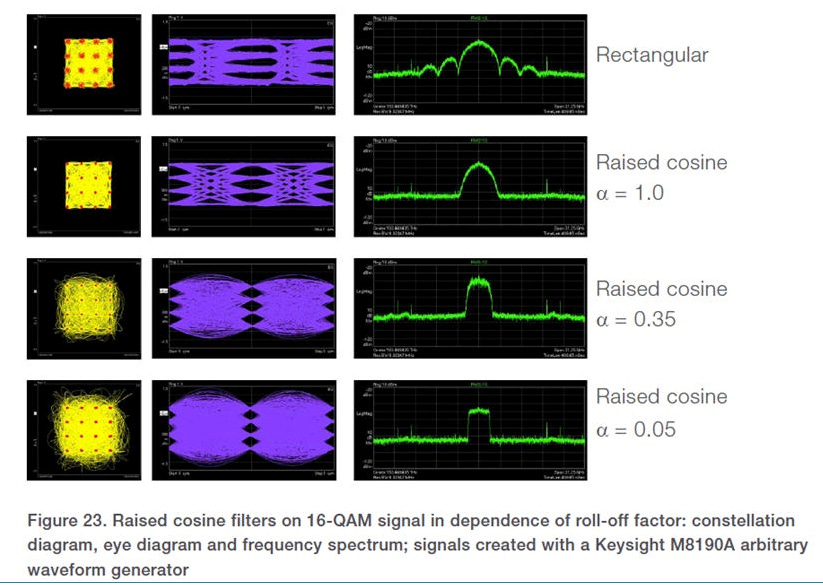
source: Keysight
α = 0:等同於理想 Sinc 波。頻譜最窄,但時域上的振盪非常嚴重,只要接收端的時脈 (Clock) 稍有偏移,就會產生巨大的 ISI。
α > 0 (如 0.05 到 1.0):頻譜邊緣被平滑化(變得像鐘形)。這會付出佔用更多實體頻寬的代價,但在時域上,脈衝的尾巴衰減得非常快。這大幅降低了系統對時序誤差 (Timing Jitter) 的敏感度,降低了接收端 DSP 與時脈恢復 (CDR) 的設計難度。
符元率 (Symbol Rate) 與類比通帶頻寬 (Analog Passband BW)
在基頻(Baseband) 傳輸中,根據Nyquist定理,傳輸 SR (Symbol Rate) 的符元率,最低需要SR/2的頻寬。 然而,現代同調光通訊使用的是I/Q 調變,這本質上是一種將訊號平移到高頻載波上的通帶(Passband) 傳輸系統。在通帶系統中,雙邊帶頻譜會佔用完整的SR頻寬。
結合前述的升餘弦濾波器,類比頻寬的最終通用公式為:
類比頻寬 (BW) = Symbol Rate * (1 + α)

同調光通訊的頻寬推導流程
在設計一個光通訊系統時,從「客戶端資料率」到最終「光纖上佔用的物理頻寬」,需要經過一個精密的推導管線:
定義總資料率 (Line Rate):包含客戶端資料 (Data Rate) 與前向糾錯 (FEC) 的額外開銷 (Overhead):

source: Cisco
計算每個符元的載位元數 (Bits/Symbol):這取決於空間擴展技術(如雙極化 DP,乘數為 2)以及調變階數(如 16-QAM,乘數為 4)。
求出符元率 (Symbol Rate):Line Rate / Bits per Symbol = Symbol Rate (Baud)。
決定最終物理頻寬 (BW):根據硬體 DSP 能力選擇合適的 α 值,代入 BW = Symbol Rate * (1 + α) 求得。
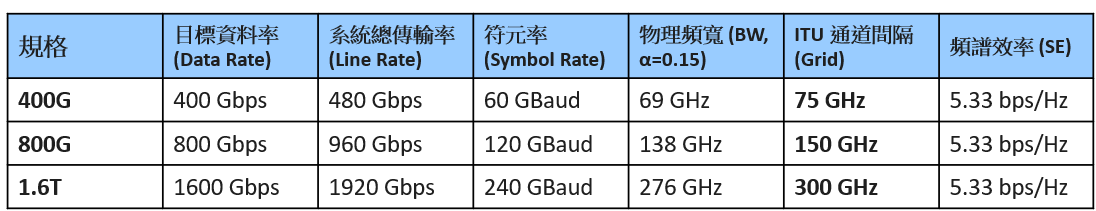
800Gbps 實例推導 (DP-16QAM, 150GHz 通道)
目標資料率 (Data Rate):800Gbps
系統總傳輸率 (Line Rate):加入20%的FEC Overhead。
Line Rate = 800 Gbps * 1.2 =960 Gbps
調變技術解析 (DP-16QAM):
DP (雙極化):提供 2 個獨立的正交空間通道。
16-QAM:每個符元攜帶 4 bits (因為24= 16)。
每個符元等效位元數:2 * 4 =8 bits/symbol
計算符元率 (Symbol Rate):
SR = 960 Gbps / 8 bits =120 GBaud
決定物理頻寬與 α 值:
現代光通訊 DSP 常見的 Roll-off Factor,設定α = 0.15。
BW = SR (1 + α) = 120(1+.015)= 138 GHz
138 GHz 的實際物理頻寬,可以安全地在ITU-T G.694.1150 GHz的 Grid 當中,並留下 12 GHz 的保護頻帶)
驗證頻譜效率 (Spectral Efficiency, SE):
SE 的定義是「有效資料吞吐量」除以「佔用的物理頻寬」。
SE= 800 Gbps / 150 GHz =5.33 bps/Hz
1.5. 數位通訊大師
數位通訊理論的建構過程中,哈里·奈奎斯特 (Harry Nyquist) 與克勞德·香農 (Claude Shannon) 的研究成果展現了明確的學術傳承脈絡。兩位學者於 1941 年至 1954 年間重疊任職於美國貝爾實驗室,促成了通訊理論由物理層級至純數學維度的演進。
在 1920 年代,奈奎斯特的研究主要建構於古典電報與控制理論之上。他針對無雜訊的理想通道環境,確立了碼間干擾 (ISI) 與頻寬之間的關係,並定義出「奈奎斯特速率 (Nyquist Rate)」。這項成果釐清了理想狀態下傳輸速率的物理限制。
至 1940 年代,香農將通訊研究推進至高維度的數學資訊理論領域。1948 年,他引入「雜訊」與「熵」的變數,探討含有高斯白雜訊的實際通道環境。其提出的「香農容量 (Shannon Capacity)」確立了實際通道的資訊傳輸極限容量,公式為C = B log2(1 + S/N)。
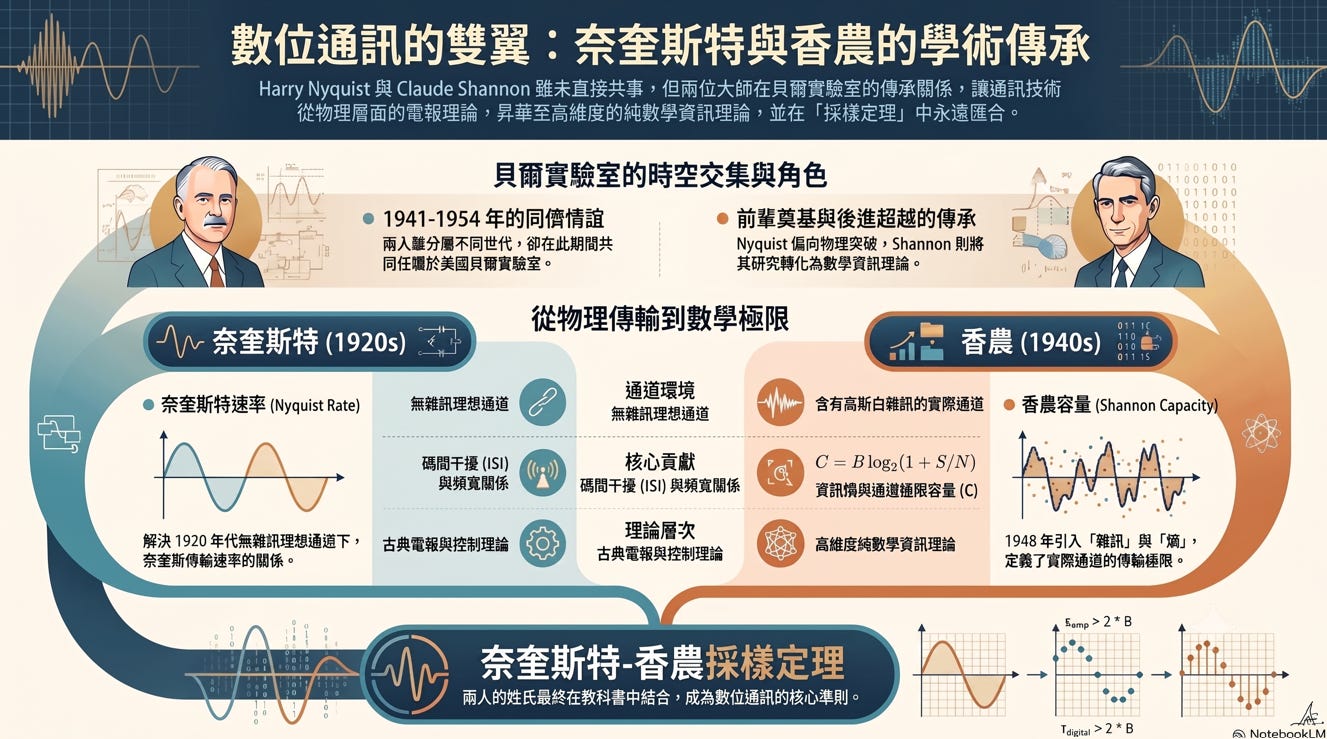
Nyquist 與 Shannon 分別從「訊號處理」與「資訊理論」兩個不同角度奠定現代數位通訊基礎。Nyquist-Shannon 採樣定理描述的是頻寬受限訊號的取樣條件,而 Shannon Capacity 則定義了雜訊通道的資訊傳輸極限;兩者雖經常同時出現在通訊系統分析中,但其研究目標與數學意義並不相同。
Nyquist-Shannon 採樣定理成功將物理世界的連續波形,與數學/數位世界的離散數據建立起嚴謹的轉換等式,成為當今所有數位音訊、影像以及高效能數位通訊系統演進的核心理論分水嶺與技術基石。
2. Existing Scale Across 架構
2.1. 同調光收發模組
同調光收發模組(Coherent Transceiver)過去十多年來,在追求更低功耗與更高傳輸速率的目標下,系統架構與關鍵零組件的演進歷程。其核心發展脈絡可歸納為「高度垂直整合」、「先進封裝技術的導入」以及「CMOS 製程微縮」。

source: Cisco離散元件時期 (2011)
模組規格:100G MSA,功耗高達80W/100G。
系統架構:採用離散式設計,數位訊號處理器 (DSP)、傳送端的調變器 (Modulator)、接收端的相干接收器 (CRX) 以及驅動晶片 (DRV) 皆為獨立封裝的元件。
光學材料與製程:依賴傳統的磷化銦 (InP) 或鈮酸鋰 (LiNbO3) 光學元件,配合 40nm CMOS 製程的 DSP。此階段體積龐大,通常僅能安裝於大型線卡 (Line Card) 上。
矽光子導入與光電共封裝萌芽 (2014 - 2017)
模組規格:由 100G CFP 演進至 200G CFP2,功耗大幅降至10W/100G。
技術突破 (SiPh & OE-MCM):2014 年開始導入矽光子 (Silicon Photonics, SiPh) 技術,取代部分傳統離散光學元件。到了 2017 年,發展出光電多晶片模組 (OE-MCM) 架構,將光子積體電路 (PIC) 與特殊應用積體電路 (ASIC/DSP) 整合於同一基板上,大幅縮短了高速電訊號的傳輸路徑,有效降低訊號衰減與功耗。
製程與調變:CMOS 製程由 28nm 推進至 16nm,調變技術從 QPSK 升級至 16QAM。
可插拔模組標準化與雷射整合 (2020 - 2024)
模組規格:進入 400G 至 800G 世代,外型尺寸微縮至 QSFP-DD(與客戶端光學模組尺寸相當),功耗進一步壓縮至 5W 到3.5W/100G。
系統架構:開始將摻鉺光纖放大器 (EDFA) 甚至微型同調雷射 (Nano-ITLA) 直接整合進 QSFP-DD 狹小的空間內,達成極高密度的模組設計。
製程與調變:DSP 製程推進至 7nm 甚至 4/3nm。調變技術導入了機率式星狀圖塑形 (PCS, Probabilistic Constellation Shaping),透過演算法優化星座圖的機率分佈,逼近夏農極限,以在有限的光訊噪比下最大化傳輸容量。
次世代材料與 100% 垂直整合 (2026 展望)
模組規格:邁向單波或雙波1.6T容量,目標功耗為2.5W/100G。
製程:依賴2nm CMOS先進製程來處理 1.6T 龐大的運算負荷並控制發熱。
2.2. IP-over-DWDM (IPoDWDM)
由於同調光模組小型化的成功,傳統架構被IP-over-DWDM (IPoDWDM)或同調路由 (Coherent Routing)取代,這正是光通訊領域近年來重要的架構典範轉移。
傳統架構的冗餘
在過去的架構中,交換器/路由器與 DWDM 骨幹網路之間,必須透過獨立的「光傳輸機箱 (Optical Chassis)」與「轉發器/多工轉發器 (Transponder/Muxponder)」進行中介轉換。 這種設計產生了雙重浪費:不僅需要額外採購短距離的「灰光模組 (Gray Pluggable)」與光纖跳線來連接交換器與傳輸設備,獨立的傳輸機箱本身也佔用極大的機架空間(Rack Space)並消耗大量電力。

source: Cisco
同調模組小型化帶來的「去中間化」
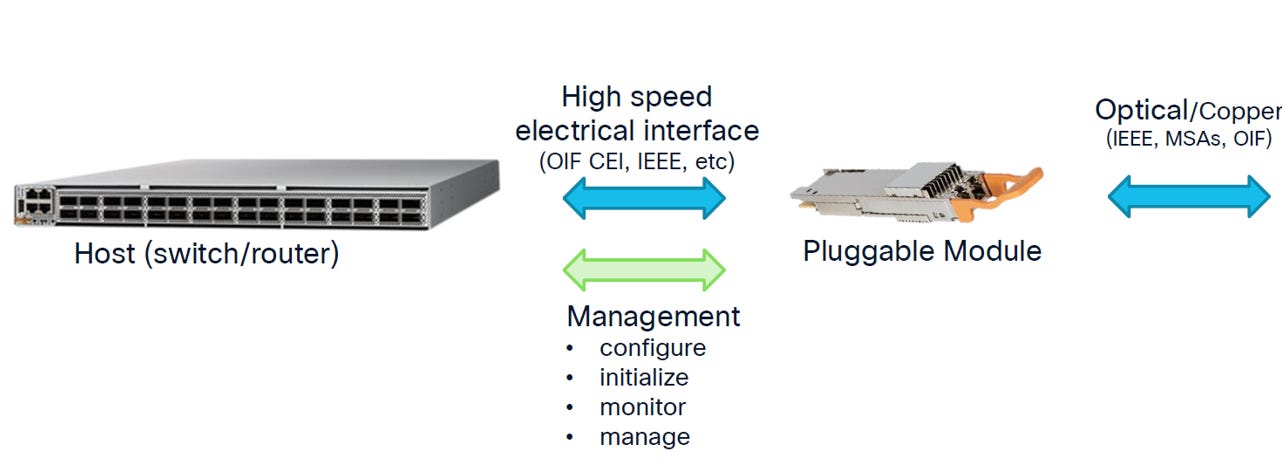
隨著 DSP 製程的微縮與矽光子技術的高密度整合,400G 甚至 800G 的同調光收發模組成功微縮至 QSFP-DD 或 OSFP 等標準可插拔尺寸(如 400G/800G ZR/ZR+)。
主機端(Host)的 ASIC 如今可以直接透過高速電氣介面(如 OIF CEI 規範的 112G PAM4 訊號)與可插拔模組內的同調 DSP 溝通,並透過 I2C/CMIS(Common Management Interface Specification) 介面進行完整的系統管理與狀態監控。
source: Cisco
系統架構效益
用戶現在只需依據頻寬需求,將同調光模組直接插入具備對應供電與散熱能力的交換器/路由器連接埠,輸出的光訊號即可直接進入OLS(開放式線路系統),透過ROADM (Reconfigurable Optical Add-Drop Multiplexer)節點併入骨幹網路。 這種架構直接帶來的具體效益:大幅降低 CapEx(省去傳輸設備與灰光模組採購)、減少約 95% 的相關功耗,並完全釋放了原本被傳輸設備佔用的機架空間。
3. Ciena Scale Across 架構
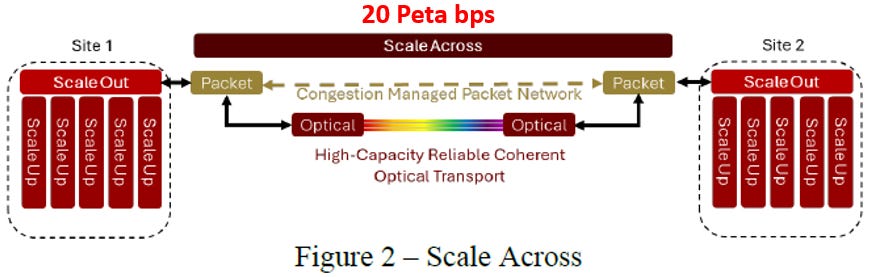
針對 AI 資料中心互聯的極大頻寬需求(20Peta bps等級),通信大廠Ciena在 OFC 2026 提出了對應Scale Across網路解決方案:

source: ciena
20 Peta bps對AI 資料中心互聯的需求是完全合理的,主要基於以下三個客觀的工程與物理條件限制:
單點高頻寬與叢集規模:次世代 AI 伺服器單顆 GPU 的網路介面將達到 800 Gbps 至 1.6 Tbps。若以 1.6 Tbps 計算,僅需 12,500 顆 GPU 進行無阻塞互連,即會產生 20 Pbps 的東西向(East-West)總流量。目前主流雲端服務商皆已在建置 10 萬顆 GPU 等級的超級叢集。
單一機房的電力與空間天花板:10 萬顆 GPU 規模的叢集耗電量極大(可達數百 MW 甚至 GW 等級),單一資料中心建築或變電站的基礎設施通常無法負荷如此密集的電力與散熱需求。
橫向擴展(Scale-Across)的必然性:受限於上述物理條件,營運商必須將巨型叢集拆分至不同的實體廠區。為了讓分散的 GPU 能同步進行 AI 模型訓練且不產生網路瓶頸,廠區之間的資料中心互連(DCI)必須具備與機房內部同等級的頻寬。因此,20 Pbps 成為支撐跨廠區運算的合理骨幹網路門檻。
source: ciena
3.1. FST + 1.6T ZR/ZR+
Full Spectrum Transponder (FST) 結合 1.6T ZR/ZR+ 解決方案,在次世代 AI 資料中心網路架構中的技術定位與設計邏輯如下:
頻譜擴張與向農定理 (Shannon's Theorem) 的實踐
在光通訊系統中,由於雷射相位雜訊、光放大器自發輻射雜訊 (ASE) 以及光纖非線性效應的物理限制,系統的訊噪比 (OSNR) 存在無法突破的天花板。根據向農定理,在通道訊噪比無法進一步推升的條件下,提升總資料傳輸容量最直接的物理途徑,便是擴張可用頻寬 (Bandwidth)。
傳統光傳輸主要集中於 C 頻段 (C-Band)。透過FST架構同時榨乾 C 頻段與 L 頻段 (C+L Band) 的資源,實體層等同於獲得了雙倍的光學頻譜。配合 1.6T ZR/ZR+ 模組的高符元率與最佳化的調變格式,系統得以在單一光纖對 (Fiber Pair) 中實現資料吞吐量的極大化,這是面對 OSNR 物理極限下最務實的擴容策略。
顛覆傳統部署邏輯:Day One 全頻譜點亮
傳統光網路 (Wavelength by Wavelength):傳統電信營運商(IPoDWDM)的邏輯,是基於逐步增長的用戶流量來擴容。初期建置光纖骨幹與 ROADM 後,再依照需求逐一採購並插上單波長的同調光模組。這種做法雖然分散了初期資本支出 (CapEx),但系統疊加過程複雜、人工介入多,且部署週期長。
FST 架構 (Day One 點亮):觀察FST Building Block,其設計將客戶端訊號 (Client Ethernet, 如 DR4)、DSP 以及線路端的同調光學元件高度整合。其核心目的在於捨棄複雜的光學多工層級,在基礎設施建置的首日 (Day One),就直接啟動整條光纖 C+L 頻段的全部容量。此舉能大幅縮短 AI 叢集上線的時間,並顯著降低後續的人工營運成本 (OpEx)。

source: ciena
AI Scale Across 的極端頻寬驅動
AI 大語言模型訓練中的節點通訊(例如 All-to-All 的張量平行同步)屬於密集且持續的 East-West 流量,對於延遲與頻寬極度敏感,無法容忍傳統網路架構中的超額訂閱 (Oversubscription) 瓶頸。這種跨廠區的互連網路一旦啟動,立刻就需要Peta-bps等級的無阻塞 (Non-blocking) 頻寬。因此,Day One具備全頻譜傳輸能力的 FST,是滿足 AI 基礎設施即時、極端頻寬需求的必然硬體架構選擇。
3.2. RLS C&L Band and Hyper-Rail for 20Pbps
針對 AI 資料中心跨廠區互連所衍生的巨量頻寬需求,整理 DCI(Data Center Interconnect)在實體層面面臨的挑戰,以及Ciena新一代高密度架構的解決方案:
DCI 互連的地理與實體物理限制
資料中心分散化佈建:受限於單一區域的電力供應與基礎設施乘載上限,大型 AI 資料中心無法無限制集中,必須依賴基礎設施完善的區域進行分散式建置:
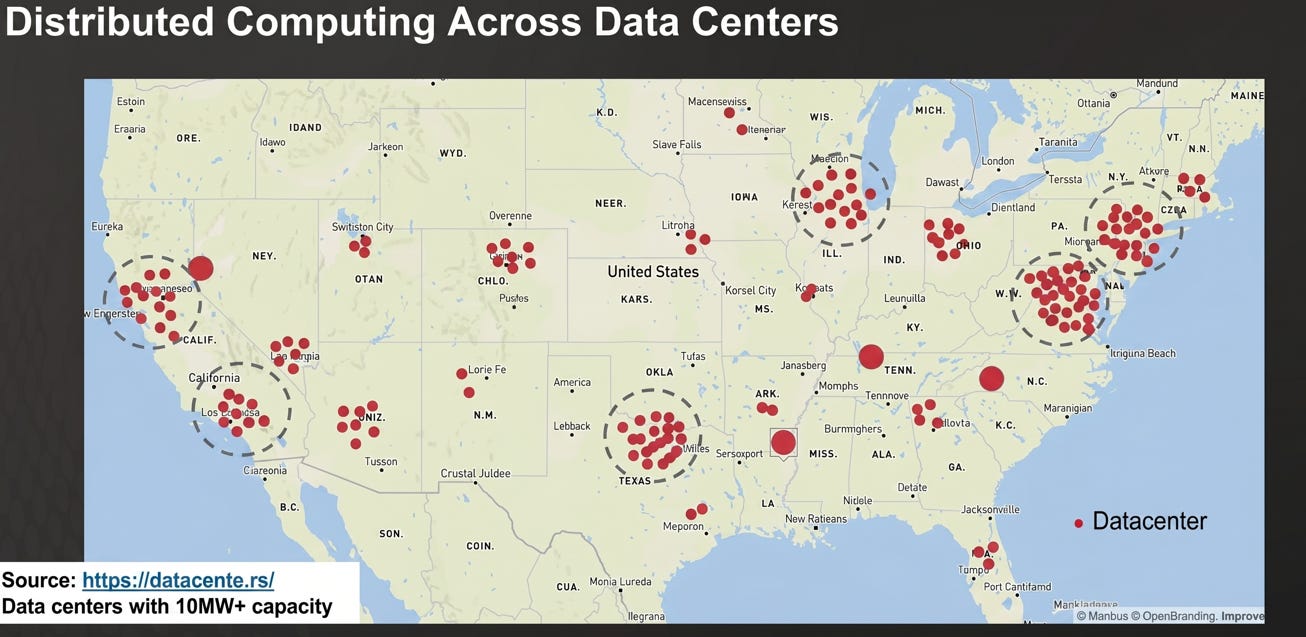
source: datacente
長距離傳輸需求:這些分散的節點之間,實體傳輸距離往往可達 1000 公里,形成長途(Long-haul)光纖網路拓撲。
訊號衰減與中繼站(Hut)建置:光訊號在光纖中傳輸存在物理衰減,每隔約 80 公里即需要設立一個光放大器中繼站(Site Amp / Hut)。這意味著一條 1000 公里的連線,沿途需要建立超過 10 個以上的中繼節點:
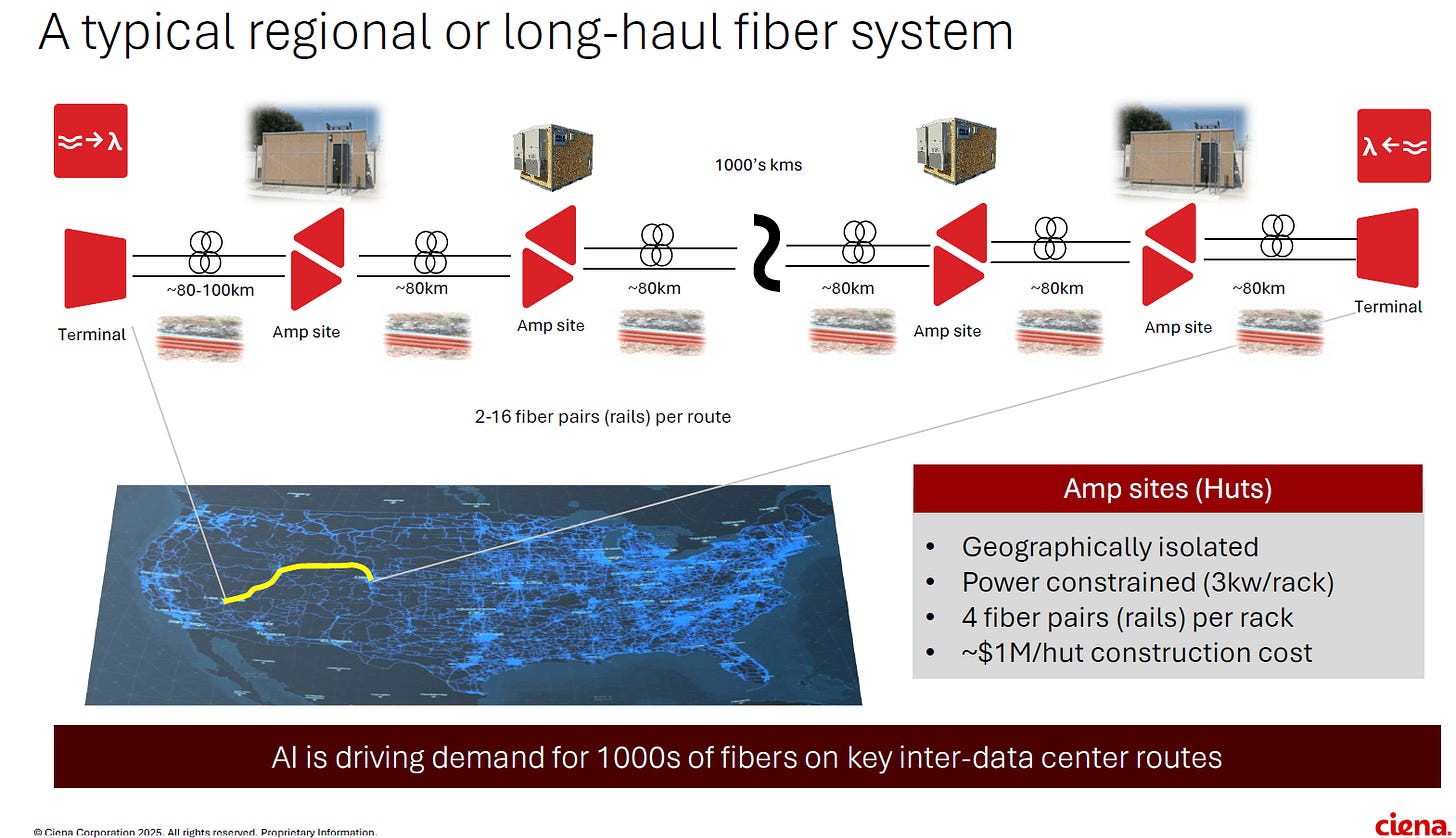
source: ciena
20 Pbps 巨量頻寬下的傳統架構瓶頸
當跨廠區互連總頻寬需求達到20 Pbps 時,傳統中繼站的實體空間與電力設計將面臨無法擴展的困境:
傳統中繼站的規格天花板:遠端中繼站常建於地理孤立地區,電力極度受限(如單一機架僅供 3kW)。在傳統設計下,單一機架僅能容納 4 對光纖(4 rails/rack),一個中繼站(Hut)滿載約為 4個 rack,16 對光纖。
擴容的實體數學挑戰:若採用C+L Band全頻譜傳輸,並假設每對光纖可承載58Tbps 的容量。要達成20 Pbps(20,000 Tbps)的總頻寬,實體層需要部署高達345 對光纖(20,000 / 58 ≒ 345)。
空間與成本的線性爆炸:將 345 對光纖套用於傳統中繼站規格,單單在一個 80 公里處的中繼節點,就需要建置高達22 個獨立的 Huts(345 / 16 ≒ 22)。考量每個 Hut 約 100 萬美元的土建與設備成本,這在工程實務與資本支出上完全缺乏可行性。

source: ciena
新世代架構與空間擴展 (Spatial Scaling) 的實踐
RLS Hyper-Rail 的高密度整合:透過大幅提升硬體封裝密度,新一代Multi-rail設計實現了32 倍的密度提升,將單一機架的容載量推升至 128 對光纖(128 rails/rack)。這使得原本需要 22 個 Huts 才能支撐的 20 Pbps 實體頻寬,現在只需壓縮在1 個 Hut (4 rack = 4x128 = 512 rails)內即可達成,且維持相近的空間與電力消耗。
符合向農定理的擴展路徑:在單一波長或單一光纖對的頻譜效率(Spectral Efficiency)因雜訊與非線性效應而逐漸逼近Shannon Limit時,透過增加實體光纖數量來平行提升總吞吐量,是唯一符合物理現實的擴容方向。高密度整合技術解決了Spatial Scaling過程中所伴隨的設備體積與功耗暴增問題,使極端頻寬的骨幹網路具備了實際落地的可能性。
3.3. Ciena Scale-Across架構整理
為什麼需要這套架構?
單一資料中心的電力與空間已無法滿足次世代 AI 巨型模型的訓練需求,算力被迫分散在相距數百到 1000 公里外的不同園區(例如美西與美中)。為了讓兩地的 GPU 叢集能無延遲同步,需要建立一條高達20 Pbps的跨區光纖大動脈。
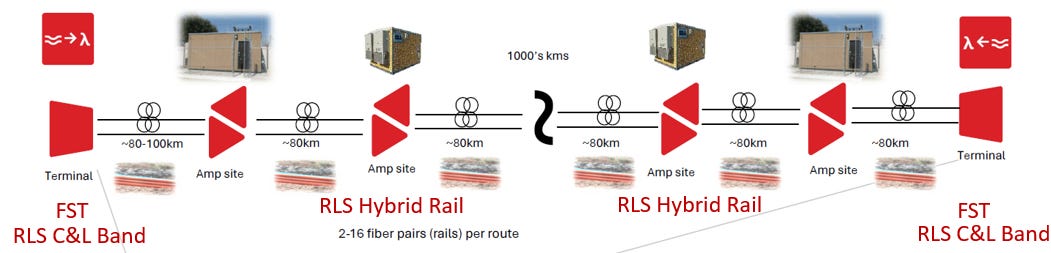
端點起點:FST (全頻譜轉發器)
任務:光電轉換引擎。
作法:吸收來自 AI 交換器的短距「灰色光」(e.g., 1310nm),利用次世代 DSP 轉為長途傳輸的 1.6T「同調彩色光」。
突破:在基礎設施建置的首日 (Day One),就直接啟動整條光纖C+L 頻段的全部容量。此舉能大幅縮短 AI 叢集上線的時間,並顯著降低後續的人工營運成本 (OpEx)。
端點樞紐:RLS C&L-Band(RLS: Reconfigable Line System)
任務:光層交通警察(合波、分波與調度)。
作法:FST 只負責把光變色,而RLS則負責把幾個FST 吐出來的幾百條彩色光纖,精準地揉合(Multiplexing)進入長途骨幹。
長途骨幹:RLS Hyper-Rail (多軌道線路放大器)
任務:純粹的實體訊號放大,專注於中繼站(ILA Huts, ILA=Integrated Line Amp)。
作法:長途跋涉每 80 公里就需要放大訊號,但偏遠小屋有著3kW 的極端電力限制。Hyper-Rail 在不超電的前提下,將放大密度增為 32 倍(單一機架吃下 128 對光纖),成功將傳統需要 22 棟小屋的硬體量縮進 1 棟貨櫃內。
這整套軟硬體矩陣,本質上就是為了克服電力與地理限制,強行在實體層面將 1000 公里外的兩座資料中心,完美黏合成同一座虛擬超大 AI 算力工廠的工程解法。
4. 結論
通訊技術的演進需在物理邊界內尋求最佳化配置。當單一通道的頻譜效率逼近夏農極限時,單純依賴推升訊噪比或強化 DSP 演算法將面臨硬體成本與功耗呈指數攀升的經濟斷點 ,光通訊產業因此轉向實體空間擴展與高度垂直整合。針對 AI 時代的極端互連需求,Ciena 透過FST實現Day One全頻譜啟動 ,並以RLS Hyper-Rail達成 32 倍的機架密度提升 ,在空間與電力高度受限的環境下提供具備商業可行性的20 Pbps骨幹網路解決方案 。
5. 補充說明
通訊系統中,若將Shannon定理視為資料吞吐量的「天花板」,那麼 Cramér-Rao Lower Bound (CRLB)便是決定DSP估測精度的「地板」,兩者共同限制現代高速通訊系統:

CRLB 核心定義:
理論基礎:CRLB 隸屬於「估計理論 (Estimation Theory)」。
物理意義:它定義了接收端在處理含有雜訊的訊號時,任何演算法在推算實體參數(如時脈、相位、通道響應)時,所能達到的「最小誤差下限」
為何被定義為「地板」?
精準度極限:在實際的雜訊通道中,接收波形伴隨的熱雜訊與相位雜訊會破壞訊號的確定性,使得接收端無法直接讀取閉合的眼圖,必須仰賴數位訊號處理 (DSP) 進行估測。CRLB 證明了無論 DSP 演算法多麼複雜先進,其估測誤差絕對無法低於由「費雪資訊 (Fisher Information)」所決定的數學下界。這是一道無法跌破的理論邊界。
硬體工程的實務代價
算力與功耗暴增:為了讓 DSP 的估測誤差盡可能收斂並貼近 CRLB 地板,系統必須動用高解析度的類比數位轉換器 (ADC),並大幅增加等化器 (FFE/DFE) 的濾波器階數。
邊際效益遞減:要消除殘存的估測誤差以逼近 CRLB,所需投入的電晶體算力與功耗會呈指數級別暴增。這導致高速 SerDes 或相干光模組內部的 DSP 必須佔用極大的晶片面積 (Die Area) 並產生極高的功耗。
實務發展趨勢
綜觀目前的半導體與資料中心互連技術,皆是在這天花板與地板之間尋找最佳的系統級妥協:
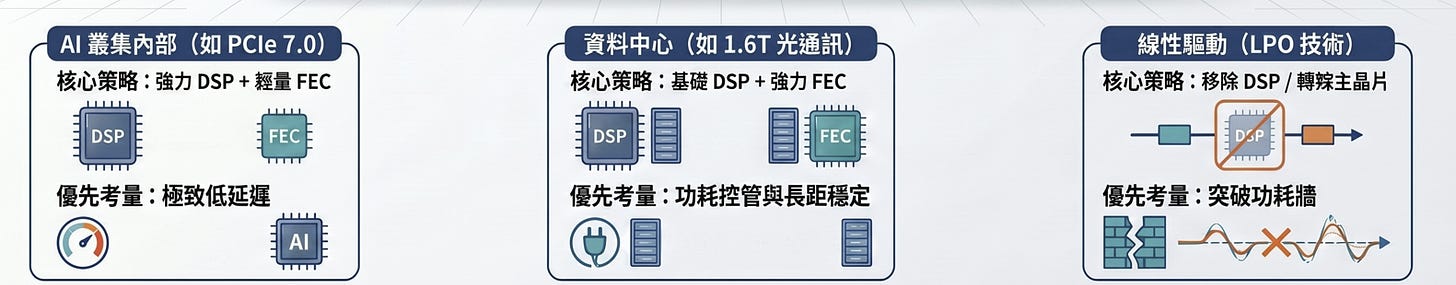
-
AI 叢集內部互連 (如 PCIe 7.0 / NVLink 6):對於延遲極度敏感的運算匣 (Compute Tray) 內部短距傳輸,系統傾向「重 DSP、輕 FEC」。投入極高功耗在 ADC-based SerDes 陣列上硬抗 CRLB 地板,換取極佳的原始眼圖,從而得以使用極低延遲的輕量級 FEC。
-
資料中心跨機架互連 (1.6T 光學模組):面臨嚴峻的通道損耗,系統架構傾向「輕 DSP、重 FEC」。容忍較差的 Pre-FEC BER 以控制 DSP 的發熱與功耗,並利用複雜的高增益 FEC 來確保資料完整性。
-
線性驅動光學 (LPO):試圖在模組端移除 DSP(不對抗 CRLB 地板),將訊號處理的重擔轉嫁給 Switch ASIC,這是業界為了打破功耗牆所進行的極端架構實驗,但也直接面臨了訊號完整性與互通性的巨大挑戰。
[Reference]
400G, 800G, and Terabit Pluggable Optics, Cisco BRKOPT-2699
Keysight, everything-you-need-to-know-about-complex-optical-modulation
Ciena, OFC26, W3A.1
Xin Yin, imec, ISSCC26 VF2.6
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


