Google 在 AI 基礎設施領域的研發已累積超過十年,持續將內部的大規模運算需求轉化為雲端基礎設施 。隨著大型語言模型與 AI 應用架構日益複雜,單一晶片架構已難以同時在「極致算力」與「成本控管」上達到最佳平衡 。為此,Google…
Google 在 AI 基礎設施領域的研發已累積超過十年,持續將內部的大規模運算需求轉化為雲端基礎設施 。隨著大型語言模型與 AI 應用架構日益複雜,單一晶片架構已難以同時在「極致算力」與「成本控管」上達到最佳平衡 。為此,Google…
- Source: Ted Yu
- Published: 2026-06-10T07:34:26+08:00
- URL: https://ytyuted.substack.com/p/ep48-google-tpu-v8-ai EP48. Google TPU v8 設計與 AI 網路技術解析 - Ted Yu
Pledge your support

EP48. Google TPU v8 設計與 AI 網路技術解析

Jun 10, 2026
Google 在 AI 基礎設施領域的研發已累積超過十年,持續將內部的大規模運算需求轉化為雲端基礎設施 。隨著大型語言模型與 AI 應用架構日益複雜,單一晶片架構已難以同時在「極致算力」與「成本控管」上達到最佳平衡 。為此,Google 首度導入解耦式(Disaggregated)設計,將工作負載明確分流,區分為專注於大參數模型預訓練的TPU 8t,以及針對模型上線部署優化的推論專用晶片TPU 8i。本文將梳理 TPU 歷代技術演進,並深入探討TPU v8在晶片底層、記憶體子系統、先進封裝以及AI網路拓撲上的關鍵突破。
1. Background
1.1. Google TPU 歷代技術演進
Google 於 AI 基礎設施領域的研發已超過 10 年。透過這 10 年的技術累積,Google 逐步將內部需求轉化為支援大規模運算的雲端基礎設施。歷代重點如下:

source: Google
Google TPU 歷代技術演進時間軸
2015 年 - TPU v1作為內部推論加速器 (Internal inference accelerator) 首次亮相,確立了專用 AI 晶片的基礎。
2018 年 - TPU v2導入分散式共享記憶體架構 (Distributed shared memory),規模可達 256 顆晶片協同運作。
2020 年 - TPU v3全面採用水冷散熱技術 (Liquid cooled),以應對運算密度提升帶來的散熱挑戰。
2022 年 - TPU v4具備光學可重構技術 (OCS) 與3D Torus網路架構,大幅提升叢集間的資料交換效率。
2023 年 - TPU v5 世代 (v5e / v5p)
v5e:專為中大型規模的訓練與推論打造 (Purpose-built for med and large scale training and inference)。
v5p:提供強大、具備高度擴展性與彈性的 AI 加速能力。
2024 年 - Trillium (TPU v6)在整體運算效能與能源效率 (Performance and efficiency) 上取得顯著突破。
2025 年 - Ironwood相較於前代 Trillium,Ironwood 帶來了5 倍的峰值運算能力 (5x peak compute)、6 倍的 HBM 記憶體容量 (6x more HBM),並將能源效率提升了2倍。
2026 年:TPU v8 的解耦式 (Disaggregated) 雙軌架構
面對大型語言模型與 AI 應用的複雜化,單一晶片架構難以同時在「極致算力」與「成本控管」上達到最佳平衡。因此,Google 今年的 TPU v8 首度導入解耦式設計,將工作負載明確分流:
TPU 8t (Training - 訓練專用):針對龐大參數模型的訓練需求所設計。架構上著重於提供極高的峰值運算能力 (Peak Compute) 以及高頻寬記憶體,以確保在長時間的叢集運算中維持最高效能,縮短模型開發週期。
TPU 8i (Inference - 推論專用):針對模型上線後的部署與服務需求所設計。架構上著重於降低延遲 (Latency)與提升能源效率,協助企業在規模化提供 AI 服務時,有效降低總體擁有成本 (Total Cost of Ownership, TCO)。
1.2. TPU v7 (Ironwood) 與 TPU v8 核心架構對比
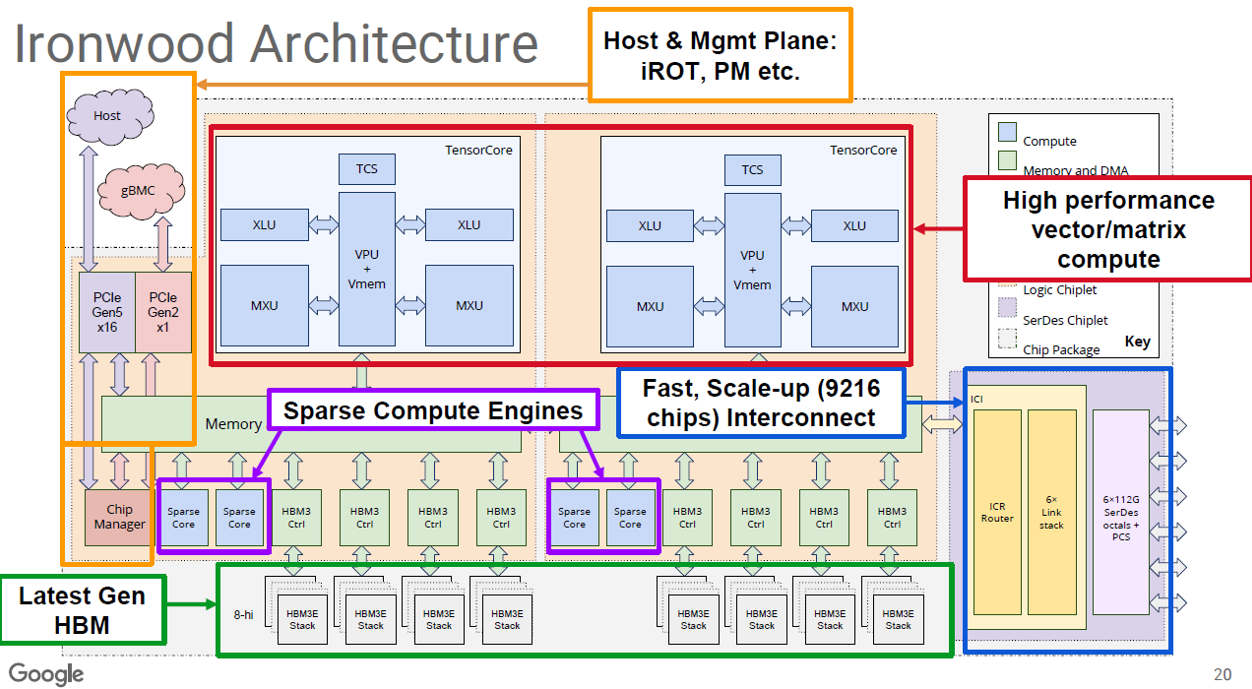
主要架構升級與加強功能分析:
source: Google
1. 高速互連介面 (Interconnect) 躍升至 224G SerDes
TPU 的Scale-up網路介面發生了關鍵的世代交替
v7 Ironwood:採用6x 112GSerDes octals(= 800Gbps)。
v8 :升級至6x 224GSerDes octals(=1.6Tbps)。
2. HBM 記憶體架構:由 8-hi 轉向 12-hi 高密度堆疊
v7 Ironwood:偏向擴展通道數量,採用8 組8-hi (8層) 堆疊的 HBM3E,總容量達到192GB(=8x24G)。
v8t:轉向提升單一模組密度,採用6 組12-hi (12層) 堆疊的 HBM3E,將總容量提升至216GB(=6x36G)。
3. 算力精度的演進與架構分流 (Disaggregation)
支援更低精度的資料格式:TPU v8t 透過原生支援FP4資料格式,將單晶片峰值算力大幅推升至12.6PFLOPs。相較於 Ironwood 主要依靠 FP8 達到的 4.6 PFLOPsFP4 在維持模型收斂有效性的前提下,提升了電晶體的利用效率與吞吐量。
解耦分流 (Disaggregation):v8 打破過往單一通用晶片的策略,首度將「模型訓練 (TPU 8t)」與「線上推論 (TPU 8i)」的硬體架構徹底分開,以針對不同階段的工作負載,精準最佳化峰值效能與總體擁有成本 (TCO)。
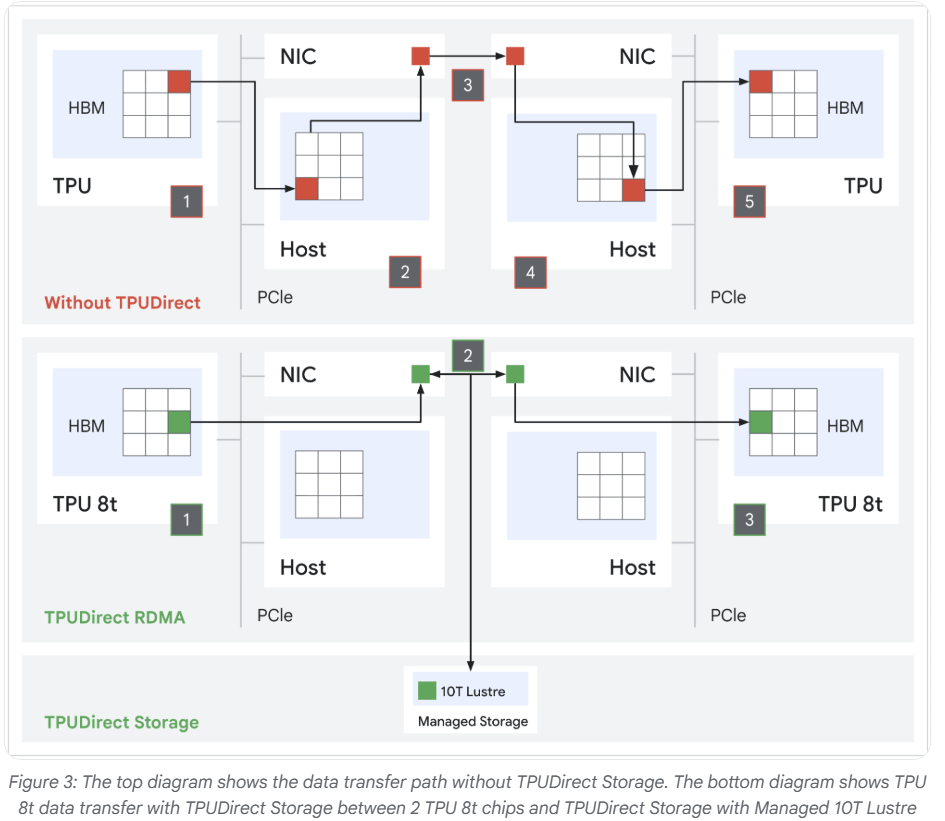
4. TPUDirect技術(包含 RDMA 與 Storage)
為了解決過往跨節點傳輸的 I/O 瓶頸,TPU 8t 導入了 TPUDirect 直通技術 :
source: Google
消除 Host 瓶頸 (Zero-copy):傳統架構下,資料傳輸必須經過 Host CPU 與系統記憶體轉發,形成彈跳緩衝 (Bounce Buffer)。TPUDirect 允許網路卡 (NIC) 透過 PCIe 點對點 (P2P) DMA,直接讀寫 TPU 的 HBM,完全繞過 Host。
釋放 PCIe 頻寬:由於資料不再需要於 PCIe 匯流排上來回傳輸兩次(TPU 到 Host,Host 到 NIC),這項直通技術有效將 PCIe 可用頻寬翻倍,並大幅降低網路延遲。
直連儲存系統:此架構同時延伸至儲存端 (TPUDirect Storage),讓 TPU 能將龐大的模型訓練狀態 (Checkpoint) 直接寫入後端的儲存系統(如10T Lustre託管儲存),無須 Host 介入,極大化大型叢集的 I/O 效率。
1.3. TPU 8t (訓練) 與 TPU 8i (推論) 硬體差異分析
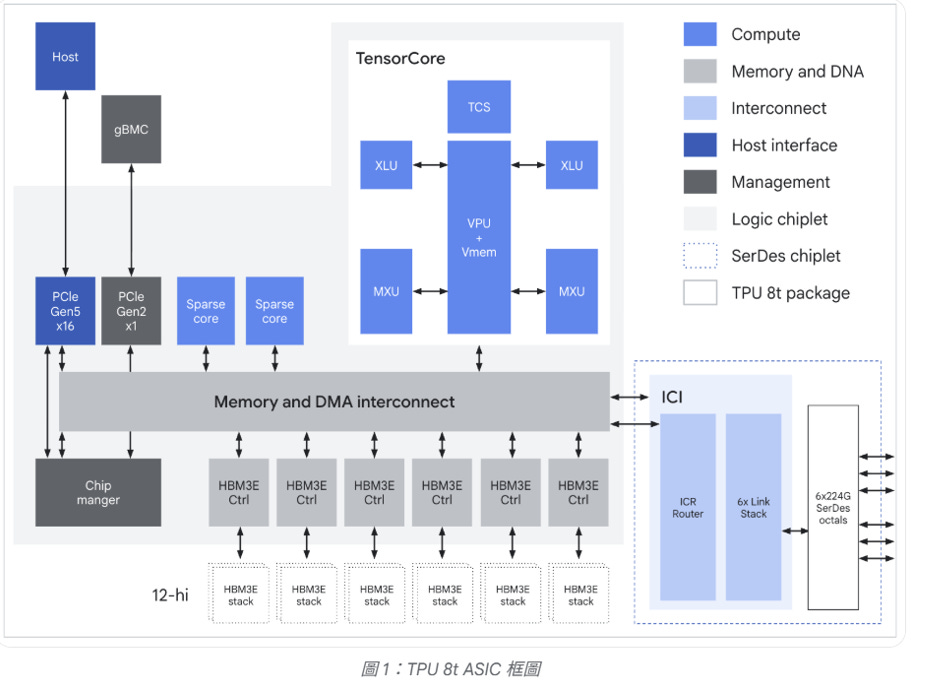
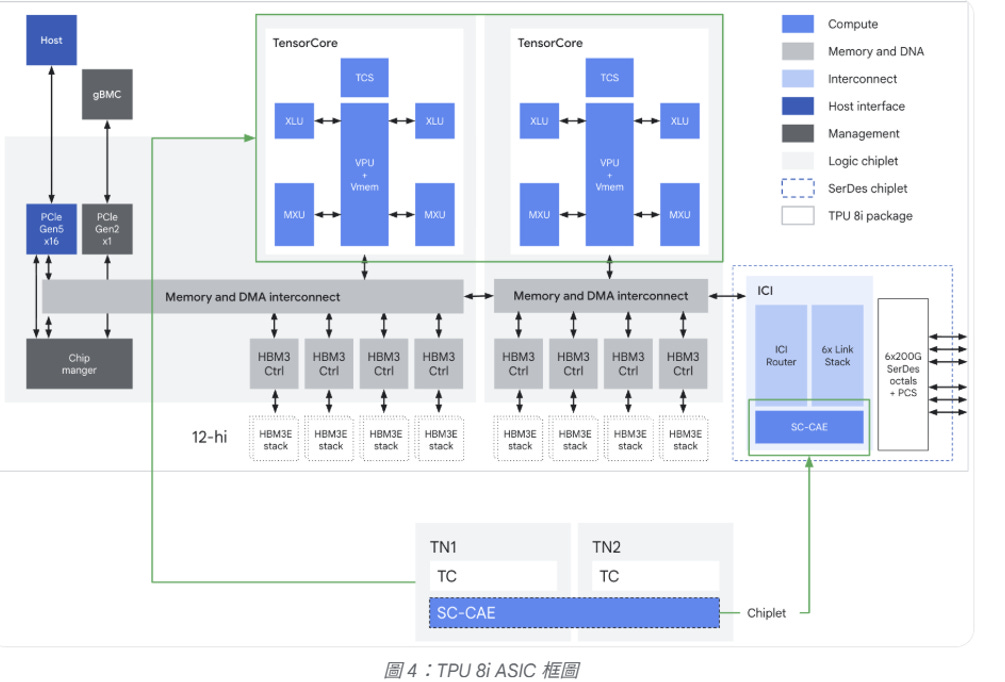
針對「訓練」與「推論」工作負載對系統資源截然不同的需求,Google 在 TPU 8t 與 TPU 8i 的硬體邏輯上進行了深度客製化 :
主要硬體邏輯差異分析:
source: Google
source: Google
1. 核心定位與設計哲學
TPU 8t (訓練最佳化):追求「絕對算力與吞吐量」。以單一龐大的運算複合體,應對超大 Batch Size 與巨型模型的預訓練需求。
TPU 8i (推論最佳化):追求「低延遲與高並發」。透過雙核心與大容量快取,解決 Token 生成時的記憶體牆瓶頸,專注於 Agentic AI 的即時回應。
2. 運算資源配置 (Compute)
TensorCore:
8t:配置 1 組超大陣列的 TensorCore,追求「絕對算力與吞吐量」,以單一龐大的運算複合體應對預訓練需求 。支援原生 FP4,單晶片峰值算力高達 12.6 PFLOPS 。
8i:配置 2 組獨立的 TensorCore,追求「低延遲與高並發」。雖然單一算力指標較低,但能並行處理不同的推論請求,大幅降低任務排隊的延遲 。
Sparse Core (稀疏運算核心):
8t:保留2 組。專職處理推薦系統或預訓練時龐大的不規則嵌入表 (Embedding Tables) 更新。
8i:因推論階段極少使用稀疏運算,將此區塊的晶片面積讓渡給其他更關鍵的元件。
3. 記憶體子系統 (Memory Subsystem)
SRAM (晶片內建快取):
8t:128 MB。維持基本容量,將矽晶面積保留給運算核心。
8i:384 MB (3倍大)。極大化將KV Cache鎖在晶片內部的能力,實現極低延遲的推論。
HBM 記憶體控制器:
8t:6 組HBM3E(6x36GB = 216GB)。專注於提供極致的循序存取頻寬。
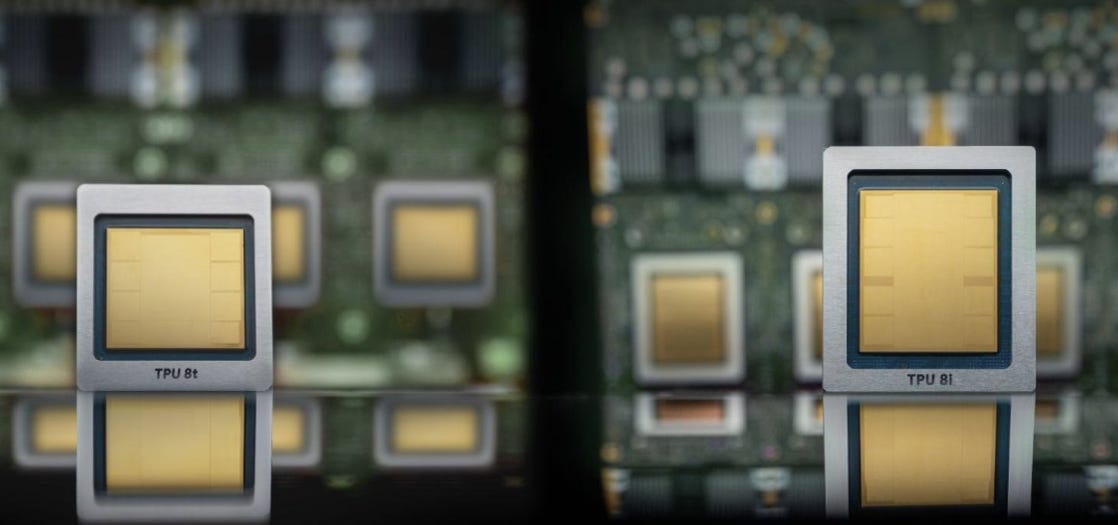
從官網釋出的圖片中,可以明顯地看出,TPU 8i的晶片實體尺寸(Die Size)與封裝明顯大於TPU 8t,最主要原因是「記憶體子系統」的物理擴張。
source: Google
4. 網路通訊與拓撲
TPU 8t (Broadcom IP):標示224G。強調實體層 (PHY) 的極限傳輸速率,因應龐大的跨節點資料交換。
TPU 8i (聯發科 MTK IP):標示200G (+ PCS)。強調 MAC 層的實際有效資料吞吐量。
叢集網路拓撲:
TPU 8t:採用3D Torus網路。適合處理大規模的模型權重同步 (All-Reduce)。
TPU 8i:採用Broadfly網路,並首度導入SC-CAE(SparseCore-Collectives Acceleration Engine, 專屬加速引擎)。由硬體直接接管跨晶片的集合通訊,徹底解放 TensorCore,讓片上通訊延遲縮減近5 倍。

source: Google
2. Google AI networking
傳統 AI 網路傾向於「堆疊標準化、分層明確」的樹狀拓撲;而 Google 則是憑藉其對底層基礎設施的絕對控制權,打造出「高度客製化」的專屬網路矩陣。
傳統 AI 網路架構
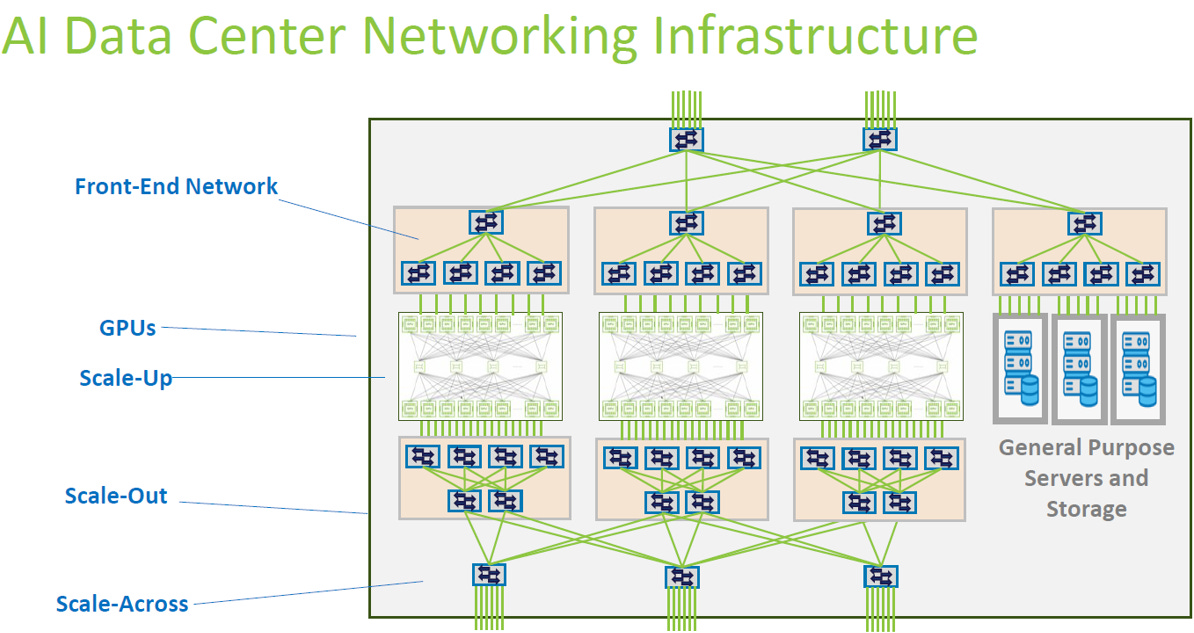
source: Terahop
傳統架構通常是由多家網通與晶片大廠(如 NVIDIA、Broadcom、Cisco)的技術標準拼湊而成,呈現嚴格的階層式(Hierarchical)設計。其資料流與硬體邊界非常清晰:
Scale-Up (向上擴展):位於單一伺服器節點(Node)內部。通常採用專有高速匯流排(例如 NVIDIA NVLink / NVSwitch 或 AMD Infinity Fabric),負責同機箱內 GPU 之間的極低延遲、高頻寬記憶體共享。
Scale-Out (向外擴展):負責伺服器節點之間的連接,構成一個運算叢集(Pod/Cluster)。業界主流標準是採用 InfiniBand 或無損乙太網路(RoCE v2),透過以太網交換器(Switch Trays)進行資料傳輸。
Scale-Across (跨叢集擴展):當單一叢集無法容納模型時,用來連接不同運算孤島的骨幹網路。這裡通常會遭遇較大的頻寬收斂比(Oversubscription)與延遲瓶頸。
Front-End Network (前端網路):傳統的標準乙太網路(通常走 TCP/IP),負責處理與 AI 運算無關的任務,包含節點管理(BMC)、除錯、外部網路接入,以及連接一般通用伺服器與傳統儲存陣列。
Google Cloud AI 網路架構
Google Cloud的 AI 網路架構,呈現了層次分明且具備高度硬體相容性的設計。整體網路分為三個主要層級:負責局部互連的 Scale-up、負責叢集擴展的Virgo(Scale-Out),以及作為全局骨幹的Jupiter (Front-End Network)。

source: Google
Scale-Up Network (加速器專屬互連層)
位於架構的最底層,負責單一節點或緊密運算單元內部的極高頻寬、極低延遲通訊。此層級採用各硬體原生的互連標準:
TPU Scale up (ICI):Google 專為 TPU 開發的互連技術 (Inter-Chip Interconnect),用於 TPU 之間的直接通訊。
GPU Scale up:針對 GPU 叢集,採用對應的業界標準互連技術 (如 NVIDIA 的 NVLink 架構),以處理 GPU 間的記憶體共享與資料交換。
Scale-Out Network - Virgo (AI 叢集擴展網路)
Virgo扮演 AI 運算孤島內的專屬網路,專注於處理模型訓練時龐大的東西向流量 (如 All-Reduce 梯度同步)。
Virgo 同時被配置在GPU 叢集與TPU 叢集的上方。這顯示 Virgo 是一套具備普適性的高效能網路矩陣,能為不同類型的 AI 加速器提供大規模的分散式節點互連。
Front End Network - Jupiter (全局骨幹與相容性中樞)
位於圖表中央的 Jupiter 是整個架構的樞紐。除了處理傳統的前端流量,其在 AI 基礎設施中最關鍵的特性在於強大的異質相容性與整合能力:
兼容 GPUs 與 TPUs:Jupiter 作為統一的橋樑,將左側的 GPU叢集與右側的 TPU叢集連接在同一個資料中心網路架構下。這使系統能靈活配置、混合管理來自不同供應商的算力資源,打破硬體專有網路所造成的孤島效應。
整合通用運算與儲存 (Compute & Storage):AI 任務高度依賴資料吞吐。Jupiter 將 AI 叢集與傳統的 CPU 運算資源及儲存系統打通,確保模型在訓練時能以最高效率讀取龐大的資料集,並快速寫入 Checkpoint 狀態。
連接廣域網路 (WAN):Jupiter 處理資料中心與外部的通訊,負責將流量導向廣域網路 (To other campuses),支援跨資料中心的分散式任務或備援機制。
在這套網路架構中,底層的 Scale-up 保留了硬體的原生效能;中層的Virgo提供了叢集規模的平行運算能力;而頂層的 Jupiter 則發揮了極高的相容性,將 TPU、GPU、儲存系統與外部網路整合為一個統一的基礎設施矩陣。
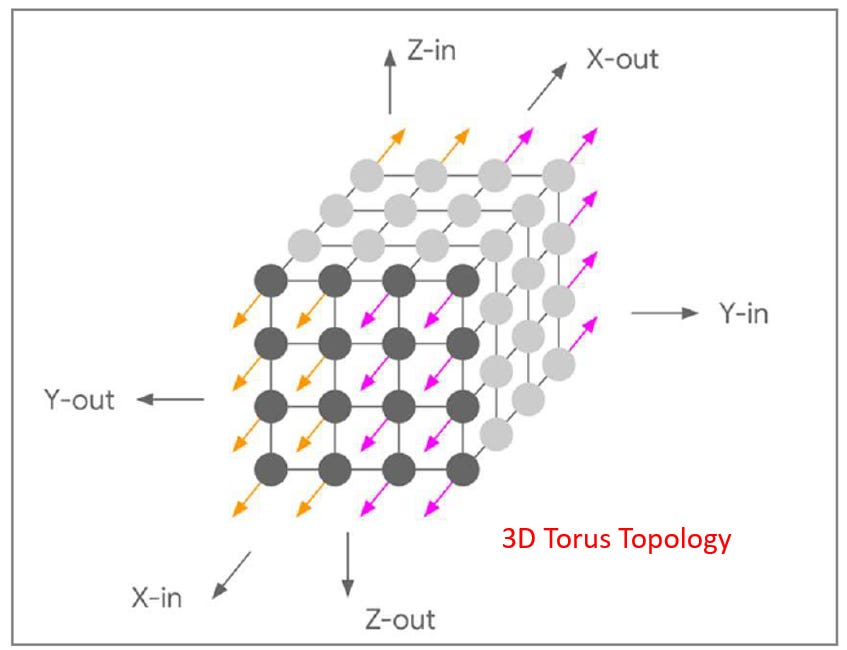
2.1. Scale-Up: 3D Torus 架構 (適用於 TPU 8t)
網路拓撲:無交換器設計 (Switchless, No EPS)
source: Google
ICI (Inter-Core Interconnect):
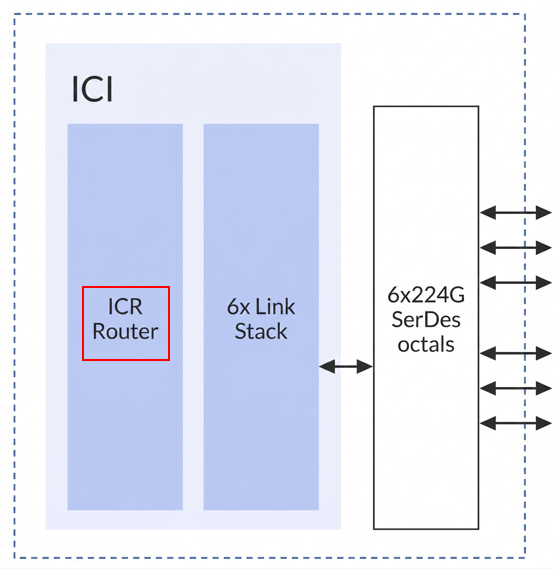
ICR Router:ICI 區塊內部整合了「ICR Router」(Inter-Core Router),路徑選擇與封包轉發由內建硬體路由器直接處理 ,反應速度快。
高頻寬介面:圖中顯示路由器連接至「6x Link Stack」與高達「6x224G SerDes octals」的介面,以支撐3D Torus六個方向的1.6Tbps資料吞吐。
Cube 結構與雙向光纖技術 (BiDi):
source: Google
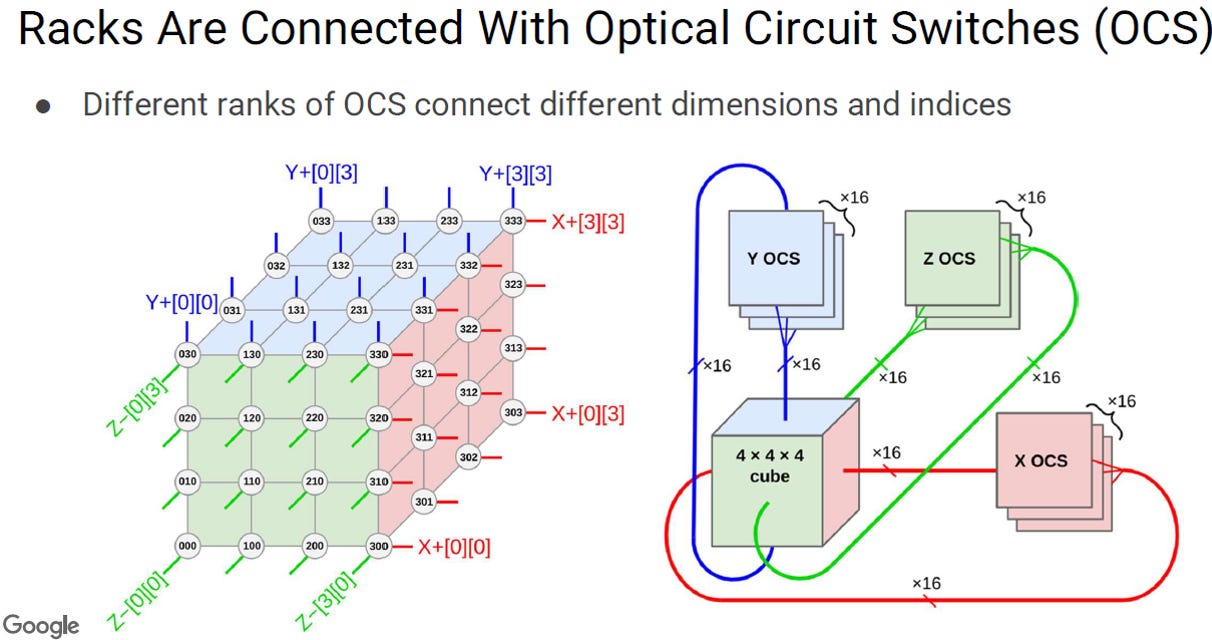
Cube 內部架構:基本的建構單元為 4x4x4 的 Cube(共 64 個節點),內部短距離通訊採用低成本、低延遲的銅線或 PCB 走線 。
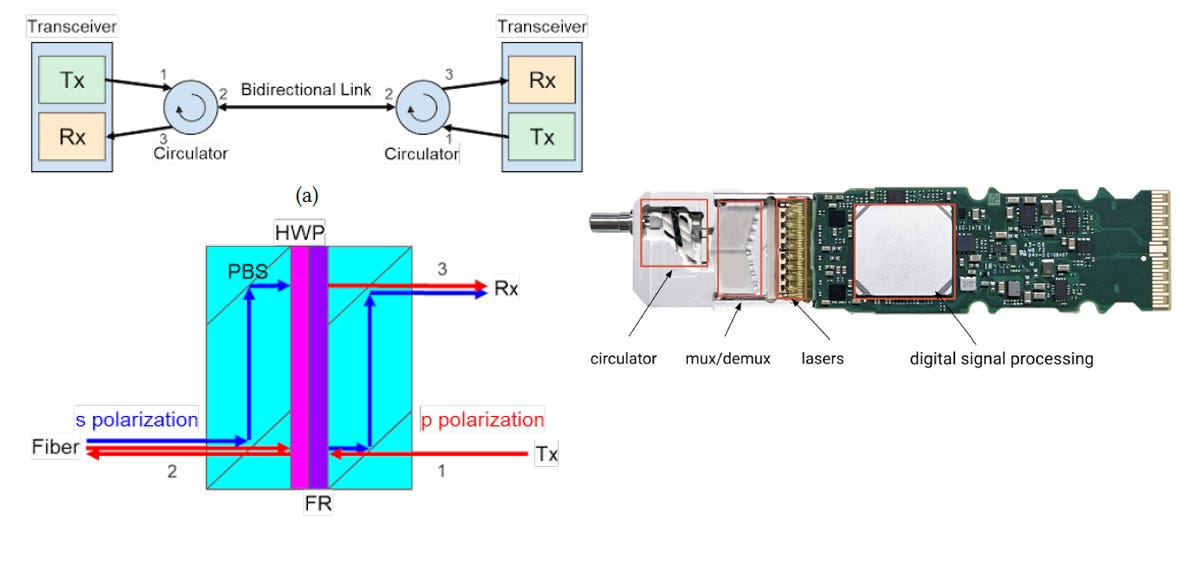
Cube 外部擴展:一個 4x4x4 的Cube共有6個面 (+x, -x, +y, -y, +z, -z),每個面有 4x4 =16個節點。因此,一個Cube會向外提供 6 x 16 =96條光學鏈路。分散連接到不同的光學電路交換器(OCS),確保單點故障時不致全盤斷線 。
source: Google
OCS (Optical Circuit Switch) 運作原理

source: Google
全光學交換:OCS在轉發資料時,不需要將光訊號轉換為電訊號再轉回光訊號 (O-E-O轉換)。訊號光進入後,直接由物理鏡面反射至目標輸出埠。這種設計對傳輸協定與速率完全透明 (Protocol and rate agnostic)。
MEMS 反射鏡陣列:核心組件為兩組 2D MEMS (微機電系統) 陣列,每組包含136個微型反射鏡(Google自研的PalomarOCS)。光束由輸入端準直器射出後,經過第一片MEMS鏡面轉向,再由第二片MEMS鏡面反射至對應的輸出端。
光學監控機制:為了精確控制微型反射鏡的角度,系統注入了 850nm 的監控光源 (Monitor light),並利用分色鏡 (Dichroic splitter) 將其與資料訊號光結合。監控光反射後會由相機模組 (Camera module) 接收,藉此提供閉環控制,確保光路精準對齊。
2.2. Scale-Up: Boardfly 架構 (適用於 TPU 8i)
針對低延遲需求的場景(例如大型語言模型的推論),過高的網路直徑(Network Diameter)與跳數(Hops)會成為效能瓶頸,這正是 Google 在TPU v8i採用Boardfly(Dragonfly 拓撲的變體)架構的核心動機。
3D Torus 與 Boardfly 的跳數(Hops)比較
3D Torus (8x8x16):在 3D Torus 拓撲中,最遠節點的距離為各維度節點數的一半相加。其最大跳數確實為8/2 + 8/2 + 16/2 = 4 + 4 + 8 = 16跳。這對於需要頻繁 All-to-All 通訊或嚴格推論延遲(Inference Latency)的任務來說,16 跳所累積的傳輸與路由延遲較高,但仍可維持1.6Tbps的速度(假設沒有封包碰撞與網路壅塞)。
Boardfly (Hierarchical Topology):透過階層式的全連接(Fully-connected)設計,搭配光學電路交換器(OCS),成功將包含1152個 TPU 的叢集最大跳數(Maximum Network Diameter)大幅壓縮至7 跳。但速度會降低。
TPU 8i Boardfly 階層式架構解析
此架構分為三個層級:

source: Google
Level 1:單一載板 (Tray / Building Block, BB)
每一張板子上包含4 個 TPU晶片。
這 4 個 TPU 之間為全連接 (Fully connected)。
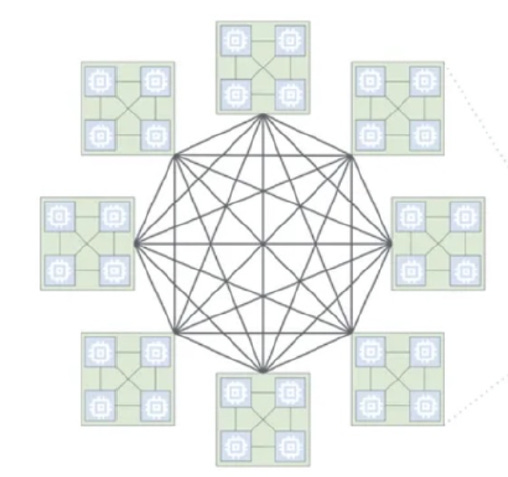
Level 2:群組 (Group / Rack)
由 8 個 BB 組成一個群組(共8 x 4 = 32個 TPU)。
群組內的 8 張板子之間透過銅線(Copper links)進行全連接(如圖中間的八角星狀連線)
Level 3:Pod (透過 OCS 連接)
一個 Pod 包含 36 個群組(共36 x 32 = 1152個 TPU)。
這 36 個群組之間透過光學連線與 OCS(Optical Circuit Switches)達成全連接。
最大 7 跳 (7-Hop) 路由路徑拆解
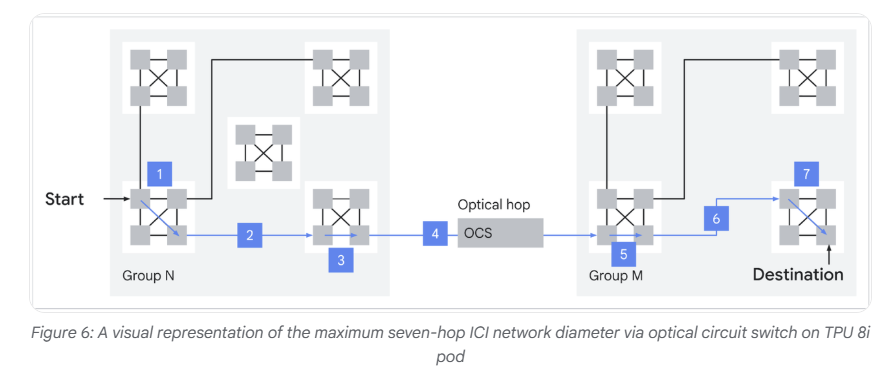
當封包需要從「Group N」的最遠端 TPU 送達「Group M」的最遠端 TPU 時,會經歷以下 7 個 Hop 的最長路徑:
source: Google
起點群組內 (Group N):
Hop 1:起點 TPU 將資料傳送至同載板 (Tray) 上負責對外溝通的 TPU。
Hop 2:透過載板間的銅線 (Cu links),傳送至負責光學輸出的目標載板。
Hop 3:在該載板內部,傳送至連接光學模組的邊界 TPU。
跨群組光學傳輸:
Hop 4 (Optical hop):資料透過 OCS,從 Group N 光學直達Group M 的邊界 TPU。
終點群組內 (Group M):
Hop 5:在接收端的載板內部,邊界 TPU 將資料傳送至負責內部路由的 TPU。
Hop 6:透過載板間的銅線,傳送至目標 TPU 所在的載板。
Hop 7:在目標載板內部,最終傳送至目的地的 TPU。
從 3D Torus 轉換至 Boardfly 階層式全連接架構,確實是為了在維持大規模Scale-up的同時,強制收斂最大網路跳數(16 hops降至7 hops),以滿足推論任務對尾部延遲(Tail Latency)的嚴格要求。
頻寬切分與兩點間速度 (Pairwise Rate) 限制
TPU 8i 單板(Board)頻寬切分

source: Google
物理總資源:單板搭載 4 顆晶片,每顆晶片內建 48 條 200G Lanes(單板總計 192 條 Lanes)
Level 1(板內消耗):每顆晶片消耗 24 條 Lanes(3 個 1.6 Tbps 控制器)與板內其餘 3 顆晶片環狀直連,共消耗 96 條 Lanes 。
外部接口變更(96 條 Lanes 拆分):剩餘 96 條 Lanes 均分給文件所述的16 個外部接口(根據官方文件),每個接口物理上僅分配到 6 條 Lanes 。
單個外部接口速率:6 Lanes * 200 Gbps =1.2 Tbps 全雙工。
16 個外部接口(1.2 Tbps)走向
11 個接口(Intra-rack):用於同機櫃內 8 塊板卡間的全連接銅纜通訊 。
5 個接口(Inter-rack):走機櫃外,透過雙向(BiDi)光學模組與環形器技術連接中央OCS,建構跨機櫃的大叢集通訊 。
任意特定兩點間速度(Pairwise Rate)
Level 1(板卡內)Pairwise Rate計算
物理幾何:4 顆 TPU 連成一個完全平權的 4 晶片 Fully-Connected Mesh。
算式:每顆 TPU 為了與其餘 3 顆鄰居達成點對點直連,各自拉出一個獨立的 1.6T 核心控制器(8 Lanes)。 Pairwise Rate = 1 控制器 x 1.6 Tbps =1.6 Tbps
Level 2(機櫃內)Pairwise Rate計算
source: Google
物理幾何:1 個機櫃(Group)內有 8 塊 Board,彼此要做 8 節點的 Fully-Connected Mesh
計算步驟:
1 塊 Board 往櫃內共拉出 11 個 1.2 Tbps 的接口,總出站頻寬為 11 x 1.2 Tbps = 13.2 Tbps
這 11 個接口必須分配給其餘 7 塊鄰居板卡,數學上無法整除(11 / 7 = 1.57)。因此,Google 工程師在實體配線時,必然將這 11 個接口做非對稱的交錯分配:有 4 個方向分配到 2 個接口,有 3 個方向只能分配到 1 個接口。
當執行 All-to-All 全局交換時,板卡間的總頻寬會被兩端晶片形成的 16 對特定晶片組合(4 x 4 = 16)所均分:
強方向 (2 個接口):Pairwise Rate = (2 x 1.2 Tbps) / 16 =150 Gbps
弱方向 (1 個接口):Pairwise Rate = (1 x 1.2 Tbps) / 16 =75 Gbps
Level 3(跨機櫃)Pairwise Rate計算

source: Google
物理幾何:整個叢集有 36 個機櫃(Groups),必須互相連接形成一個 36 節點的大型 Dragonfly 拓撲
計算步驟:
單機櫃對外總頻寬 = 8 塊 Board x5 接口x 1.2 Tbps = 48 Tbps
這 48 Tbps 的總頻寬,在打向 OCS 網域後,必須分流給全場其餘 35 個獨立機櫃。 機櫃對機櫃 (Group-to-Group) 直連頻寬 = 48 Tbps / 35 約等於 1.3714 Tbps
在跑 All-to-All 時,這條 1.3714 Tbps 的跨櫃鏈路,必須被本端機櫃的 32 顆 TPU 與目標機櫃的 32 顆 TPU 所形成的 1,024 對特定晶片組合(32 x 32 = 1,024)集體攤平:特定 TPU-to-TPU 跨櫃 Pairwise 頻寬 = 1.3714 Tbps / 1,024 約等於 1.34 Gbps !
註: Google未釋出相關資料,計算僅供參考
2.3. Scale-Out: Virgo 網路架構與突發流量對策
網路架構演進:TPU v7 Scale-Out

source: Google
TPU v7 (Ironwood) AI network
Scale-Up:單一 Superpod 內部透過 3D Torus 拓撲相互連接,最大擴展至 9,216 顆晶片。
Scale-Out:TPU v7 的跨叢集橫向擴展(Scale-Out)網路與前端資料輸入、儲存存取(Data Ingestion & Storage),均共同操作並擠在同一個Jupiter 網路(資料中心南北向骨幹)中,未在實體層面進行物理流量隔離。
次毫秒級線速突發 (Sub-millisecond Line-rate Burst)

source: Google
同步集體通訊 (Synchronized Collectives):在進行大型語言模型(LLM)或混合專家模型(MoE)的分散式訓練時,數萬顆晶片會以高度同步的步調,交替執行「資料計算」與「全域通訊」。
瞬間灌滿頻寬 (Line-rate Spikes):當所有節點在同一個微秒級的時間點完成反向傳播計算、準備進行梯度同步(例如執行 All-Reduce 或 All-to-All)時,網路介面會在一瞬間從「完全閒置 (0 Gbps)」直接飆升到「實體線速滿載 (Line-rate)」。
時間尺度:若使用傳統資料中心常見的1 秒解析度 (1 second resolution)監控工具,這些極端的尖峰會被時間平均拉平,看起來流量平緩。然而,一旦切換到次毫秒級解析度 (Sub-millisecond resolution),就會顯現出由無數個方波組成的極端脈衝。
突發流量對 Scale-Out 網路的破壞與衝擊
緩衝區溢位與丟包 (Buffer Pressure):這種短暫、密集且高度同步的突發流量,會在毫秒級時間內釋放龐大數據,瞬間將傳統電氣交換器(EPS)的封包緩衝區(Packet Buffers)灌爆,導致嚴重的網絡壅塞與丟包。
落後者效應 (Straggler Node):由於 AI 分散式訓練普遍採用大量同步並行(BSP)模式,只要任何一個封包因為網路瞬態壅塞而延遲,整個訓練叢集(數萬顆晶片)都必須停下來原地等待。這會導致晶片的 Duty Cycle 大幅下滑,嚴重打擊整體有效算力(Goodput)。
共用 Jupiter 的劣勢 (TPU v7 痛點):在 TPU v7 (Ironwood) 世代,當這類突發的 Scale-Out 同步流,與常規的儲存讀寫流量共同競爭 Jupiter 網路鏈路與緩衝區時,兩種不同型態的流量會相互干擾,使瞬態壅塞的預測與控制變得極其困難。
Virgo 網路(Scale-Out)架構與對策
雙層非阻塞交換拓撲(2-layer ESP, fully non-blocking)
為了解決 AI 訓練中常見的次毫秒級線速突發(Sub-ms line-rate burst)壅塞問題,Virgo 網路在 Scale-Out 層級改用雙層電氣封包交換器(ESP)建立Clos拓撲。

source: Google
提供完全非阻塞(Fully non-blocking)的對等頻寬。
利用電氣交換器內建的封包緩衝區(Packet Buffers)與硬體路由排程能力,直接在橫向擴展層面消化瞬間湧入的集體通訊同步流量(如 All-Reduce、All-to-All)
獨立平面容錯架構
TPU 8t 機架(Racks)內部的晶片透過網路卡(NIC),將對外流量分分流至多個完全實體隔離的獨立交換平面(Independent Planes)(圖中以綠、紅、藍三色線條與獨立的交換方塊區分)。
突發流量分流:突發的流量脈衝會被平均分散到不同的 ESP 實體平面進行傳輸,減輕單一交換晶片的緩衝區溢位壓力。
硬體級容錯:單一交換平面或線路發生故障時,其餘獨立平面仍能維持運作,避免整個大規模訓練叢集因單點網路故障而退化為落後者(Straggler)。
大規模叢集流量解耦
Virgo Network:利用 2 層 ESP 專網,純粹承載 TPU 8t 機架之間的高密度橫向擴展訓練流量。
Jupiter Network:機架另有獨立線路連向 Jupiter 的聚合區塊(Aggregation blocks),再經由 Apollo OCS(Optical Circuit Switch)連接至分散式全球廣域網(Distributed Global WAN)與輔助運算/儲存單元。
3. 其他關鍵硬體特性分析
3.1. 整合型矽電容 (ISC, Integrated Silicon Capacitor)
TPU 8t 封裝佈局:
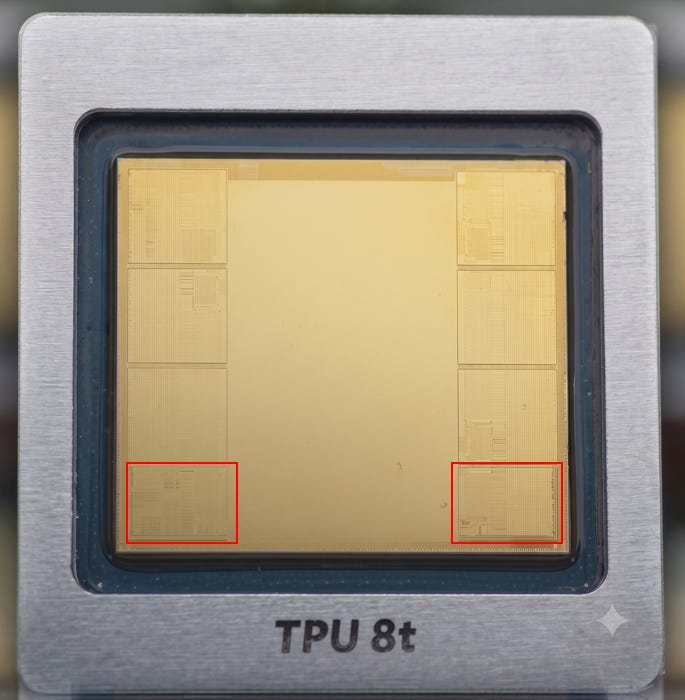
HBM 配置:中央大面積為主運算邏輯區,左右兩側各有 3 個記憶體堆疊,總計為6 顆 HBM。
ISC 區域:用紅框標示出的底部兩個角落,其表面紋理與上方的 HBM 陣列明顯不同。在先進 AI 晶片封裝中,為了就近供應高速 I/O 與大電流瞬態切換所需的電荷,將ISC (整合型矽電容)放置於晶片邊角或緊鄰 PHY 的位置是標準的架構設計。
ISC的功能
ISC 的核心功能在於提升電源傳輸網路 (PDN, Power Delivery Network) 的完整性與穩定性,具體表現如下:

source: Rebellions
抑制 PDN 阻抗共振 (Lowering PDNZ):從右側的頻率響應圖可以明顯看出,當連接 ISC 後(紅線),VDDQL (HBM3E) 與 PHY 的電壓阻抗峰值被大幅壓平。這能有效吸收高頻切換時產生的雜訊。
緩解電壓降 (Voltage Droop Mitigation):AI 運算(尤其是 NPU 與 HBM 之間的高速資料傳輸)會產生極大的瞬態電流需求 (di/dt)。傳統 PCB 上的 MLCC 電容距離過遠,寄生電感過大,無法即時反應。ISC 透過與 Die 封裝在一起,縮短了供電路徑,能提供局部的瞬間電荷補充,確保高速傳輸時的訊號完整性。
ISC供應鏈動態
三星電機(Samsung Electro-Mechanics)近期在矽電容(ISC)領域取得了重大的商業突破。
三星 ISC 重大供應合約資訊
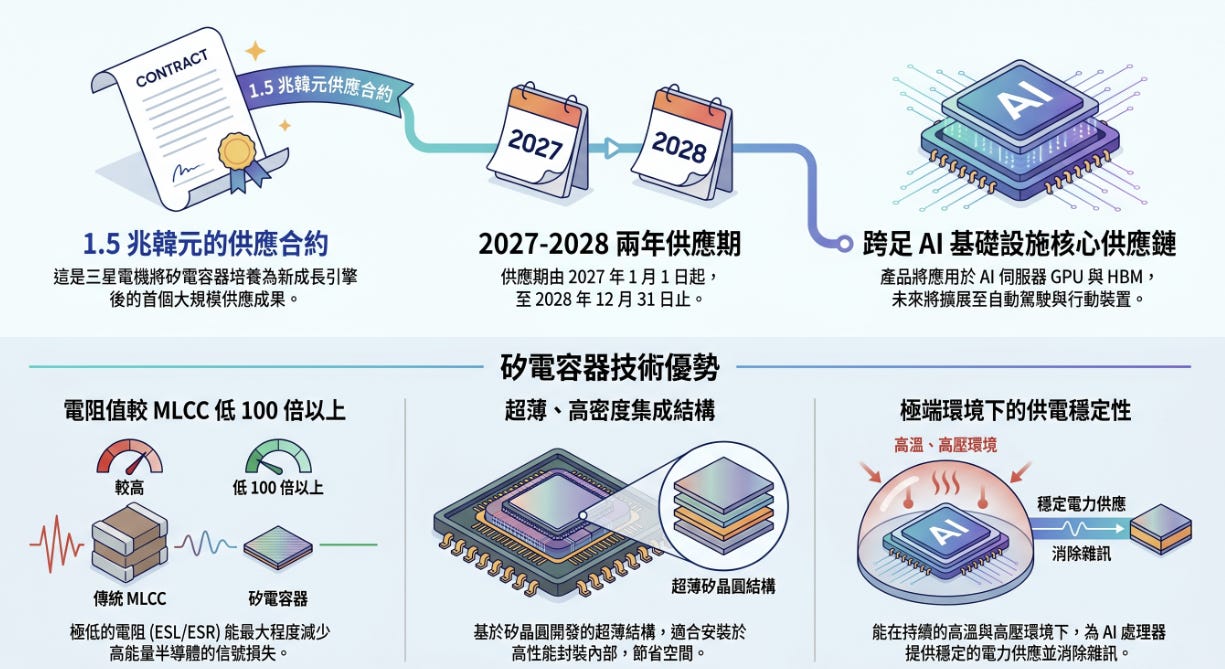
1.5 兆韓元超級大單:三星電機成功拿下總值高達 1.5 兆韓元的矽電容器供應合約,這是他們將 ISC 培養為新成長引擎後的首個大規模供應成果。
出貨時程:合約明確規定了兩年的供應期,自 2027 年 1 月 1 日起至 2028 年 12 月 31 日止。
核心應用場景:這批矽電容將直接打入 AI 基礎設施的核心供應鏈,專門應用於 AI 伺服器的 GPU 與 HBM 中,未來藍圖更計畫擴展至自動駕駛與行動裝置領域。
ISC 技術優勢
超低電阻減少損耗:ISC 的電阻值(ESL/ESR)較傳統 MLCC 低 100 倍以上,能夠最大程度地減少高能量半導體在高速運作下的信號損失。
超薄高密度結構:基於矽晶圓開發的超薄結構,使其非常適合直接安裝(或內嵌)於高性能先進封裝內部,大幅節省寶貴的空間。
極端環境穩定性:AI 處理器運作時會產生極高熱能,ISC 能夠在持續的高溫與高壓環境下,穩定地提供電力並消除雜訊
這份合約不僅確立了三星在 ISC 市場與村田製作所(Murata)等大廠競爭的地位,也印證了先進封裝對於整合型矽電容的強烈剛性需求。
3.2. Native FP4 數據格式與設計哲學
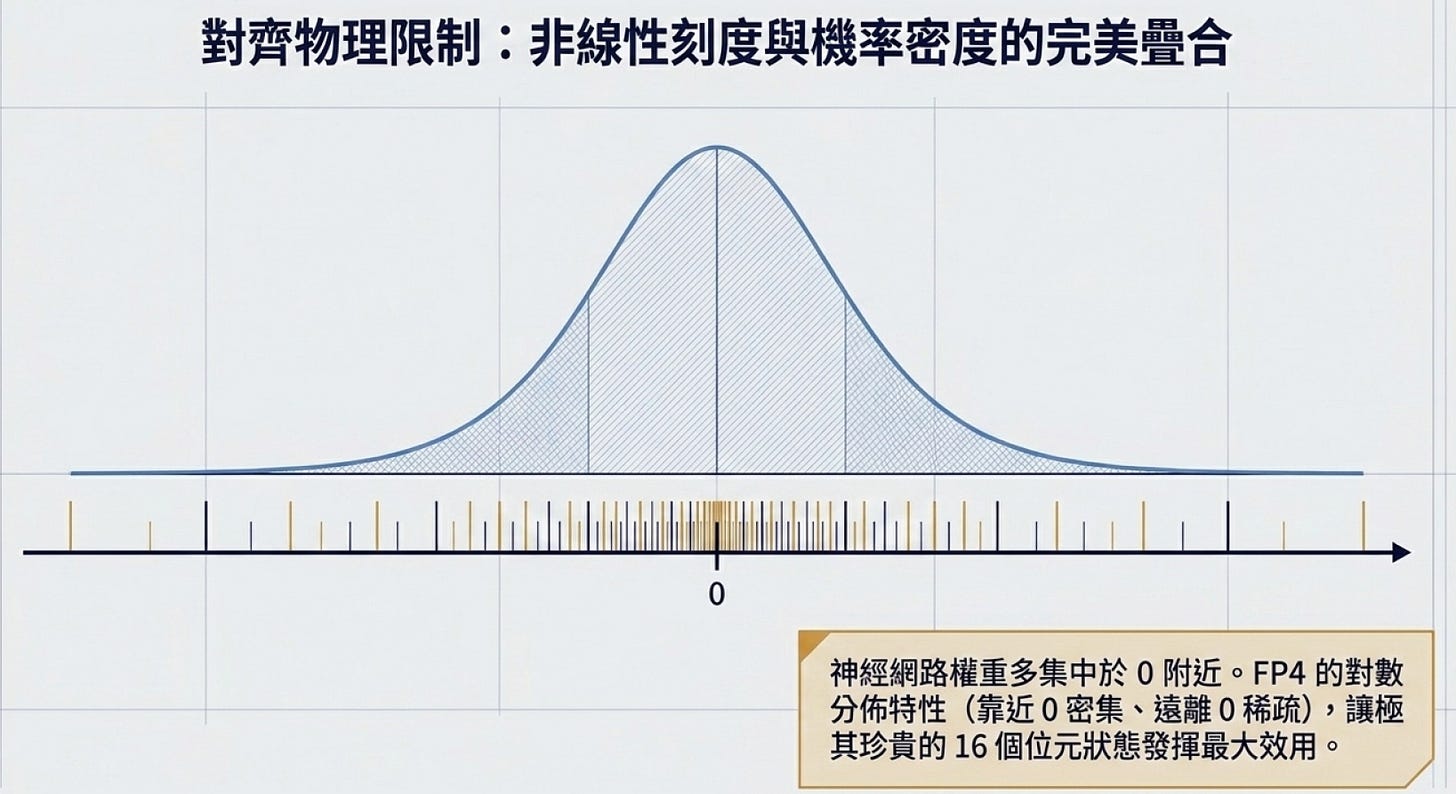
FP4 (4-bit Floating Point) 數據格式近期在 AI 領域備受重視。因為 AI 模型的參數分佈通常呈現常態分佈(集中在零附近),FP4非線性分佈的特性,相較於整數格式(INT4),能更精準地擬合這種分佈。透過降低運算精度,FP4 能大幅減少記憶體頻寬消耗與運算功耗,成為提升模型訓練與推論效率的關鍵技術。

source: Hotchips 25
FP4 數值特性:非線性分佈
純粹的 4 位元浮點數(FP4)總共只能表示 16 種狀態(24= 16)。扣除正負號重疊的 0,實際上只有15個有效數值。
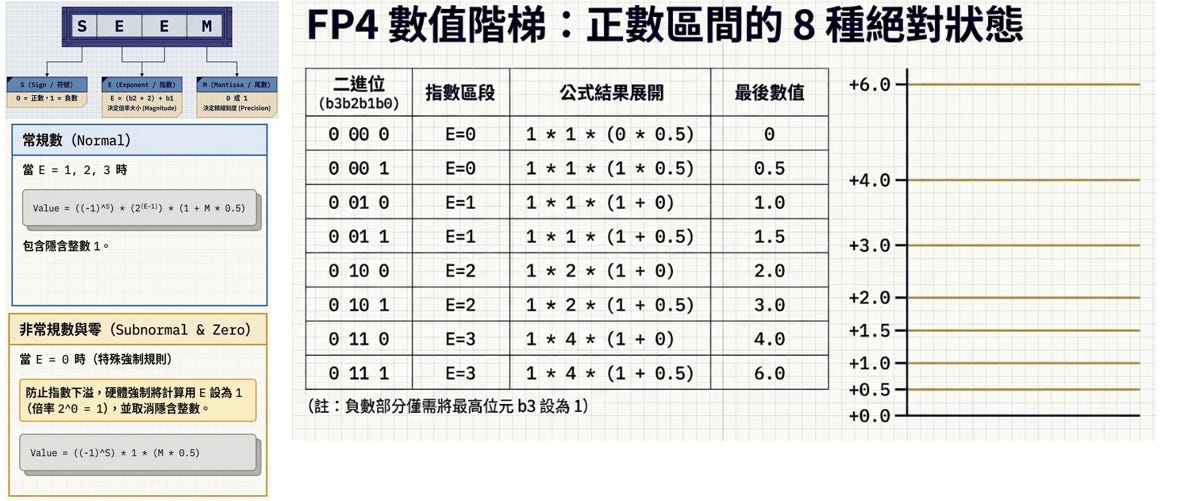
非線性間距 (Nonlinear Spacing):FP4(採 1 個符號位、2 個指數位、1 個尾數位,即 E2M1 格式)的數值並非等距分佈。
在靠近 0 的區間(例如 0 到 1.5 之間),數值階梯的間距較密(0, 0.5, 1.0, 1.5),能提供較高的解析度。
在較大的區間,數值階梯的間距變寬(2.0, 3.0, 4.0, 6.0),容錯率降低
優勢:這種「中間密、兩頭疏」的特性,完美契合 AI 模型中權重(Weights)與活化值(Activations)多集中於零附近的統計分佈,因此在相同位元數下,FP4 的表現通常優於等距分佈的 INT4。
解決 Range 問題:三大主流縮放 (Scaling) 架構
由於 FP4 的最大絕對值僅到 6.0,直接使用極易造成數值溢出(Overflow)或下溢(Underflow)。為了解決這個致命的 Range 問題,業界引入了「縮放因子(Scaling Factor / Shared Exponent)」,即多筆 FP4 資料共用一個高精度的指數(如 8-bit),在運算前進行放大或縮小。
不同的陣營對於「幾筆資料共用一個縮放因子(縮放粒度)」以及「由誰來負責縮放」有不同的設計哲學:
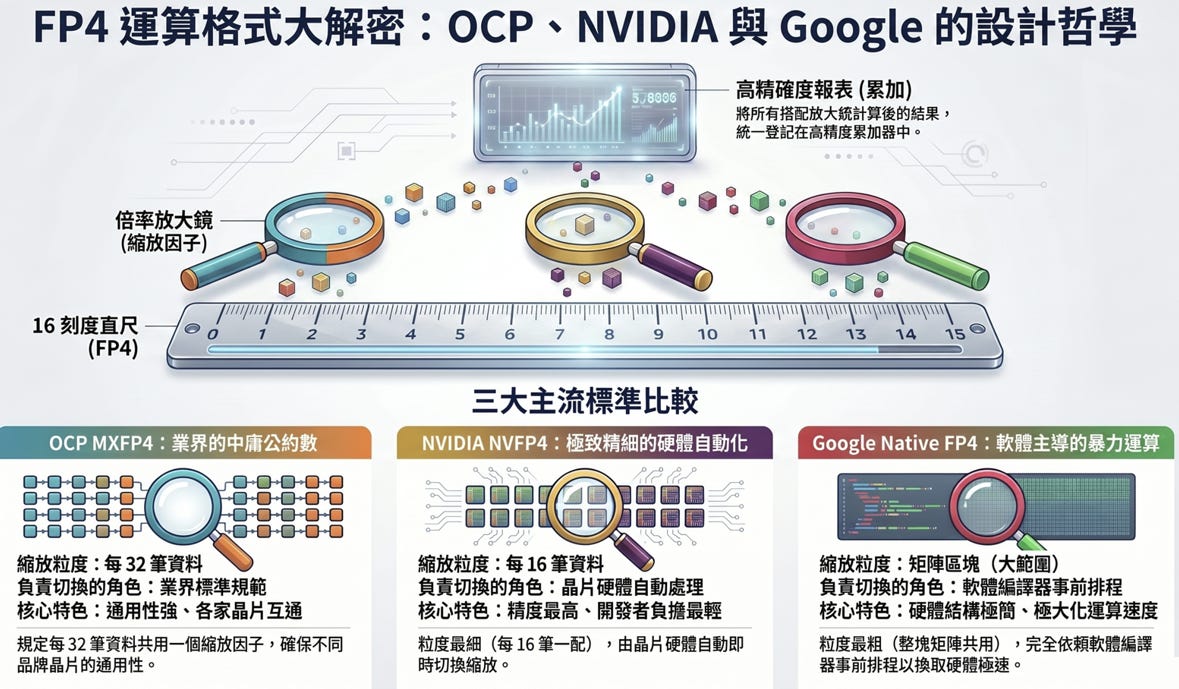
OCP MXFP4:業界的中庸公約數
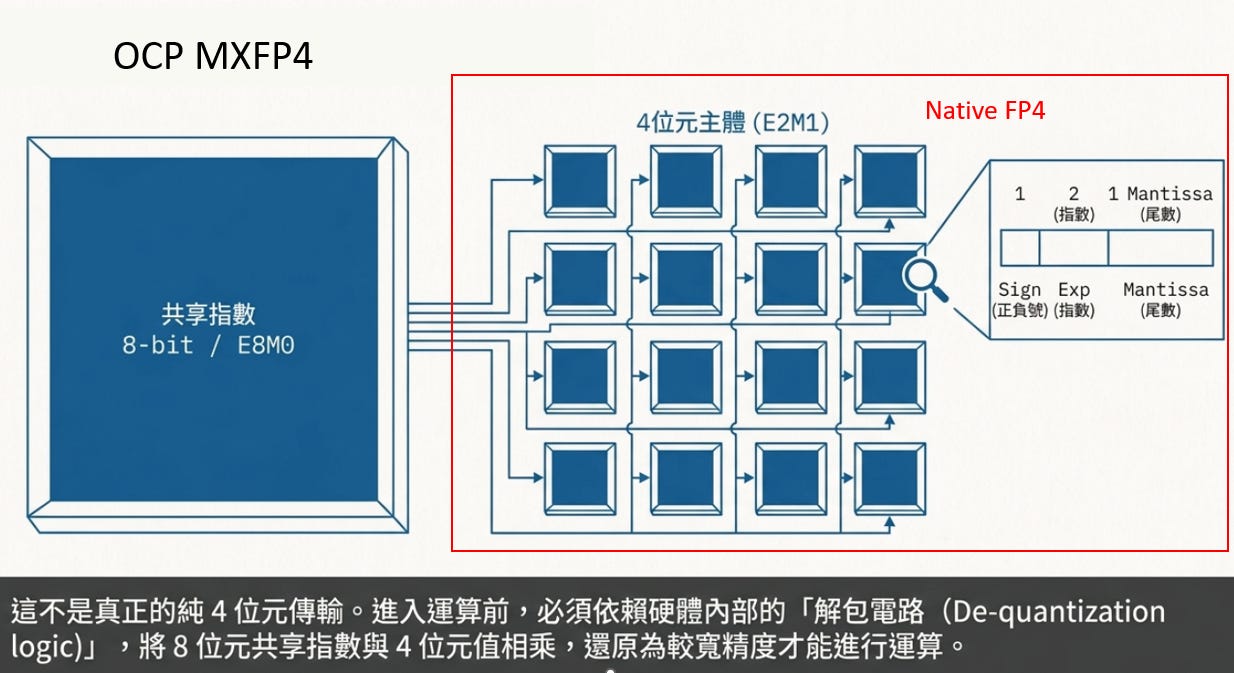
縮放粒度:每32 筆資料共用 1 個 8-bit 縮放因子(E8M0)。
運作機制:如下圖所示,進入運算前,必須依賴硬體內部的「解包電路(De-quantization logic)」,將 8 位元共用指數與 4 位元主體相乘,還原為較寬精度後才能進行運算。
核心特色:這是一個由AMD、Arm、Intel、Meta、Microsoft等大廠共同制定的開放標準(OCP MX Specification),通用性最強,確保不同品牌晶片間的互通性。
NVIDIA NVFP4:極致精細的硬體自動化
縮放粒度:每16 筆資料共用 1 個縮放因子。
核心特色:縮放粒度最細,因此能提供最高的數值精度與擬合能力。縮放過程由晶片底層硬體自動化即時處理,大幅減輕軟體開發者的負擔。
Google Native FP4:軟體主導的暴力運算
縮放粒度:極粗(通常為整個矩陣區塊或大範圍共用一個縮放因子)。
核心特色:硬體結構極簡化。將動態縮放與資料對齊的責任交給軟體編譯器(如 XLA)在事前進行排程計算。這種設計雖然增加了編譯期的軟體負擔,但換取了硬體極致的運算速度與最低的電路延遲。
4. 結論
Google TPU v8展現了 AI 運算晶片從「通用設計」走向「工作負載精準解耦」的戰略轉變,其背後的核心靈魂正是「軟硬體協同設計(Hardware-Software Co-design)」的極致實踐。面對模型訓練與即時推論對硬體資源截然不同的訴求,Google 採取「極簡化硬體、編譯器主導」的策略,將複雜的動態縮放與數據對齊責任交由軟體層處理,透過 Native FP4 與 XLA 編譯器的深度軟硬體協同,在 TPU 8t 上壓榨出高達12.6 PFLOPs的極致循序吞吐量;同時在 TPU 8i 上,藉由物理擴張記憶體子系統、鎖定 3 倍 SRAM 的 KV Cache,並採用最大跳數收斂至 7 跳的Boardfly拓撲,強行攻克推論時的尾部延遲挑戰。
在網路與叢集層面,這種軟硬體協同思維同樣貫穿始終。Virgo專網與雙層非阻塞交換拓撲的導入,成功將次毫秒級的線速突發流量與 Jupiter 骨幹網路的常規流量從物理層面進行隔離,徹底解決了分散式訓練中關鍵的落後者效應。結合先進封裝中的整合型矽電容(ISC)與 12-hi HBM3E 密集堆疊技術,TPU v8 不僅在晶片層面,更在系統級、機架級乃至資料中心級的平面化專屬矩陣上,為下一代大規模叢集部署樹立了以軟硬體協同為核心、高度客製化的底層範式。
後記
第八代 TPU 家族的第三條路徑架構——TPUv8e(代號:Humufish)。相較於追求極致訓練算力的 TPU8t與主攻低延遲 AI 代理服務的 TPU8i,v8e的字尾代表著「能效與基礎核心(Efficiency / Essential)」,不以追求極端跑分為目標,而是定位為資料中心大規模經濟部署的「運算底座」,專攻常態性推理、中小型模型與 RAG(檢索增強生成)等高放量任務。
在核心商業戰略上,TPU v8e 承載了 Google 分散產能風險與實施「供應鏈雙軌化(Dual-Sourcing)」的重要戰略轉變。為了擺脫對台積電 CoWoS 產能吃緊的單一依賴,Google 將這款產品的部分大單(預計達 300 萬顆、約佔其未來兩年總需求的一半)交由Intel Foundry,藉此在未來的產能與價格談判中取得更多籌碼。
在技術與先進封裝佈局層面,TPUv8e展現了跨越物理限制的務實選擇。該晶片主要由客製化晶片業者邁威爾(Marvell)協同設計,除了預計在 2027 至 2028 年大批量產時導入具備 RibbonFET 與背面供電(PowerVia)技術的Intel 18A先進製程外,更全面擁抱了 Intel 的EMIB先進封裝。由於台積電CoWoS-L採用的有機重佈線中介層(Organic RDL Interposer)在超越光罩極限的大面積下,極易面臨熱膨脹係數(CTE)錯配與翹曲(Warpage)風險,v8e選擇以EMIB局部嵌入矽橋的方式,希望達成高良率、低應力的多晶粒整合。
[Reference]
The latest from Google’s TPU roadmap: Architecting TPU 8t and TPU 8i for frontier AI
How Google’s 8th Generation TPUs Power the Agentic Era
Inside the eighth-generation TPU: An architecture deep dive
Introducing Virgo Network, Google’s scale-out AI data center fabric
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


