隨著雲端服務供應商大量建置高效能 AI 運算晶片的叢集,算力增長已超越目前記憶體的頻寬能力 。HBM4 的出現並非單純的規格演進,而是底層架構的顯著世代交替 。HBM4 轉變為需要記憶體廠、邏輯晶圓代工廠與 AI 晶片設計商三方深度整合的高階客製化解決方案 。本篇文章將深入解析 Samsung 於…
隨著雲端服務供應商大量建置高效能 AI 運算晶片的叢集,算力增長已超越目前記憶體的頻寬能力 。HBM4 的出現並非單純的規格演進,而是底層架構的顯著世代交替 。HBM4 轉變為需要記憶體廠、邏輯晶圓代工廠與 AI 晶片設計商三方深度整合的高階客製化解決方案 。本篇文章將深入解析 Samsung 於…
- Source: Ted Yu
- Published: 2026-04-29T07:32:12+08:00
- URL: https://ytyuted.substack.com/p/ep42-ai-hbm4 EP42. 因應次世代 AI 算力需求:解析三星 HBM4的關鍵技術 - Ted Yu
Pledge your support

EP42. 因應次世代 AI 算力需求:解析三星 HBM4的關鍵技術

Apr 29, 2026
隨著雲端服務供應商大量建置高效能 AI 運算晶片的叢集,算力增長已超越目前記憶體的頻寬能力 。HBM4 的出現並非單純的規格演進,而是底層架構的顯著世代交替 。HBM4 轉變為需要記憶體廠、邏輯晶圓代工廠與 AI 晶片設計商三方深度整合的高階客製化解決方案 。本篇文章將深入解析 Samsung 於 ISSCC 2026 發表的最新技術 ,探討其如何透過將 Base-Die 轉移至 4nm 先進邏輯製程 ,並導入創新的動態校準機制,成功在 12 層堆疊下達成 13Gbps I/O 速率與單顆 3.3TB/s 的海量頻寬 ,以應對次世代 AI 晶片的算力需求 。
1. Backgroud
1.1. HBM Trends
根據Samsung的資料,自 2018 年至 2026 年,HBM 技術在堆疊密度(Density)與頻寬(Bandwidth)兩個核心指標上呈現顯著的躍升。在過去八年間,HBM 實現了4.5倍的容量增長與10.8 倍的頻寬提升。

source: Samsung, ISSCC26 15.6
在 HBM3E 之前,容量與頻寬呈現相對穩定的同步增長;但預估在 2026 年的 HBM4 世代,單一封裝的堆疊層數與容量 (12H, 36GB) 雖維持平盤,但頻寬卻出現大幅度的躍升 (突破 3000 GB/s),顯示底層 I/O 技術架構的重大改變。
source: Samsung, ISSCC26 15.6
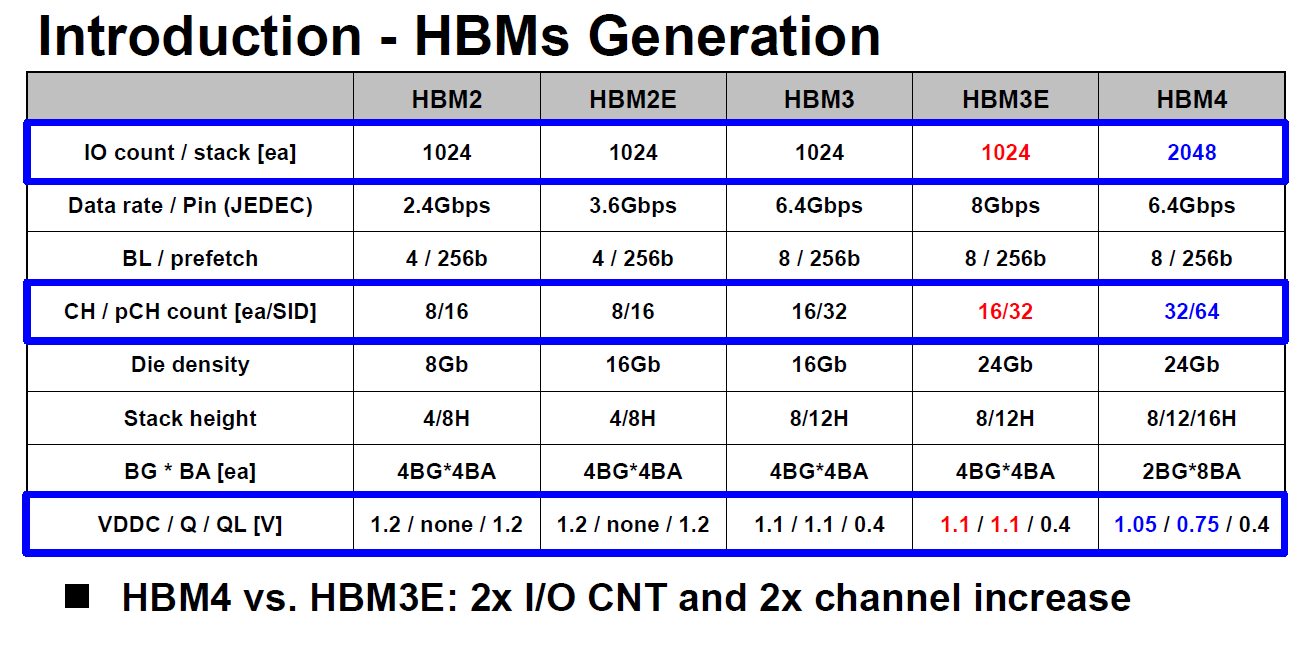
基於JEDEC 基礎規範,比較從 HBM2 到 HBM4 的底層硬體規格演進。相較於 HBM2 至 HBM3E 屬於循序漸進的效能推進,HBM4 在架構設計上展現了顯著的世代交替:
I/O 介面寬度首度翻倍
從 HBM2 到 HBM3E,每個記憶體堆疊的 I/O 引腳數 (IO count / stack) 皆維持在1024。HBM4 則打破此物理限制,將 I/O 數量倍增至 2048。這是 HBM4 整體頻寬得以躍升的最核心基礎。
單引腳速率與總頻寬的設計權衡
HBM4 的單引腳傳輸速率 (Data rate / Pin),JEDEC 官方標準定義為6.4Gbps,較前一代 HBM3E 的8Gbps有所調降。選擇以「擴增實體通道數量」來確保基礎頻寬與良率。
在 AI 運算強烈需求下,大廠們並未受限於JEDEC基礎標準。三星(高達 13 Gbps)、SK 海力士(突破 10 Gbps)等供應商,藉由導入台積電或自家晶圓代工廠的「先進邏輯製程」作為底層裸晶,並搭配專屬的時序校準電路,硬是打破了物理限制,讓總頻寬翻倍。
Rubin GPU 官方設計總頻寬目標為 22 TB/s,搭載 8 顆 HBM4,單顆頻寬為2.75TB/s,對應單引腳速度約10.7 Gbps
這意味著 HBM 已經從過去插上就能用的「通用標準記憶體」,正式轉變為必須由記憶體廠、先進邏輯晶圓代工廠與 AI 晶片設計商(如 NVIDIA、Google 等)三方深度合作的「高度客製化解決方案」。
通道架構平行化擴展
為配合 I/O 數量的倍增,HBM4 的實體通道 (CH) 與偽通道 (pCH) 數量同步從 HBM3E 的 16/32 翻倍至32/64。這項改變大幅提升了記憶體控制器的資料平行處理與排程能力。
封裝堆疊高度的推進
在裸片密度 (Die density) 方面,HBM4 維持與 HBM3E 相同的 24Gb。但在堆疊高度 (Stack height) 上,HBM4 在既有的 8H 與 12H 架構之外,新增了16H (16 層堆疊)的規格選項,藉由垂直空間的擴展來持續推升單一記憶體模組的總容量。
工作電壓持續下降以控制功耗
在 I/O 數量翻倍的情況下,熱管理與功耗控制成為關鍵。HBM 核心電壓 (VDDC) 從 HBM2/2E 的1.2V,降至 HBM3/3E 的1.1V,並在 HBM4 進一步下修至1.05V。這反映了透過先進製程與架構優化,來抵銷高頻寬帶來的額外能耗
1.2. HBM4 架構
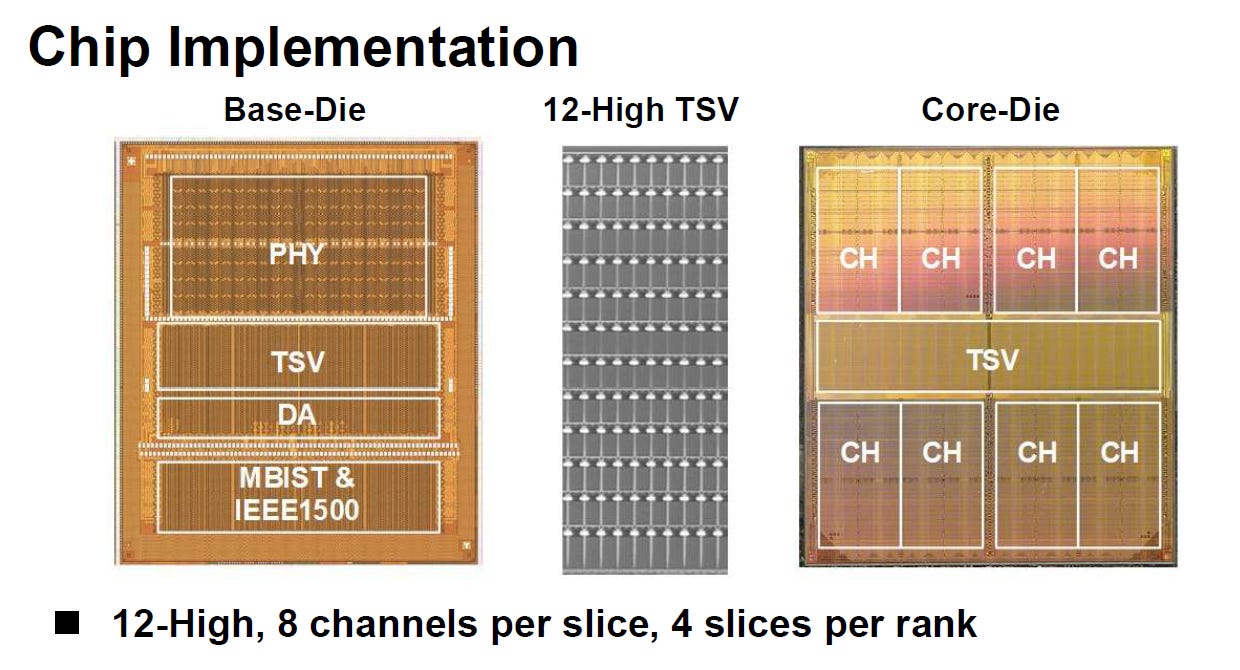
HBM4 採用異質整合技術,將底層的Base-Die(邏輯控制晶片)與上層的Core-Die(記憶體晶片)透過TSV(矽穿孔)進行垂直堆疊。

source: Samsung, ISSCC26 15.6
Base-Die (邏輯底層晶片)
Base-Die 位於整個 HBM 模組的最底層,負責與主機(如 GPU 或 ASIC)進行資料傳輸與邏輯控制。根據圖表中的 Layout 與電路佈局,Base-Die 包含以下關鍵區塊:
PHY (實體層):佔據 Base-Die 最大的面積。圖中明確標示出 CH0 至 CH31,共計 32 個實體通道。每個通道寬度為 64-bit,32 個通道恰好構成 2048-bit 的總 I/O 寬度。
TSV (矽穿孔連接區):位於晶片中央區域,負責將 Base-Die 的訊號垂直傳遞至上方的Core-Die堆疊。中央佈局有助於縮短所有通道到 TSV 的平均佈線距離,降低訊號延遲與功耗。
DA (Direct Access):直接存取測試埠,主要用於除錯或在特定測試模式下繞過部分邏輯電路,直接對記憶體陣列進行讀寫。
MBIST & IEEE1500:MBIST(記憶體內建自我測試)與IEEE 1500標準測試介面被整合在 Base-Die 中,負責在 13Gbps 等高速運作下,執行全可程式化的時序校準與錯誤檢測。
Core-Die (記憶體核心晶片) 與 12-High TSV
上層的 Core-Die 是實際儲存資料的 DRAM 陣列
對稱式通道佈局:從 Core-Die 的晶片實體圖可以看出,記憶體陣列被劃分為多個對稱的通道區塊(標示為 CH),而 TSV 陣列同樣貫穿晶片中央。
12-High TSV 垂直互連:圖中展示了 12 層堆疊(12-High)的 TSV 橫截面示意圖。數以萬計的微小銅柱穿透 12 層 Core-Die,形成極高密度的垂直高速資料公路,確保 Base-Die 能以極低的物理延遲同時驅動上方所有的記憶體層。
邏輯拓撲與分片架構 (Channel & Slice Architecture)
HBM4 在邏輯分組上採用了高度平行化的設計,以最大化資料吞吐效率。圖下方標示了其核心組織架構:「12-High, 8 channels per slice, 4 slices per rank」以及「16 banks per pseudo channel」
Slice (Core-Die) 組態:整個 HBM4 模組共有 32 個通道(CH0-CH31)。系統將其劃分為 4 個 Slice,因此每個 Slice 負責 8 個通道。
立體對應關係:從第一張圖的右側 3D 拆解圖中可見,這 32 個通道並非集中在單一樓層,而是分佈在不同的物理層中(例如 1F 到 4F 構成一個群組,包含 CH16-19, CH0-3, CH24-27, CH28-31 等等)。這種三維交叉分佈有助於分散熱量,避免單一 Core-Die 因特定通道的密集讀寫而產生局部過熱(Hotspot)
Bank 數量:每個偽通道(Pseudo Channel)配備 16 個 Bank,高密度的 Bank 數量提升了記憶體控制器的交錯存取(Interleaving)效率,減少頁面命中(Page Hit)的等待時間,進一步推升實際的有效頻寬(Effective Bandwidth)。
Address Hierarchy
HBM4 36GB 的36-bit階層式定址架構,是將主機的邏輯記憶體請求精準映射至 3D 物理封裝的機制,其核心目的在於透過高度平行化存取,來掩蓋 DRAM 先天的物理充放電延遲(Latency Hiding)。


36-bit 階層式定址的物理映射剖析 (由高位元至低位元):
Z 軸樓層選擇 (SID, 4-bit; or Rank):指向特定的實體記憶體層,精準控制各樓層的喚醒與待機,優化整體熱耗散。
X-Y 軸通道路由 (Channel & PCH, 6-bit):將資料分散至獨立運作的實體通道或偽通道,提升傳輸效率。
陣列交錯存取 (BG/BA, 4-bit):在等待單一 Bank 準備資料的延遲期間,同步對其他 Bank 進行讀寫,是掩蓋延遲的核心關鍵
物理資料矩陣 (Row & Col, 17-bit):負責開啟特定資料頁面 (Row) 並鎖定輸出的最小資料單位 (Col)。
位元組邊界 (Byte Offset, 5-bit):決定最終輸出資料的準確位移量。
簡言之,透過複雜的位址映射將資料打散,確保了系統能夠在多個通道與 Bank 之間不斷切換,完美掩蓋了單一電容陣列在Pre-charge階段必須停機等待的物理缺陷,從而維持接近理論極限的超高頻寬利用率。
1.3. Two core technologies
HBM 的效能與容量增長,本質上是底層 DRAM核心製程(Node Process)與先進封裝(Advanced Packaging)同步演進的結果:
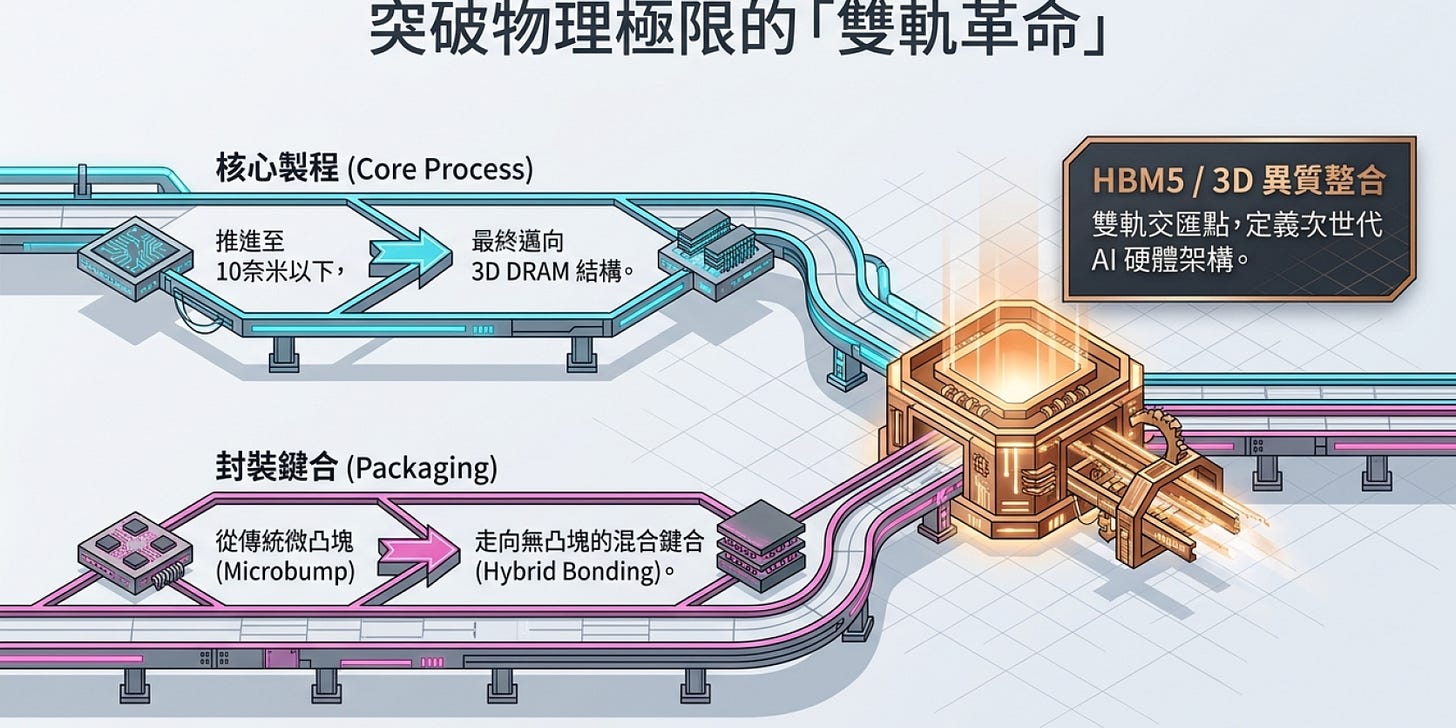
註: JEDEC 將 HBM4 的封裝總厚度上限由原先預期的更嚴格標準,正式放寬至775 微米 (µm)。混合鍵合(Hybrid Bonding, HB)技術延後至 HBM5 才大規模導入。
1.3.1. 核心製程
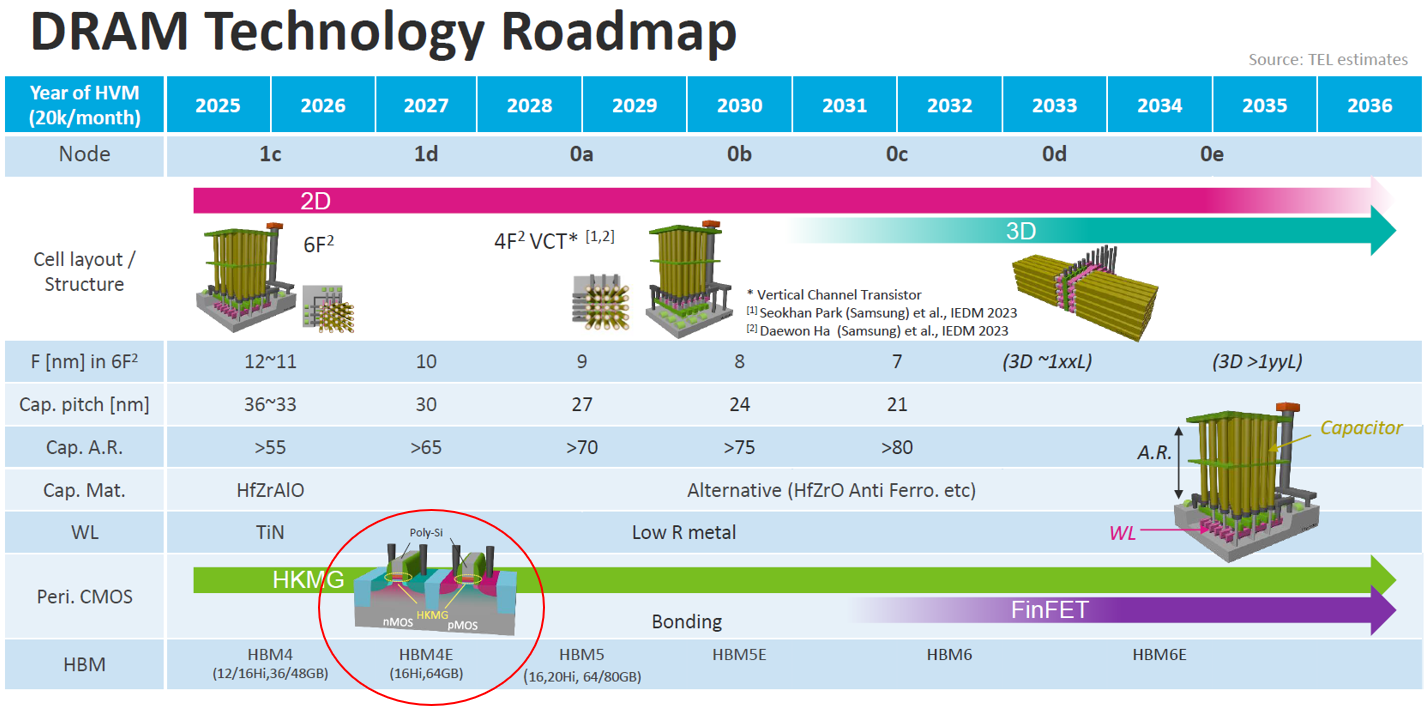
這份藍圖展示了 DRAM 核心製程未來十年的三大演進方向,主要為了解決平面微縮的物理極限:

source: TEL, IEDM25 SC2-5
製程微縮與物理極限:隨著製程節點逐步微縮至 7 奈米以下,為了維持足夠的電容量,電容結構必須變得極度細長(高寬比激增),導致傳統平面製程面臨良率與製造的物理瓶頸。
記憶體架構 3D 化:為了突破上述的空間限制,儲存單元將經歷重大變革。從現有的平面 2D 架構,先過渡到將電晶體直立的「垂直通道電晶體 (4F2 VCT)」以節省面積,最終將走向如同 3D NAND 般垂直堆疊的「真 3D DRAM」
周邊電路與材料升級:配合核心密度的提升,周邊邏輯電路將從 HKMG 轉向效能更佳的 FinFET 架構。同時,將導入反鐵電等新世代電容材料與低阻抗金屬,以支撐高頻運作
1.3.2. 先進封裝
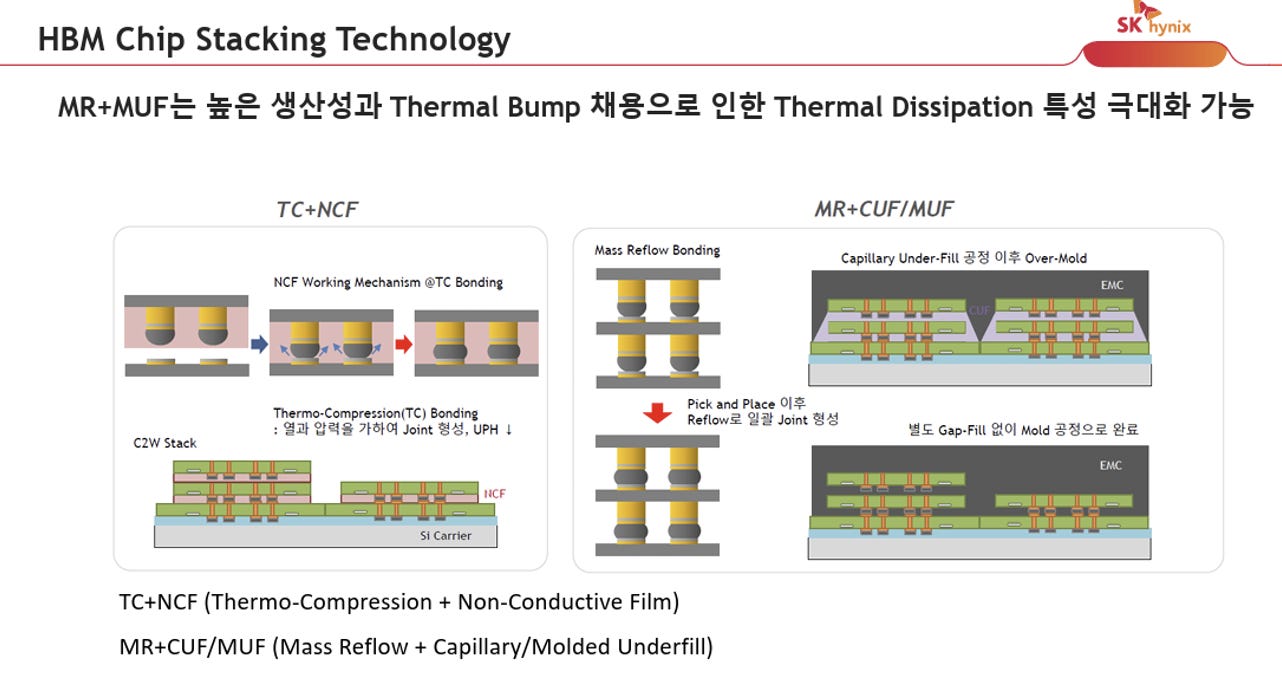
下張圖對比了當前 HBM 市場兩大主流的 3D 晶片堆疊封裝技術陣營:左側為三星(Samsung)主導的TC-NCF(熱壓合+非導電薄膜),右側則是 SK 海力士(SK hynix)取得市場領先地位的關鍵技術MR-MUF(批量回流焊+模塑底部填充)。
source: Sk hynix
MR (Mass Reflow, 批量回流焊)
相較於 TC 必須逐層加壓加熱,MR 製程採用了完全不同的邏輯:
先堆疊後烘烤:機台先將所有的記憶體裸晶(Core Die)塗上助焊劑並精準對位堆疊(Pick and Place)。接著,將整組堆疊好的晶片一次性送入回流焊烤箱(Reflow Oven)。
一體化成型:圖表標示了「일괄 Joint 형성(批量接合形成)」,透過精確的溫度曲線控制,讓所有樓層的微凸塊(Microbump)在同一時間熔融並形成物理與電氣連接。
高生產力:簡報標題特別標示了「높은 생산성(高生產力)」,正是因為 MR 擺脫了逐層熱壓的時間瓶頸,大幅提升了每小時產出量(UPH, Units Per Hour)。
CUF vs. MUF (底部填充技術演進)
在完成金屬凸塊接合後,必須填補晶片間的微小縫隙以保護 TSV 與凸塊。圖表右側展示了兩種填充路徑:
傳統 CUF (Capillary Under-Fill, 毛細管底部填充):利用毛細現象,將液態樹脂緩慢注入晶片層間的縫隙。完成後,再進行外部的 Over-Mold(包覆成型)來封裝整個模組。其物理限制在於毛細現象速度較慢,且堆疊層數越多,越容易在核心區域產生氣泡(Void)。
創新 MUF (Molded Underfill, 模塑底部填充):這是圖表右下方標示「별도 Gap-Fill 없이 Mold 공정으로 완료(無須額外 Gap-Fill,Mold 製程一站完成)」的關鍵技術。它捨棄了毛細注入,直接將含有特殊配方的EMC(Epoxy Molding Compound,環氧樹脂封裝材料)在高壓下同時注入所有晶片層間的縫隙,並一併完成外部包覆。
熱散逸優勢 (Thermal Dissipation)
MR-MUF 搭配「Thermal Bump(散熱凸塊)」能極大化散熱特性。
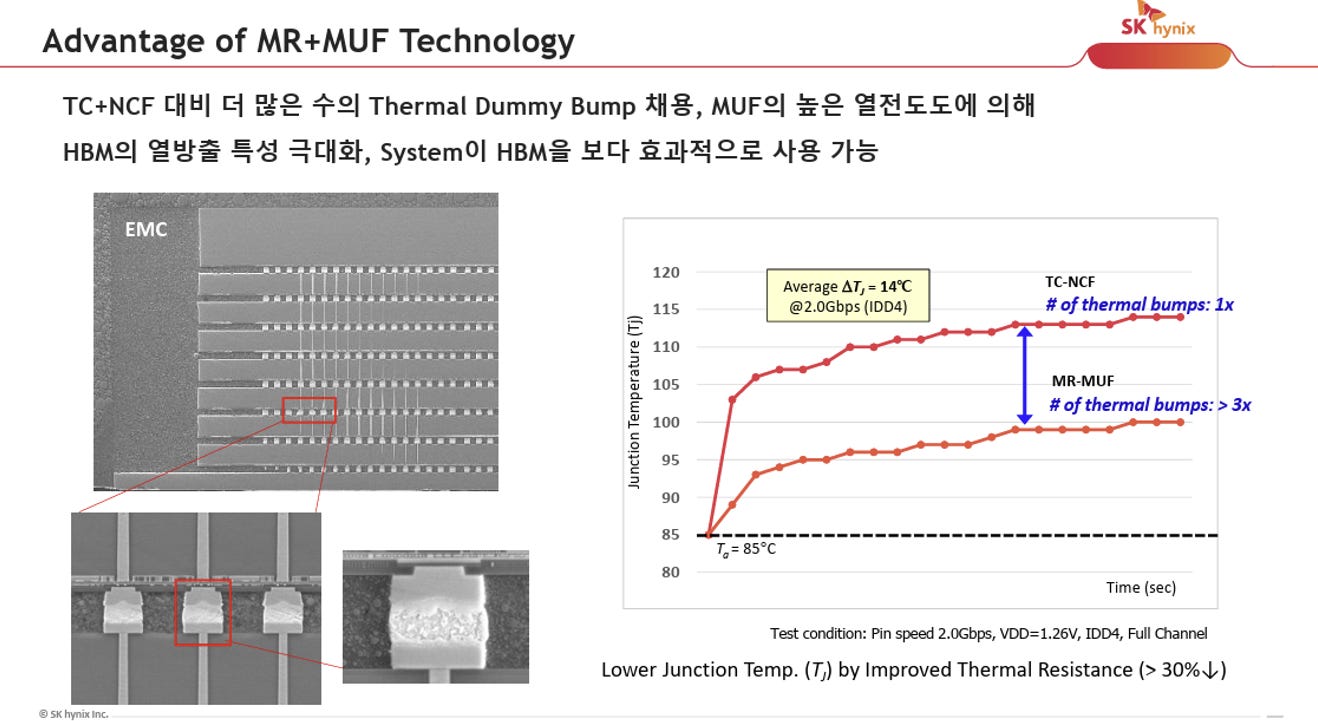
source: Sk hynix
材料導熱性:SK 海力士在 MUF 製程中使用的 EMC 材料,其內部參雜了高密度的導熱微粒,導熱係數遠高於傳統的 NCF 薄膜。這使得 HBM 核心層產生的廢熱能更有效地傳導至模組外部。
散熱凸塊架構:結合額外佈建的 Thermal Bumps(不負責電氣訊號,專門提供熱傳導路徑的假凸塊),MR-MUF 架構建立了立體的垂直散熱通道,解決了高層數堆疊最棘手的熱當機問題。
TC-NCF 擁有極佳的物理平整度控制力,但受限於量產效率與薄膜的散熱瓶頸;而 MR-MUF 則以極高的生產力與優異的熱傳導特性,成為目前 HBM3 與 HBM3E 世代的市場主流。
混合鍵合 (Hybrid Bonding)導入時間?
關於 HBM4e 邁向 16 層堆疊 (16Hi) 的實際量產路徑,產業界在「理想物理極限」與「現實商業考量」之間做出了妥協:

source: Sk hynix
HBM4 務實方案:1c 製程 + 775µm 放寬 + 改良型微凸塊
製程定調:三星官方已明確宣佈,其商業化量產的 HBM4 正是採用第六代 10 奈米級(1c)DRAM 搭配 4 奈米先進邏輯製程。
厚度妥協與微凸塊續命:JEDEC 將 HBM4(16 層堆疊)的高度上限從嚴苛的 720µm 放寬至 775µm。這關鍵的 55µm 讓三星與 SK 海力士得以暫緩導入良率與成本極具挑戰的混合鍵合(Hybrid Bonding),繼續沿用並改良現有的 TC-NCF 與 MR-MUF 微凸塊封裝技術。
終端應用對接:這種務實組合的直接驅動力來自 NVIDIA。為了趕上 NVIDIA 次世代 Vera Rubin 架構(預計採用 16 堆疊 HBM4,且要求高達 10-11 Gbps 的非標準高頻寬)的量產時程,記憶體廠必須選擇最穩定的交貨方案,而非強推最前瞻但不穩定的封裝技術。
HBM4E 與 1d 製程的銜接
在半導體技術藍圖中,HBM4E 預計於 2026 年下半年至 2027 年進入送樣與量產階段,這個時間點正好與 1d 製程的成熟期完美重疊
HBM4E 將挑戰 18 層甚至 20 層堆疊(18Hi/20Hi)。要在此等高密度堆疊下維持模組的物理總厚度並控制功耗,單片 DRAM 核心必須進一步微縮與減薄。1c 製程在 16Hi 已逼近極限,因此 1d 製程提供的微縮餘裕,是達成 HBM4E 規格的必要硬體基礎。
混合鍵合 (Hybrid Bonding) 遞延至 HBM5 的最新拉鋸
混合鍵合這項無凸塊技術全面取代現有封裝的時間點,確實被業界極力遞延至 HBM5。近期半導體產業界甚至出現了進一步的防禦性策略:JEDEC 目前正在正式討論,針對未來採 20 層堆疊的 HBM4E 與 HBM5,將高度標準大幅放寬至825µm 甚至接近 900µm。這意味著記憶體廠即便在 1d 製程的 HBM4E 世代,仍會試圖「壓榨」微凸塊(uBumps)技術的極限,以規避混合鍵合初期可能帶來的良率災難。

source: AMAT
1.4. Logic Base Die:Customized HBM
為何 Base Die 必須轉向先進邏輯製程 ?
過去的常規 HBM 模組中,Base Die 是由記憶體廠使用記憶體製程 (Memory Process)製造(Planar CMOS)。但在 HBM4 世代,Base Die 正式被劃入邏輯代工製程 (Logic Foundry Process)的範疇(例如台積電或三星晶圓代工的 4nm/5nm 製程)。
支撐 2048 I/O 與高頻寬的硬體需求:HBM4 擁有翻倍的 2048 個實體 I/O,大廠正挑戰 10Gbps 至 13Gbps 的極限傳輸率。要處理如此龐大、高速的資料吞吐,並執行複雜的時序校準 (如RDQS/WDQS) 與除錯機制 (MBIST),傳統記憶體製程的電晶體密度與開關速度已無法負荷。必須仰賴先進邏輯製程的 FinFET 或 GAA 電晶體,才能在有限的面積內實現高效能的實體層控制。
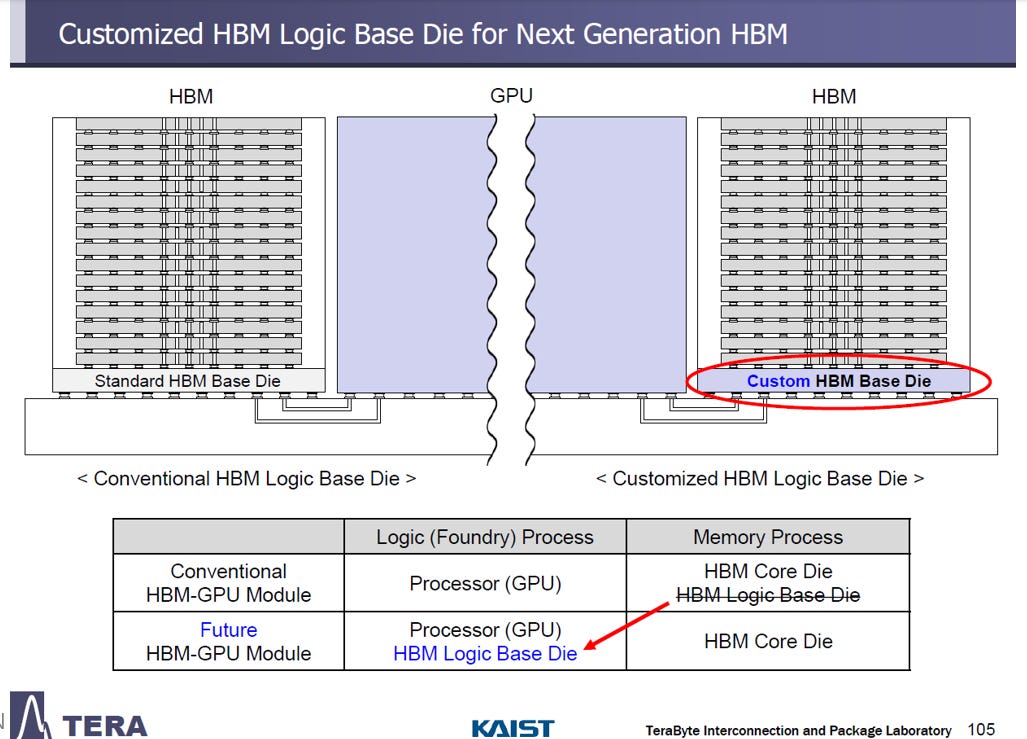
source: Kaist
為何客戶 (AI 晶片廠) 渴望掌控 Base Die 設計?
AI 晶片廠商 (如 NVIDIA, AMD, Google) 積極介入 Base Die 設計,主要基於以下三大技術誘因:
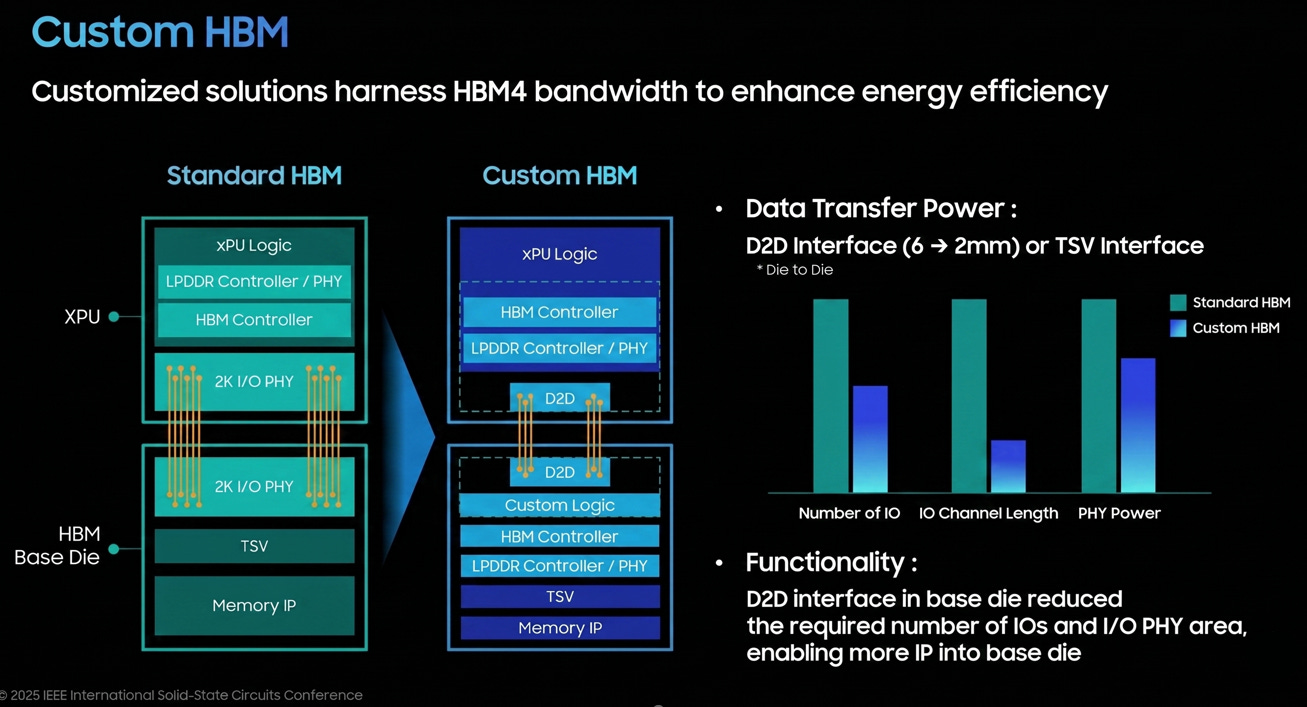
source: ISSCC25
大幅降低功耗與 PHY 面積:捨棄傳統標準且長距離的傳輸通道,改用客製化的超短距 D2D (Die-to-Die) 介面 (通道長度小於 2mm),能極大化提升傳輸能效並縮小實體層佔地。
釋放 GPU 寶貴空間:透過將「記憶體控制器 (HBM Controller)」從 XPU 內部剝離並下放至 Base Die,能為逼近物理尺寸極限的 XPU 騰出空間,進而塞入更多 AI 運算核心。
高度整合客製化 IP:利用先進邏輯製程省下的空間,客戶可以植入專屬的邏輯電路或特定的資料處理架構,進一步優化整體運算系統。
透過這項轉變,Base Die 從單純的被動傳輸墊片,正式進化為分擔 GPU 負載的「延伸邏輯層」

2. Samsung的黑科技
HBM資料傳輸採用「來源同步(Source-Synchronous)」技術。RDQS(Read Data Strobe)與WDQS(Write Data Strobe)正是此技術的核心,被統稱為「資料選通訊號(Data Strobe Signals)」。
傳統的同步電路依賴單一的全局時鐘來協調所有元件,但在極高的傳輸速率下,時鐘訊號到達各個引腳的時間差(Clock Skew)以及資料走線長度的微小差異,都會導致採樣失敗。來源同步技術的解決方案是:發送資料的一方,必須同時發出一個專屬的伴隨時鐘訊號(即DQS),接收方則嚴格依照這個伴隨訊號來鎖定並擷取資料。
RDQS (Read Data Strobe - 讀取): Core Die → Base Die
動作:執行讀取指令時,上層的Core Die(記憶體陣列) 是資料的「發送端」。
物理流向:Core Die 將資料 (DQ) 透過垂直的矽穿孔 (TSV) 往下傳送給 Base Die,同時必須往下發送RDQS訊號。
接收處理:Base Die 作為接收端,會利用其內部的先進邏輯電路,來精準捕捉並對齊這些由上往下傳遞的高速訊號。
WDQS (Write Data Strobe - 寫入):Base Die → Core Die
動作:執行寫入指令時,底層的邏輯控制晶片 (Base Die) 轉變為資料的發送端。
物理流向:Base Die 透過 TSV 將資料 (DQ) 往上派發給指定樓層的 Core Die,並同步往上發送WDQS訊號。
接收處理:各樓層 Core Die 內部的接收電路,嚴格依賴這個由下往上傳遞的WDQS觸發邊緣,將資料寫入物理電容陣列中。
2048個 I/O 數量翻倍與13Gbps 極端高速傳輸下,物理走線變異與時間窗(Data Window)大幅縮小,導致傳統記憶體製程無法負荷,必須仰賴邏輯電路的動態補償。
2.1. Per-Channel TSV RDQS Auto Calibration
Per-Core Die TSV RDQS Adjustment
三星在應對 HBM4 高速傳輸時,針對每個Core-Die(含8 個 Channels), 提出的兩大核心解法:一個是實體架構的改變(2x TSV),另一個是底層電氣特性的動態調校(ABB):

source: Samsung, ISSCC26 15.6
物理架構升級:2x DQ TSV 配置 (資料時間窗翻倍)
在 HBM3E 世代,受限於 TSV(矽穿孔)的數量,單一條資料 TSV 必須承載多個連續的資料突發(Burst Length, BL= 8, 分為圖中的 BL0 與 BL4)。
HBM3E 的困境:由於兩筆資料必須擠在一條通道傳輸,每一筆資料在時間軸上能停留的時間極短(如下圖所示,僅有 1tck = 500ps)。這導致資料眼(Data Window)極度狹窄,接收端極易發生採樣錯誤。
HBM4 的解法 (2x TSV):三星直接將負責傳輸資料的 TSV 數量翻倍。透過將原本串列的資料「解多工(Demultiplexing)」打散到兩條平行的實體通道上(DQ_TSV0 專責 BL0;DQ_TSV1 專責 BL4)。
等效降速效應:資料從單線道變成雙線道後,每筆資料在匯流排上維持有效狀態的時間得以延長一倍(從 1tck 擴展為 2tck)。雖然系統總頻寬提升了,但在單一 TSV 通道上的「等效物理傳輸速率」卻相對降低,大幅拓寬了資料眼(TSV data window enhancement by 2x),降低了實體層的佈線與採樣難度。
電氣特性調校:ABB (Adaptive Body Bias,自適應基底偏壓)
即便透過 2x TSV 拓寬了資料時間窗,HBM 仍面臨 3D 堆疊帶來的另一個致命問題:跨晶片變異 (Inter Core-Die Variation)。 HBM 中堆疊的 12層 Core Die,因半導體製程的微小物理差異,天生就有「跑得快 (fast die)」與「跑得慢 (slow die)」的區別。
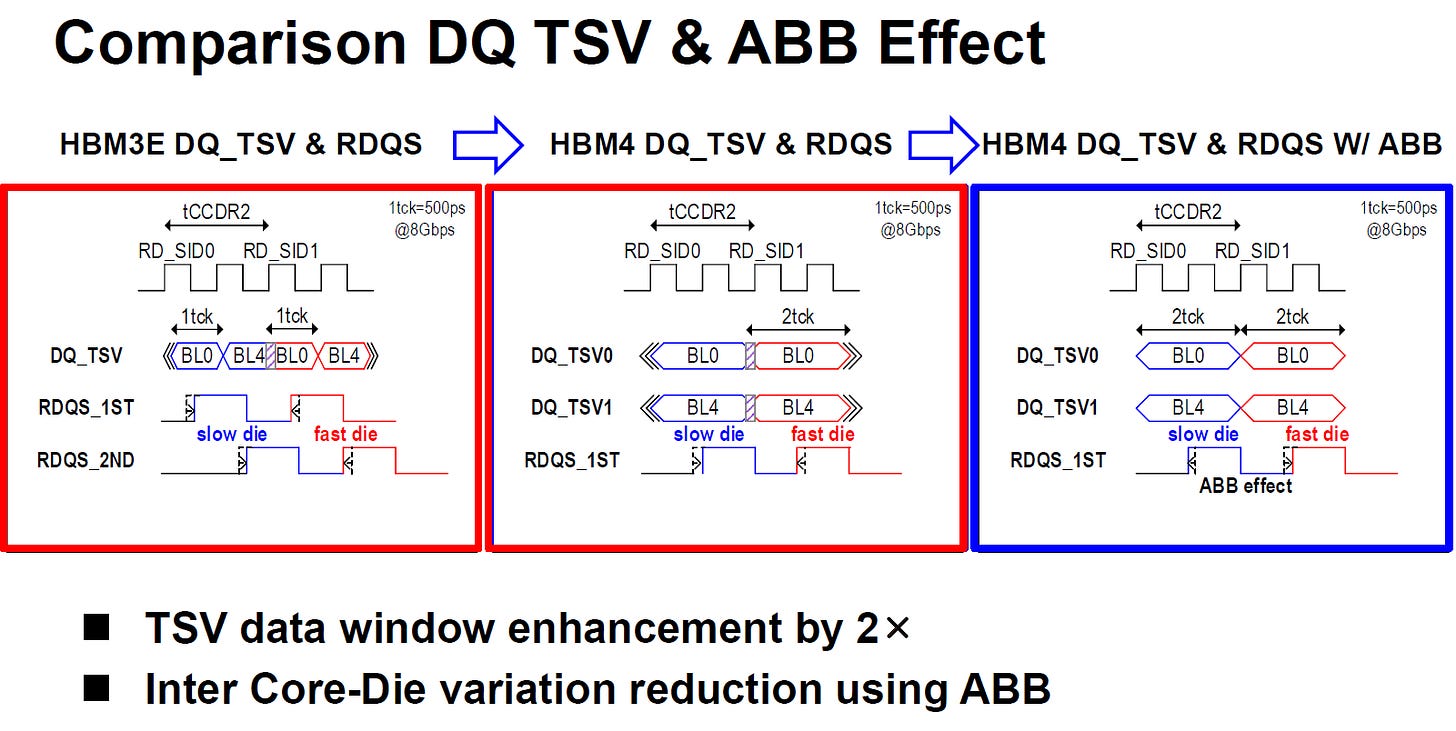
source: Samsung, ISSCC26 15.6
未校準的延遲分佈:參考圖表右側,如果放任不管,fast die 的 RDQS 訊號會太早抵達,slow die 的 RDQS 訊號會太晚抵達,導致兩者的邊緣差距極大(DQ_TSV重疊部分寬)
ABB 的運作原理: Adaptive Body Bias是一種進階的電晶體控制技術。系統會針對每一層 Core Die 獨立施加不同的「基底電壓(Body Bias)」。
針對Slow Die:施加順向偏壓(Forward Body Bias),降低電晶體閾值電壓,強迫其運作加速。
針對Fast Die:施加逆向偏壓(Reverse Body Bias),提高閾值電壓,強迫其運作減速。
校準結果:透過這種「截長補短」的電氣微調,所有樓層的 Core Die 處理延遲被強制收斂到一個極小的區間內(DQ_TSV重疊部分變窄)。在時序圖上,就是成功將 fast die 與 slow die 的 RDQS 觸發邊緣靠攏,確保 Base Die 能夠用單一的基準時間點,精準採樣來自所有樓層的資料。
Per-Channel TSV RDQ Adjustment
但即便使用了 ABB (自適應基底偏壓) 來縮小跨晶片的變異,在極高速的環境中,這還不夠。三星設計了單通道層級 RDQS 自動校準機制 (Per-channel TSV RDQS Auto Calibration)機制:Base Die需要一個絕對精準、能動態適應每一根實體 TSV 特性的校準系統。
核心概念:
這套機制的最終目標是:找到堆疊中最慢的那層晶片 (Slow Die),並強迫其他所有較快的晶片 (Fast Die / Typical Die) 配合它的節奏。
透過在較快晶片的傳輸路徑上人為加入「延遲 (Delay)」,確保來自所有樓層 (SID) 的 RDQS 訊號,抵達 Base Die 的時間點完全一致。這能將 tCCDR (跨層讀取延遲) 壓縮到物理極限。

source: Samsung, ISSCC26 15.6
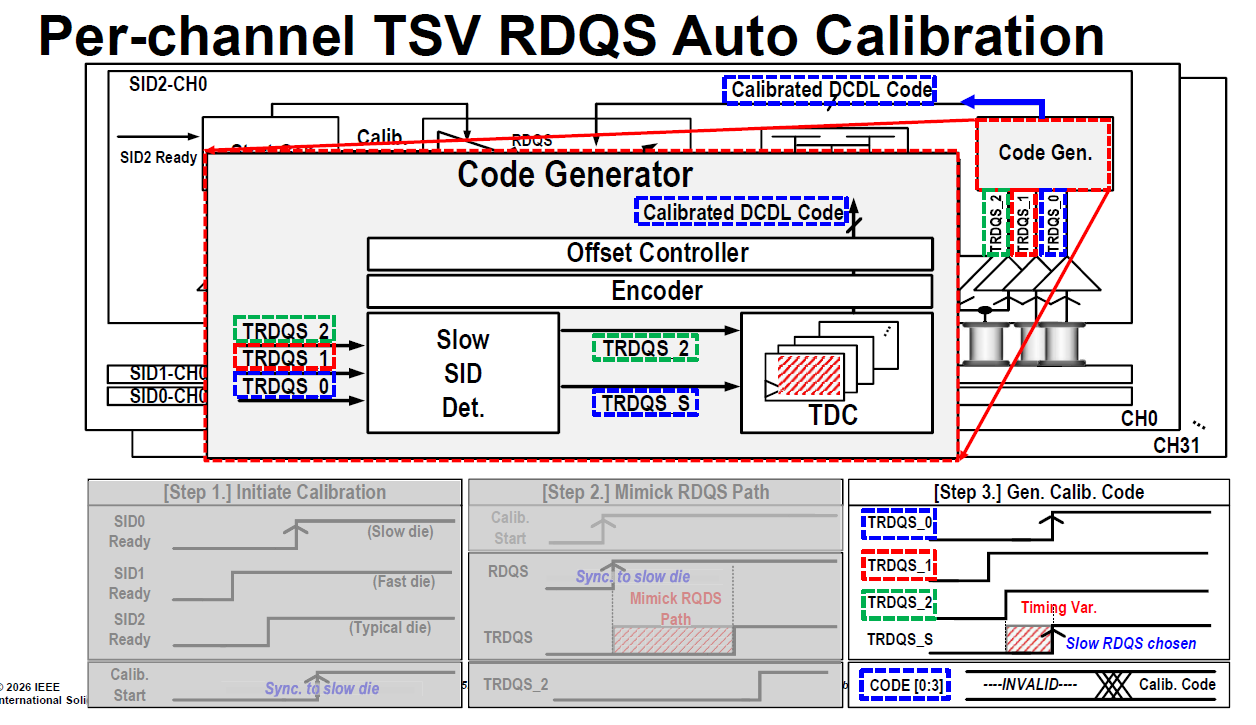
啟動校準與找出「最慢者」 (Initiate Calibration, [Step 1.])
SID Ready 訊號:在校準階段,Base Die 會同時向所有樓層 (SID0, SID1, SID2...) 發出準備訊號。
收集回饋:各樓層的 Core Die 收到訊號後會回傳Ready。因為物理特性的差異,假設SID0 (Slow die) 回傳最慢,SID1 (Fast die) 回傳最快。
同步基準 (Sync to slow die):Base Die內部的Start Gen.(啟動產生器) 會等待,直到收集到「最慢的那個Ready訊號」後,才正式發出全局的Calib. Start(校準開始) 指令。這確立了整個校準過程將以最慢的晶片作為基準。
模擬 RDQS 路徑 (Mimick RDQS Path, [Step 2])
Replica Tree (複製樹狀電路):為了知道訊號在真實傳輸時會花多少時間,電路中設計了一個Replica Tree,它的物理特性完全模仿真實的Normal Tree(標準資料樹狀走線)
測試訊號:將上一步產生的Calib. Start訊號送入這個模擬路徑,產生一個測試用的延遲訊號TRDQS。這個TRDQS完美模擬了如果是一般資料,從該層 Core Die 走到 Base Die 所需的真實物理時間
source: Samsung, ISSCC26 15.6
產生校準代碼與套用延遲 (Gen. Calib. Code)
Code Generator (代碼產生器):這個模組收集來自所有樓層的模擬測試訊號 (例如TRDQS_0,TRDQS_1,TRDQS_2)。
Slow SID Det. (最慢層偵測器):在Code Generator內部,偵測器會比對這些訊號,挑選出最晚抵達的那一個 (如圖中的TRDQS_S,即 Slow RDQS)。
TDC (時間數位轉換器):接著,TDC會測量每一層的測試訊號 (TRDQS_n) 與最慢訊號 (TRDQS_S) 之間的時間差 (Timing Var.)。
產生 DCDL Code:根據量測出的時間差,Encoder(編碼器) 會計算出每一層專屬的數位代碼 (Calibrated DCDL Code)。
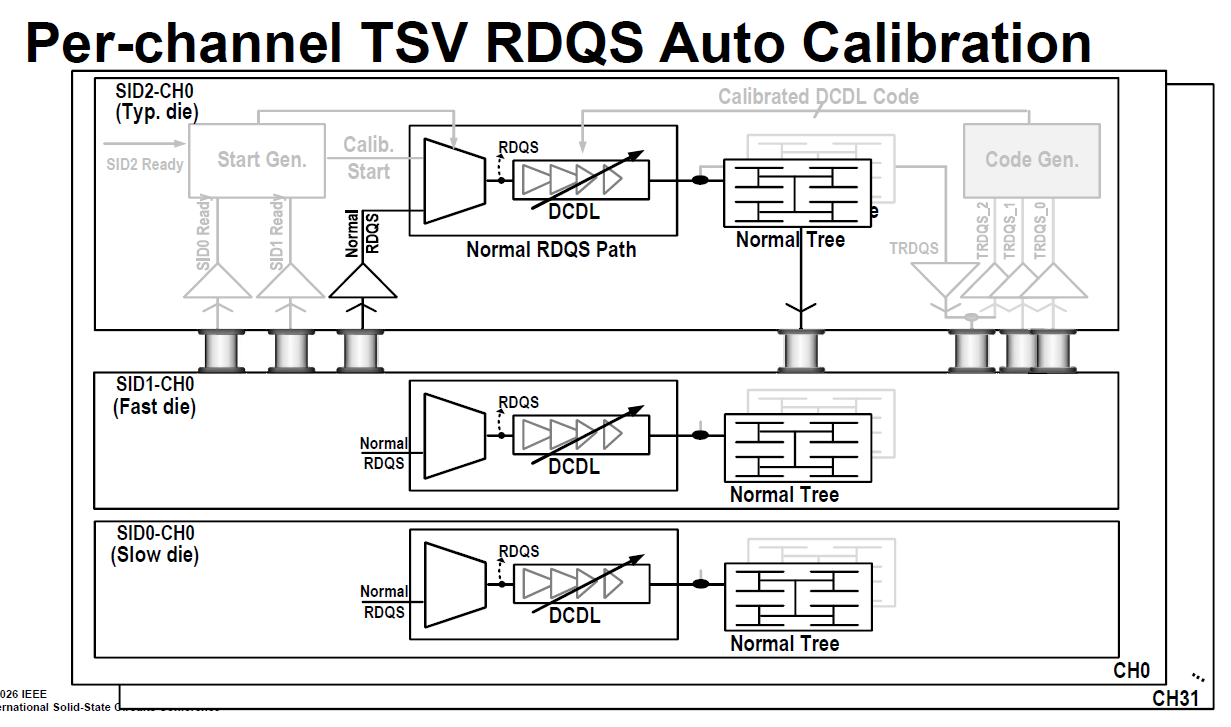
source: Samsung, ISSCC26 15.6
DCDL (數位控制延遲線) 介入:這些代碼最終被回傳到每一層的Normal RDQS Path中的DCDL (Digitally Controlled Delay Line)。DCDL 就像一個可調節的減速帶。
Fast die (SID1):收到較大的代碼,DCDL 會加上較長的延遲,強迫它等一下。
Slow die (SID0):收到代碼為 0,DCDL 不加延遲,全速前進。
透過這三個步驟,三星的自動校準電路能夠動態偵測並補償各層 TSV 的微小時間差。結果就是,無論主機要求讀取哪一層 (SID) 的資料,RDQS 訊號都能在極端一致的時間點抵達 Base Die,徹底排除了跨晶片變異對高速採樣的干擾。
2.2. IO WDQS 4-Phase Skew Calibration
挑戰起因:Quarter-Rate PHY 與 4-Phase WDQS
為了在 HBM4 實現超過 10Gbps 的傳輸率,如果讓內部時脈也跑在 10GHz 以上,晶片將面臨嚴重的功耗與散熱崩潰。
等效降速 (Quarter-rate PHY):業界的解法是採用四分之一速率 (Quarter-rate) 架構。內部時脈頻率降至原本的 1/4,但透過產生四個不同相位(例如 0度、90度、180度、270度)的 WDQS 訊號來交錯觸發資料。這樣在外部看起來,依然維持了全速的資料吞吐量。
致命弱點 (4Φ Skew):這種架構的風險在於,這四個相位的間隔必須絕對精準。只要其中一個相位的實體走線或電氣特性產生微小偏移(即 4-Phase Skew),就會直接吃掉資料眼(Data Eye Margin),導致寫入失敗。
source: Samsung, ISSCC26 15.6
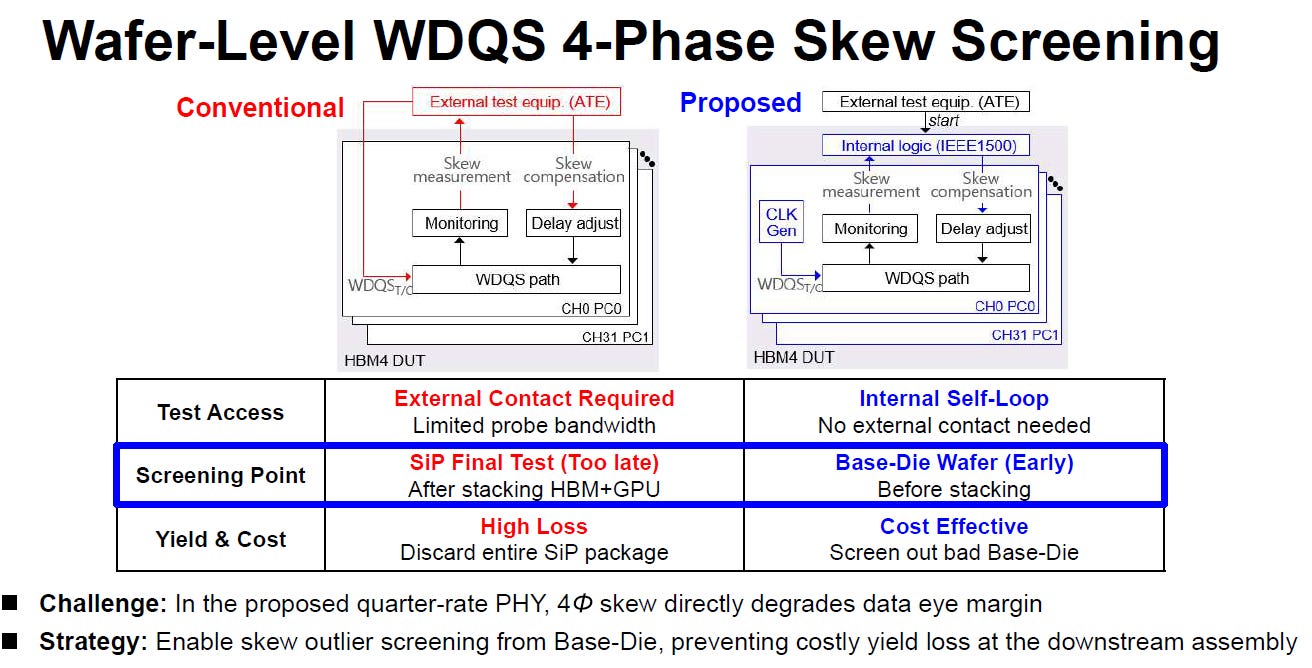
傳統測試的困境
過去的 HBM 依賴外部測試機台 (ATE, Automatic Test Equipment) 來量測與補償這些偏移。
頻寬限制:ATE 的探針無法支援 HBM4 極端高頻的完整測試。
發現太晚:因為在裸晶圓階段無法進行全速高頻測試,這種微小的時序偏移問題,往往要等到 HBM 堆疊完成,甚至與 GPU 封裝在一起進行SiP Final Test (系統級封裝最終測試)時才會暴露出來。
巨大成本損失:如果此時才發現 HBM 的 Base-Die 有問題,整顆已經封裝好的昂貴 GPU 與 HBM 模組都必須報廢,良率損失的成本極為驚人。
三星的解法:先進邏輯賦能的內部自測
HBM4 的 Base-Die 轉用先進邏輯製程,這賦予了 Base-Die 強大的運算與控制能力。
它將原本昂貴、且嚴重滯後的系統級除錯,提前轉換為晶圓級的自我篩選,從源頭阻斷了不良 Base-Die 流入後段封裝流程,是確保 HBM4 得以具備商業量產經濟效益的關鍵策略。
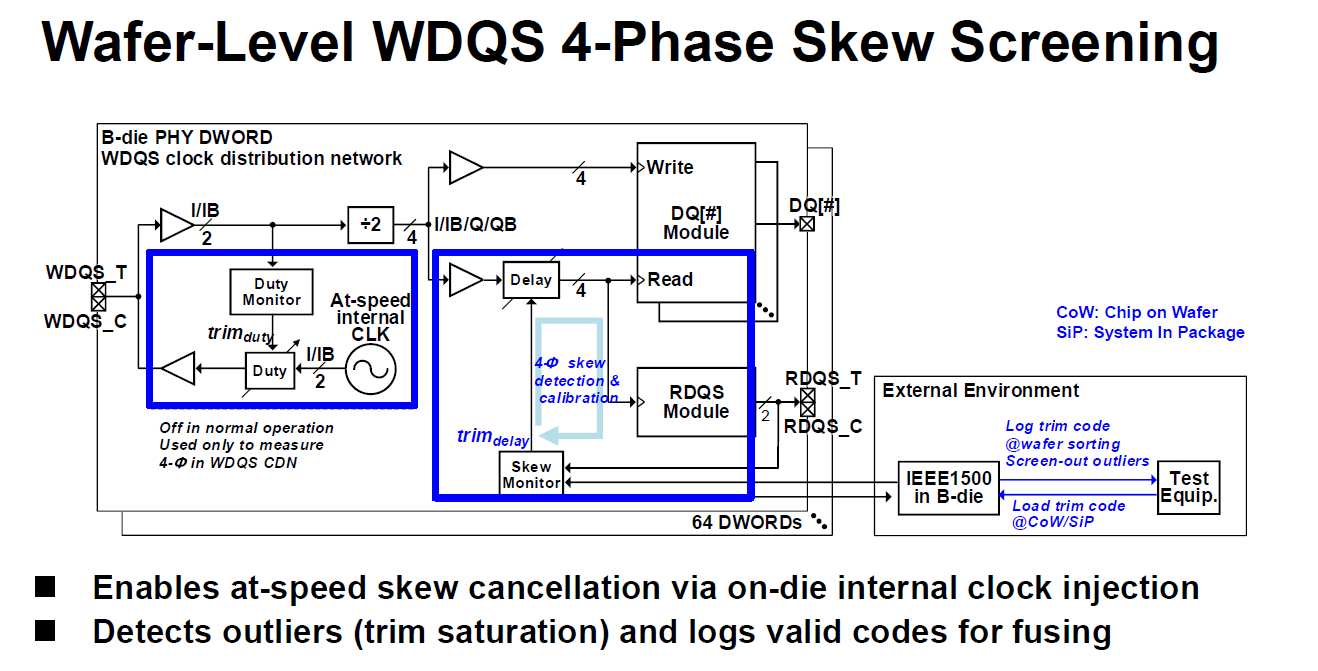
source: Samsung, ISSCC26 15.6
左側藍框:內建全速時脈注入與占空比校正 (At-speed internal CLK & Duty)
內部時脈 (At-speed internal CLK):解決方案是在 Base Die 內部直接做一個能跑全速的震盪器,專門用來產生測試用的 WDQS 時脈。這個模組在晶片正常出貨運作時是關閉的 (Off in normal operation)。
占空比監控 (Duty Monitor):要產生完美的 4 相位,原始時脈的高低電位時間比例 (Duty Cycle) 必須是完美的 50%。這裡透過一個內部迴圈 (Duty Monitor->trim_duty->Duty調整器) 來確保初始時脈的完美對稱。
右側藍框:四相位產生與自動校準迴圈 (4-Φ Skew Detection & Calibration)
時脈經過除頻 (÷2) 後,會產生四個相位的訊號 (I/IB/Q/QB,即 0°、90°、180°、270°)。
封閉測試迴圈:這些訊號會被送入一個包含可調延遲 (Delay) 的路徑,然後進入一個內部的迴圈(這裡利用了Read模組的接收路徑來做內部 Loopback)。
偵測與修正:訊號進入Skew Monitor(偏移監控器) 後,硬體會檢查這四個相位的間距是否精準。如果發現偏差,Skew Monitor會即時吐出trim_delay(微調延遲) 訊號,回去控制前面的Delay模組,把跑太快的相位拉慢,直到四個相位完美等距。
右側外部環境:篩選淘汰與代碼紀錄 (External Environment & Logging)
外部的測試機台 (Test Equip.) 此時只需要透過低速的 IEEE1500 標準介面在旁邊「監工」
淘汰瑕疵品 (Detects outliers):如果內部的Delay模組已經把參數調到極限 (Trim saturation,微調飽和),卻依然無法把四個相位對齊,代表這顆 Base Die 物理缺陷太大,機台就會在裸晶圓階段 (Wafer sorting) 直接把它標記為不良品並淘汰。
紀錄有效代碼 (Log valid codes):如果內部校準成功,外部機台會把這組完美的trim_delay校準代碼紀錄下來。等到未來進行 CoW (晶片封裝至晶圓) 或 SiP 系統級封裝時,再把這組代碼燒錄 (Fusing) 進晶片裡。
2.3. Fully Programmable MBIST
HBM 測試技術在邁向 HBM4 世代時的關鍵演進:從傳統的MBIST (Memory Built-In Self-Test)升級為PMBIST (Programmable Memory Built-In Self-Test)

source: Samsung, ISSCC26 15.6
傳統 MBIST 的侷限 (HBM3E)
MBIST 的概念是在記憶體晶片內部燒錄一套測試電路,讓晶片自己產生測試資料來檢查儲存單元是否有壞軌。
僵化的測試模式 (Pre-defined Pattern):HBM3E 的 MBIST 只能執行晶片出廠時預先寫死的測試演算法。
受限的程式空間 (Max 2272 bit):由於測試指令是硬體佈線 (Hardwired) 或寫死在極小的唯讀記憶體中,它只能容納非常短的指令碼。
無法應對未知錯誤:當 HBM3E 在真實系統中面臨 9.2Gbps 高頻時,可能會出現因特定資料排列或溫度變化才誘發的「動態錯誤」。預先寫死的測試模式往往抓不到這些新型態的弱點。
PMBIST 的革命性升級 (HBM4)
得益於 Base-Die 採用先進邏輯製程,HBM4 能夠內建一個小型的微控制器等級測試引擎。
海量程式空間 (Max 512K bit):程式容量暴增了超過 200 倍。這意味著測試工程師可以載入極度複雜、多步驟的測試演算法
自定義測試模式 (Programmable Pattern):客戶或工程師不再被綁死在原廠預設的測試項目。他們可以根據在實際 AI 運算環境中發現的最新錯誤行為,隨時編寫新的測試指令 (Test Pattern) 並動態載入HBM 內部執行。
靈活的定址迴圈 (Flexible Loop Sequences):傳統 MBIST 只能用固定的路線 (Fixed Loop) 掃描整個陣列。PMBIST 允許工程師設定複雜的迴圈,針對特定的可疑區塊 (例如容易過熱的核心區域) 進行高壓力的反覆隨機存取測試,精準揪出隱藏的瑕疵。
隨著 HBM4 傳輸率飆升至 10Gbps+,訊號完整性與資料錯誤的形態變得難以預測。PMBIST 放棄了過去「寫死」的測試策略,轉向「軟體定義測試(Software-Defined Testing)」。這賦予了 HBM4 極高的除錯彈性,能在晶圓階段、封裝階段,甚至是在伺服器機房運作時,隨時下載並執行最新的測試腳本,大幅提升了次世代記憶體的可靠度。
PMBIST 硬體架構
source: Samsung, ISSCC26 15.6
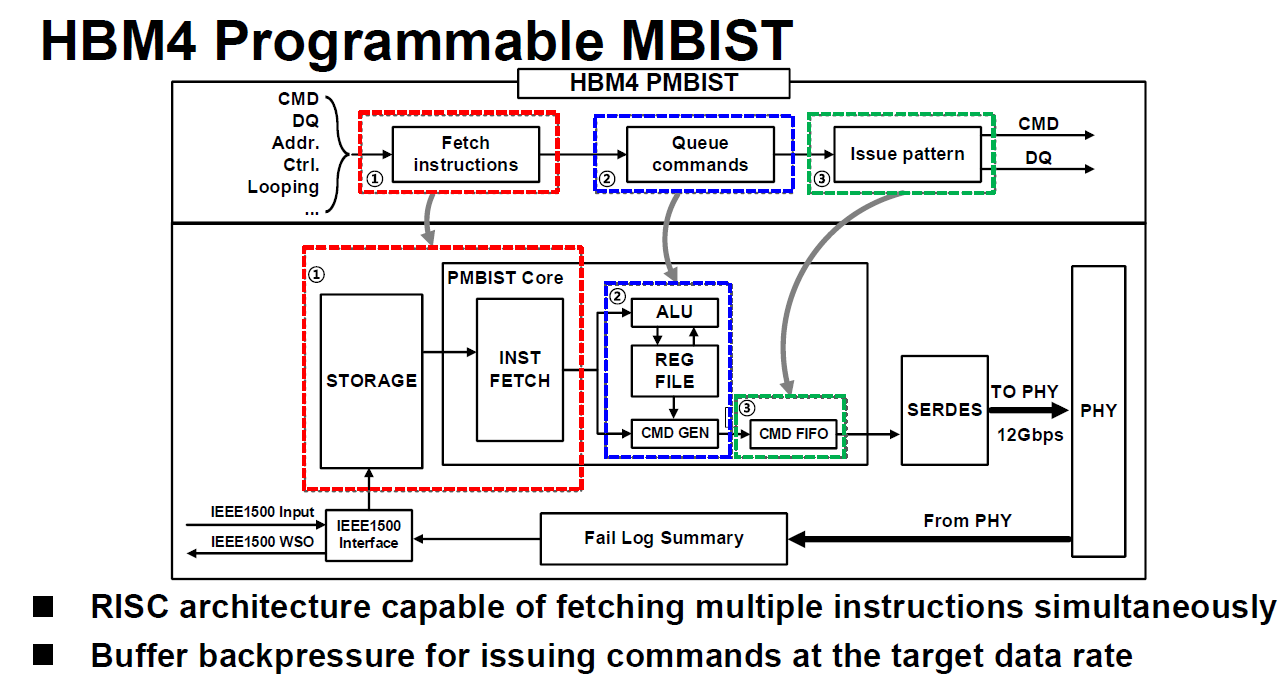
HBM4 的 PMBIST 實質上已經進化成一顆內建於 Base Die 的微型 RISC 處理器。其運作管線 (Pipeline) 包含三個主要階段:
① 儲存與擷取 (Storage & Fetch instructions):外部測試機台透過低速的 IEEE1500 介面,將客製化的測試程式碼載入內部的STORAGE。接著,PMBIST Core內的INST FETCH模組會像 CPU 一樣,同時擷取多個指令。簡報強調其具備RISC 架構,能高效解碼這些測試指令。
② 指令生成與排隊 (Queue commands):擷取到的指令進入包含算術邏輯單元 (ALU)、暫存器檔案 (REG FILE) 與命令產生器 (CMD GEN) 的區塊。這個區塊負責根據程式邏輯,運算出實際要送到記憶體陣列的實體位址與控制命令。
③ 發送與背壓控制 (Issue pattern & Buffer backpressure):生成的命令會進入命令佇列 (CMD FIFO),最後透過序列器 (SERDES) 以高達 12Gbps 的全速打入實體層 (PHY)。
Buffer backpressure (緩衝區背壓)機制:因為前端解碼速度可能與後端 12Gbps 的極端發送速率不匹配,FIFO 佇列能起到緩衝作用,當佇列快滿時會產生背壓訊號暫停前端擷取,確保測試命令能以目標資料速率穩定、無中斷地持續轟炸記憶體陣列。
PMBIST 運作模式與迴圈切換
PMBIST 「可程式化」帶來的最大實戰價值:打破僵化的測試迴圈,實現特定時序的極限測試。

source: Samsung, ISSCC26 15.6
HBM3E MBIST 的限制 (Fixed Loop):上半部圖表顯示,傳統 MBIST 的位址跳動順序是寫死的 (Fixed)。它只能執行ACT-WR-PRE或ACT-RD-PRE的線性流程。在迴圈設計上,它總是優先跑完同一個 Bank 裡面的所有欄位位址 (CA 0, CA 1, CA 2... CA 31)。這種模式只能用來測試同一個實體平面內的連續讀寫延遲 (如圖中標示的tCCDLtest)。
HBM4 PMBIST 的彈性 (Programmable Loop Slots):下半部圖表顯示,PMBIST 導入了Loop Slot與CMD Slot的概念,允許測試工程師自由定義迴圈的層級與順序。
實戰案例:tCCDR 測試解鎖:為了測試跨樓層的讀取延遲 (tCCDR,也就是稍早討論過的重點),工程師利用 PMBIST 將位址迴圈的優先級反轉。從原本的CA order(欄位優先) 改為SID order(堆疊層號優先)。 如圖中下方的命令序列所示,系統變成連續發出ACT SID0,ACT SID1,ACT SID2,接著連續執行RD SID0,RD SID1,RD SID2。這種刻意在不同實體樓層 (SID) 之間高速來回切換的測試模式,在傳統 HBM3E 是完全無法做到的。
HBM4 PMBIST 透過導入 RISC 處理器架構,讓 Base Die 具備了全速產生複雜測試圖形的能力。這賦予了工程師切換位址迴圈 (Switch Address loop) 的自由,使其能夠針對 HBM4 特有的3D TSV 跨層時序 (如 tCCDR)進行精準且高壓的動態驗證。
3. Results
根據 Shmoo 測試圖表,HBM4 的實驗結果可簡述為兩大關鍵突破:

source: Samsung, ISSCC26 15.6
達成極限頻寬:在較高電壓配置下(VDDC 1.25V 與 VDDQ 0.85V),系統成功達到13.0Gbps的最高資料傳輸率,證明底層架構與校準技術足以支撐極端高頻運作。
顯著提升能效:相比上一代 HBM3E 基準(10Gbps @ 1.1V & 1.1V),HBM4 能夠在更低的電壓條件下(1.05V & 0.75V)提供更快的11.8Gbps傳輸率,展現出大幅進步的能效比。

source: Samsung, ISSCC26 15.6HBM4 透過三大關鍵規格升級,完美契合了 NVIDIA Rubin 等次世代 AI 晶片的嚴苛需求:
底層製程升級 (4nm 邏輯):Base-Die 首度導入先進邏輯製程,實現了「記憶體控制器下放」與「客製化短距 D2D 介面」,有效釋放 GPU 寶貴的晶片面積。
頻寬翻倍突破 (3.3 TB/s):實體通道數增至 32 個,搭配13Gbps的極端傳輸率,單顆頻寬暴增至3.3 TB/s,徹底打破大型 AI 模型訓練的記憶體瓶頸。
極致低壓節能 (0.75V I/O):在效能大幅躍升的同時,負責傳輸的 I/O 電壓逆勢降至 0.75V。這項「降壓提速」的特性,有效舒緩了頂規 AI 伺服器面臨的極端散熱壓力。
4. 結論
source: Samsung, ISSCC26 15.6
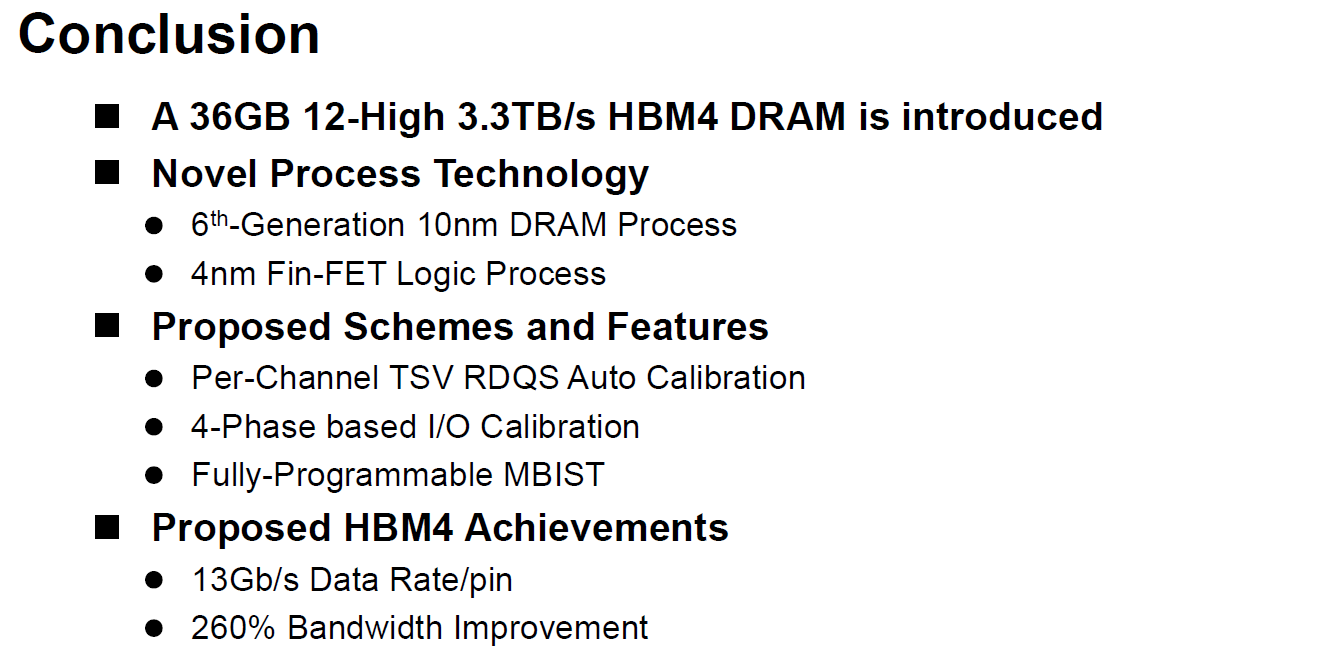
HBM4 透過多項底層架構與電路設計的革命性突破,完美契合了如 NVIDIA Rubin 等次世代 AI 晶片對極致頻寬與能效的渴望 。從 Samsung 揭露的技術細節中可以觀察到,Base-Die 轉向先進邏輯製程是實現這一切的核心基礎。透過 4nm Fin-FET 製程的運算能力 ,HBM4 得以內建單通道 TSV RDQS 自動校準 、晶圓級的 4-Phase 時序偏移篩選 ,以及具備 RISC 架構的全可程式化 MBIST (PMBIST) 。這些硬體與測試層面的黑科技,不僅確保了 2048 個 I/O 在 13Gbps 極端高頻下的訊號完整性 ,更讓總頻寬躍升 260% 達到 3.3TB/s ,同時將 I/O 工作電壓逆勢下修至 0.75V 以控制功耗 。這標誌著 HBM 供應鏈正式步入跨界協作的新範式,為未來的 AI 算力擴展奠定了堅實的硬體基石。
後記
NVIDIA GTC 2026 大會上,官方宣布Rubin Ultra為全球首款具備1 TB記憶體容量的 AI GPU,旨在解決兆級參數模型與 Agentic AI 的記憶體頻頸。
單一 Rubin Ultra 如何達到 1 TB 容量?
四運算晶片 (Quad-Chiplet) 架構:Rubin Ultra 放棄了標準版 Rubin R100 的雙晶片 (2-Die) 設計,改為將四顆運算晶片整合在單一超大型 CoWoS 中介層上。
HBM4E 配置:在此四運算晶片複合體的周圍,總共配置了 16 顆HBM4E記憶體模組。
堆疊密度:為了達到 1024 GB 的總容量,這 16 顆模組中的每一顆都必須具備 64 GB 的容量。這要求記憶體端採用先進1d節點和16 層堆疊技術(MicroBonding),每層封裝 32 Gb (4 GB) 的 DRAM 晶粒 (計算方式:16 顆模組 x 64 GB = 1024 GB = 1TB)。
source: TEL
最新供應鏈設計調整動態
封裝良率與翹曲 (Warpage) 挑戰:將 4 顆運算晶片與高達 16 顆HBM4E記憶體模組整合在單一超大面積的CoWoS-L中介層上,產生了極大的熱應力與封裝翹曲風險,嚴重影響良率。
實體架構的潛在轉向:業界消息指出,為降低量產風險與供應鏈壓力,NVIDIA 正考慮進行實體設計的回調。計畫將原先單一龐大的「四芯封裝 (Quad-die)」拆分為板級 (Board-level) 整合的「2+2 雙芯封裝 (Dual-die)」方案
規格影響:若最終採取此調整,邏輯上單一 Rubin Ultra 運算節點的總 HBM4E 容量仍維持在 1 TB 不變,但在實體層面,將會是由兩顆較小型的封裝體 (各搭載512 GB, 8x64GB HBM4e, 16 Hi) 在基板上組合而成,而非最初展示的單一超大型複合封裝體
[Reference]
Samsung, “A 36GB 3.3TB/s HBM4 DRAM with Per-Channel TSV RDQS Auto Calibration and Fully-Programmable MBIST“, ISSCC26, 15.6_A
SK Hynix, “Advanced Packaging Technology for Beyound Memory“, Ho-Young Son, Ph.D
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


