在共封裝光學 (CPO) 與高密度波長分波多工 (DWDM) 系統中,微環調變器 (MRM) 扮演著光電轉換的核心樞紐 。然而,將極致的微觀光學結構實現在矽晶圓上,必然面臨半導體前段蝕刻製程的物理極限。在 SOI 晶圓上,僅僅 +/- 4…
在共封裝光學 (CPO) 與高密度波長分波多工 (DWDM) 系統中,微環調變器 (MRM) 扮演著光電轉換的核心樞紐 。然而,將極致的微觀光學結構實現在矽晶圓上,必然面臨半導體前段蝕刻製程的物理極限。在 SOI 晶圓上,僅僅 +/- 4…
- Source: Ted Yu
- Published: 2026-04-16T07:29:29+08:00
- URL: https://ytyuted.substack.com/p/ep40-nvidia EP40. 矽光子製程變異的解方:NVIDIA逆向設計微環器技術探討 - Ted Yu
Pledge your support

EP40. 矽光子製程變異的解方:NVIDIA逆向設計微環器技術探討

Apr 16, 2026
在共封裝光學 (CPO) 與高密度波長分波多工 (DWDM) 系統中,微環調變器 (MRM) 扮演著光電轉換的核心樞紐 。然而,將極致的微觀光學結構實現在矽晶圓上,必然面臨半導體前段蝕刻製程的物理極限。在SOI(Silicon-On-Insulator)晶圓上,僅僅+/- 4 奈米的微觀製造誤差,轉換至光通訊的頻譜維度後,便會放大為嚴重的共振波長偏移,進而迫使系統設計必須承擔極高的靜態熱功耗來進行補償 。
本篇將深入解析 NVIDIA 於 OFC 2026 發表的最新論文。剖析工程界如何跳脫傳統尋求「完美蝕刻」的硬體思維,轉而透過 GPU 加速的「逆向設計 (Inverse Design)」演算法 。探討研發團隊如何利用微觀的邊緣擾動進行相位工程,在極限的實體幾何變異與材料應力限制中,取得降低2.5倍變異敏感度的系統級妥協 。
1. Background
1.1. 製程變異導致微環頻移
在共封裝光學(CPO)與高密度波長分波多工(DWDM)系統架構中,矽光微環調變器(MRM)扮演著核心的轉換樞紐,宛如整個光電系統的心臟。其主要職責是將高速電訊號轉換為光訊號,而得益於微環結構的特性,MRM 能夠在極小的晶片面積內實現高頻寬密度的光學 I/O,是推動高密度整合的關鍵元件
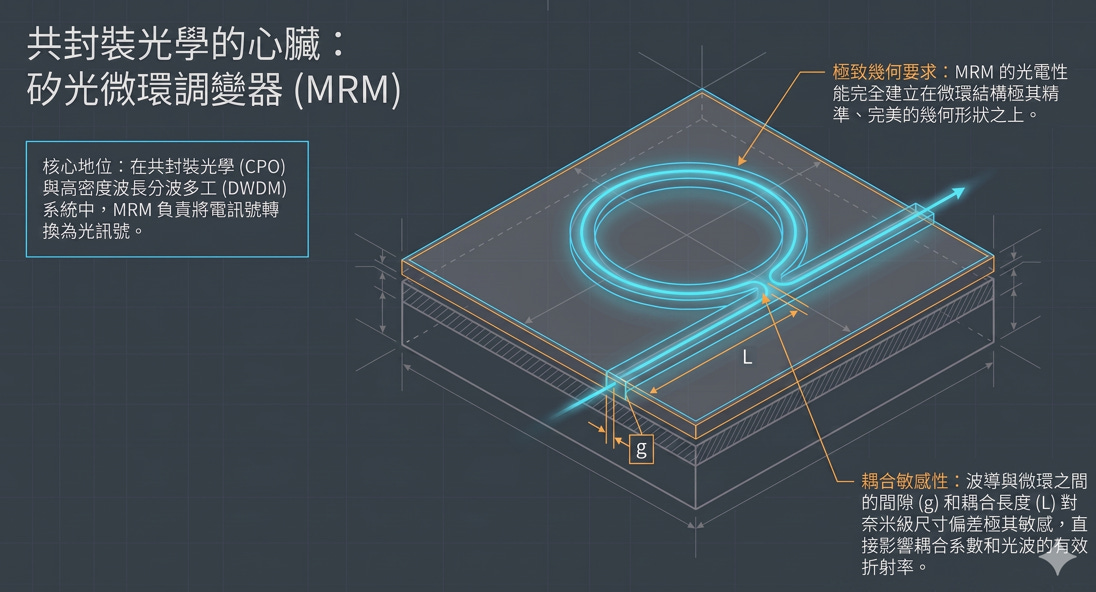
然而,要發揮 MRM 的高效能,其物理設計與製造面臨著極為嚴苛的要求。MRM 的整體光電轉換性能,完全建立在微環結構極其精準的幾何形狀之上。在物理層面上,光波導與微環之間的間隙以及耦合長度,具備高度的耦合敏感性,系統對奈米等級的尺寸偏差極度敏感。任何微小的幾何變異都會直接改變耦合係數與光波的有效折射率,進而影響整體光訊號調變的精確度。因此,在製造過程中,必須將邊緣粗糙度與形狀變異控制在極低水準,才能確保元件在 CPO 架構中發揮預期的效能。
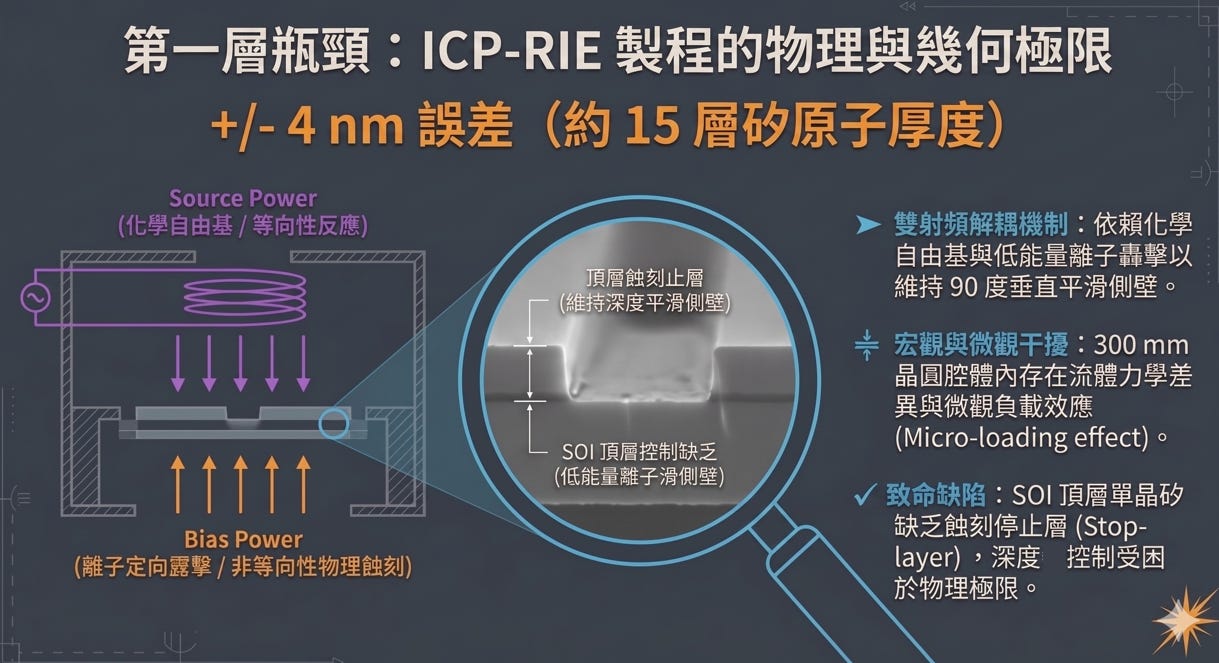
根據 NVIDIA 在OFC26發表的論文內容,矽光子製程在邁向高密度共封裝光學(CPO)時,面臨著來自蝕刻製程的嚴格物理與幾何極限。主要瓶頸在於SOI晶圓的頂層單晶矽缺乏天然的化學蝕刻停止層,導致波導的蝕刻深度控制完全受困於物理條件,極易產生正負 4 奈米(僅約 15 層矽原子厚度)的微小誤差。這微小的波導尺寸改變,會導致光波的有效折射率發生變化,進而在光學層面上被放大,使 MRM 的共振波長產生高達 5.1 奈米的嚴重偏移。
然而,在試圖修正這個偏移時,工程師遇到了矽材料的先天限制。矽具備「正熱光係數」,這表示當系統使用微型加熱器為 MRM 加溫時,其共振波長只能往長波長的方向移動,也就是只能產生「紅移」,無法透過降溫來反向調整(藍移)。
面對製程變異產生的波長隨機分佈,以及加熱器只能「單向紅移」的限制,系統設計被迫採用一種名為「預設藍移(Intentional Blue-Biasing)」的防禦性策略。為了確保所有生產出來的 MRM(無論其初始誤差為何)最終都能被加熱調整至統一的目標波長,設計時會將 MRM 的初始標稱波長,刻意設定在所有可能誤差範圍的最藍端(最短波長處)。

這個妥協策略的代價就是龐大的能耗。採用「預設藍移」後,這意味著系統在運作時,微型加熱器必須始終保持開啟,持續消耗極高的靜態功耗,將每一顆 MRM 的波長「推」向並鎖定在目標值。這種為了彌補製程變異而產生的持續性熱能消耗,最終成為高階 CPO 模組在熱管理上最大的瓶頸。
1.2. 尺寸觀點: 半導體 vs. 光通訊
矽光子與共封裝光學技術在跨領域整合時,最核心的認知衝突:同一個物理數值「0.8奈米」,在半導體製造與光通訊傳輸中,代表著截然不同的工程量級與系統衝擊。
半導體工程視角:實體空間的微觀極限
在半導體製程的實體物理維度中,0.8 奈米是一個極度微小的值,大約僅相當於不到兩顆原子的寬度。在評估製程變異時,若硬體結構(如線寬或蝕刻深度)出現1%的微小誤差,通常會落在設計的寬容度範圍內。對晶片製造而言,這已經是極致完美的工藝表現,系統完全能夠容忍並正常運作。
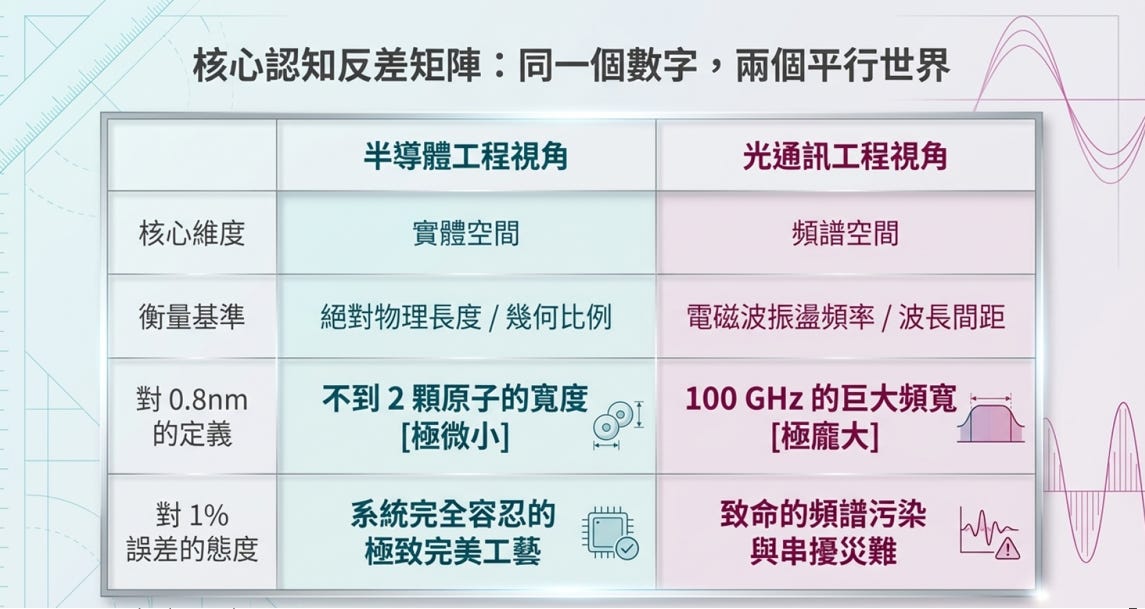
光通訊工程視角:頻譜空間的巨大頻寬
然而,將視角切換到光通訊的頻譜維度,意義便完全反轉。依據ITU針對1550奈米波段定義的DWDM(高密度波長分波多工)標準,0.8 奈米的波長間距(Channel Spacing)在頻域上等同於高達100 GHz的頻寬,可用於400Gbps Dual-Pol 16QAM Coherent 信號.
光通訊的衡量基準是電磁波的振盪頻率與波長間距,而非單純的物理長度。
|Δf| ≈ ( c / λ² ) × |Δλ| (c : 光速, λ : 中心波長)
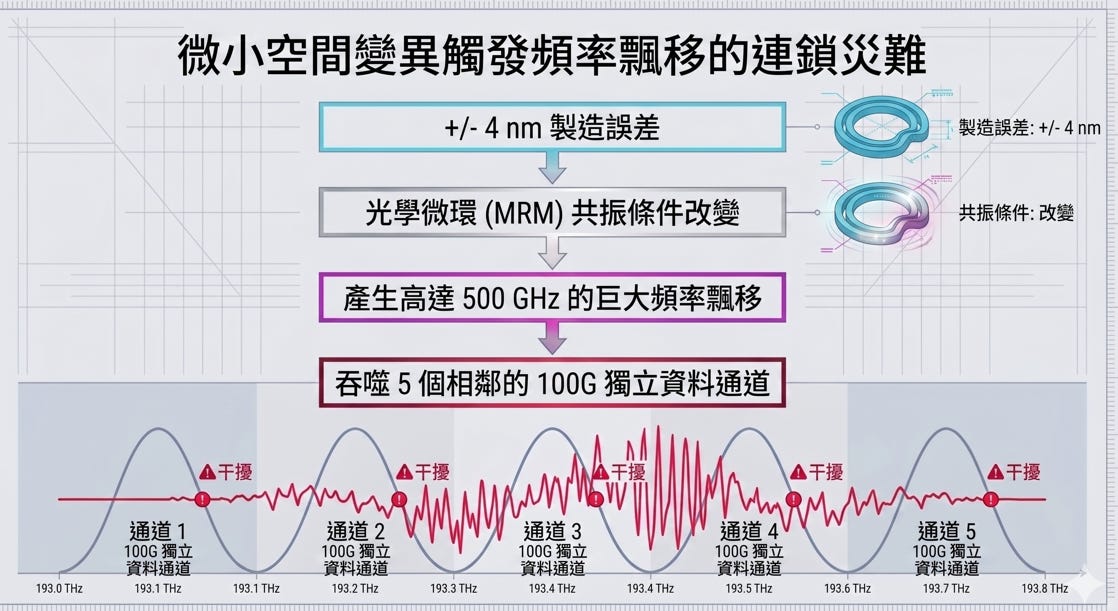
在共封裝光學(CPO)與波長分波多工(WDM)系統的整合中,微觀的硬體製造誤差會引發系統層級的連鎖效應。根據 Nvidia論文,當矽光微環調變器(MRM)在製程中產生正負4 奈米的製程誤差時,會直接改變微環的共振條件,導致其輸出光波長發生約5.1 奈米的偏移。
若將這5.1 奈米的波長偏移轉換至光通訊的頻譜維度來看,其影響會被顯著放大。在光學頻譜上,這樣的波長變化會產生高達500 GHz以上 (在1310nm, 5.1 nm 偏移約 891 GHz) 的頻率飄移。假設DWDM頻道間距為100G,超過500 GHz的頻率飄移,將會影響多個相鄰的資料通道。
1.3. 蝕刻製程
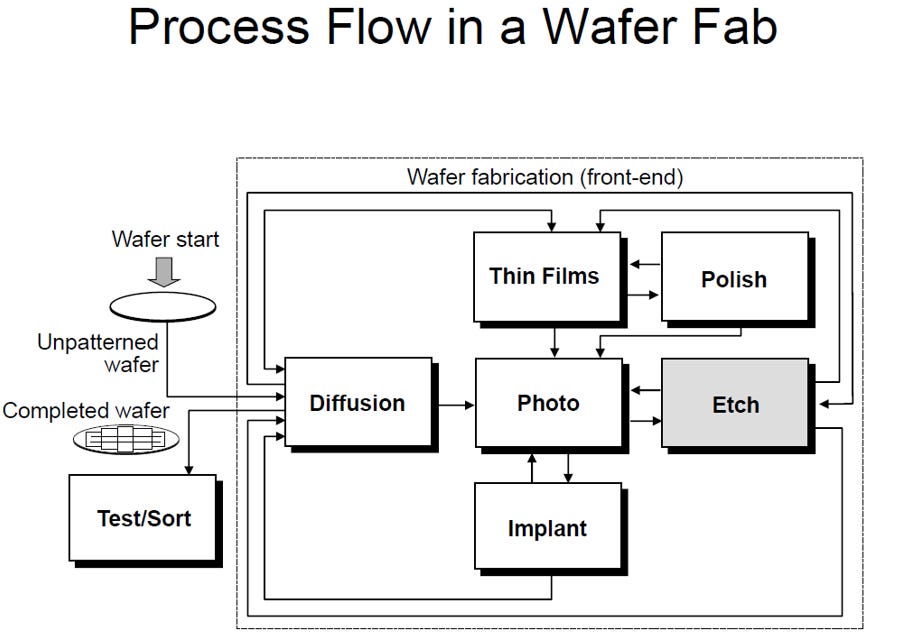
在半導體前段製程(Front-end wafer fabrication)中,蝕刻與微影(Photo)、薄膜(Thin Films)、擴散(Diffusion)、離子植入(Implant)及研磨(Polish)並列為六大核心循環步驟:
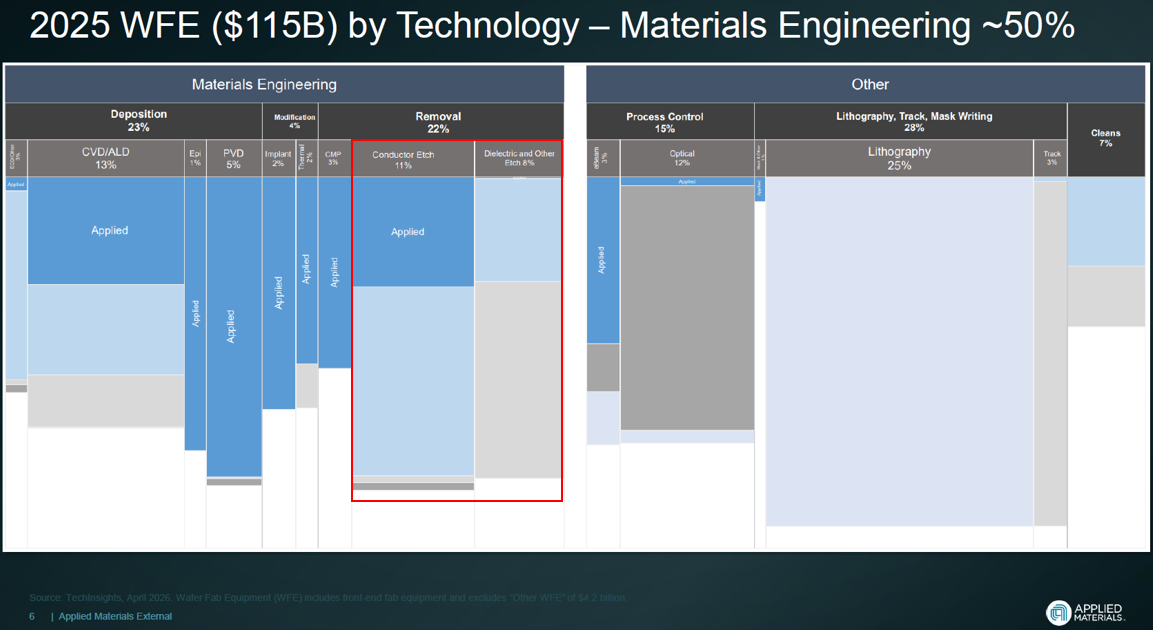
依據 Applied Materials(AMAT)針對 2025 年晶圓廠設備(WFE,總額1150億美元)的資料顯示,資本支出高度集中於特定領域:
source: AMAT
材料工程(Materials Engineering)過半:包含沉積(加法)、改質與移除(減法)等材料工程設備佔總體 WFE 約50%。
蝕刻設備佔比達 22%:負責將圖案實體化的「移除(Removal)」製程(即蝕刻),佔總支出的 22%,比例僅次於微影製程的 28%和沉積製程的 23%。
導體蝕刻佔 11%:在蝕刻分類中,導體蝕刻(Conductor Etch)單獨佔了總體設備支出的 11%。
先前所探討的 MRM 幾何誤差與波長偏移問題,其物理發生的節點正是落在上述佔比 11% 的導體蝕刻(Conductor Etch)領域,具體為處理單晶矽波導的ICP-RIE(感應耦合電漿反應離子蝕刻)製程。
傳統反應離子蝕刻(RIE, Reactive Ion Etching)的基礎原理
RIE 是一種結合「物理性非等向性蝕刻」與「化學性等向性蝕刻」的混合製程。其完整步驟包含:
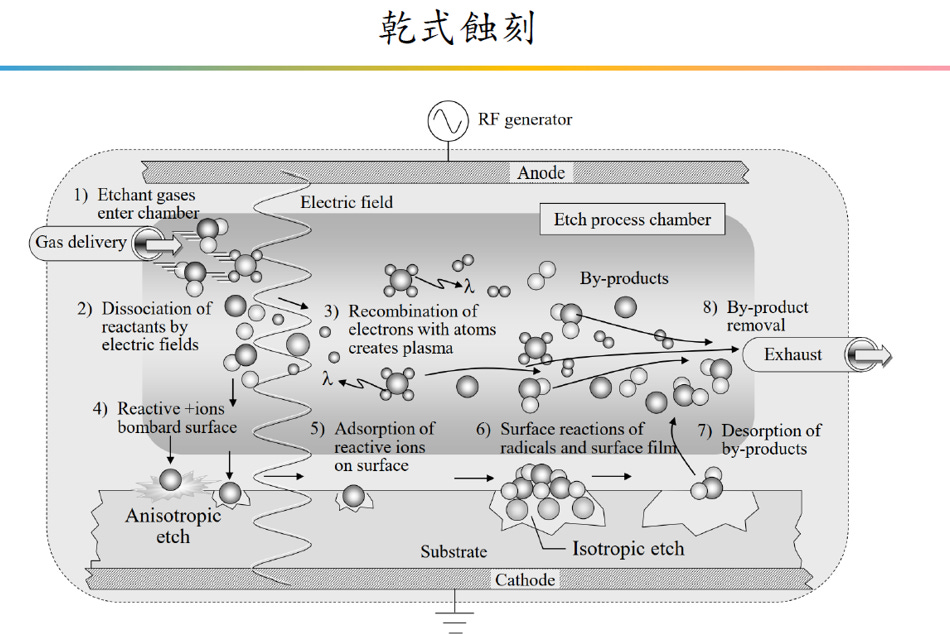
氣體導入與解離:
蝕刻氣體(Etchant gases)進入腔體後,透過射頻(RF generator)產生的電場解離成帶電離子與化學自由基。
電漿生成:
電子與原子重組形成發光的電漿(Plasma)區域。
雙重蝕刻機制並行:
物理轟擊(Anisotropic etch):帶正電的反應性離子受電場加速,垂直轟擊晶圓表面,提供具備方向性的非等向性蝕刻。
化學反應(Isotropic etch):呈電中性的化學自由基吸附(Adsorption)於晶圓表面,發生化學反應。此反應缺乏方向性,屬於等向性蝕刻。
副產物排除:
反應生成的揮發性副產物從表面脫附(Desorption),並由排氣系統(Exhaust)抽出腔體。
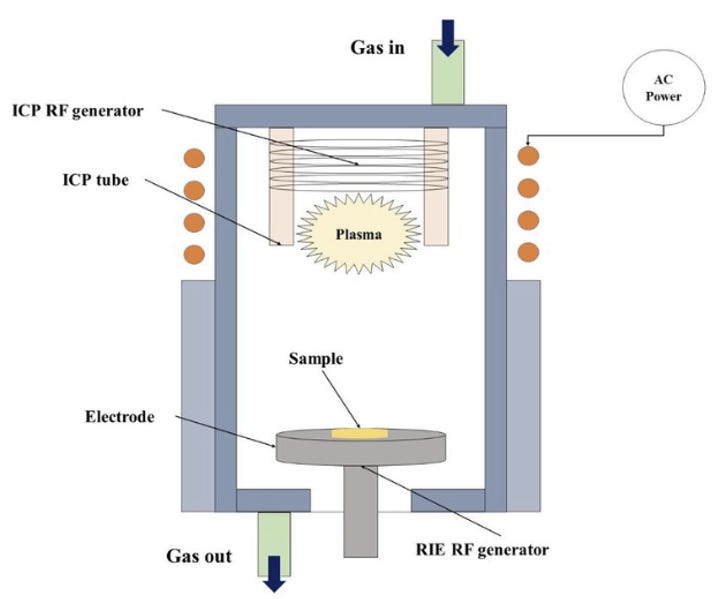
進化版架構:ICP-RIE (Inductively Coupled Plasma Reactive Ion Etching; 感應耦合電漿 + 反應離子蝕刻)
source: ReserchGate
上層 ICP RF Generator (Source Power / 電漿源功率):
透過腔體外部的感應線圈(ICP tube/coils)輸入交變電流,利用電磁感應原理在腔體內部激發出極高密度的電漿。
專職控制「化學自由基與離子的濃度」。功率越高,化學蝕刻速率越快,但不會增加離子撞擊晶圓的動能。
底層 RIE RF Generator (Bias Power / 偏壓功率):
連接至承載晶圓的底座電極(Electrode)
專職建立垂直方向的電場,負責牽引並加速由上方ICP產生的離子。功率越高,離子垂直轟擊的物理動能越強
針對矽光子與 MRM 製程的工程意義
在製造矽光微環調變器(MRM)時,波導的側壁平滑度與幾何尺寸精準度要求極高(容許誤差在+/- 4 nm內)。ICP-RIE設備讓半導體工程師能夠進行以下精細調控:
開啟極高的ICP功率以獲得足夠的蝕刻速率與高選擇比。
同時維持極低的RIE偏壓功率,確保離子具備足夠的垂直方向性以維持 90 度側壁,但動能又低到不足以對波導表面造成嚴重的物理損傷或引發微觀負載效應(Micro-loading effect)。
在現行的高階矽光子代工廠中,定義波導主要依賴 193nm 浸潤式微影(DUV)配合 ICP-RIE 蝕刻。
若要進一步將誤差縮小至1 nm內,必須全面改用極紫外光(EUV)與原子層蝕刻(ALE),這在現階段的生產成本與產能上並不具備商業可行性。

source: Lam Research
技術層面的完美(ALE 的優勢):原子層蝕刻(ALE)具備「自我限制」的物理化學機制,能將化學改質與物理轟擊徹底分離。它能像剝洋蔥般,逐層、精準地移除單層矽原子,從而達到幾乎沒有損傷的完美平整度與次奈米級尺寸控制。
商業層面的致命傷(成本與產能):ALE 這種逐層反覆操作的製程極度耗時,導致機台產出率(UPH)極低;且若要達到極致精準,通常需搭配造價極高的極紫外光(EUV)微影設備。這與矽光子技術旨在提供低成本、高頻寬傳輸的初衷背道而馳。
最終的產業妥協:權衡之下,光通訊產業選擇了一種系統級的妥協。與其投入天價成本製造毫無誤差的「完美晶片」,產業界寧可接受現有 ICP-RIE 設備所產生的 +/- 4 nm 幾何誤差,並在後端設計中,透過為 MRM 加裝微型加熱器、承擔較高的靜態功耗來補償波長偏移。這是目前最具商業量產可行性的解決方案
2. Inverse-Designed Etch-Stable MRM
為了克服傳統微環調變器(MRM)對蝕刻深度極度敏感的痛點,NVIDIA研究團隊提出了一種基於「逆向設計(Inverse Design)」的穩定型微環結構 。該設計方法與核心重點摘要如下:
幾何參數化:從標準圓環到波浪型穩定環

source: OFC26 Tu2J.3, Nvidia
目標函數(FOM)與蝕刻變異的數學定義
逆向設計的核心在於設定正確的最佳化目標。團隊針對270 nm厚的 SOI 晶圓進行200 nm的脊狀(Rib)蝕刻模擬,並將 +/- 4 nm(即 196 nm 至 204 nm)的蝕刻深度製程變異納入設計標的 。定義的品質因數(Figure-of-Merit, FOM)公式為:
𝐹𝑂𝑀 = 𝜁 ∙ 𝐿 + (𝜑 − 𝜑0)2
這個方程式同時最小化了兩項關鍵指標:
光學損耗 (L):確保基本模態的傳輸效率,同時抑制因波導寬度變化而產生過多的高階模態轉換損耗 。
𝜁是逆向設計目標函數中的權重超參數,負責引導演算法在「降低光學傳輸損耗」與「提升抗製程變異能力」這兩個互相牽制的指標之間,找出最佳的幾何平衡點
相位偏移 (𝜑 − 𝜑0)2:確保微環在 196 nm 到 204 nm 的蝕刻深度波動下,其半環傳輸的相位與目標相位(𝜑0)的偏差降到最低 。採用平方誤差而非絕對值,是為了維持演算法在反向傳播時的數學可微性 。
最佳化工具與 GPU 算力加速
幾何形狀的最佳化是透過開源的電磁逆向設計工具包EMopt來執行 。為了解決龐大的運算量,NVIDIA 團隊將該工具的運算核心移植到了 GPU 平台上,成功實現了約 10 倍的模擬加速 。該設計總共運用了 20 個幾何參數,並搭配SciPy函式庫中的信任域(Trust-region)最佳化演算法,確保在尋找最佳解時的收斂穩定度 。
模擬理論成效:抗變異能力提升 5 倍
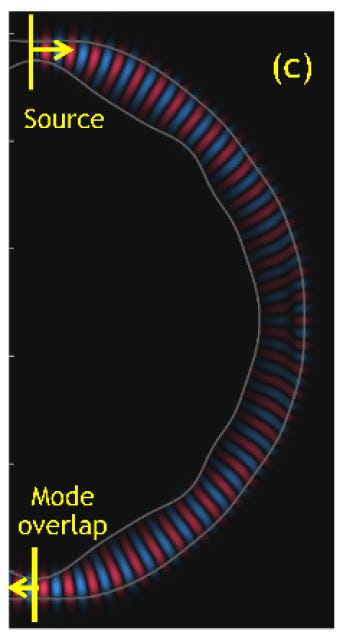
經過 GPU 密集計算後得出的「穩定環」,其幾何特徵會在遠離耦合區的腰部區域逐漸變寬。這種設計會短暫激發出高階的TE1模態(乘載約 25% 的光功率),並在光繞行至另一端耦合區前,完美收斂回基本模態TE0。
source: OFC26 Tu2J.3, Nvidia
個人觀點
根本解法(Root Solution):擴大波導寬度。藉由增加幾何尺寸的基數,稀釋 +/- 4 nm 蝕刻變異對光波有效折射率的相對影響力
物理代價(Physical Trade-off):打破單模限制。波導加寬在物理上必然會激發出高階模態(TE1、TE2...),造成功耗的損失。
邊界控制(Boundary Control):透過演算法限制幾何方程式(最高 10 階餘弦),確保波導拓寬的幅度與形狀僅會激發出相對單純且可控的 TE1,避免系統陷入多重高階模態的混亂。
終極收斂(Ultimate Alignment):逆向設計的核心價值。利用波浪邊緣的微觀擾動進行精準的相位工程(Phase Engineering),強制 TE0 與 TE1 在收斂節點達到相位同步(In-phase),將破壞性干涉的風險轉化為無損耗的建設性干涉。
全環模擬的結果:
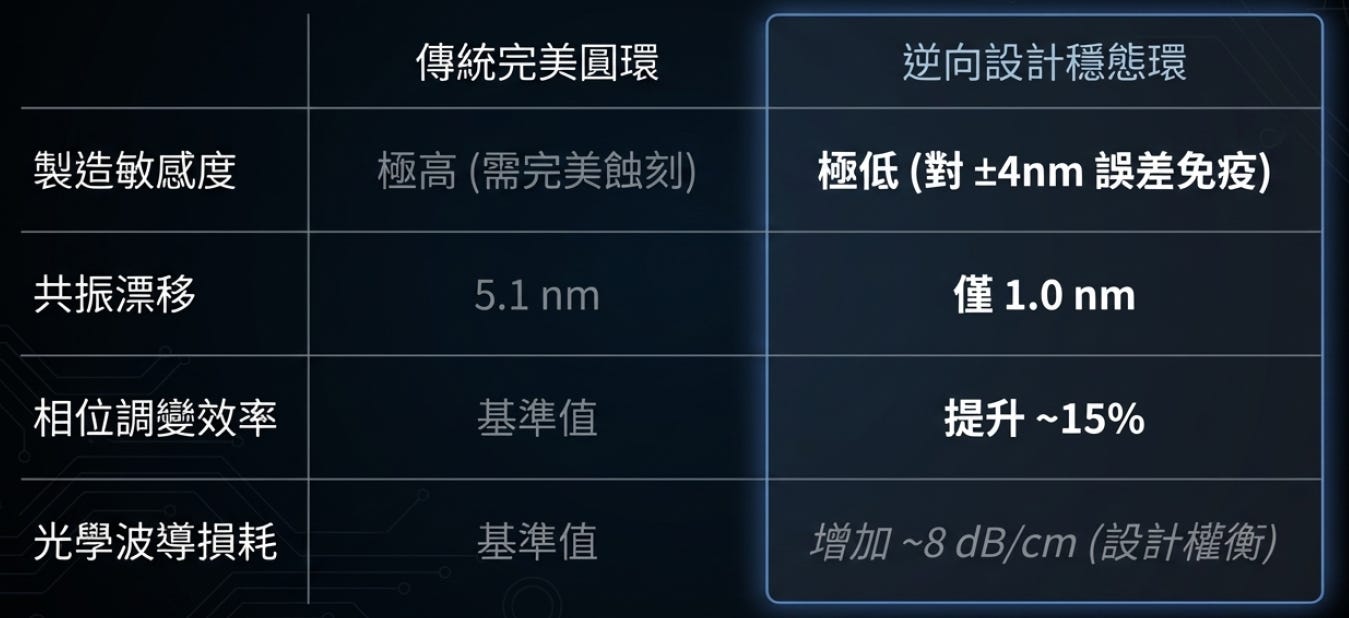
在面臨同樣 8 nm 的總體蝕刻深度變異時,傳統標準圓環的共振波長會發生高達5.1 nm的劇烈偏移;而採用逆向設計的穩定環,其波長偏移被大幅度壓縮至僅有1.0 nm。這意味著逆向設計成功在不增加顯著光學損耗的前提下,實現了 5 倍的製程抗性提升 。

3. 實作結果
研究團隊在商業晶圓代工廠進行了大規模的實體驗證。以下為實作成果的客觀數據與分析總結:
晶片製造與測試規模
團隊採用商業 CMOS 晶圓代工廠的製程,製造了半徑為5 微米與10 微米的逆向設計穩定環與標準圓環,並整合了垂直 PN 接面(關於1310nm Ring半徑大小,請參考補充說明)
測試範圍涵蓋了單片全流程晶圓 (full-flow wafer) 上的 75 顆晶粒 (dies) 。
核心目標驗證:共振波長變異抑制
實測 2.5 倍改善:數據顯示,無論是 5 微米或 10 微米的設計,穩定環的共振波長分佈範圍與標準差,皆比標準圓環縮小了約 2.5 倍 。
理論與實測的落差分析:透過雙變數擬合分析 (Bivariate fit),穩態環的斜率 (k=0.21) 顯示其硬體設計確實具備達成 5 倍變異抑制率的潛力 。然而,數據呈現出較大的散佈現象 (r=0.49),這暗示了除了蝕刻深度之外,還有其他導致變異的來源存在 。
殘餘變異的根因判定 (Residual Variation)
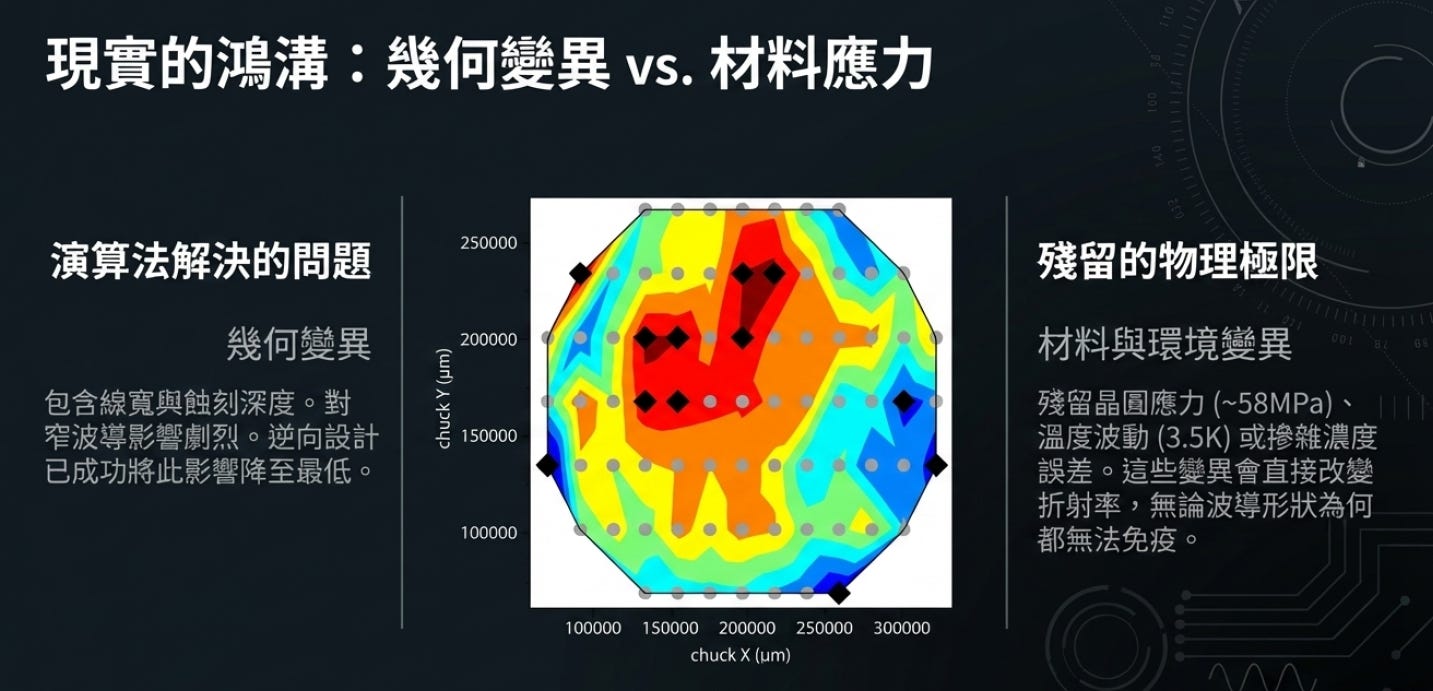
透過晶圓級的殘餘誤差圖分析,發現仍存在高達 0.3 nm 的波長偏移例外點 (相當於折射率改變了約 6.5 x 10⁻⁴) 。
研究團隊推論,逆向設計的「加寬波導」能有效抵禦幾何變異 (如蝕刻深度),但無法抵禦「材料本質變異」 。在排除溫度波動與摻雜濃度的變數,並考量到晶圓廠嚴格的測試條件後,團隊判定殘餘的晶圓應力 (Residual wafer stress) 是導致最終實測抑制倍率僅有 2.5 倍 (低於模擬預測的 5 倍) 的最主要原因
附加效益與物理代價
光學損耗增加:在光學傳輸上,穩定環的等效波導損耗比標準圓環高出了約8 dB/cm。這項損耗是建立在為了 PN 接面進行重摻雜所帶來的高基礎損耗之上 。
由於半徑5 微米的微環其總周長極短(約31.4 微米),因此換算下來,單一微環所增加的「絕對插入損耗」實際上微乎其微。
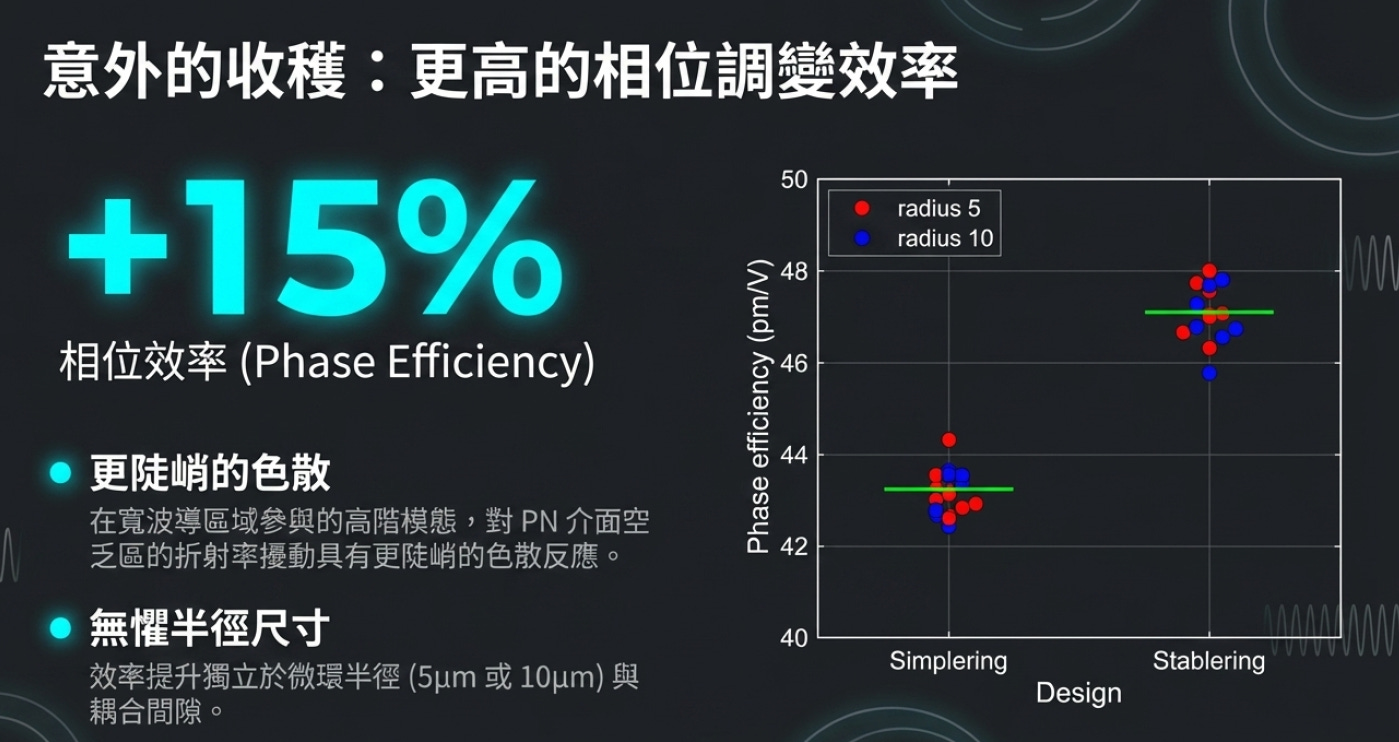
相位調變效率提升:實測數據證實,穩定環的相位調變效率比標準圓環高出了約 15% 。這項結果與模擬預測一致,證實了穩定環中參與的高階模態 (如 TE1),對材料折射率的改變具備更陡峭的響應特性 (steeper dispersion) 。
4. 結論
根據 NVIDIA 團隊的研究結論,他們透過逆向設計成功開發出高穩定性的微環調變器。在先期的理論模擬中,這種特殊幾何設計能將元件對蝕刻深度誤差的敏感度大幅降低5 倍,證明了光學設計確實能有效彌補實體製造的物理缺陷。隨後,在商業晶圓廠進行的大規模晶圓級光學實測中,該設計獲得了具體確效,成功達成2.5 倍的敏感度降低,證實其具備投入實際量產並降低系統功耗的實務價值。
然而,針對理論預測(5 倍)與實測結果(2.5 倍)之間的落差,研究團隊進行了客觀的分析。他們判定,逆向設計雖然能極大化地抵禦由蝕刻製程造成的幾何形狀變異,卻無法消除由「殘餘晶圓應力」等材料本質物理狀態所引發的折射率改變。這項總結精準地反映了矽光子技術在跨越實驗室邁向高密度量產時,工程師必須在演算法極限與材料物理現實之間取得妥協的真實工程挑戰。
5. 補充說明
5.1. 微環大小
設計 1310nm 波段的微環調變器 (MRM) 時,決定半徑大小是整個矽光子晶片設計流程中的核心首要步驟 。此過程需在三個物理條件之間進行最佳化與平衡,而非透過單一公式計算唯一解 :
相位匹配條件 (Phase Matching Condition)

光在微環內形成共振時,其物理路徑長度必須為有效波長的整數倍 。決定半徑的基礎數學公式如下:
2πR × neff= m × λres
R:環的半徑
neff:波導的有效折射率,對於 1310nm 在 SOI 波導中,通常約介於 2.4 至 2.8 之間
m:整數(共振階數)
λres:目標共振波長(例如 1310nm)
設計流程上,通常會先設定半徑的初步範圍,再微調 R 以符合等式,使共振波峰能落在 1310.0nm 的網格(Grid)上。
網格(Grid)指的是光通訊標準中所規範的「特定波長(或頻率)通道的標準排列位置」。
尺寸上限:自由光譜區 (Free Spectral Range, FSR)
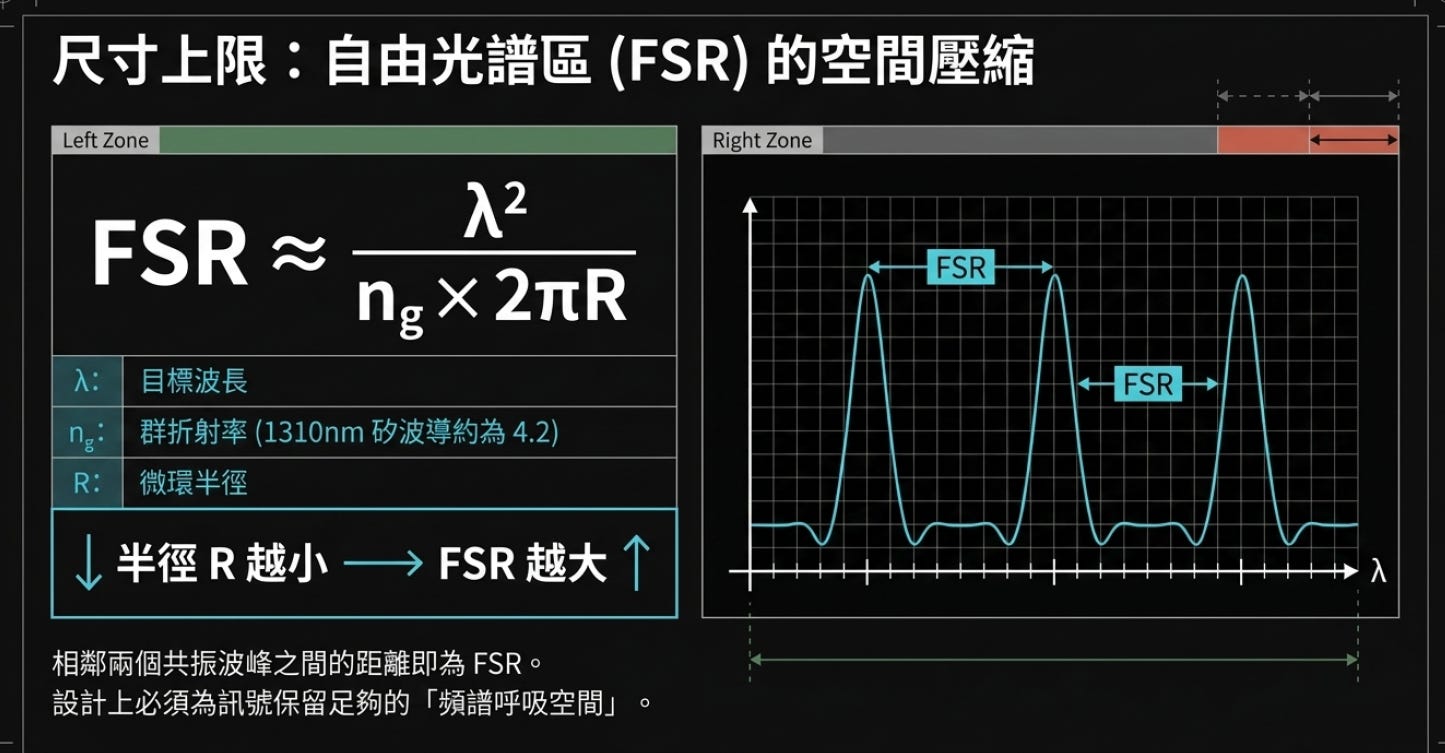
微環會產生一系列週期性的波峰,相鄰兩個波峰之間的距離即稱為自由光譜區 (FSR) 。其數學關係式為:
FSR ≈ (λ2) / (ng× 2πR)
其中ng為群折射率,1310nm 矽波導的群折射率約為 4.2 。
系統要求:在 WDM 系統中,若訊號頻寬為 10nm,則 FSR 必須大於 10nm,以避免相鄰共振波峰干擾訊號通道
物理限制:由公式可知,半徑 R 越小則 FSR 越大;為確保頻譜空間足以避免通道碰撞,設計上通常傾向將微環半徑縮小 。
尺寸下限:彎曲損耗 (Bending Loss)
物理現實:當波導彎曲半徑過小時,光學模態無法被有效侷限於矽核心內而向外洩漏,此現象稱為彎曲損耗

1310nm 的特性:相較於 1550nm,1310nm 的波長較短,光被矽波導侷限的能力較強 。在標準 220nm SOI 晶圓上,1550nm 的微環半徑下限約為 5 μm;而 1310nm 的半徑則可縮小至 4 μm 或 3.5 μm,且不致引發過高的損耗 。
總結
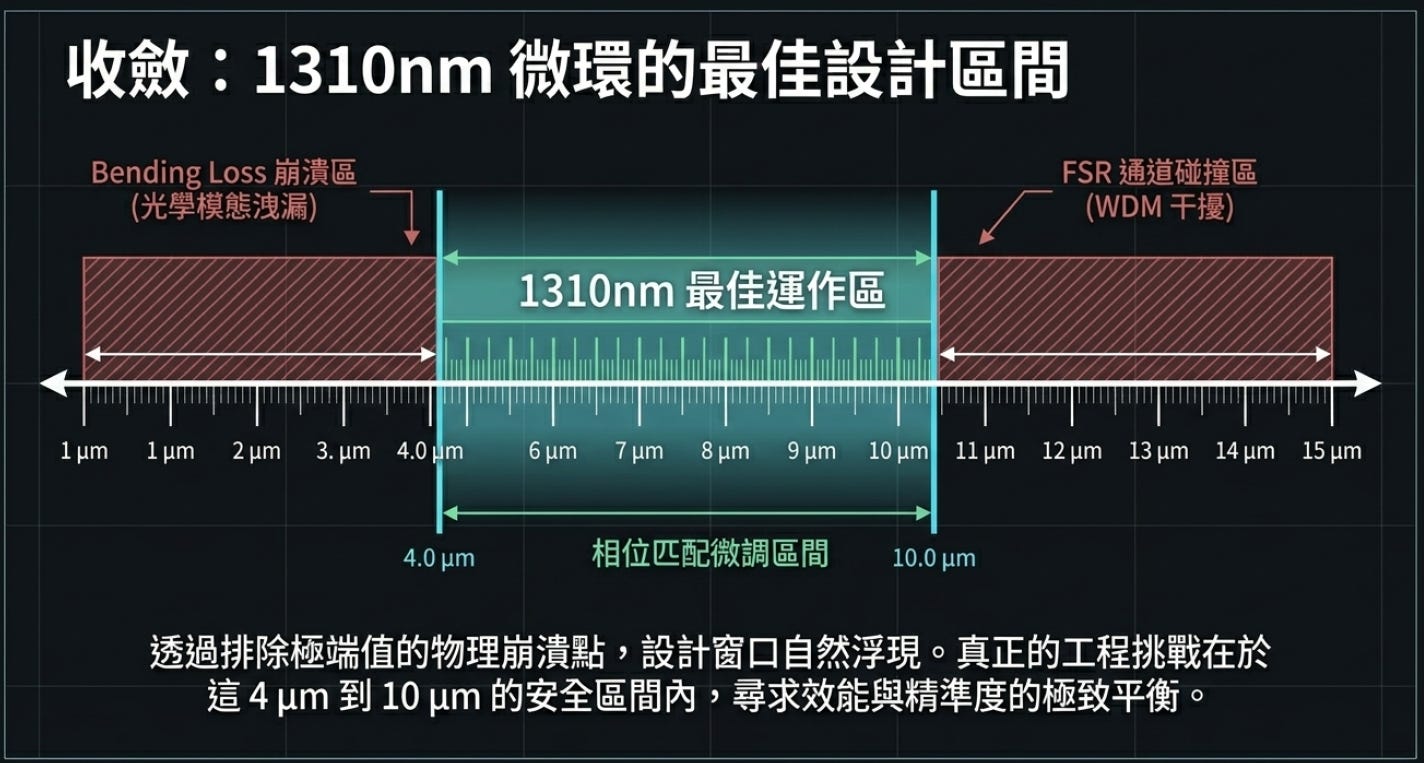
綜合上述條件,1310nm 矽光微環的半徑區間通常介於 4 μm 至 10 μm 之間
半徑不大於 10 μm:避免 FSR 過小而無法容納多通道 WDM 訊號
半徑不小於 4 μm:避免光從波導邊緣洩漏導致 Q-factor 下降及調變失效
5.2. Inverse Design Concept
核心共通點(運算思維)
兩者皆捨棄人類直覺的標準幾何形狀(如正圓、直角),改以「由果推因」的目標導向演算法,仰賴龐大算力(GPU)逆推出反直覺的複雜曲線,藉此突破傳統工程極限。
核心差異點(解決域與目標)
ILT(製程端的逆向):致力於「消除誤差」。主要對抗光學繞射極限,目的是欺騙光學系統,將設計圖完美無瑕地印製在晶圓上。
NVIDIA 逆向設計(設計端的逆向):致力於「包容誤差」。承認完美的實體製造不存在(接受 +/- 4nm 的蝕刻變異),透過改變元件本身的幾何態樣,讓元件對製造誤差產生免疫力。
ILT 在製造端追求完美的圖形轉移,而 NVIDIA 逆向設計則在設計端吸收製造的不完美,兩者皆是半導體與矽光子逼近物理極限下,依賴演算法突圍的必然策略。
[Reference]
OFC26 Tu2J.3, “Inverse-Designed Etch-Stable Ring Modulators“, Nvidia
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


