2026年,AI 硬體的戰火已從單純的 GPU 算力,全面延燒至資料中心網路架構。在這場競賽中,有人試圖打造封閉的垂直整合帝國,也有人正集結產業力量推動開放標準。
2026年,AI 硬體的戰火已從單純的 GPU 算力,全面延燒至資料中心網路架構。在這場競賽中,有人試圖打造封閉的垂直整合帝國,也有人正集結產業力量推動開放標準。
- Source: Ted Yu
- Published: 2026-02-04T16:40:53+08:00
- URL: https://ytyuted.substack.com/p/ep33-ai-networking EP33. AI Networking - Ted Yu
Pledge your support

EP33. AI Networking

Feb 04, 2026
2026年,AI 硬體的戰火已從單純的 GPU 算力,全面延燒至資料中心網路架構。在這場競賽中,有人試圖打造封閉的垂直整合帝國,也有人正集結產業力量推動開放標準。
從 Broadcom Jericho 4 與 NVIDIA Spectrum-X 在跨資料中心(DCI)的路線之爭,到 Ethernet 終於在 Scale-Out 戰場超車 InfiniBand,再到 Scale-Up 領域中 NVLink 面臨 UALink,SUE/ESUN 的挑戰。分享個人心得,歡迎討論。
1. Background
1.1. The Network is the Computer
隨著 AI 模型參數呈現指數級爆炸成長,傳統半導體依靠製程微縮(Scaling)帶來的算力紅利已面臨物理極限。我們正處於一個關鍵的轉折點:當單顆晶片做不大、封裝拼不夠時,網路(Networking)必須進化為運算架構的一部分:
物理的鐵壁:光罩限制 (Reticle Limit)
一切問題的根源在於微影製程的物理天花板。
現狀:ASML 的曝光機存在一個無法突破的物理極限,即Reticle Limit,最大曝光面積約為858 mm²(26mm x 33mm)(約等於人的指甲蓋大小)。
困境:無論台積電的 2nm 製程有多先進,單一顆 Die(裸晶)的面積就只能這麼大。對於 LLM(大型語言模型)這種每幾個月參數就翻倍的「怪獸」來說,單晶片的算力成長已經徹底掉隊。單靠製程微縮已無法滿足 AI 的需求

封裝的緩兵之計:CoWoS 的極限
為了突破單晶片效能,業界轉向 Advanced Packaging(先進封裝)。
拼接策略:利用 CoWoS 或 SoIC 技術,將兩顆(如 Blackwell B200)甚至未來四顆 Die 拼在同一個封裝內。
新的瓶頸:這雖然能解決燃眉之急,但也面臨挑戰。封裝基板(Interposer)本身受到良率、尺寸限制(目前極限約為 3.5x - 4x Reticle Size)以及散熱問題的制約。
結論:封裝只能解決算力「倍數」級的擴充,卻無法解決 AI 對算力「指數」級的需求。
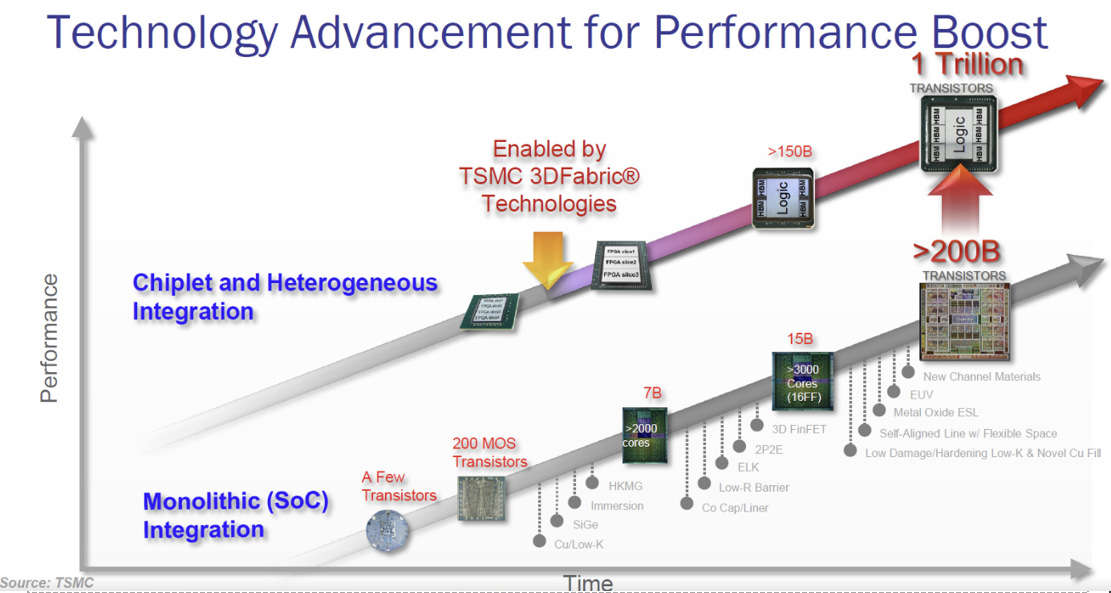
最後的手段 (Last Resort):網路即運算 (The Network is the Computer)
當物理製造和封裝技術都碰到天花板,唯一的出路就是架構層面的重構:把「互連 (Interconnect)」變成「晶片內部的匯流排 (Internal Bus)」。
概念轉換:這是 Scale-Up network 的核心精神。不再將網路視為連接伺服器的管線,而是將其視為晶片內部訊號的延伸。
目標:構建Virtual XPU(虛擬超大晶片)。透過極致的互連,讓軟體以為它在操作一顆巨大的單一晶片,而不是數千顆分散的 GPU。
NVIDIA:利用NVLink+ 銅纜,將 72 顆 GPU 融合成一顆「NVL72 虛擬晶片」。
Google:利用ICI + OCS(光路交換),將 9162 顆 TPU 融合成一顆「Superpod 虛擬晶片」。
Broadcom:利用XPU + SUE架構,構建大規模的「XPU 虛擬晶片」

這不僅僅是網路技術的升級,而是電腦架構的重新定義。因為Semiconductor manufacture limitation(Reticle Limit & Yield),被迫將Computation的壓力轉移到Interconnect上。未來的 AI 算力競爭,不再僅是比誰的 GPU 單核更強,而是比誰能用AI Networking畫出一顆最大、最快、延遲最低的Virtual XPU。
1.2. AI Networking
光通訊技術如何從宏觀的「全球互連」,一路微縮並聚焦到當前最火熱的戰場——「AI 資料中心內部的運算架構」, 這是一個由「廣域傳輸 (Transport)」走向「高密度互連 (Interconnect)」的過程。
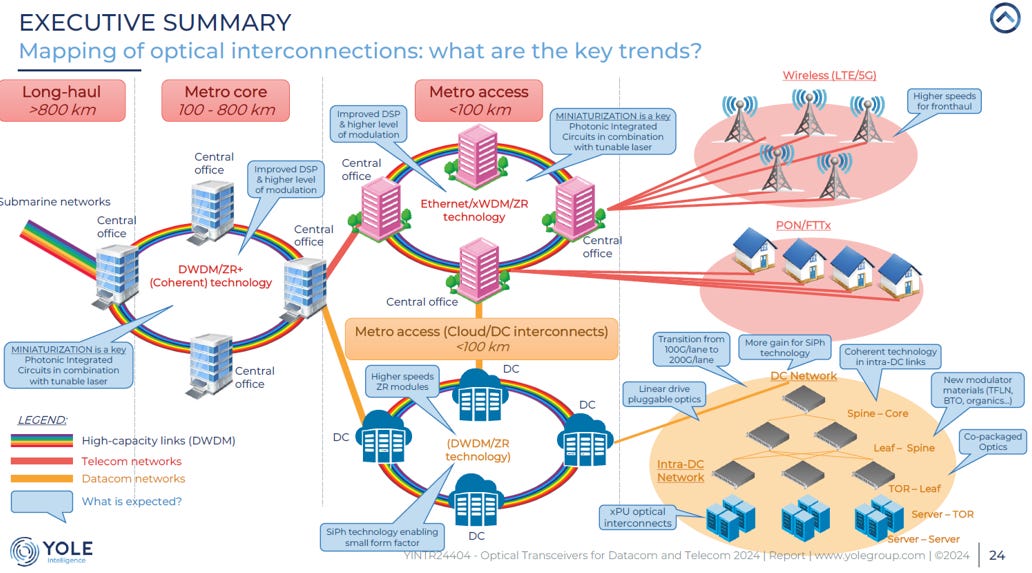
The Big Picture — 光通訊層級的收斂
Long-haul & Metro Core (>100 km - 800 km+):
關鍵技術:Coherent Technology (同調光通訊)是這裡的王者。利用 DWDM/ZR+ 技術進行長距離、大容量傳輸。
趨勢:這裡強調的是訊號的完整性與傳輸距離,DSP (數位訊號處理) 的效能與高階調變 (High level modulation) 是核心。
Metro Access (<100 km):
角色轉變:這是連接城市與資料中心的橋樑。重點在於將 Coherent 技術下放 (Down-scale),例如使用ZR/ZR+ modules來連接不同的Data Center (DCI)。
關鍵字:Miniaturization (微縮化)。透過 PIC (光子積體電路) 和可調雷射 (Tunable laser) 來縮小體積並降低功耗。
Intra-DC Network (資料中心內部):
戰場核心:圖中右下角的橘色區塊是目前技術演進最激進的區域。
技術典範轉移:
從傳統的可插拔模組 (Pluggable optics) 最終演進至CPO (Co-packaged Optics),將光引擎直接封裝在 Switch 或 XPU 旁。
新材料導入:為了追求更高頻寬密度,傳統矽光 (SiPh) 之外,開始探索TFLN (薄膜鈮酸鋰)、BTO或有機材料 (Organics)

Deep Dive — AI DC Networking Infrastructure
當我們鑽進上述的「Intra-DC Network」內部,針對 AI Workload,網路架構被進一步細分為不同的層級 (Tier),其目標只有一個:服務 GPU 的高吞吐運算
Scale-Up Network (垂直擴展 - GPU 互連):
位置:圖中 GPU 區塊內部。
功能:這是最高速、低延遲的互連層,用於將多顆 GPU (例如 8顆、72顆 or more) 綁定成一個巨大的Virtual GPU。
技術對應:這裡通常對應的是NVLink,SUE/ESUN或Google ICI。在硬體上,這往往使用銅纜 (Copper) 或未來的光互連,直接在 Server 內部或 Rack 內部進行 Memory semantic 的溝通。
Scale-Out Network (水平擴展 - 節點互連):
位置:連接不同的 GPU Server/Pod。
功能:用於連接數千甚至數萬顆 GPU 進行分散式訓練。這是RDMA(Remote Direct Memory Access) 發揮作用的地方。
技術對應:這裡對應的是InfiniBand,RoCEv2 (Ethernet)或UEC。這個層級的光模組需求量巨大,且對延遲極其敏感
Scale-Across (跨域擴展):
位置:圖中最下方,連接不同的 Cluster 或資料中心。
功能:當單一 Data Center 電力或空間不足時,需要跨機房進行訓練或推論,這時就回到了第一張圖的DCI (Data Center Interconnect)領域,使用ZR/ZR+等長距離光傳輸技術。
Front-End Network (前端網路):
位置:圖中最上方。
功能:負責管理、儲存存取 (Storage)、以及與一般用途伺服器 (General Purpose Servers) 的溝通。這通常是標準的 Ethernet 網路,雖然重要,但頻寬需求通常低於 Scale-Up/Scale-Out 網路
關於Scale Up, Scale Out和Scale Across的應用範圍:
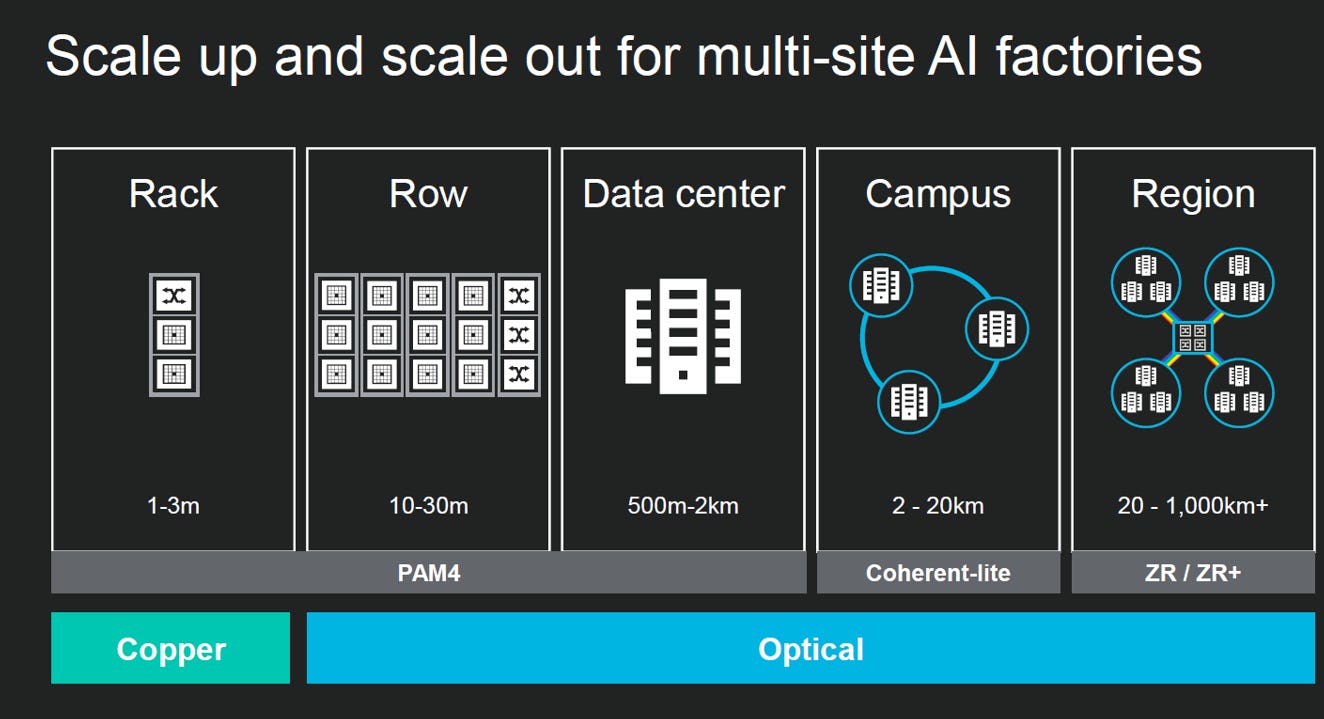
Scale Up (垂直擴展):造「超級晶片」
範圍:Rack(機櫃內, 1-3m)。
目的:透過極致低延遲,讓多顆 GPU 邏輯上變身為「一顆大晶片」(Virtual XPU)。
技術:Copper (銅纜)。
原因:短距離內,銅是絕對王者——速度最快、延遲最低、成本最便宜
Scale Out (水平擴展):造「運算叢集」
範圍:Data Center(機房內,10m - 2km)。
目的:將成千上萬顆 GPU 串聯起來,進行大規模平行運算。
技術:Optical IMDD(Intensity Modulation Direct Detection)/PAM4。
原因:距離拉長,銅線跑不動了,必須切換為光纖。IMDD/PAM4是目前性價比最高的機房內光傳輸技術
Scale Across (跨域擴展):造「分散式網路」
範圍:Campus / Region(跨建築或跨城市, 2km - 1000km+)。
目的:突破單一機房的電力與空間上限,連接多座資料中心(DCI)。
技術:Optical Coherent(Coherent-lite / ZR+)。
原因:距離太遠,訊號衰減嚴重,必須借用電信級的同調光 (Coherent)技術來確保長距離傳輸品質
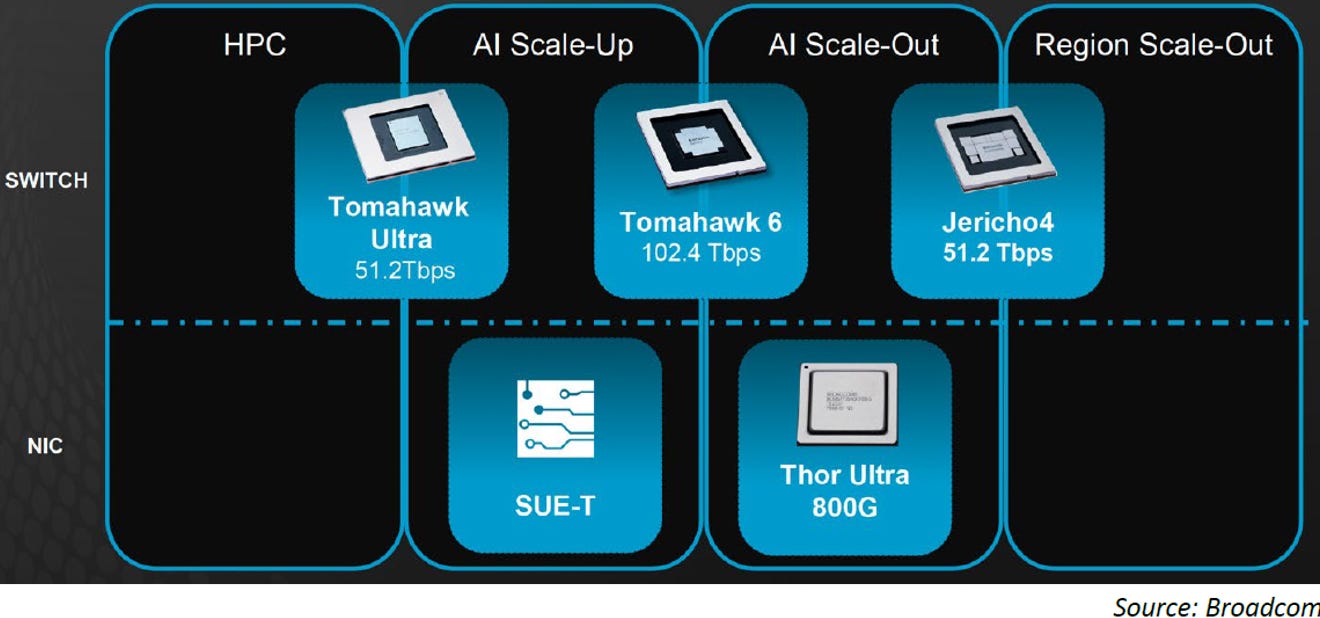
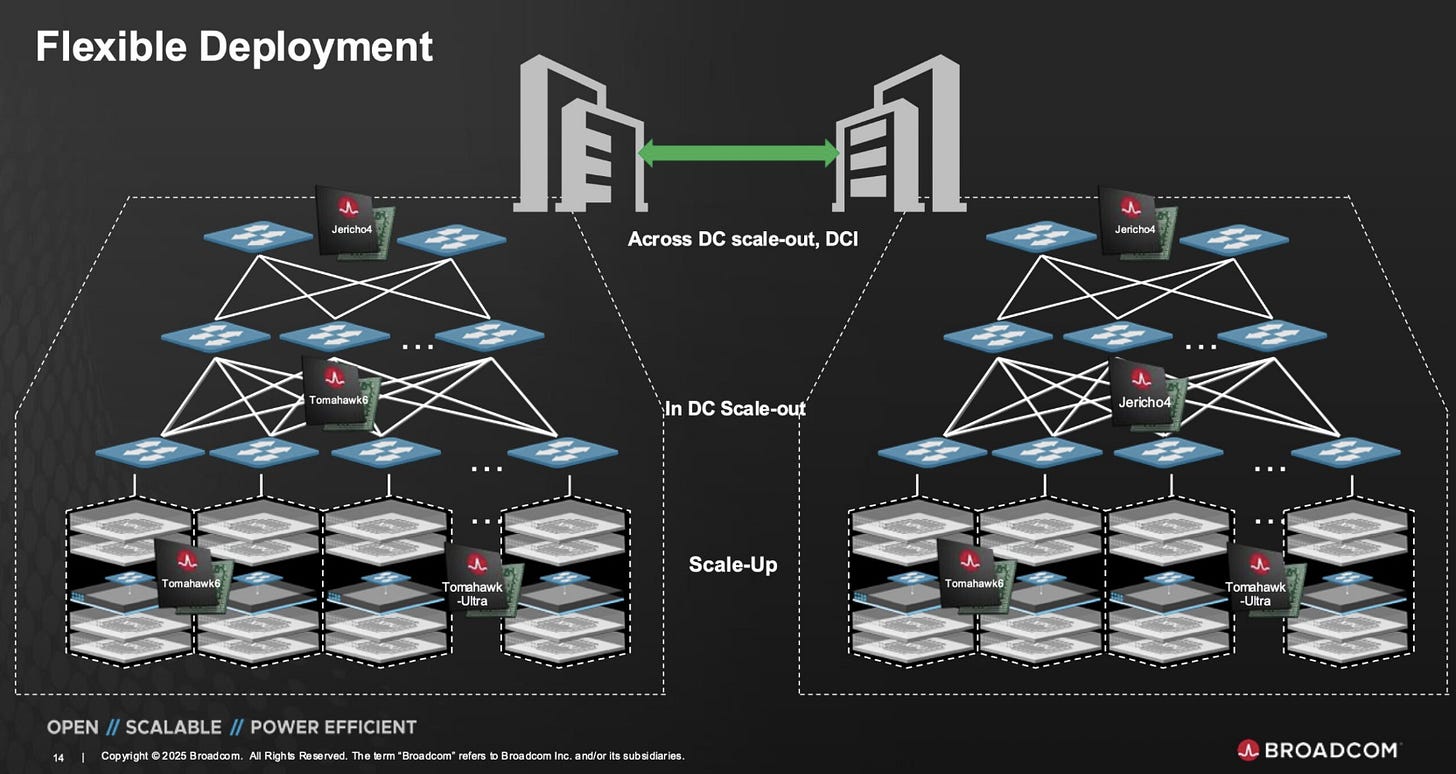
Broadcom 針對 AI 網路提出分層戰略:以Tomahawk Ultra的低延遲特性主攻Scale-Up,以Tomahawk 6的超大頻寬支撐Scale-Out,並以Jericho4的深緩衝架構負責長距離的Region Scale-Out,試圖用全方位乙太網方案一統 AI 基礎建設。
2. Scale Across
2.1. Distributed Data Centers
這張圖是"Scale Across" (跨域擴展)在現實世界中的實體戰場地圖:

展示了美國境內容量超過10MW (百萬瓦)的主要資料中心地理分佈,核心含義如下:
為什麼需要 "Distributed Computing" (分散式運算)?
單點電力瓶頸:請注意左下角的註解 “Data centers with 10MW+ capacity”。雖然 10MW 聽起來很大,但對於現代AI Supercluster(動輒數百 MW) 來說,單一機房的電力與散熱往往很快就觸頂。
結論:無法將所有的 GPU 都塞進地圖上的一個紅點裡。被迫必須將運算任務「分散」到多個紅點(機房)甚至多個區域去執行。
地理分佈就是 “Latency” 的挑戰
群聚效應 (Clusters):圖中用虛線圈起來的區域(如美東Ashburn、美西矽谷、德州、芝加哥等),代表了網路與電力資源最豐富的“Region”。
跨區互連:
圈圈內部 (Intra-region):對應上一張圖的Campus (2-20km),使用Coherent-lite技術互連。
圈圈之間 (Inter-region):例如要讓美西的紅點與美東的紅點協同運算,距離跨越數千公里。這正是上一張圖中ZR / ZR+ (Coherent)技術的用武之地。
這張圖證明了Scale Across不僅是概念,而是物理上的剛需。因為單一機房不夠用,所以必須用長距離光纖網路把這張地圖上的紅點串成一台超級電腦。
2.2. Scale-Across Switch
2.2.1. Broadcom Jericho 4 (ASIC)

場景定位:Scale Across (跨機房互連)
Jericho 4 專攻DCI (Data Center Interconnect),負責連接相距2km+的不同機房。
核心痛點:距離 = 延遲 (Latency)
距離越長,數據在光纖中飛行的時間 (RTT) 越久。一旦網路擁塞需要「煞車」(Flow Control),還有大量數據正在路上,傳統 Switch 的小容量 SRAM (MB級) 會瞬間爆滿並丟包

解決方案:Embedded HBM (Deep Buffer)
以空間換時間:Jericho 4 封裝了HBM,提供GB 級的巨大緩衝區 (Deep Buffer)。這對於推論 (Inference)或長序列訓練的重要性,因為這些場景對丟包極度敏感
Lossless 機制:當遠端發送暫停訊號時,HBM 能將「煞車距離」內湧入的數據全部暫存下來,確保即使跨越100km,也能做到Zero Packet Loss (零丟包)。
晶片邊緣的零和博弈 (Zero-sum Game)(參考 Jericho 4的圖案)
物理限制 (The Constraint):晶片的周長 (Shoreline) 是有限的「黃金地段」
抉擇 (The Trade-off):
Tomahawk 6選擇全蓋「碼頭」(SerDes) —> 追求極致Throughput(吞吐量),但沒有倉庫(僅用SRAM) (TH6: BRCM首度用Chiplets設計Switch IC)。
Jericho 4選擇拆掉部分碼頭,改建「大倉庫」(HBM) —> 犧牲了I/O 數量。
目的為了在長距離 (100km+) 傳輸中,有足夠的空間 (Deep Buffer) 暫存飛行中(on-fly)的數據,確保Zero Packet Loss。
請參考:Jericho4: Enabling Distributed AI Computing Across Data Centers with Broadcom
2.2.2. Nvidia Spectrum-XGS (platform)
針對Scale Across (DCI)場景,NVIDIA Spectrum-XGS(platform) 正在挑戰 Broadcom Jericho 4(ASIC) 的統治地位。這不是單純的規格比拼,而是「控制派 (Control)」 vs. 「緩存派 (Buffer)」的路線之爭。
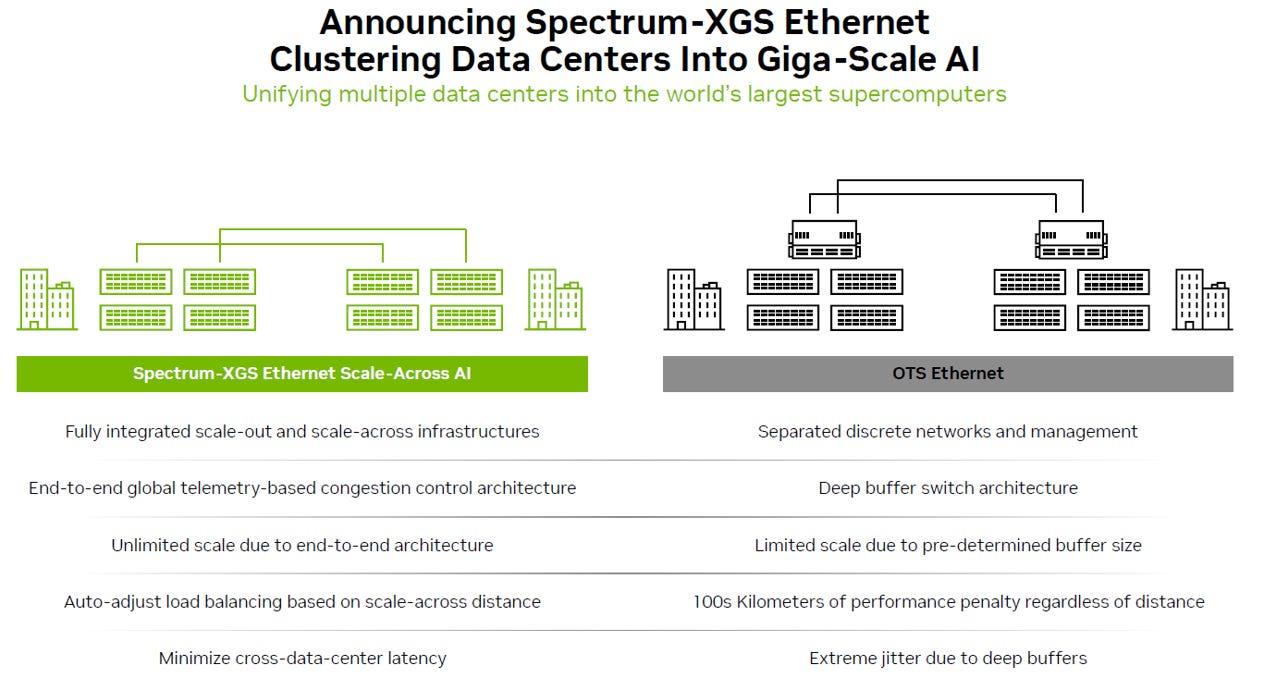
Broadcom ( platform based on Jericho 4 ASIC):緩存派
手段:用HBM (Deep Buffer)當大水庫。
邏輯:遇到擁塞就把數據「存起來」,慢慢消化。
NVIDIA 攻擊點:數據在水庫排隊會造成Jitter (抖動),拖慢 AI 運算
NVIDIA (Spectrum-XGS platform):控制派
手段:用Telemetry (端對端遙測)當智慧號誌。
邏輯:在擁塞發生前就「精準控流」,不讓數據堆積。
優勢:
實現Low Latency (低延遲),並讓機房內外使用同一套 Ethernet 架構,打破了Router的壟斷。
Jericho 4 需要封裝 HBM,這在成本與封裝良率上都是額外的負擔;而 NVIDIA 的 Spectrum-X 試圖用演算法 (Telemetry) 解決物理問題,本質上是為了 Cost Reduction。
結論:
Broadcom (Jericho 4系列) 的護城河:
在跨機房(10km - 100km+)場景,Broadcom 的Jericho系列因為擁有Deep Buffer (HBM),目前幾乎是「壟斷」地位。Hyperscalers 需要它來保證長距離傳輸不掉包。
NVIDIA (Spectrum-XGS) 的挑戰:
NVIDIA 正在試圖用Spectrum-XGSPlatform打入這個市場,宣稱用演算法可以取代HBM Buffer。但在 2026 年初的當下,Jericho+HBM 的物理優勢 (高可靠性)依然較受電信與大型雲端業者信賴,NVIDIA 在此領域尚處於進攻階段,尚未取得決定性勝利。
2.3. IMDD vs. Coherent
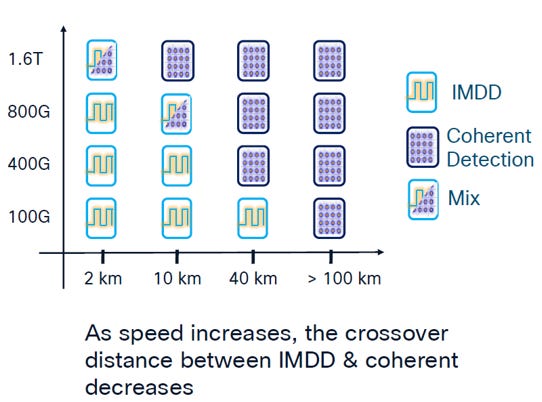
在 1.6T 世代(單通道 200G),傳統定義的長距離正在被重新定義,而2 公里 (2km)確實成為了直接調製偵測 (IMDD) 與相干調變(Coherent) 的關鍵分水嶺。光纖色散 (Chromatic Dispersion, CD)是最主要影響因素。

IMDD 的致命傷:相位遺失 (Loss of Phase)
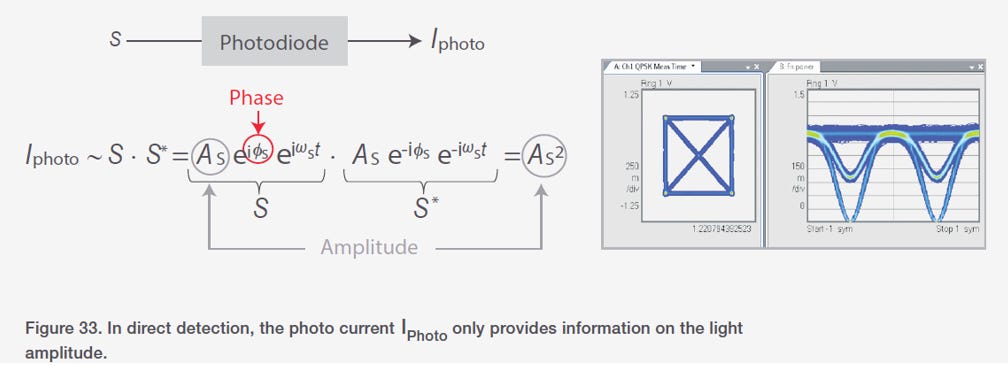
運作原理 (只看強弱):IMDD (如 PAM4) 的偵測器(Photo Diode)非常簡易,它是一個「平方律偵測器 (Square-law Detector)」。它只能感測光波的功率 (Power)或強度 (Intensity),也就是光波振幅的平方。
色散的破壞 (波形擴散):色散會導致不同頻率的光跑得快慢不一,導致光脈衝在時間上「變寬、變矮」,甚至和前後的脈衝疊在一起 (ISI, 符號間干擾)
為什麼救不回來?色散本質上是改變了光波的「相位 (Phase)」關係。 但因為 IMDD 的偵測器在接收光的那一瞬間,把「相位」資訊全都丟掉了(只留下了強度)。一旦相位資訊丟失,無法從單純的強度訊號中,推導出光波原本長什麼樣子。只能靠電氣均衡器(CTLE/FFE/DFE)去「硬猜」原本的波形,能力非常有限。

Coherent 的超能力:全場重建 (Full Field Reconstruction)
運作原理 (混頻偵測):Coherent 接收端有一個「本地振盪雷射 (Local Oscillator, LO)」。它將訊號光與這個 LO 光進行干涉(混頻)
保留相位:透過干涉,偵測器不僅能讀出光的強度 (振幅),還能讀出光的相位 (Phase)和頻率。它捕捉到了光波的完整電場資訊
數位補償 (DSP 作為時光機):DSP 擁有了光波的完整數學描述(振幅 + 相位),色散對它來說,就只是一個已知的「數學函數」。 DSP 只需要在數位域上,乘上一個與色散函數「完全相反」的濾波器 (Inverse Filter),就能在數學抵消色散的影響。
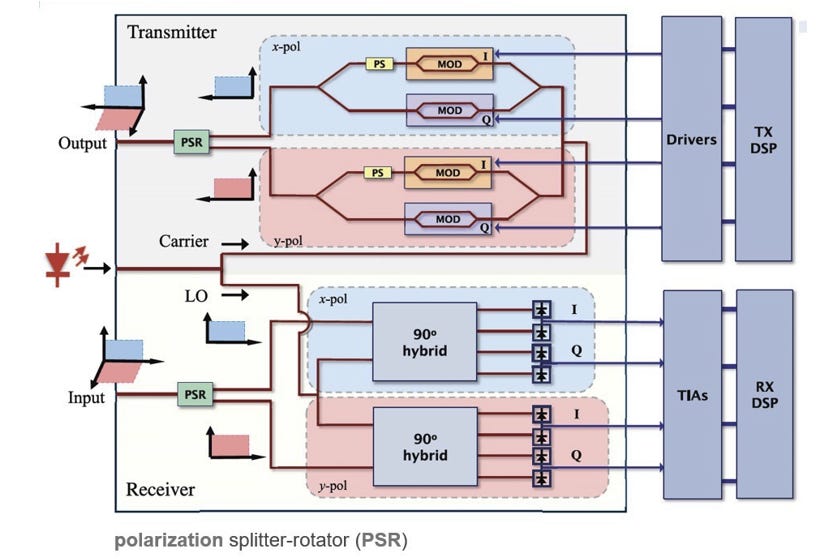

請參考:Everything You Need to Know About Complex Optical Modulation
結論
IMDD 輸在「維度」不夠。它在接收端少了一個「相位」維度,導致它面對色散這種相位扭曲現象時,是「盲人摸象」。
Coherent 贏在「資訊完整」。它把光學問題轉化成了數學問題。只要 DSP 算力足夠,色散在數學上是完全可逆 (Fully Reversible)的,這就是為什麼Coherent可以跑幾千公里,而 IMDD 在1.6T時代連2 公里都跑得氣喘吁吁的原因。
Coherent Lite發現短距離傳輸不需要那麼強的糾錯能力,所以把多餘的 DSP 功能關掉,以換取更省電、更便宜、更快的傳輸效率,專門服務AI Campus(< 20km)
3. Scale Out
3.1. Ethernet Over InfiniBand(IB)
2025 年確實是Ethernet (Scale-Out)正式超車InfiniBand的關鍵年份(參考LC的報告)。這背後有三個核心驅動力:商業博弈、技術進化、與實戰驗證。

商業與運維層面:拒絕被「綁架」 (Anti-Vendor Lock-in)
儘管 IB 性能優異,但它對 Hyperscaler 來說有致命傷:
單一供應商風險: IB 幾乎等同於 NVIDIA。如果 Google 或 Meta 的網路架構全部押注 IB,他們就被 NVIDIA 徹底綁架了 (Vendor Lock-in)。
運維成本 (O&M):全球懂 Ethernet 的工程師有幾百萬人,但精通 InfiniBand 的可能只有幾千人。維護一套龐大的 IB 網路需要昂貴的專門團隊。
通用性:Ethernet 是通用的,今天的 AI Cluster 退役後,這些 Switch 還能挪作他用;但 IB Switch 只能跑高性能運算,缺乏彈性。
技術層面:Ethernet 已經「進化」
傳統 Ethernet 是 “Lossy” (會丟包) 的,這對 AI 確實不行。但現在的AI Ethernet(如 NVIDIA Spectrum-X) 已經不是傳統定義下的Ethernet了。它透過以下技術「模仿」了 IB 的強項:
RoCEv2 (RDMA over Converged Ethernet):讓 Ethernet 也能像 IB 一樣直接存取記憶體,繞過 CPU,大幅降低 Latency。
Adaptive Routing (自適應路由):這是關鍵。傳統 Ethernet (ECMP) 是靜態的,容易發生 Hash Collision 導致某條路塞死。新一代 Ethernet (如 Spectrum-X) 能像 IB 一樣,感知擁塞並動態繞道 (Per-packet dynamic routing)。
Congestion Control (擁塞控制):利用 Telemetry 技術 (如您之前上傳的圖),實現端對端的流量管理,做到近似Lossless的效果。
實戰驗證:x.AI Colossus
x.AI 的 100k H100 Cluster (Colossus) 是Proof of Scale。
規模:這是世界上最大的 AI Cluster 之一。
網路:全部採用Ethernet (NVIDIA Spectrum-X),而非InfiniBand。
意義:這證明了「Ethernet 足以支撐 10 萬卡級別的訓練任務」。如果連 Elon Musk 這種追求極致速度的人都選擇 Ethernet,這大幅削弱了其他企業堅持採用昂貴且封閉 IB 架構的理由
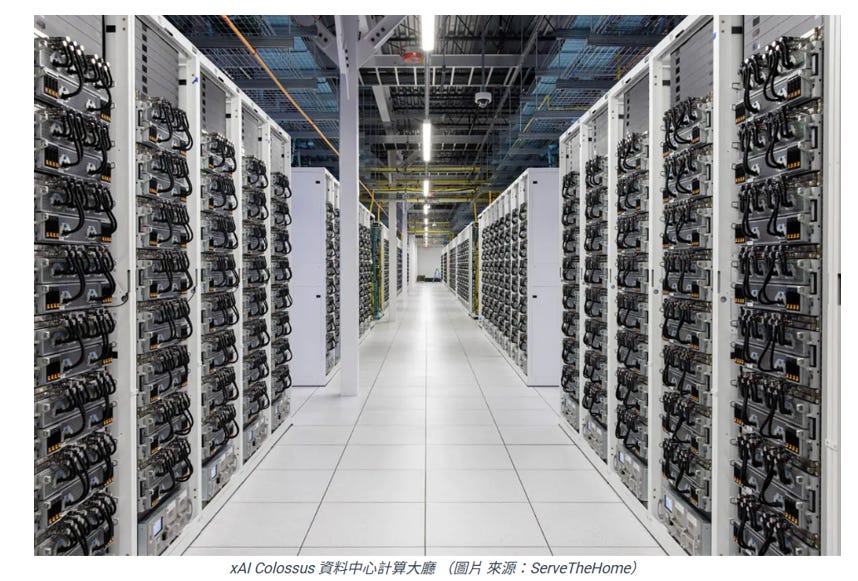
在AI Scale-Out的主戰場,Ethernet 已經獲勝。未來的 AI Factory,將是Spectrum-X (NVIDIA)與UEC(Ultra Ethernet Consortium)兩大 Ethernet 陣營的對決,而不再是Ethernet與InfiniBand的戰爭。
NVIDIA 選擇以「一般成員 (General Member)」而非核心決策者的身分加入UEC,主要基於兩點務實考量:
確保互通性 (Interoperability):透過參與聯盟,NVIDIA 能掌握業界通用的技術標準草案,確保其產品未來能與市場上的其他設備相容,避免技術孤立。
維持雙軌策略 (Dual Strategy):NVIDIA 雖然參與開放標準,但其商業重心仍聚焦於推廣自家的Spectrum-X平台,以提供差異化的高效能解決方案,而非致力於推動競爭對手主導的開放生態。
3.2. UEC(Ultra Ethernet Consortium)
Ultra Ethernet Consortium (UEC)改善Ethernet的核心策略在於對通訊堆疊(Stack)的全面優化,特別是引入了Ultra Ethernet Transport (UET)協議來解決現代 AI 與 HPC 的效能瓶頸。
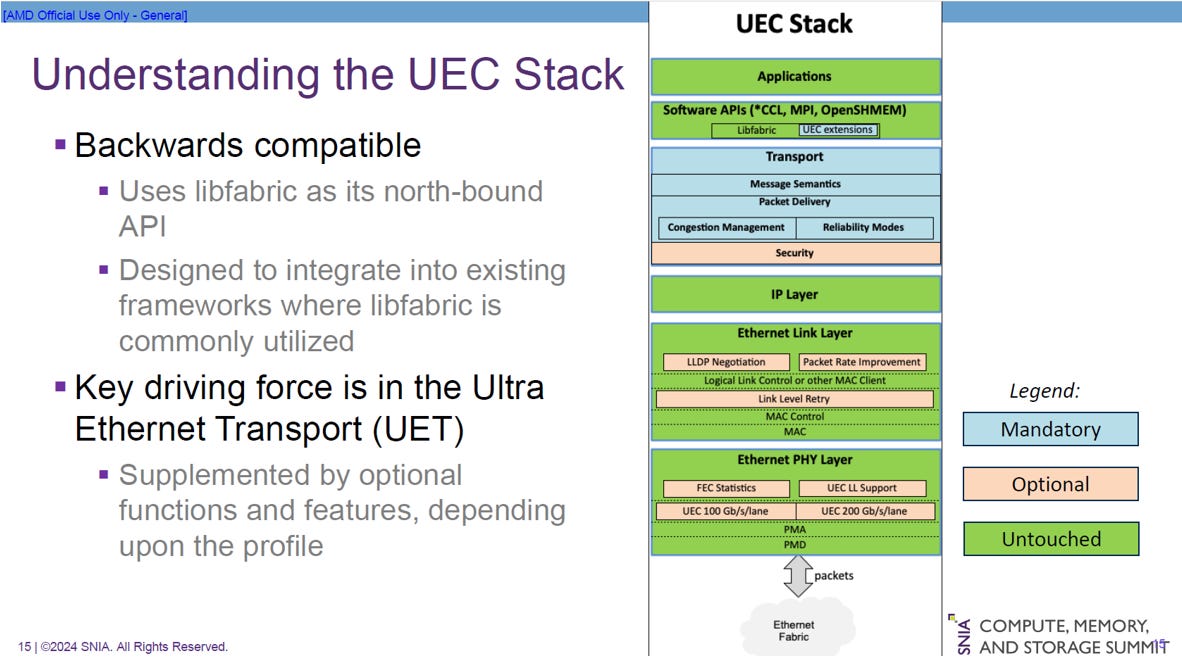
重新設計傳輸層 (Transport Layer)
這是 UEC 最關鍵的改進。傳統Ethernet在處理 AI 任務時效率較低,UET 透過以下技術進行了徹底改革:
封包噴灑 (Packet Spraying):傳統 RDMA 採用流級多路徑(Flow-level multi-pathing),容易造成路徑擁塞;UET 則採用封包噴灑,能實現更高的網路利用率。
靈活的傳輸順序:支援「無序封包交付」(Out-of-order packet delivery)但保持「有序訊息交付」,這能更精準地匹配應用需求並降低尾部延遲(Tail Latency)。
先進擁塞控制:捨棄了配置複雜且脆弱的 DCQCN,提供針對工作負載優化、無需配置且具備可程式化能力的擁塞控制技術,能減少 Incast 問題並加快反應速度。
強大且向後相容的堆疊結構
UEC 在維持與現有技術相容的同時,對軟硬體層級進行了區分與強化:
軟體層相容性:使用libfabric作為其北向 API,使其能無縫整合進現有已廣泛使用 libfabric 的軟體框架中。
分層優化 (UEC Stack):
傳輸層 (Transport):屬於「強制性 (Mandatory)」改進核心,包含封包交付、訊息語義與擁塞管理。
實體層 (PHY Layer):支援 100 Gb/s 到 200 Gb/s 每通道速率,並提供 UEC 鏈路層支援與 FEC 統計。
可選擴充性:根據不同的 Profile(應用場景),提供可選的安全與可靠性模式功能
解決大規模擴充與安全問題
針對 AI 資料中心動輒數萬個節點的需求,UEC 進行了以下優化:
極大規模化:傳統 RDMA 通常僅支援數千個同時在線端點,而 UEC 的目標是支援100 萬個端點 (1M endpoints)。
原生安全機制:將安全視為「一等公民(1st class citizen)」,提供可擴展的原生安全設計,而非像傳統標準將安全外包給外部規格。
端到端遙測:支援發送端或接收端的遙測,相比傳統僅依賴 ECN 的機制,能提供更好的可視化與更快的擁塞解決能力。
UEC 與傳統 RDMA 差異總結

網路利用率的提升:UEC 改用封包噴灑 (Packet spraying)技術,取代傳統的流級多路徑傳輸,能將流量更均勻地分散在網路中,避免特定路徑擁塞。
延遲表現的優化:透過支援無序封包交付 (Out-of-order packet delivery)並維持有序訊息傳遞,UEC 能有效降低 AI 運算中最擔心的長尾延遲 (Tail latency)。
用一個生活化的比喻來說明UEC與傳統RDMA的差異。例如:傳統 RDMA 像是在高速公路上指定單一車道,一輛車拋錨(擁塞)後面全堵住;UEC 的封包噴灑則是允許車輛任意變換車道,只要最後在出口處(接收端)按順序排好即可
擁塞控制的現代化:捨棄了設定複雜且反應較慢的DCQCN(Data Center Quantized Congestion Notification),UEC 採用免配置、可程式化且低延遲的擁塞控制機制,並強化了端對端的遙測能力。
軟體整合的簡化:UEC 以libfabric作為標準 API,讓開發者能更輕易地將現有的 AI 框架與應用程式移植到 UEC 體系,同時降低了硬體實作的複雜度。
超大規模的支援能力:UEC的目標是支援多達100 萬個端點,遠超傳統 RDMA 僅能負載數千個端點的限制,並將網路安全納入核心規範中。
4. Scale Up
根據前面 LightCounting 報告圖表,可以看到一個驚人的趨勢:Scale-up Switches(紫色柱狀)的銷售額預計將在 2029-2030 年左右超越傳統的 Ethernet Switches(藍色柱狀),成為市場的主導力量。這代表「讓多顆 GPU 像一顆超級晶片一樣運作」的技術,價值正急速攀升。

市場霸主:NVIDIA NVLink + NVLink Switch
這是目前 Scale-Up 領域的絕對標準,也是這一波 AI 硬體革命的核心。
技術核心:NVIDIA 透過NVLink實現了 GPU 之間的高頻寬、記憶體語意(Memory Semantic)互連,讓 GPU 記憶體可以共享。
架構實例 (GB200 NVL72):如圖所示,NVIDIA 的GB200 NVL72架構將 72 顆 GPU 透過背板(Backplane)和銅纜(Copper Cables)連接成一個巨大的單一邏輯單元。
關鍵組件:
NVLink Switch Tray:這是物理層的核心交換單元,負責處理 GPU 間的點對點高速傳輸。
銅纜直連:在機櫃內部,NVIDIA 採用銅纜而非光纖,這能降低功耗並減少 SerDes 的轉換延遲。
優勢:生態系極度成熟,軟體堆疊(CUDA)優化最好,是目前訓練大型 LLM 的首選
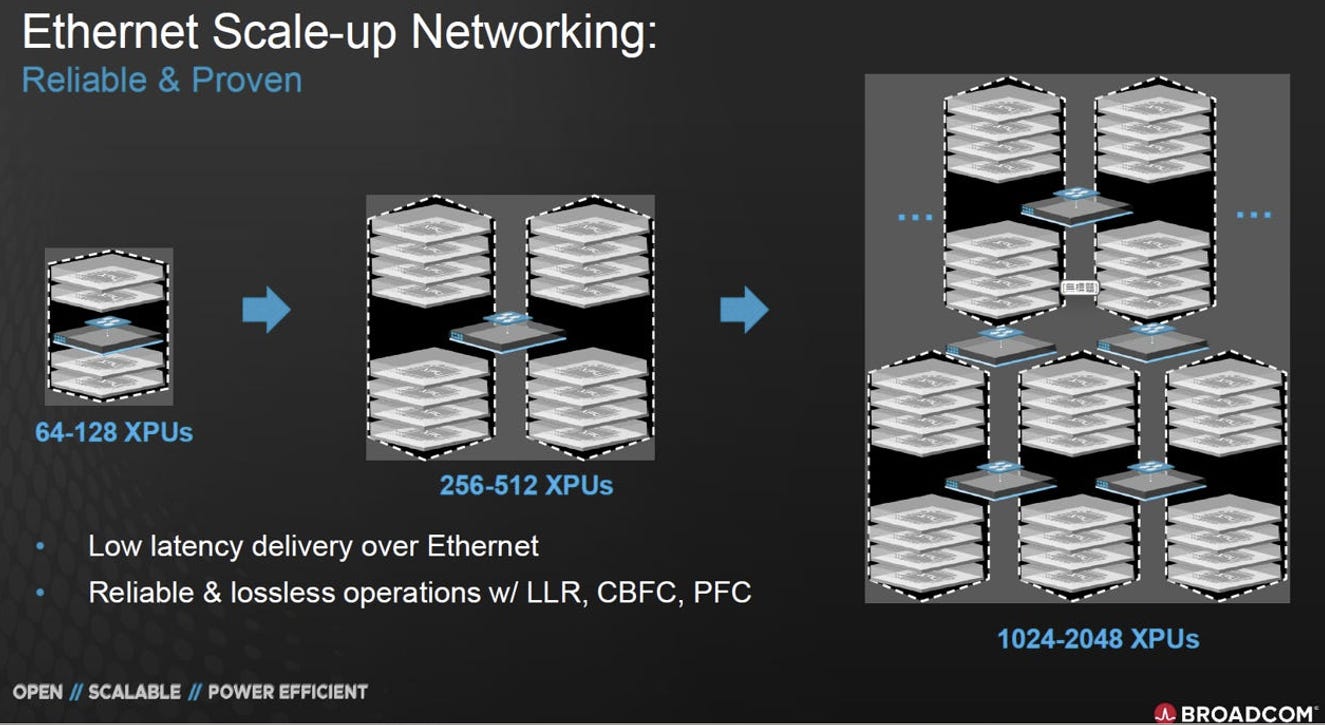
Ethernet的反擊:Broadcom SUE / ESUN (Ethernet Scale-Up Networking)
為了打破 NVIDIA 的專有壟斷,OCP (Open Compute Project)陣營與Broadcom正在大力推動基於標準Ethernet的 Scale-Up 方案。
技術核心:Broadcom 提出的SUE (Scale-Up Ethernet)或ESUN,主張利用Ethernet的通用性來解決專用互連(如 NVLink/InfiniBand)成本高、供應商單一的問題。
運作機制:如圖所示,Broadcom 強調 Ethernet Scale-up 已經具備 “Reliable & Proven” 的特性。
利用LLR (Link Level Retry)、CBFC和PFC (Priority Flow Control)來實現無損傳輸(Lossless),現在Ethernet也能做到。
圖中展示了從 64 XPUs 到 2048 XPUs 的擴展能力,顯示Ethernet交換機(Tomahawk Ultra 系列)已經準備好處理這種大規模的 Scale-Up流量。
優勢:成本較低、供應鏈開放、多供應商支持。這是 Meta、Microsoft 等 Hyperscaler 非常渴望的路徑。
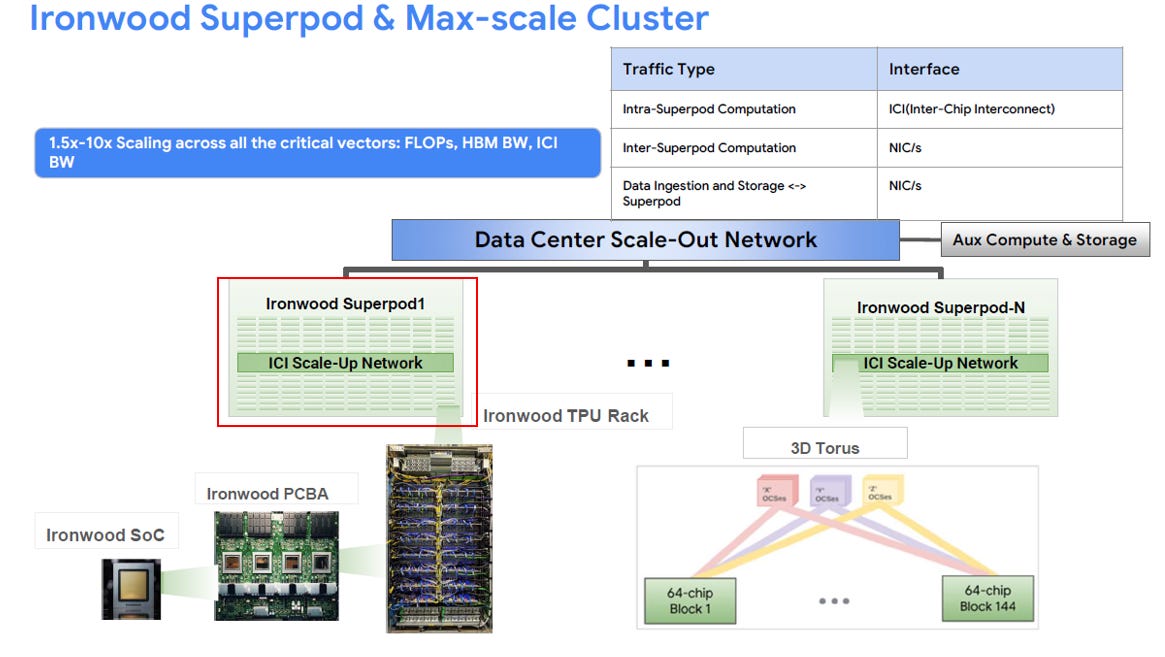
特殊架構:Google TPU ICI + OCS (Optical Circuit Switches)
Google 走了一條完全不同的路,這屬於non-EPS (Non-Electrical Packet Switching)的範疇,是極具前瞻性的架構
技術核心:Google TPU 使用自研的ICI (Inter-Chip Interconnect)進行晶片間互連,類似於 NVLink。但在機櫃與 Pod 之間的互連,Google 引入了OCS (Optical Circuit Switches)。
OCS 的特點:
非封包交換:OCS 不是像傳統交換機那樣讀取封包標頭並轉發(Packet Switching),而是透過 MEMS 鏡片物理反射光訊號。這意味著它不需要光電轉換(O-E-O),延遲極低且功耗極低。
動態拓撲:如圖中的Ironwood Superpod與3D Torus架構,OCS 允許 Google 根據工作負載動態改變網路拓撲,靈活組合64-chip Blocks。
地位:這是 Google 獨家的秘密武器,雖然不對外銷售,但證明了在超大規模下,「光電混合」或「全光交換」在Scale-Up中的潛力。

開放標準聯盟:UALink (Ultra Accelerator Link)
背景:由 AMD、Intel、Amazon、Cisco 等巨頭組成的聯盟,目標是制定一個開放標準的 Scale-Up 介面,直接對標 NVLink。
目標:讓不同廠商的 GPU/加速器(XPU)能夠在同一個記憶體域內互連。
展望:如果 Broadcom 的交換機晶片能原生支援 UALink,這將與上述的SUE/ESUN形成互補——SUE 解決傳輸層,UALink 解決協定層與記憶體一致性問題。
結論
依據 LightCounting 的數據,Scale-up Switch營收將呈現爆發式增長。未來的戰局將呈現「三足鼎立」:
NVIDIA NVLink:目前的王者,追求極致效能與垂直整合。
Google TPU/OCS:特立獨行的先行者,展示了光交換在Scale-Up的可能性。

[Reference]
Jericho4: Enabling Distributed AI Computing Across Data Centers with Broadcom
Everything You Need to Know About Complex Optical Modulation
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


