這幾個星期最熱門的話題就是Google Gemini 3 的問世,網路上有相當多的討論,請參考附件。基於硬體的經驗,整理手邊的資料,介紹Google Ironwood TPU,這是促成Gemini 3進化的基石。分享個人觀點,歡迎討論。
這幾個星期最熱門的話題就是Google Gemini 3 的問世,網路上有相當多的討論,請參考附件。基於硬體的經驗,整理手邊的資料,介紹Google Ironwood TPU,這是促成Gemini 3進化的基石。分享個人觀點,歡迎討論。
- Source: Ted Yu
- Published: 2025-12-04T08:16:51+08:00
- URL: https://ytyuted.substack.com/p/ep26-google-ironwood EP26. Google Ironwood - Ted Yu
Pledge your support

EP26. Google Ironwood

Dec 04, 2025
這幾個星期最熱門的話題就是Google Gemini 3 的問世,網路上有相當多的討論,請參考附件。基於硬體的經驗,整理手邊的資料,介紹Google Ironwood TPU,這是促成Gemini 3進化的基石。分享個人觀點,歡迎討論。
1. Google TPU(Tensor Process Unit)
1.1. TPU 發展路線圖
Google TPU 的發展路線圖(Roadmap)從早期的推論專用晶片,演進至今日的高效能訓練集群,並於 2025 年推出採用全新架構的 “Ironwood”


Source: Google
穩定演進 (2015-2024):從早期的TPU v1(推論專用) 一路演進至Trillium。重點在於不斷擴大集群規模 (從單晶片到數千顆互連)、導入液冷與光學互連技術,並衍生出「效能型 (v5p)」與「成本效益型 (v5e)」產品線。
重大躍進 (2025 Ironwood):2025 年推出的Ironwood是架構上的大變革。
技術突破:首度採用雙運算晶粒 (Dual Compute Die)設計。

Source: Google
算力 (FLOPS) 的巨大躍進:
Ironwood的單晶片算力高達4614 TFLOPS,而 TPU v5p 僅為 459 TFLOPS。
這代表算力在一個世代間成長了10 倍以上,證實了雙晶粒架構帶來的效能紅利。
記憶體 (HBM) 大幅強化:
為了餵飽龐大算力,Ironwood 配備了192 GB的 HBM3e,頻寬高達7.4 TBps。
相比 v5p (2.8 TBps),頻寬提升了約2.6 倍,容量也翻倍。
集群規模 (Pod Size) 趨於穩定:
Pod 的晶片數量從 v5p 的8960顆微幅增加至9216 顆。
這顯示 Google 在這一代的策略是透過提升單顆晶片的密度與效能,來推動整體算力而非單純依賴擴大集群規模。
1.2. Ironwood 架構
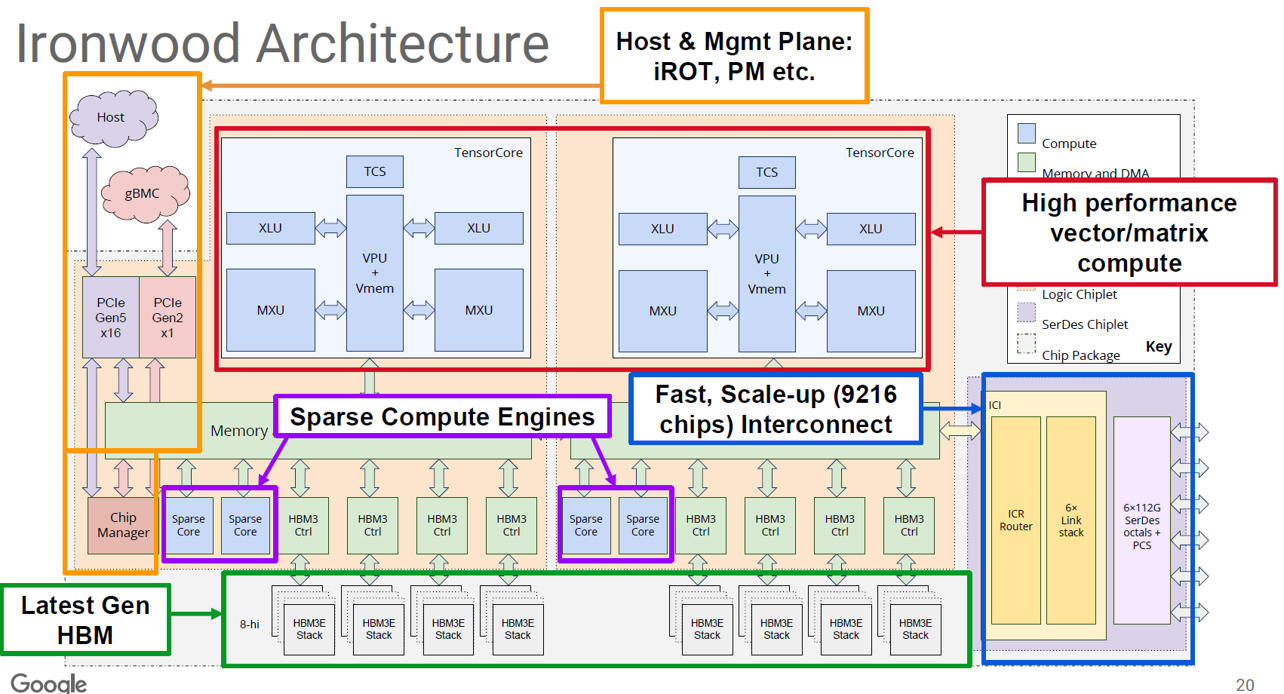
Ironwood採用了高度模組化的Chiplet(小晶片)設計。這是一個雙運算晶粒(Dual Compute Die)的系統,旨在最大化 AI 訓練與推論的吞吐量
Source: Google
雙運算核心架構 (Dual Compute Die)
Ironwood的核心由兩個對稱的TensorCore區塊組成,這是其效能暴增至 10 倍的基礎。
每個 TensorCore 內部包含MXU(矩陣運算單元) 與VPU(向量運算單元),專門處理高效能的矩陣與向量計算。
稀疏運算引擎 (Sparse Compute Engines) -特殊功能
這是 Ironwood 最獨特的硬體功能之一。架構圖中明確標示了專用的Sparse Core。
這代表 Google 在硬體層面直接針對 AI 模型的「稀疏性 (Sparsity)」進行加速,能大幅提升處理非密集數據的效率與功耗比。
大規模互連擴展 (Scale-up Interconnect)
採用ICI (Inter-Chip Interconnect)技術,內建ICR Router與6x8112G SerDes(可支援6個800Gbps)。
此架構支援無縫擴展 (Glueless scale-up) 至單一叢集9216 顆晶片,以應對超大規模模型訓練
下一代記憶體系統 (Latest Gen HBM)
搭載8 層堆疊 (8-hi) 的 HBM3e記憶體。
提供高達7.4 TBps的頻寬與192 GB的容量,以解決記憶體牆瓶頸
硬體級安全 (Hardware Security)
在主機管理平面 (Host & Mgmt Plane) 中整合了iROT (Integrated Root of Trust),提供晶片層級的安全信任根,確保運算環境的安全性
1.3. Broadcom ASIC
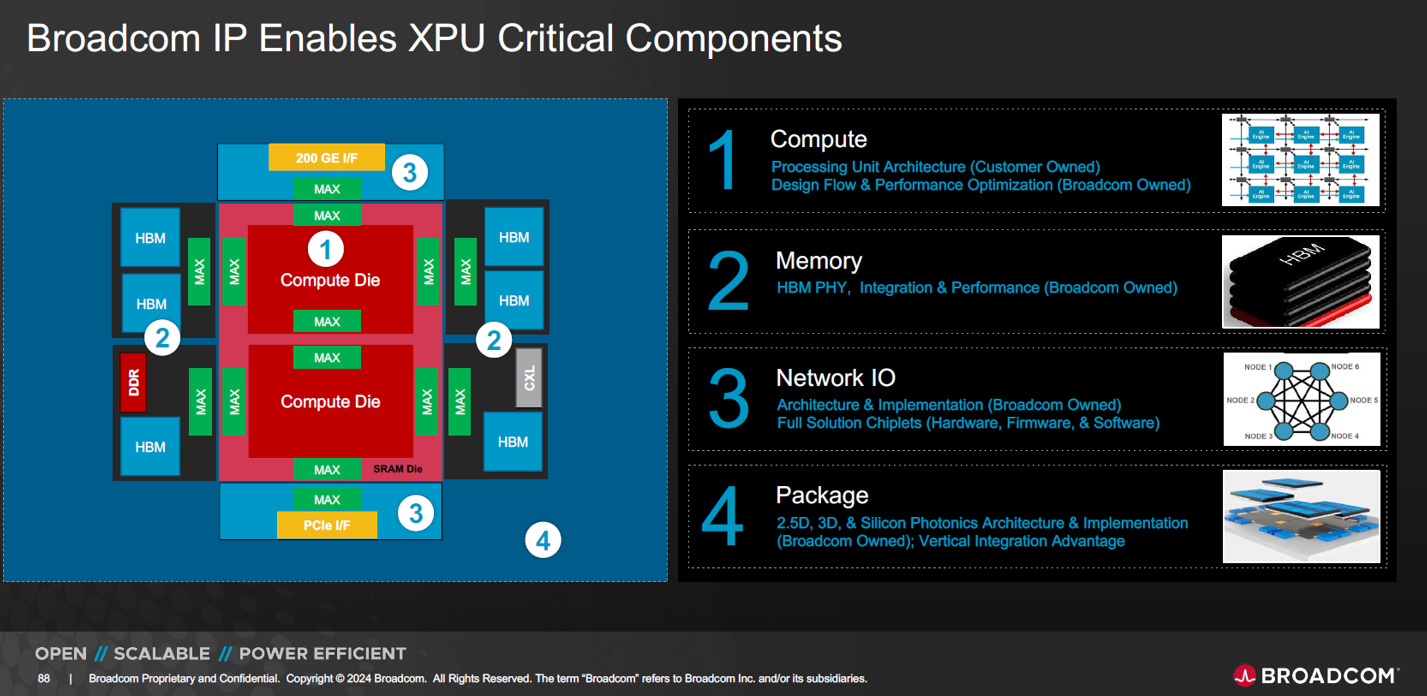
Ironwood是一個典型的「Google 定義 (Defined) + Broadcom 賦能 (Enabled) + TSMC 製造 (Manufactured)」的ASIC合作模式。
Source: Broadcom
Google:掌握核心靈魂 (Compute)
職責:Google 專注於設計核心的Compute Die,包含 TensorCore、MXU、VPU 以及最新的Sparse Compute Engines。
意義:這是 Broadcom 投影片中指出的“Customer Owned” (客戶擁有)區域,代表了 Google 獨家的 AI 演算法硬體化優勢。
Broadcom:提供關鍵 IP 與整合 (I/O, Memory, Packaging)
職責:Broadcom 提供通用的高效能模組 IP 來加速開發,包括:
網路 I/O (Network IO):提供112G SerDes技術,實現 Ironwood 的ICI 互連。
記憶體介面 (Memory):提供HBM PHY 與控制器,確保 HBM3E 能穩定達到 7.4 TBps 的頻寬。
封裝整合 (Package):負責 2.5D/3D 封裝架構的實作與供應鏈管理。
TSMC:先進製程製造 (Manufacturing)
雖然圖片未直接標示 TSMC,但此模式下,Broadcom 通常作為主要窗口,將設計交由 TSMC 進行先進製程晶圓製造與CoWoS封裝。
總結:
Google 透過使用 Broadcom 成熟的 SerDes 與 HBM IP,得以將研發資源全數集中在最核心的 AI 運算邏輯上,並利用 Broadcom 的整合能力縮短上市時間 (Time-to-Market)。
1.4. Ironwood與B200比較
Google Ironwood 與 Nvidia B200 (Blackwell) 是正面對決的兩大 AI 旗艦晶片。兩者在單晶片硬體規格上呈現驚人的「趨同」,但在網路互連哲學上截然不同:
硬體規格:勢均力敵
架構:兩者皆因光罩極限(Reticle size < 850mm2)而採用雙運算晶粒 (Dual Compute Die)設計。
算力:Ironwood 的 FP8 算力達4614 TFLOPS,已完全追平 B200 的密集算力水準
記憶體:兩者皆搭載192 GB HBM3e。Ironwood 頻寬達7.4 TB/s,與 B200 (8.0 TB/s) 處於同一量級,皆解決了記憶體牆問題
互連架構(Scale-up):光學 vs. 電氣 (最大差異)
Ironwood (光學流):ICI互連頻寬為1.2TB/s(112Gbps SerDes),依賴OCS (光學電路交換)。優勢在於極致節能、低延遲,並能透過「拓撲工程」物理改變網路形狀以適配模型,支援單一叢集擴展至9216 顆。
B200 (電氣流):依賴NVLink + NVSwitch(EPS, Electrical Packet Switch)。優勢在於互連頻寬更高1.8TB/s(200Gbps SerDes),且通用性強,適合各種多租戶與隨機流量場景
特殊優化
Ironwood:硬體內建Sparse Compute Engines,顯示 Google 針對自家 Gemini 等稀疏模型 (MoE) 做了深度客製化,將稀疏運算視為核心功能
總結
Ironwood 的出現代表 Google 在硬體規格上已「追平」了與 NVIDIA 的差距,並試圖利用其獨家的光學網路 (Optical Network)優勢,在大規模模型訓練和推理的能效比上超越對手。
1.5. IronWood Tray
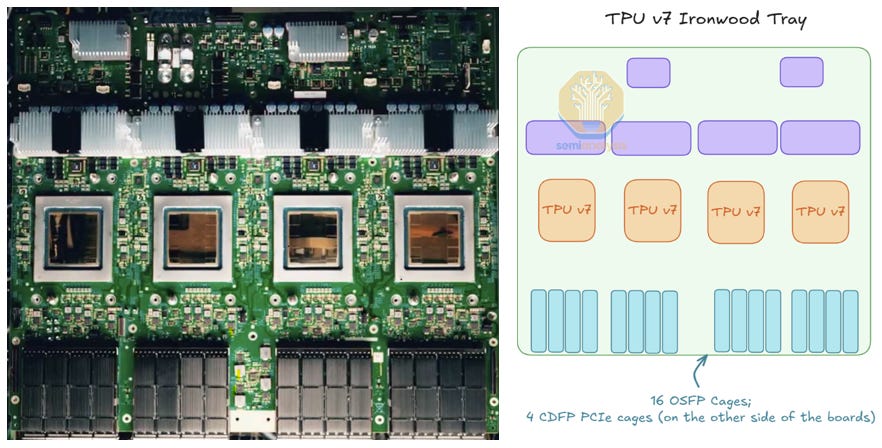
Ironwood TPU 的伺服器托盤(Tray)設計,其硬體規格簡述如下:
Source: Google, SemiAnalysis
運算配置
每張托盤搭載4 顆 Ironwood TPU,這是構成 Google AI 超級電腦的基本運算單元。
先進液冷系統 (Liquid Cooled)
全面覆蓋:冷卻迴路採用並聯水流 (Parallel water flow)設計,同時覆蓋 4 顆晶片以及VRs (電壓調節模組),確保供電與運算單元皆有效散熱。
正面冷卻TPU晶片,背面則利用並聯水路冷卻高功率的供電模組(VRM),以解決高密度算力帶來的供電熱問題,參考下圖。
動態調節:透過閥門 (Valve) 控制冷卻液流速,其運作概念類似於氣冷的「變頻風扇」,能根據負載需求提供更高效的冷卻效果。
高速互連介面
板外互連 (Off-board Interconnect):配備總共16 個 OSFP 連接器,用於連接外部的光學互連網路 (ICI)
主機通訊 (Host I/O):每顆 TPU 擁有獨立的PCIe Gen5 x16通道與主機溝通,連接位置位於板卡背面,4 個連接器(CDFP,Cool Dense Form factor Pluggable)位於電路板的另一面(背面)

Source: SemiAnalysis
1.6. IronWood Rack
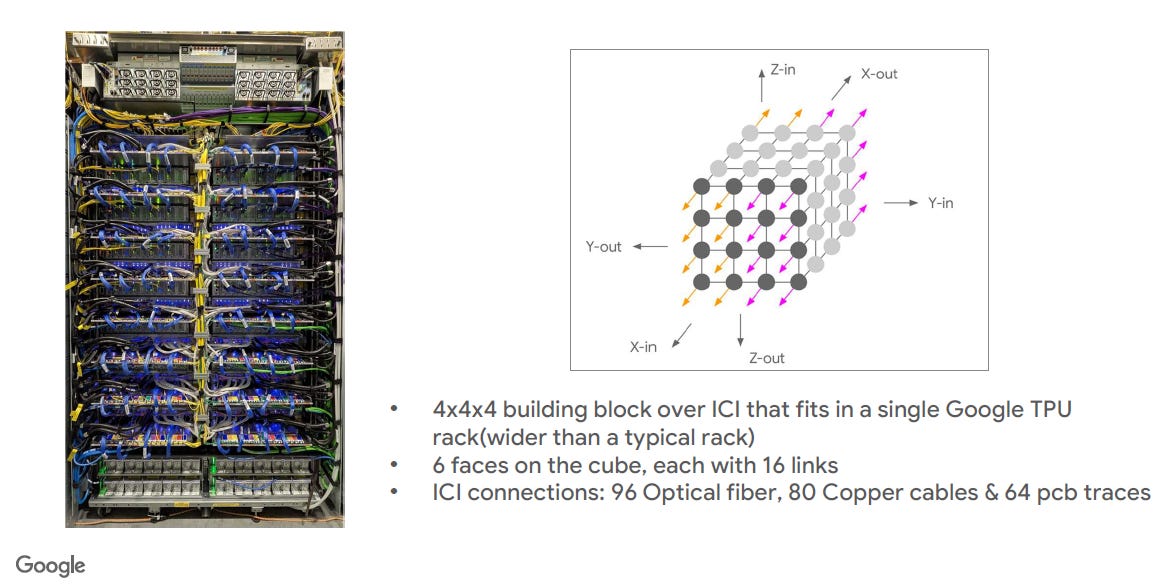
Ironwood Rack 是一個高度整合、專為液冷設計的 AI 運算機櫃。它是構成 TPU 叢集的基本物理積木(Building Block)(請參考EP15. The Hot Chip is a Rack介紹)

邏輯與物理架構
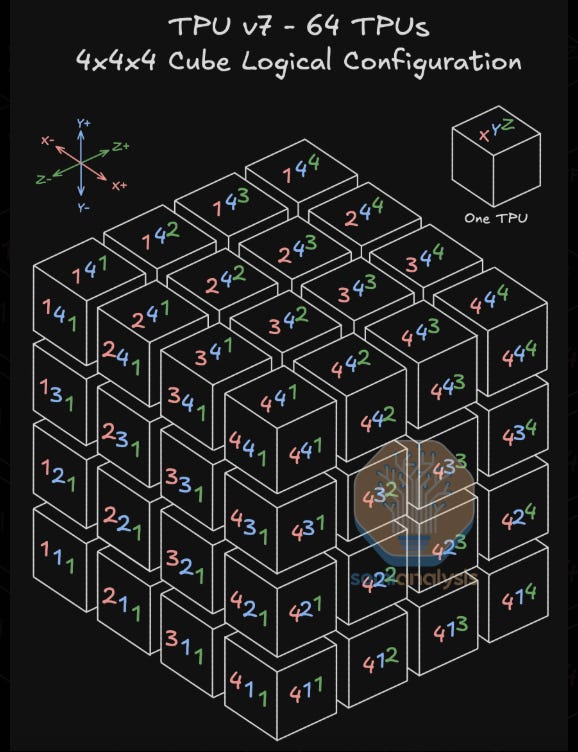
4x4x4 運算立方體:單一機櫃即容納了一個完整的4x4x4 Cube,包含64 顆 Ironwood TPU 晶片。
加寬機櫃設計:為了容納兩側複雜的液冷管路與大量纜線,該機櫃的寬度比一般典型機櫃更寬 (wider than a typical rack)
Source: SemiAnalysis
內部關鍵組件 (由上而下)
根據詳細標示圖,機櫃內部配置高度模組化:
頂部基礎設施:包含416V AC 輸入與整流器(供電)、ToR 交換器(網路管理)、以及光纖配線架 (Optical Patch Panels)(對外光學互連)。特別的是配置了上方集水盤 (Upper drip pan)以防止冷卻液洩漏波及設備。
運算區域:採TPU Tray與Host Tray(CPU 主機) 交錯配置。兩者之間透過外部的PCIe Cable進行連接(因為TPU 與 CPU 不在同一張主機板上)。
底部備援:配置了電池備援單元 (Battery Backup Unit),確保供電穩定性。
混合式 ICI 互連系統
為了在單一機櫃內實現 64 顆晶片的高速3D Torus互連,並對外連接至OCS,Ironwood Rack 採用了複雜的三級互連介質:
96 條光纖 (Optical fiber):用於連接機櫃外部的 OCS 光學交換機(Scale-up網路)(96 = 6面 x16 )
80 條銅纜 (Copper cables):用於機櫃內部或相鄰機櫃間的短距高速互連(80 = 144(=12x4x3) - 64)
64 條 PCB 走線 (PCB traces):用於極短距離的晶片間通訊(64 = 16(tray) x 2x2 on
TPU tray board)
Copper when you can; Optics when you must

Source: SemiAnalysis
ICR Router
ICI (Inter-Chip Interconnect) 中的 ICR Router是整個 Scale-up 網路的交通指揮中心。它的設計完全是為了服務3D Torus這種特定的網路拓撲。

ICR Router 核心功能簡介
3D Torus 交通樞紐:
在 3D Torus 網路架構中,每個 Ironwood 晶片都需要與其在 X, Y, Z 三個維度上的前後鄰居進行通訊,總計6 個方向。
ICR Router 負責將 Compute Die 產生的數據包導向這 6 個物理方向中的正確出口,對應於架構圖中的“6x Link stack”。
實現 Glueless Scale-up:
ICR Router 扮演了內建的超高效能交換機,使得數據包可以直接從一顆 TPU 路由到鄰近的 TPU,無需經過任何外部的電氣交換機。
它執行複雜的路由演算法(如維度排序路由),確保在數千顆晶片構成的 3D 網格中,數據傳輸的低延遲和無死鎖 (Deadlock-free)。
物理介面控制:
ICR Router 連接至“6x 112G SerDes octals”,這提供了極高的 I/O 吞吐量(總頻寬 1.2 TBps),負責將路由後的邏輯數據轉換為物理傳輸訊號。
它必須能夠在單一晶片內同時處理連接到PCB 走線、銅纜、光纖三種異質介質的流量,實現 Ironwood 機櫃內部的混合互連系統。
散熱系統
液冷歧管 (Liquid manifolds):機櫃右側配置了垂直的液冷管路,將冷卻液分送到每一層 TPU Tray 與 Host Tray
1.7 Ironwood SuperPod
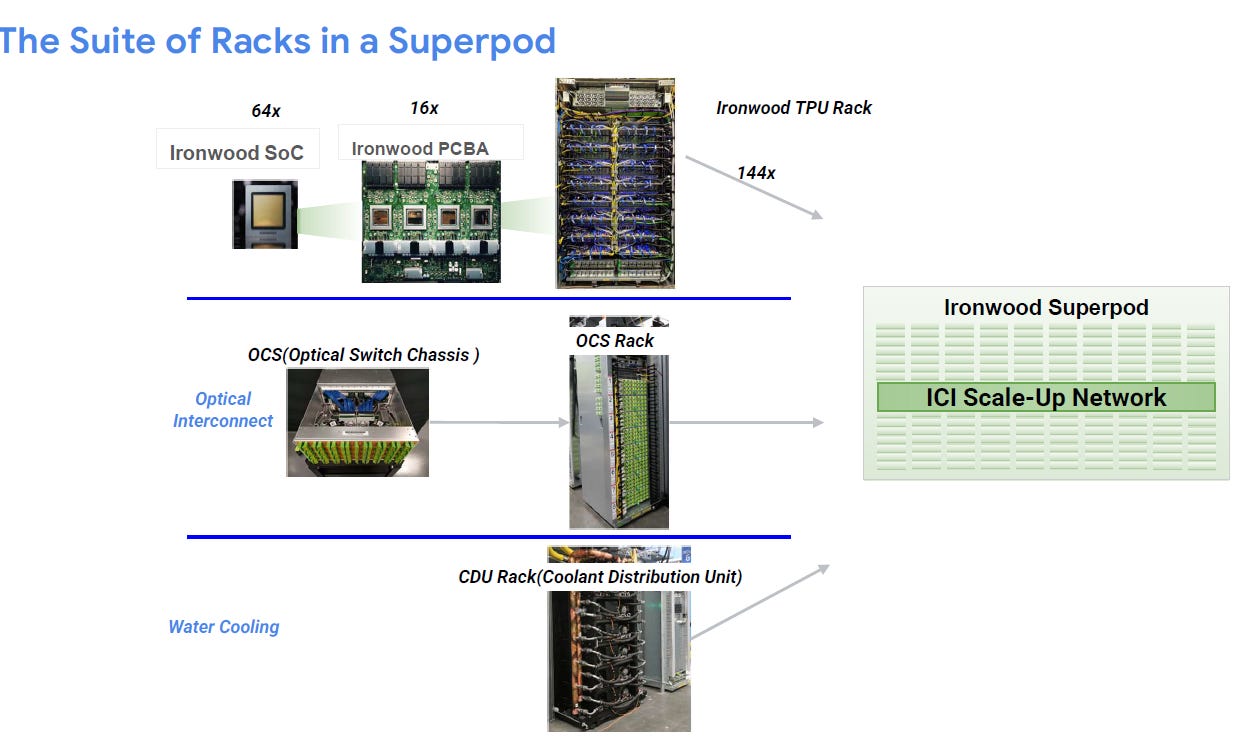
Ironwood Rack 是一個將電力、液冷、運算 (64 TPU) 與混合互連 (光/銅)高度壓縮在單一單元中的超級節點,144 個Racks 組成SuperPod(144x64 =9216TPUs),是 Google 建構Exa-scale AI算力的基礎單位。
2. Ironwood Scale-up Network
2.1. 網路拓撲 (Network Topology)

這張圖片展示了現代高效能運算 (HPC)和AI 資料中心中最常見的三大類網路拓撲 (Network Topology):
Hierarchical (階層式 / Clos, Fat-Tree)
概念:像公司的組織圖,層層上報。伺服器連到上層交換機,交換機再互連。
優點:效能最穩定。任意兩點之間的距離(跳數)是固定的,頻寬無阻塞 (Non-blocking)。
缺點:最貴。需要購買大量的交換機和光纖。
應用:目前主流的AI 資料中心(如 NVIDIA DGX SuperPOD),因為 AI 訓練需要極高且穩定的頻寬。
Direct-Connect (直連式 /Torus, Mesh)
概念:像棋盤或網格。電腦只跟隔壁的電腦手牽手,沒有中央大交換機。
優點:成本較低。省去了昂貴的中央交換機,利用運算節點本身來轉發封包。
缺點:長距離傳輸慢。如果資料要從網格左上角傳到右下角,要經過很多站,延遲高。
應用:傳統科學運算的超級電腦,或特定的 AI 加速器叢集 (如早期的 Google TPU)。
Hybrid (混合式 / Dragonfly)
概念:兩者的折衷。將節點分成很多「小組」,組內全互連,組跟組之間再拉幾條直連線。
優點:效率最高。試圖用最少的線材,讓全網任意兩點的距離都在 3 跳以內。
缺點:控制最複雜。需要非常聰明的演算法來避免塞車。
應用:次世代 Exascale (百億億次) 等級的超級電腦。
2.2 NVL72 Scale-Up Network
針對 NVL72 的拓撲架構,簡述如下:
Source: Nvidia
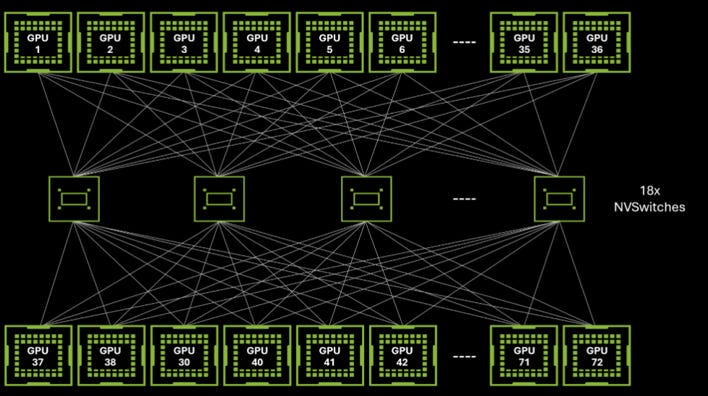
分類定義:它不是 Clos (多層),而是「單層交換架構」 (Single-Stage Switch Fabric)
物理連接:72 顆 GPU直接連接至中央的 18 顆 NVSwitch,中間沒有任何其他層級
邏輯效果:達成「全互連」 (Full-Mesh)的效果。任意兩顆 GPU 溝通只需要經過中間那一層 Switch,路徑極短 (1-Hop)
最終目的:透過這種暴力直連,讓 72 顆 GPU 在軟體看來就像「單一顆擁有巨大算力的超級 GPU」
簡單說:它把傳統網路「壓扁」成一層,用最直接的方式實現最高速的互連
2.3. 3D Torus Network
針對Ironwood架構,其Scale-Up網路設計簡述如下:
核心拓撲:
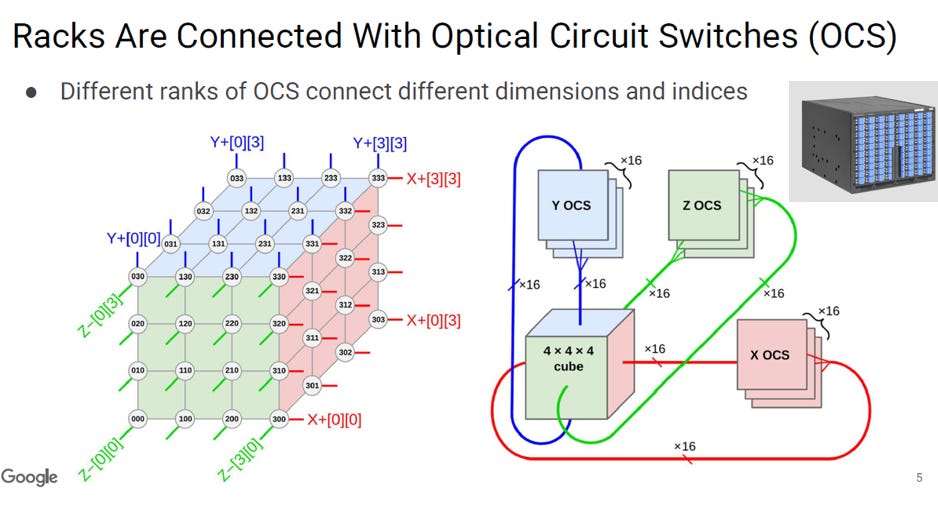
基於3D Torus結構,但改用OCS (光路交換器)進行動態連接,取代傳統的固定光纖佈線。
基本單元:
以4x4x4 Cube (64 顆 TPU,Rack)為基礎,利用OCS分別處理 X、Y、Z 三個維度的互連。
從圖中可知,所需OCS數目為: 3 (X,Y,Z)x 16 =48,規格至少是144 x 144 (144 Racks)
OCS 的關鍵作用:
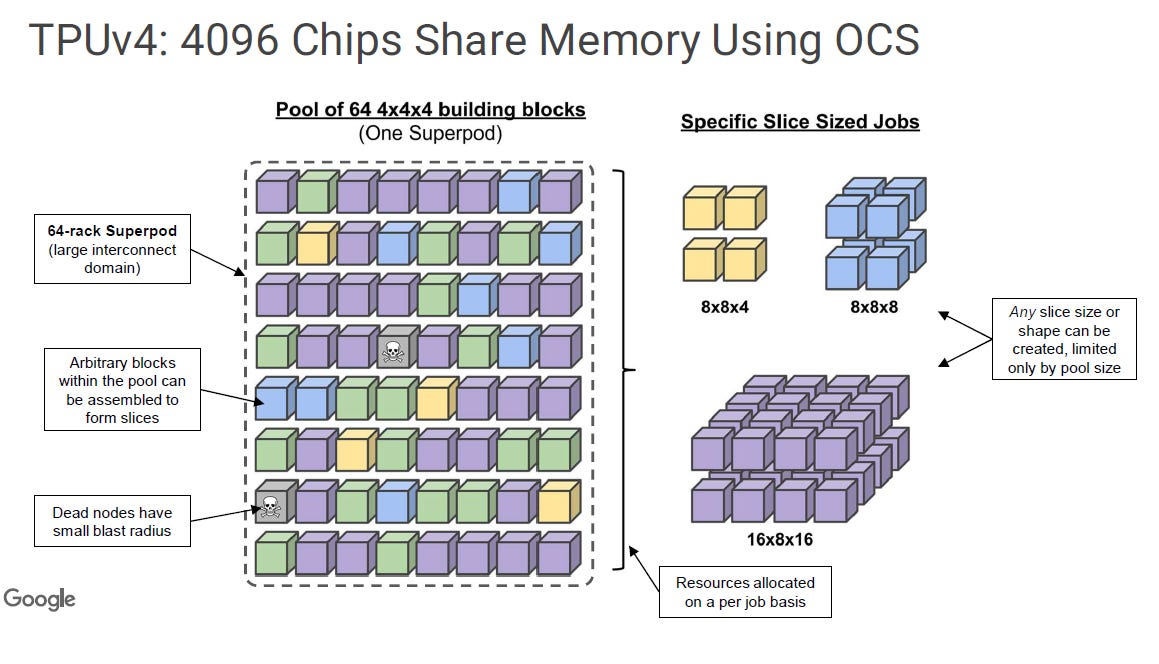
積木化資源池 (Pooling):系統將大量的 TPU 預先組建成標準的4x4x4 Cube (立方體積木),形成一個巨大的共享資源池。
按需動態組網 (Dynamic Slicing):軟體可根據不同任務的需求,指令 OCS 靈活地抓取積木,瞬間組合成各種形狀的 3D Torus 網路(例如8x8x4的小切片、8x8x8的中切片,或16x8x16的大切片)。
靈活避開故障 (Fault Tolerance):當資源池中出現壞掉的節點 (Dead nodes)時,軟體能直接指示 OCS 「跳過」這些故障積木,只連接健康的積木,確保大運算任務不受單點故障影響。
總結:
Ironwood 利用 OCS 將傳統「僵化」的 3D Torus 轉變為高彈性、高容錯且低延遲的現代 AI 超級電腦網路
2.4. BiDi Optics
BiDi Optics (雙向光學)與OCS (光路交換器)的結合被視為擴展 AI 算力的最佳組合,簡述如下:
BiDi 的核心貢獻 (減少線纜):
傳統光學需要兩根光纖 (一收一發),而 BiDi 技術利用波分複用 (WDM) 讓光訊號在單一光纖內雙向傳輸。
這將所需的光纖數量直接砍半 (50%),解決了大規模叢集中「光纖多到塞不下」的物理瓶頸。

Source: Broadcom
硬體層面的A/B分組(以Broadcom slide舉例說明)
Broadcom 的 12.8T Bi-di 光引擎已經在硬體設計上,將端口預設分成了兩組:
Group A:上半部 32 對光纖 (發 λ1, 收 λ2)。
Group B:下半部 32 對光纖 (發 λ2, 收 λ1)。
Group A只能接Group B
OCS 的核心貢獻
OCS 接收這些減量後的 BiDi 光訊號,透過MEMS鏡片進行交叉連接 (Dynamic cross-connects)自動配對

BiDi 技術有Group A / Group B的波長配對需求( λ1vs. λ2)
傳統痛點:如果沒有 OCS,您必須小心翼翼地確保「OSFP A」去連「OSFP B」。如果拿到兩個都是 Type A 的模組,直接對接會失敗。
OCS 解法:OCS 內部的Cross-connect (交叉連接)功能消除了這個煩惱。
當兩個一模一樣的 OSFP (都是 Group A) 連接時,OCS 會將光路設定為N-S 交叉。
左邊 Link 1 (N)連去右邊 Link 2 (S)。
左邊 Link 2 (S)連去右邊 Link 1 (N)。
結果:使用者完全不用管模組是 A 還是 B,OCS 讓兩個相同的模組也能順暢通訊
800G OSFP module for Ironwood
BiDi 架構中 ,它們使用的是雙波長 (Dual Wavelength, 1270/1310nm)的 100G PAM4 技術。
更精確的說法是:“800G OSFP (2x400G BiDi) with 1270/1310nm 4-λwavelengths”。

Source: Google
2.5. Scale-Out Network

Source: Google
Scale Up (向上擴展):變大算力
這是Ironwood Superpod 內部(144 Racks)的網路,目的是讓9216顆 TPU 晶片透過高速互連,運作得像「一顆巨大的虛擬晶片」。
核心技術 (OCS):採用光路交換機 (Optical Circuit Switch, OCS)。
連接介面:ICI (Inter-Chip Interconnect),這是 Google 專有的晶片間互連協定。
網路拓撲:3D Torus。圖中顯示利用 X、Y、Z 三個維度的 OCS 來連接 64-chip Racks,形成極低延遲的立體光學網狀結構。
用途:處理Intra-Superpod Computation(Superpod 內部的運算),承載 AI 模型訓練中最密集的參數交換流量。
Scale Out (向外擴展):變多節點
這是Superpod 之間以及連接外部資源的網路,目的是將多個 Superpod 串聯成一個超大規模叢集。
核心技術 (EPS):採用傳統的Data Center Scale-Out Network,通常由電封包交換機 (EPS, Electrical Packet Switch)組成。
連接介面:標準的NIC (Network Interface Cards),走乙太網路協定。
用途:
Inter-Superpod Computation:跨 Superpod 的分散式運算。
Data Ingestion & Storage:從儲存設備讀取龐大的訓練資料。
總結
Ironwood架構完美體現了「內光外電」的分工:
內層 (Scale Up/OCS):用光(BiDi + OCS) 解決高密度、低延遲的晶片直連問題。
外層 (Scale Out/EPS):用電(Ethernet) 解決大規模資料傳輸與儲存存取的通用相容性問題。
註: 嚴格說Scale Up,同一機櫃的TPU,還是用Copper相連(80 條銅纜,64 條 PCB 走線)。還是那句話: "Copper when you can; Optics when you need”
3. OCS(Optical Cicurit Switch)
OCS 的核心技術(如 MEMS, LCoS)源自電信領域成熟的 WSS(Wavelength Selective Switch) 與 OXC(Optical Cross-Connect) 設備,近年是為了突破 AI 算力擴充面臨的「功耗牆」瓶頸,才被大規模轉用於資料中心網路。
3.1. OCS vs. EPS(Electrical Packet Switch)
在Scale-up(大規模 AI/HPC 運算) 場景下,EPS 與 OCS 的核心差異簡述如下:

核心機制與代價:
EPS (電交換):走O/E/O (光轉電轉光)路線。需逐個檢查封包,靈活性高,切換速度極快,納秒級 (ns),但在超高速 (800G/1.6T) 下,晶片功耗與發熱極大,是擴展的瓶頸。
OCS (光交換):走O/O/O (全光直通)路線。如同一面可轉動的鏡子,不耗電解碼,切換速度較慢,毫秒級 (ms)(受限於 MEMS 鏡片轉動的物理時間。具備極低功耗與零抖動延遲的優勢。
未來兼容性 (Future-proof):
EPS:升級速率(如 400G 升 800G)通常需更換整台交換機。
OCS:對速率與協議透明。升級時只需換終端模組,中間的光開關無需更換,長期成本低。
應用結論:
EPS適合處理碎、亂、快的突發流量(如伺服器接入層)。
OCS適合處理AI 訓練中巨大且穩定的資料流(Elephant Flows),是解決超大規模叢集「功耗牆」與「延遲問題」的關鍵技術。OCS設好基本上就不動,直到下一個任務。
總結:
Scale-up趨勢是用EPS做靈活接入,用OCS做大頻寬、低功耗的核心骨幹傳輸。
3.2. OCS技術分類
OCS 技術主要依據「物理切換機制」分為以下四大類,其特性簡述如下:


MEMS (微機電系統):目前的主流選擇
原理:利用微小鏡片轉動反射光線。
特點:技術最成熟,平衡了埠數與速度(約 10~30ms),是 Google TPU 與 Lumentum 等廠商的首選方案。
Liquid Crystal (液晶):強調高可靠性
原理:利用電壓改變液晶排列來控制光路,無可動部件。
特點:耐用度高,切換速度約 10~50ms,代表廠商為 Coherent。
Robotic (機械手臂):強調超低損耗與擴充性
原理:像機器人一樣物理移動光纖接頭。
特點:幾乎零損耗且可擴充至數千埠,但切換極慢(秒至分鐘級),適合不常變動的架構。代表廠商為 Telescent。
Si Photonic (矽光子): 下一代技術
矽光子 (SiPh) OCS 被定位為 下一代技術,旨在將切換速度從毫秒級 (ms) 提升至微秒級 (µs),以應對突發流量 (Bursty traffic),主要相關廠商簡述如下:
iPronics
技術:基於 Mach-Zehnder 干涉儀 (MZI) 的可編程矽光子技術 。
規格:切換速度< 300 µs,可選用光放大器 (SOA) 實現無損傳輸 。
狀態:正送樣ONE-32(32x32 埠) 產品,目標是取代機櫃內的 NVLink 電交換機
nEye Systems
技術:混合架構,使用2D MEMS驅動配合矽光子耦合器 (SiPh coupler)進行交換 。
規格:切換速度< 10 µs。
亮點:獲得Nvidia、Google (Capital G)與Microsoft (M12)的戰略投資,並已展示 64x64 原型機 。
Oriole Networks
技術:使用被動陣列波導 (Passive Arrayed Waveguides) 與快速波長傳輸元件 。
規格:達到100 ns的極速切換,可處理確定性與突發性流量
3.3. Google Palomar OCS (MEMS based)
Google OCS (代號 Palomar,用於TPU v4, v5p) 的核心工作原理簡述如下:

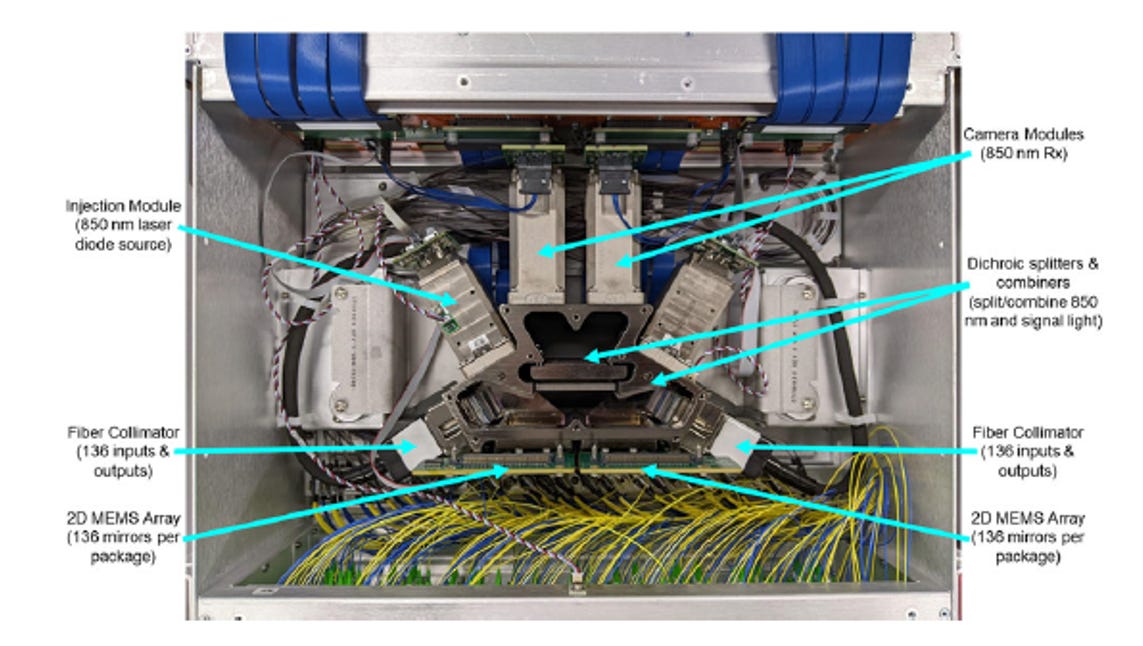
Source: Google
2D MEMS 反射技術:系統利用兩組微米級的鏡片陣列(各136片),在自由空間中將光訊號從輸入端精確反射至輸出端,實現全光交換。
雙波長主動校準 (關鍵創新):為了防止微鏡片因震動或溫度而跑位,系統將不可見的訊號光 (O-band)與可見的監控光 (850nm)混合傳輸。
閉環控制 (Closed-loop control):內建相機 (Camera)持續追蹤 850nm 監控光點的位置,一旦偵測到偏差,系統會即時微調鏡片角度,確保連線永遠精確對準
就像一個自動化的光學撞球台,利用850nm 雷射瞄準器與攝影機來輔助 MEMS 鏡片,確保每次反射都能「精確進洞」
註: TPU v7 應該採用 OCS大廠Lumentum的R300 (320+ 埠)。代表 Google OCS 正式從「實驗室自研」畢業,轉入「工業標準件」時代。
4. 補充說明
4.1. Gemini 3的需求
硬體: Ironwood
Ironwood的硬體設計與Gemini 3(Sparse MoE Transformer)之間呈現極為緊密的「軟硬體協同設計 (Hardware-Software Co-design)」關係。簡單來說,Ironwood 是 Google 為了讓 Gemini 3 這類超大規模稀疏模型能高效運行而量身打造的物理載具。
以下是兩者的對應關係簡述:
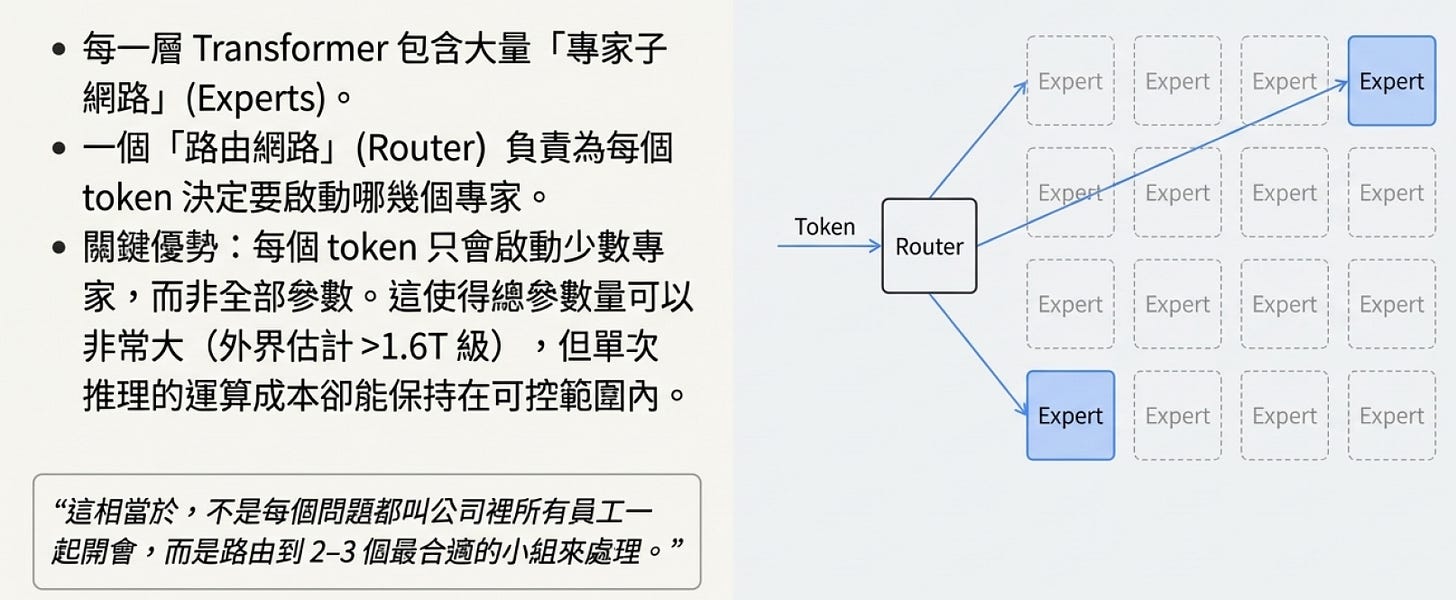
稀疏運算引擎 (Sparse Compute Engines) 對應 MoE 架構
軟體需求 (Gemini 3):採用 Mixture of Experts (MoE) 架構,其特性是「稀疏性」——處理數據時不需啟動整個大腦,只需調用一小部分相關的「專家 (Experts)」。
硬體解法 (Ironwood):架構圖中特有的Sparse Compute Engines與Sparse Core即是為此而生。這些硬體單元能略過無效的零值運算,或高效執行 MoE 所需的動態路由 (Routing) 與權重調度,解決了傳統密集運算單元處理稀疏數據效率低落的問題。
極致頻寬 (HBM3E) 對應海量參數存取
軟體需求 (Gemini 3):MoE 模型的總參數量通常是天文數字(達數兆級(T)),雖然運算量稀疏,但從記憶體中「撈取」正確專家的權重需要極大的頻寬
硬體解法 (Ironwood):Ironwood 配備頻寬高達7.4 TBps的 HBM3E,是前代的2.6倍,確保當模型決定呼叫某個專家時,硬體能瞬間提供所需的權重數據。
雙晶粒 (Dual Die) 對應模型並行
軟體需求 (Gemini 3):模型過大,無法放入單一晶片。
硬體解法 (Ironwood):透過雙運算晶粒 (Dual Compute Die)增加單封裝內的算力密度,並結合可擴展至9216 顆晶片的ICI互連,支援超大規模的模型並行 (Model Parallelism) 訓練與推論。
軟體: Pathways
由 Dense Model 演進至 Sparse MoE Model,Pathways之所以成為「必要條件」

演進背景:算力牆的突破
Dense Models (稠密模型):參數量與計算量呈線性關係。要模型變聰明(參數變大),算力與電力就得等比例暴增,這在物理上已不可持續。
Sparse MoE (稀疏模型):透過「條件式計算」,每次僅啟用少數「專家(Experts)」。實現了參數量極大化(兆級),但單次推論成本極小化。
核心衝突:軟體的「動」 vs. 硬體的「靜」
MoE 的代價是產生了大量動態、隨數據變化(Data-Dependent)的路由需求。
這與 Google 底層硬體(OCS + 3D Torus)擅長處理靜態、可預測流量的特性發生了根本衝突。若無中間層協調,網路效率將崩盤
Pathways 的必要性:
唯一的協調者 Pathways 是連接這兩個世界的橋樑,其核心價值在於:
馴化隨機性:它利用GSPMD技術,將 MoE 混亂的動態通訊需求,編譯成硬體能理解的規律模式。
單一系統視角:摒棄傳統 MPI(Message Passing Interface) 多程序溝通模式,將數萬顆 TPU 視為「單一邏輯裝置」進行全域優化。
隱藏延遲:透過非同步調度(Asynchronous Dispatch),讓計算與通訊完美重疊,掩蓋掉 MoE 頻繁跨節點搬運數據的時間成本。
沒有Pathways的軟體調度,Google 的 MoE 模型就無法在 SuperPod上高效跑起來。它是將「動態演算法」成功映射到「靜態硬體」的關鍵編譯層
4.2. 個人觀點
在 AI Scale-Up 的場景下,「可預測性(Predictability)」大於「靈活性(Flexibility)」
流量特徵決定架構:AI 訓練 vs. 網際網路流量
傳統網路(EPS 適用場景):流量是突發的(Bursty)、隨機的,來源和目的地不斷變化(如 Web 搜尋、雲端服務)。因此需要每封包路由(Per-packet routing)來應對不確定性。
AI Scale-Up(OCS 適用場景):大型模型訓練(LLM Training)的通訊模式是確定性(Deterministic)的。
當Pathways編譯好一個模型的訓練任務時,它已經知道每一個 TPU 晶片在每一個時間點需要跟誰交換數據(通常是 All-Reduce 或 All-to-All 模式)。
既然流量模式已知且固定持續一段時間(數秒到數天),我們就不需要在交換機層級浪費算力去檢查每一個封包的 Header。但ICI Router 還是會檢查,確定資料的流向。
省電的物理本質:OCS vs. EPS
EPS (Electronic Packet Switching):為了轉發數據,交換機必須進行O-E-O 轉換(光轉電 -> 處理/緩衝/路由 -> 電轉光)。
隨著頻寬增加(400G, 800G, 1.6T),SerDes(序列化/解序列化)和 DSP 的功耗呈現指數級上升。這就是所謂的「光電轉換懲罰」。
OCS (Optical Circuit Switch):它是純光學的(MEMS 鏡片反射)。
被動傳輸:光子直接通過鏡片反射,中間沒有任何信號處理或重定時(Retiming)。
功耗極低:OCS 的功耗主要來自於維持鏡片角度的靜電驅動,與傳輸的資料量(Bandwidth)無關。無論是傳 10G 還是 800G,OCS 的功耗幾乎不變。
結論:如果 Source 和 Destination 在一段時間內不變,使用 EPS 就像是「為了過一條固定的直路,卻在每個路口都設一個交通警察檢查證件」;而 OCS 則是直接「架設一條封閉的高架橋」。
Topology: 3D Torus 與 Pathways 的協同
「Pathway 最佳規劃」與「減少 Hop」是 OCS 架構帶來的最大紅利,這也就是 Google 所謂的“Twisted Torus” (扭曲環面)概念
傳統 Torus:機櫃 A 只能連到物理上相鄰的機櫃 B。如果要從 A 傳到遠處的 Z,必須經過 B, C, D... 多次 Hop
OCS 賦能的 Torus:透過 OCS,機櫃 A 可以「光學直連」到物理上很遠的機櫃 Z。
Pathways的編譯器可以根據模型的需求,計算出最佳的鄰居關係(Logical Neighbors)。
減少 Hops:透過這種「蟲洞(Wormhole)」般的連接,網路直徑(Network Diameter)被大幅壓縮,長尾延遲(Tail Latency)顯著降低。
潛在的權衡 (Trade-off)
雖然OCS + 3D Torus在Scale-Up效率極高,但也有其侷限性(這也是為什麼 EPS based Scale-Up 仍然流行的原因):
切換時間 (Switching Time):MEMS OCS 的切換速度是毫秒級(ms)甚至秒級,無法應對 packet-level 的突發流量。這就是為什麼它必須依賴 Pathways 的「預先規劃」。
軟體複雜度:這把複雜度從硬體(Switch ASIC)轉移到了軟體(Pathways/Compiler)。編譯器必須非常聰明,才能完美利用這種靜態拓撲。如果編譯器排程不好,效能會大打折扣。
結論
Google「軟體定義拓撲 (Software-Defined Topology)」的核心策略,將原本固定的硬體變成了可配合軟體變形的有機體:
Pathways (大腦 - 決策):它不只調度算力,還負責計算出「最適合當前 AI 模型的幾何形狀」。例如,它會判斷該模型適合跑在標準立方體 (16x16x16) 還是長條形 (4x4x256) 的 3D Torus 上,以獲得最佳並行效率。
OCS (身體 - 變形):接收指令後,OCS 進行物理層的光路重構。它將分散的機櫃在物理上連接成 Pathways 指定的形狀,創造出一個專屬、隔離且低延遲的「虛擬切片 (Virtual Slice)」
ICI Router (神經 - 傳輸):在已鋪設好的 3D Torus 網路上,Ironwood 的ICI Router執行極簡的維度路由 (Dimension-Ordered Routing)。因為物理連線已由 OCS 完美適配,Router 只需透過6x Link Stack高速轉發數據,無需處理複雜的擁塞控制,從而達成 Scale-up 的極致頻寬與效率。
4.3. Deterministic(確定性)
2025年底最熱門的話題:Nvidia 願意花 200 億美元去授權 Groq 技術並挖角其團隊
Groq 的創辦人Jonathan Ross是 GoogleTPU v1 的核心設計者。所以 Groq LPU(Language Processing Unit)的設計哲學,可以說是在 TPU 的基礎上,將「確定性(Deterministic )」這條路走到了極致。
Google TPU 的 Deterministic DNA
Google TPU 的設計核心思想一直都是:「軟體定義硬體 (Software-defined Hardware)」。
TPU 的作法 (System Level Determinism):Google 的Pathways(及其編譯器XLA) 會在訓練開始前,就把成千上萬顆 TPU 之間的通訊路徑算好。
OCS (Optical Circuit Switch):它建立的是「電路」(Circuit),就像以前的電話接線生把線插好一樣。一旦連上,這條光路就是你的專用通道,中間不需要像 Ethernet Switch (EPS) 那樣去檢查每一個 Packet 的 Header、排隊、轉發。
結果:在整個訓練過程中(可能長達數週),這條路徑是靜態 (Static)的。這就是為什麼 TPU Cluster 效率極高,因為它省去了EPS(Electronic Packet Switch)頻繁做 Packet Switching 的巨大開銷 (Overhead)。
Groq LPU:把 TPU 的邏輯「內化」到晶片內部
Groq 繼承了這個Deterministic DNA,但它發現 TPU 雖然解決了「晶片間」的通訊確定性,但「晶片內」還是有太多動態因素(如HBMcache miss, DRAM refresh 等)。
於是 Groq 做了更極端的決定:不僅網路要 Deterministic,在推理時晶片內部的每一個電子流動都要 Deterministic。
Groq 是 "TPU DNA" 的極端版?
TPU + OCS 架構,主要是為了解決"Throughput" (訓練超大模型)的問題,讓資料像水流一樣穩定流動。Jonathan Ross 把這個「靜態規劃」的哲學拿來解決"Latency" (推論速度)的問題:
TPU 的遺憾:雖然 TPU 用了 OCS,但它還是使用 HBM (High Bandwidth Memory)。HBM 本身有物理上的延遲和不確定性(Off-chip memory access)。
Groq 的進化:為了達成在推理時絕對的 Determinism,Groq砍掉了 HBM,全部改用SRAM。這樣一來,它就不僅是「網路路徑」確定了,連「記憶體存取時間」都精確到 nanosecond (奈秒) 級別。
TPU 用 OCS + Pathways 消除了「網路層」的 Packet Switching 不確定性;Groq LPU用 Compiler + SRAM在推理時消除了「晶片層」的 Memory/Cache 不確定性。
這兩者背後的靈魂確實是同一個:「不要讓硬體在執行時做決定 (Runtime Decision),把所有的決定都在編譯時 (Compile time) 做完。」
[Reference]
•SemiAnalysis TPUv7: Google Takes a Swing at the King
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


