在EP23 提到了Slow & Wide的光互連方式,剛好手邊有些相關資料,整理個人心得分享,歡迎討論。
在EP23 提到了Slow & Wide的光互連方式,剛好手邊有些相關資料,整理個人心得分享,歡迎討論。
- Source: Ted Yu
- Published: 2025-11-13T07:23:50+08:00
- URL: https://ytyuted.substack.com/p/ep24-microled-interconnect EP24. MicroLED Interconnect - Ted Yu
Pledge your support

EP24. MicroLED Interconnect

Nov 13, 2025
在EP23 提到了Slow & Wide的光互連方式,剛好手邊有些相關資料,整理個人心得分享,歡迎討論。
1. MicroLED 互連簡介
1.1. 光學互連
微軟 Azure將光學互連分為三個區塊:
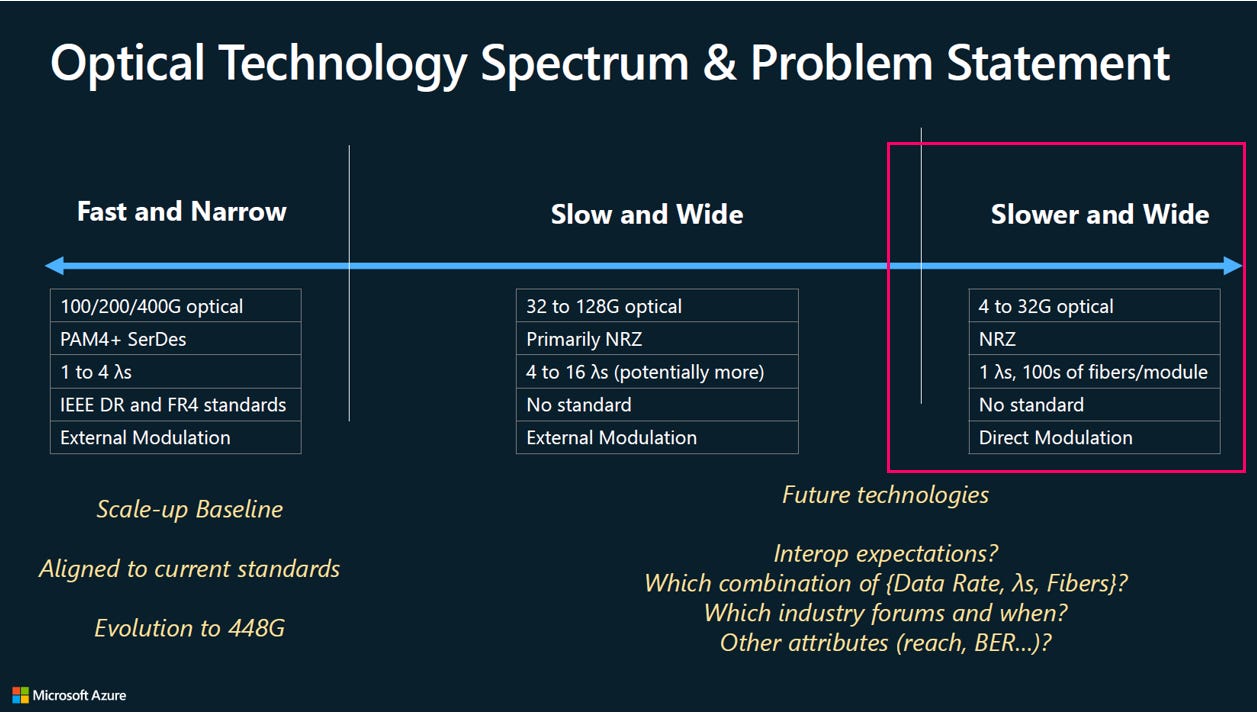
快而窄 (Fast and Narrow):屬於目前的「擴展基線」(主流路線),採用PAM4技術和1 到 多個波長,速率為 100G 到400G/波長,與現行標準對齊。參考EP23. 448G SerDes介紹。
慢而寬 (Slow and Wide):屬於WDM的技術,採用 NRZ 和4 到 16 個(更多)波長,速率為 32G 到 128G/波長。CPO會採用,有空再介紹。
更慢而寬 (Slower and Wide):屬於另一技術,採用 NRZ 和單一波長,但特點是搭配數百根光纖,速率較低(4G 到 32G),並使用直接調變。光源會使用MicroLED。
核心問題在於探討未來光學互連應如何權衡資料速率、波長和光纖數的最佳組合
目前開發Slower&Wide 或MicroLED互連的新創公司有Avicena,Hyperlume(Credonow) 和 微軟研究院的MOSIAC。Avicena和MOSIAC的技術類似,本報告以這兩家的資料為主。
註: 關於直接調變和間接調變,請參考EP3. SiPH - Modulation介紹。
1.2. 短距離互連
EP22. Interconnect Meida有提到Kyber(NVL576)的架構:

集中式瓶頸:Narrow & Fast (Copper)
架構與技術:集中式的高性能互連(如 NVIDIA Kyber/NVL576),依賴高帶寬的銅互連技術(Narrow & Fast)(400G/lane)。
問題:為了實現極致的Scale-up性能,所有組件被高度集中在一個或幾個機櫃內。這種密度導致了極高的功耗密度 (600KW) (Mt. Diablo架構)
結果:高功耗密度直接造成嚴重的散熱 (Thermal)挑戰和供電 (Power)壓力,限制了 AI 叢集規模的進一步擴展。
分散式解決方案:Wide & Slow (Optics)
核心觀點:如果互連技術(如 Slower & Wide 概念)能夠滿足 Scale-up 的要求,就可以採用分散式 (Distributed)架構。
方法:透過使用低功耗、可長距離傳輸的「Wide & Slow」互連技術,將運算單元(如 GPU)分散到多個機架上(Multi-Racks / NVL36 配置)
效益:1.解決功耗瓶頸:將總體功耗分攤開來,大幅降低單一機架的功耗密度 ( < 50KW/rack)。 2.解決散熱瓶頸:降低了單一機櫃內的熱量集中度,使現有的資料中心散熱系統能夠有效處理,解決了 Thermal 問題
總結來說:採用分散式架構並搭配Wide & Slow的低功耗互連,是打破集中式架構在散熱和供電上限制,同時仍滿足大規模 Scale-up 性能需求的關鍵路徑
註: 「Wide & Slow」分散式方法能解決散熱與功耗問題的基礎,在於該互連技術必須先滿足集中式架構對 Scale-up 性能(高頻寬、低延遲)的要求
1.3. 微軟MOSIAC的觀點
微軟認為 MOSAIC 是一種理想的短距離互連解決方案。它能在50 米以內的距離(適用於連接約 1,000 個 GPU 的大型叢集)實現銅線的低功耗、低成本和高可靠性,從而解決了在數據中心內部擴展高性能計算時面臨的關鍵瓶頸。
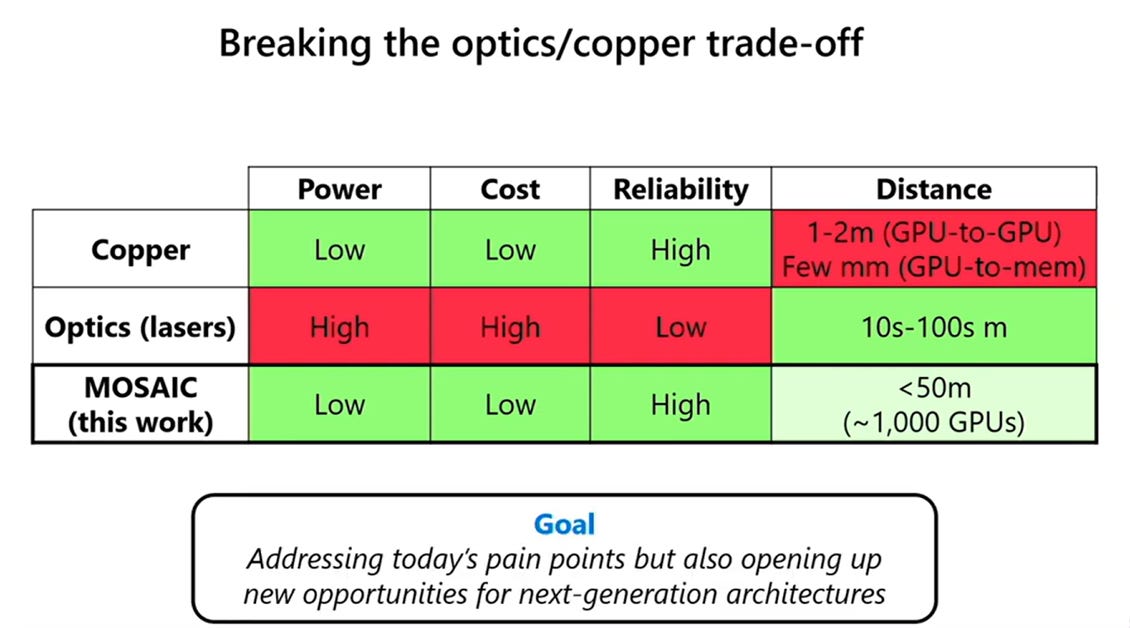
Narrow-and-Fast (窄而快)」架構面臨的「詛咒」是:
銅線:速度越高,訊號損耗越大,導致傳輸距離急劇縮短(如 800 Gbps 時距離小於 5 米)。
光學:速度越高,需要越耗電的雷射和複雜的電子元件 (DSP),導致功耗暴增(如 800 Gbps 時功耗接近 25 瓦)。

總結:此架構以犧牲銅線距離和光學功耗為代價來換取高速度。
MOSAIC:Wide-and-slow (寬而慢) 的救援:
MOSAIC 採用「Wide-and-slow (寬而慢)」的解決方案,利用多通道、低速度的原理(如 400x2 Gbps),避開高速互連的功耗瓶頸。

它使用microLED array(微型 LED 陣列),Imaging fiber (成像光纖)和相機感測器等元件,達成了低成本、低功耗、高可靠性的優勢,同時無需更改現有的 NIC/交換機基礎設施,可適用於Ethernet、NVLINK、CXL等任何協定。
1.4. MicroLED vs. Laser Diode(LD)
請參考EP9. Light Source介紹,這裡僅簡述。
發光物質
LED 和 LD 發光物質的選擇是基於其能隙 (Energy Gap),它決定了發光波長:
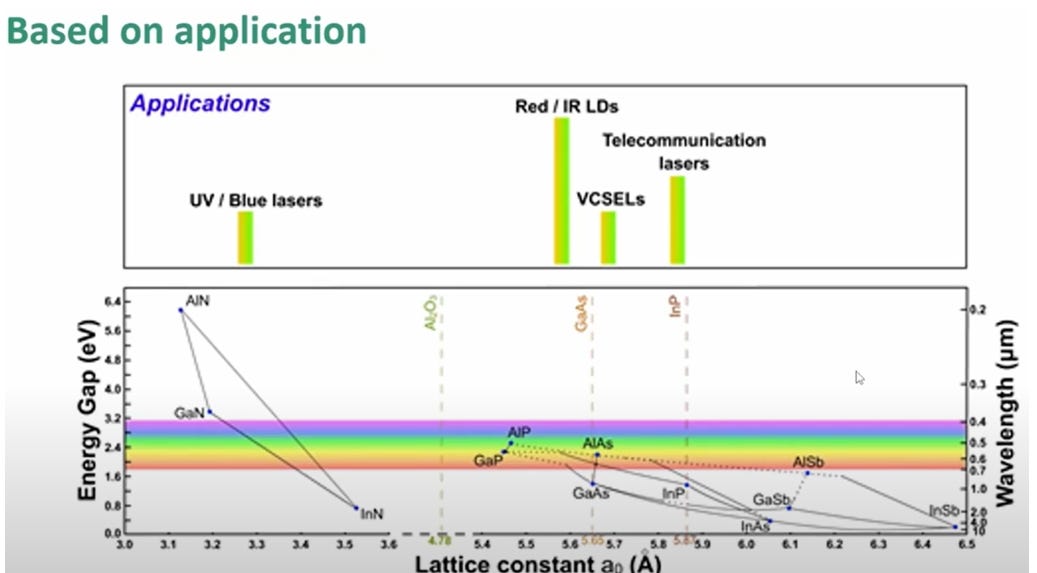
能隙高 (如 GaN):發射藍光或紫外光(短波長)。
能隙中等 (如 GaAs):發射紅光或近紅外光(中波長),常應用於 VCSELs。
能隙低 (如 InP 合金):發射光通訊所需波長(長波長)。
此外,材料的晶格常數必須與基板匹配,以確保高品質的磊晶生長。
發光原理
LD (雷射二極體) 和高效率 LED 的發光原理都基於核心的雙異質結 (Double Heterostructure, DH)結構,該結構能極大地提高發光效率:
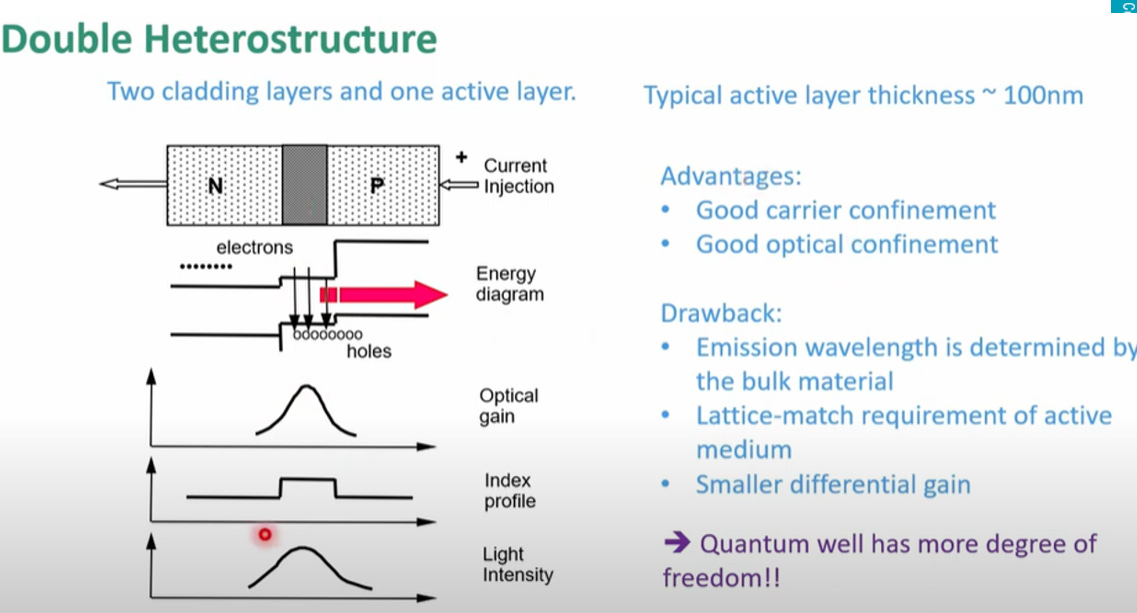
結構:由能隙較寬的包覆層夾著能隙較窄的活性層。
核心功能:實現了載流子限制(將電子和電洞限制在活性層)和光學限制(將光限制在活性層內傳播)。
發光:載流子在活性層內高效複合,產生光子(LED 為自發輻射,LD 為受激輻射)。
這種結構有效地實現了載流子限制和光學限制,是高效發光器件的基礎
LED 與 LD比較
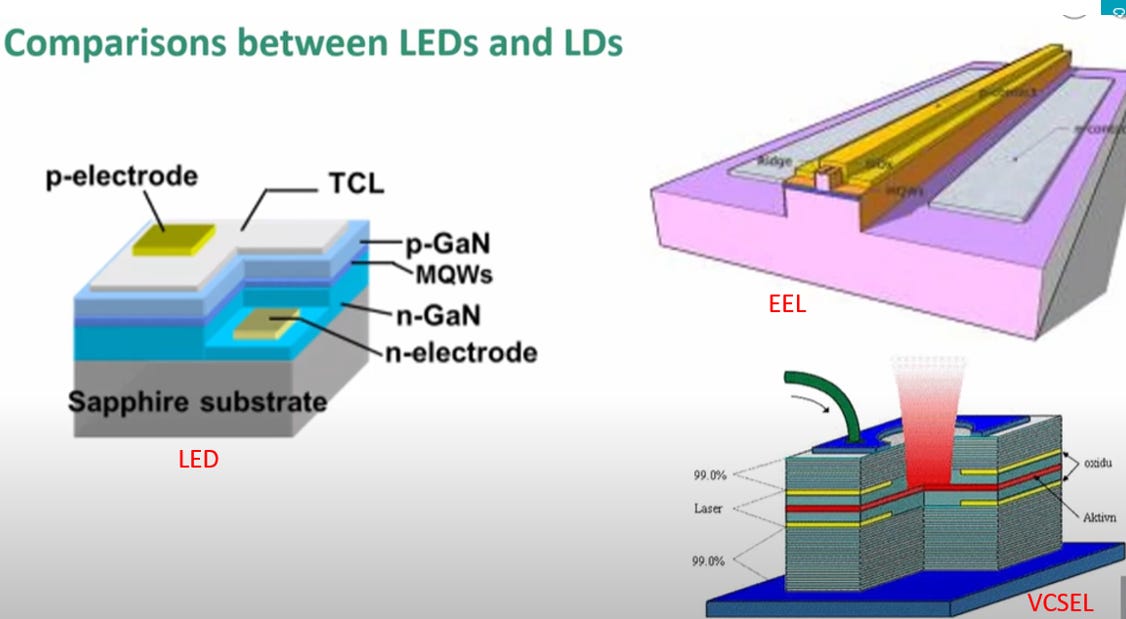
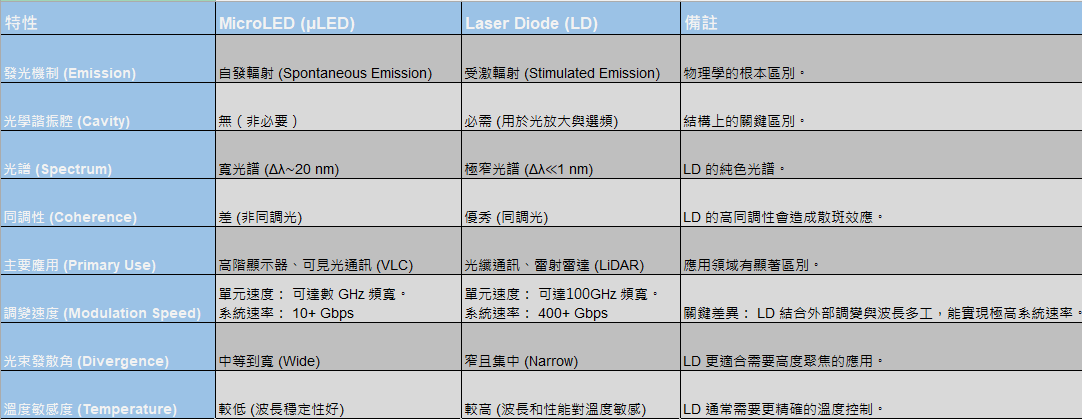
LD (EEL 和 VCSEL) 相比於 LED,關鍵在於擁有光學諧振腔,這使其能實現受激輻射,產生相干、高功率的雷射光。

MicroLED
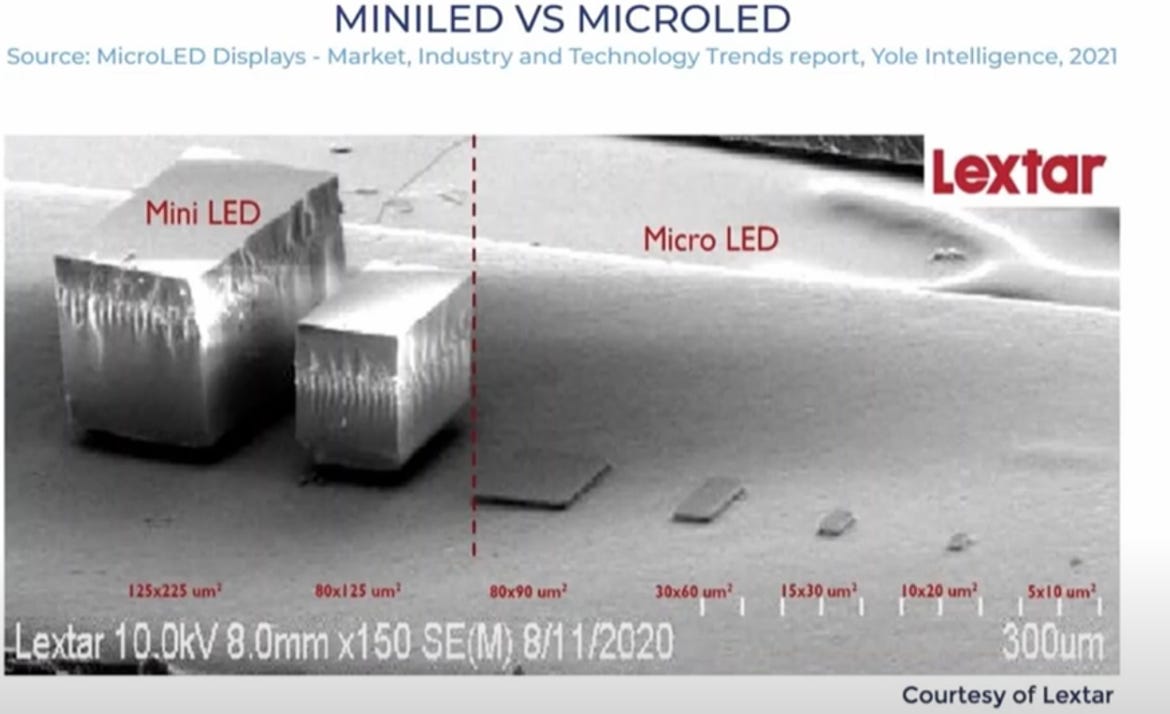
MicroLED 是一種微型發光二極體顯示技術,其核心特點是將傳統 LED 晶片做得極小化,通常定義為尺寸小於100 微米 (µm)的 LED 晶粒,甚至可小到5 微米。
主要優勢是:
自發光,具備超高亮度和無限對比度。
低功耗、長壽命
它被視為終極顯示技術,但目前面臨的主要挑戰是巨量轉移 (Mass Transfer)生產工藝。
2. Avicena LightBundle
2.1. LightBundle™ 簡介

LightBundle™ 的設計理念是將傳統高速串行傳輸轉變為大規模並行光學傳輸,主要組件包括:
µLED 陣列 (µLED Array):
作為發射端,由微型 LED 陣列組成
每個微 LED 晶粒都作為一個獨立的低速光學通道。
LightBundle IC / ASIC:
這是核心控制晶片,通常與主機 ASIC(如 CPU/GPU)集成在一起。
它負責將電訊號轉換為並行光訊號,並驅動 µLED 陣列發射
透鏡/準直光學元件 (Lensed Optics):
位於 µLED 陣列和 PD 陣列之間,用於將光訊號準直(collimation),確保光線能夠高效耦合。
光電二極體陣列 (Lensed PD Array):
作為接收端,與 µLED 陣列的幾何形狀對應。
接收到光訊號後,將光訊號轉換回電訊號。
光纖纜線 (Multicore Fiber Cable):
圖示中似乎採用了多芯光纖 (Multicore Fiber Cable),用來傳輸這些並行的光束
最終組裝 (Final Assembly):
所有的組件(Host ASIC、LightBundleIC、µLED/PD 陣列)最終被整合到一個緊湊的光學模組中,直接連接到光纖纜線。
LightBundle™ 藉由以下方式提高總帶寬:
低速傳輸:每個 µLED 通道都運行在相對低速(例如數 Gbps)。
大規模並行:晶片上集成數百甚至數千個這樣的低速通道,利用空間上的並行性來實現極高的總帶寬。
以下就主要關鍵技術介紹。
2.2.CROME
LightBundle™ 所使用的µLED 陣列是基於CROME (Cavity Reinforced Optical Micro Emitter)技術,並展示了其在高速數據傳輸方面的性能。

世界上最快的 LED
CROME 是一種經過優化的氮化鎵 (GaN)LED,利用藍光發射,能夠實現極高的調變帶寬 (Modulation Bandwidth)。
性能表現:
極速傳輸:CROME 被宣稱為「世界上最快的 LED」。
數據速率:目前數據速率可達10 Gbps/通道(需使用 6 dB 均衡補償高頻信號)。這對低速並行傳輸(Wide-and-slow)來說是極大的提升

調變帶寬 (Bandwidth) 與電流密度的關係(圖表分析):
圖表顯示了 CROME 裝置的 3 dB 電光 (EO) 帶寬與電流密度的關係,呈現出一個 U 形曲線,這反映了裝置在不同電流密度下的速度表現:
低電流密度區:裝置速度較快(帶寬上升)。這歸因於Coulombic effects(庫倫效應) 的複合機制。
高電流密度區 (J > 1 kA/cm²):裝置速度變得極快(帶寬急劇上升)。這是由於非輻射複合(如Auger 複合)增加所致。
技術優化策略:
尺寸微縮:圖表顯示,隨著 µLED 尺寸從 32 µm 減小到 4 µm,其最高調變帶寬顯著提高,證明微縮化是提升速度的關鍵。
效率與帶寬的取捨:CROME 可以權衡效率 (Efficiency)和調變帶寬 (Modulation BW)。例如,照明 LED 的效率可達 90%,這意味著 µLED 可以犧牲部分效率(轉化為熱量)來換取更高的調變速度。
10Gbps Case

這張圖表強調了µLED (微型 LED) 的速度已超過 10 Gbps,與傳統 LED 完全不同,並說明了達成高速傳輸所需的條件。
速度曲線分析 (3dB 頻率 vs. 電流密度)
左側的曲線圖展示了不同 µLED 裝置在不同電流密度 (Current Density) 下的 3dB 電光 (EO) 帶寬:
黑色曲線 (µLED on Si):這是轉移到矽基板上的 µLED 性能曲線。它在低電流密度時有一個速度低谷(可能受缺陷或電容影響),但在高電流密度下(約5000 A/cm²附近)帶寬顯著增加,表明其具備高速調變能力。
橙色曲線 (µLED on Sapphire):這是在藍寶石基板上的 µLED 性能,整體帶寬比轉移到矽上的高,但在高電流密度下的極速表現與矽上的類似。
紅色曲線 (Lighting wafer):這是傳統照明用 LED的性能曲線,其帶寬極低(遠低於 500 MHz),突顯了高速 µLED 與傳統 LED 的巨大差異。
達成 10 Gbps 的挑戰與解決方案
圖中右側的眼圖 (Eye Diagram) 證明了該 µLED 能夠實現10 Gbps的數據傳輸:
Nyquist 頻率:10 Gbps 的數據速率,其奈奎斯特 (Nyquist) 頻率為 5 GHz。
裝置限制:從左圖可見,µLED 的 3dB 帶寬曲線最高約在 3.5 GHz 至 4.0 GHz 之間。由於4 GHz 小於 5 GHz,這意味著µLED 本身在高頻處的響應會衰減
解決方案:為了成功傳輸 10 Gbps 訊號,需要額外的等化器 (Equalizer)。圖中註明使用了6 dB 的等化來增強高頻訊號,從而補償訊號在傳輸路徑和發射器本身的高頻損耗,使眼圖能夠清晰地開啟,確保數據的可靠傳輸
總結來說:轉移到矽基板上的 µLED 已經具備極高的速度潛力,但要達到 10 Gbps 的目標速率(對應 5 GHz 的 Nyquist 頻率),必須依賴高電流密度來驅動,並使用等化技術來克服其在 Nyquist 頻率附近的帶寬不足問題。
選擇GaN
CROME 選擇 GaN(氮化鎵)作為發光物質的主要原因有三點:
藍光發射 (Blue Light):GaN 是寬能隙材料,能發射藍光,適合光學互連,並有利於矽 PD吸收。
極致高速調變:透過將 GaN µLED 尺寸微縮並在高電流密度下驅動,能夠將載流子壽命縮到極短(Auger 複合),實現10 Gbps/通道的超高調變帶寬。
高溫穩定性:GaN 的寬能隙使其在高溫環境下仍能保持極低的洩漏電流,確保裝置在靠近運算晶片的高熱環境中可靠運作。

2.3 Si PDs
矽 PD 適合藍光偵測的原因
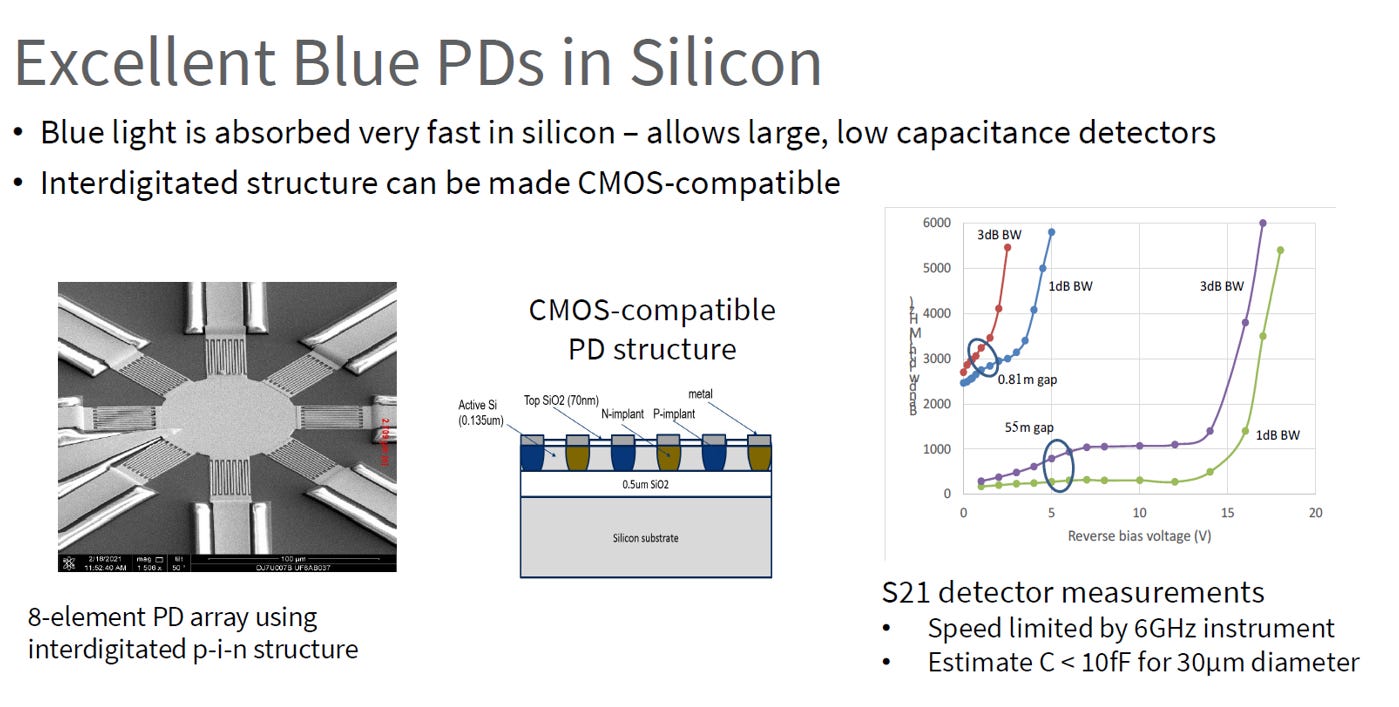
極速吸收:藍光 (Blue Light)由於波長短、能量高,在矽材料中吸收速度非常快,且吸收深度極淺(靠近表面)。
低電容設計:這種淺層吸收特性,使得設計者可以製造出面積大、但電容極低的光偵測器,這對提升速度至關重要。
CMOS 兼容的結構特點
為了實現高速度和高集成度,藍光 Si PD 採用了優化的結構:
交錯指狀 p-i-n 結構 (Interdigitated p-i-n structure):
圖中顯示偵測器採用了多個交錯排列的指狀電極。
這種設計能提供一個很大的光捕捉面積(有利於訊號),但同時能確保載流子(電子和電洞)只需要漂移很短的距離即可被收集,從而極大地降低了電容 (C < 10 fF),實現高頻率響應。
CMOS 兼容性:整個結構可以直接利用標準的CMOS 製程製造,這使得 Si PD 可以與處理器、驅動電路等電路實現單晶片集成 (Monolithic Integration)
效能表現
這種結構設計使得 Si PD 能夠實現極高的調變帶寬 (BW):
圖中的 S21 量測結果顯示,在高反向偏壓下,偵測器能達到極高的帶寬。
雖然量測受限於 6 GHz 的儀器帶寬,但其超低的電容證明了其具備偵測10 Gbps以上高速訊號的能力。
總結:這種 CMOS 兼容的交錯指狀 Si PD 結構,是利用藍光在矽中快速吸收的特性,實現了大偵測面積、低電容、高速度的完美結合,是 LightBundle / Wide-and-slow 光學互連解決方案中理想的接收端元件。
2.4 BoC(Bunch of Cores) Fiber
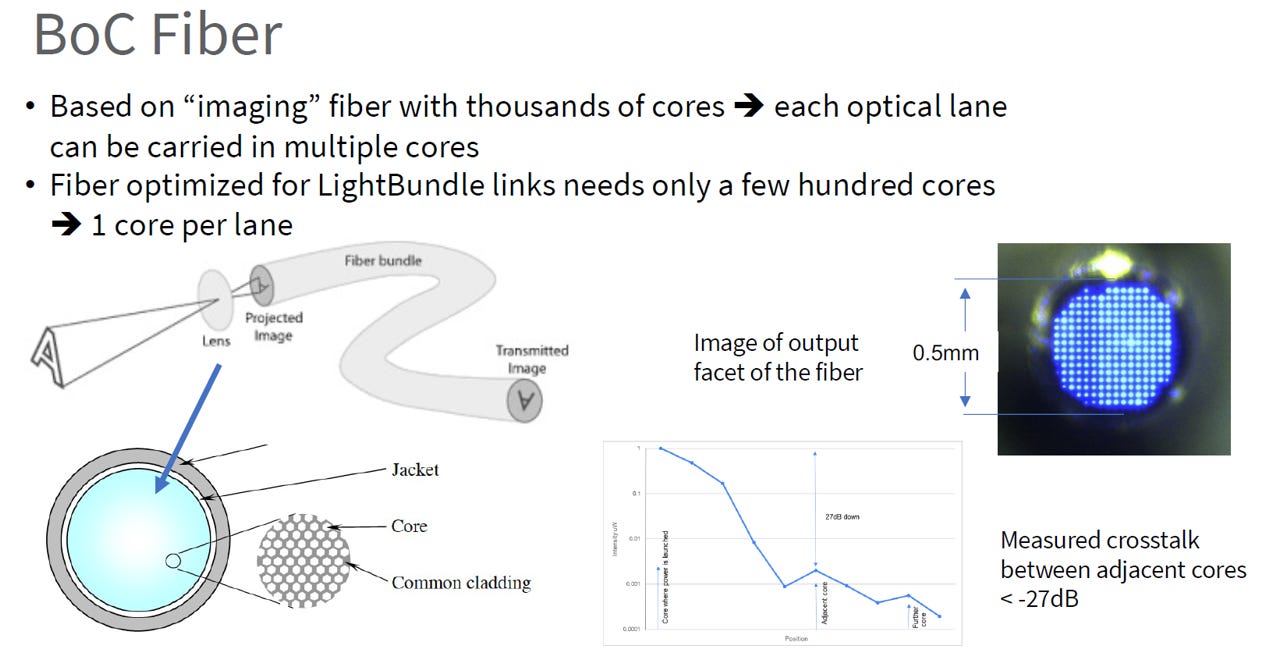
這是一種為大規模並行光學互連設計的多芯成像光纖(imaging fiber)。
核心結構:多芯成像光纖
成像光纖基礎:BoC Fiber 基於一種特殊的成像光纖 (Imaging Fiber,用於內視鏡),內部包含數千個獨立的微小光纖芯 (cores)。
結構特點:在一條光纖纜線中,這些光芯被共同的包覆層 (Common cladding) 包圍。這種結構能傳輸一個完整的圖像 (Image),保留其空間資訊(兩端Core的相對位置不變)。
高密度應用:光纖輸出端的光圖像顯示,光芯以極高的密度排列,直徑僅約0.5 毫米。
LightBundle 應用優化
大規模並行傳輸:這種光纖經過優化,特別適用於 LightBundle 鏈路。雖然它包含數千個光芯,但 LightBundle 應用只需要數百個光芯。
傳輸模式:採用1 個光芯對應 1 個光通道 (1 core per lane)或多對1(multi cores per lane)的模式。由於 LightBundle 採用「Wide-and-slow」的多通道並行策略,光芯(通道)負責傳輸一個低速的數據流。
關鍵性能指標:極低的串擾
串擾 (Crosstalk) 測量:由於光芯間距離極近,光訊號在相鄰光芯之間可能會發生洩漏(串擾)。
優異的隔離性:測量結果顯示,相鄰光芯之間的串擾小於 -27 dB(通常認為這是非常低的串擾),這確保了每個光學通道的訊號能夠保持獨立和完整,對於高密度並行傳輸的可靠性至關重要。
Coupling
在 MicroLED 光學互連系統中,微光學元件 (Micro-optics)如何設計來最大化光線收集效率的問題。

傳統微透鏡陣列 (MLAs):由於 MicroLED 是廣角發射(朗伯體, Lambertian),傳統的 MLA 無法有效收集所有發散的光線,導致耦合效率低。
MOSAIC的解決方案是採用定製的TIR 透鏡 (全內反射透鏡)。該透鏡利用全內反射的原理,有效捕捉並準直大角度發射的光線,從而最大化光線收集效率,確保光訊號能高效耦合。
CROME (Cavity Reinforced Optical Micro Emitter)內含的諧振腔 (Cavity) 對於µLED 的耦合 (Coupling)效率有極大的幫助。
增強方向性 (Enhanced Directionality):
傳統的 MicroLED 是Lambertian Emitter (朗伯體發射器),光線會向各個方向發散。
諧振腔的設計(通常是利用 DBR 等反射結構)可以修改 µLED 的自發輻射模式,使發出的光線更集中、方向性更強
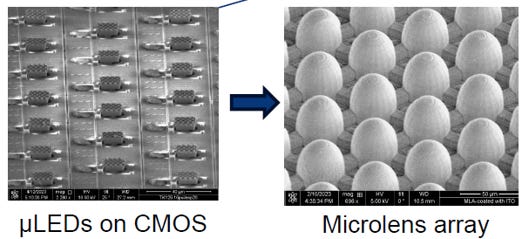
CROME µLED 陣列直接整合在CMOS 晶片上,以實現高速並行互連:
CROME w/ Cavity:µLED 內建諧振腔,用以增強發射光的方向性和效率。
MLA 整合:覆蓋的微透鏡陣列 (MLA) 將已被諧振腔優化的光線進一步準直 (Collimation)
總結:透過諧振腔和MLA的協同作用,確保光線能以高效率和高密度耦合至光纖中。
應用
多對1(multi cores per lane)的模式:
這張圖表闡述了 MicrosoftMOSAIC在使用多芯成像光纖時,採用的「多對一」 (Multi cores per lane)策略,來優化製程中的對準 (Alignment)挑戰。
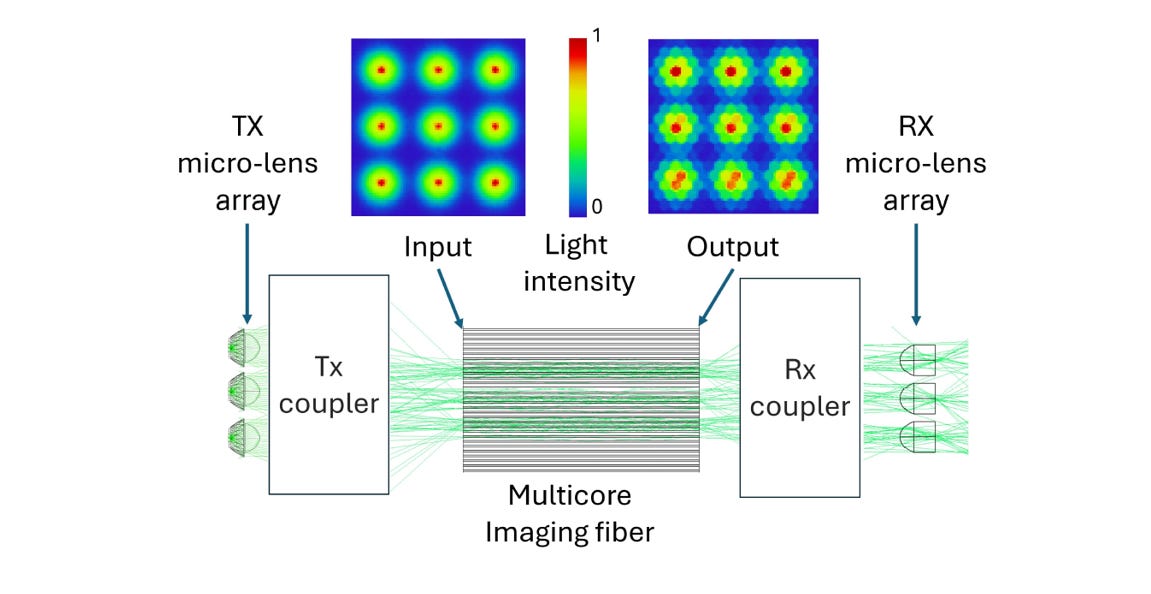
採用「多對一」策略,以簡化製程對準:
目標:克服高密度光學元件組裝中,發射器必須精準對準單一光纖芯的挑戰。
方法:允許一個邏輯光通道的光束分散並由多個相鄰的光芯承載傳輸。
優勢:這能極大地放寬微透鏡陣列與光纖之間的機械對準公差,從而提高大規模量產的良率和可靠性。
1 個光芯對應 1 個光通道 (1 core per lane):
這張圖表展示了 Avicena LightBundle 系統如何將1 個光芯對應 1 個光通道(1 core per lane) 的並行原理,落實到實際的高密度光纖纜線和連接器上。

這款特製的MTP 連接器內裝有高精度的光纖陣列,是 Avicena LightBundle 實現大規模並行傳輸的關鍵:
纜線包含數百條(圖示為 331 條)50 µm直徑的光纖。
實現了1 個光芯對應 1 個光通道的極高密度並行傳輸。
特製 MTP 連接器能夠以高精度耦合這些光纖陣列,承載超過600 個光學通道(Tx和Rx各 331 條光纖),確保高岸邊密度和可靠性。
4. 結語
Avicena 應該在2021 OCP Global Summit就介紹他們的技術了。
他們將其技術定位於圖中的大型藍色區域:

效能基準與關鍵指標
Y 軸指標:BW Density * Energy Efficiency (Gbps/mm / (pJ/bit))。
基準線 (紅線):圖中在 Y 軸1000的位置畫了一條紅色的基準線,代表一個雄心勃勃的性能目標:1 pJ/bit @ 1 Tbps/mm。
Avicena (µLEDs) 的技術定位
超越基準線:整個 µLED 區域都位於紅色的 1000 基準線之上。這表明 Avicena 的技術在短中距離互連中,可以穩定地達到甚至超越1 pJ/bit @ 1 Tbps/mm性能目標。

µLED 互連技術是Scale Up 網絡的理想選擇,其關鍵優勢在於:
能源效率極高:< 1 pJ/bit。
頻寬密度高:> 2 Tbps/mm(岸邊密度,Shoreline Density)。
兼容性強:可與任何CMOS 製程兼容,並集成 Si PD 偵測藍光。
可靠性高:工作溫度範圍廣,且採用多模設計,有利於放寬組裝公差和成本效益
1 Tb/s演示晶片證明了Wide-and-Slow光學互連的可行性:
雖然該晶片的總帶寬1.2 Tbps小於NVLink B200 的 7.2 Tbps峰值帶寬(NVLink 主要是短距離銅線互連),但該演示晶片著重於證明光學互連如何在能源效率和大規模集成上取得突破。

性能達成:晶片通過304 個並行通道(每個 4 Gbps),實現約1.2 Tbps的總帶寬。
能源效率:功耗極低,小於 1 pJ/bit。
集成度:成功在TSMC N16製程上集成了µLED 陣列、Si PD 陣列和數位功能。
AvicenaLightBundle或 微軟MOSAIC技術是Scale Up 網絡的關鍵突破,它成功地以< 1 pJ/bit的極高能效和> 2 Tbps/mm的高密度,解決了傳統互連的功耗和頻寬瓶頸。該技術驗證了Wide-and-slow架構的可行性,正引領光學互連邁向高效、低成本的新時代。
5. 補充說明
Avicena 在ECOC 2025和OCP Summit 2025,展示最新技術:
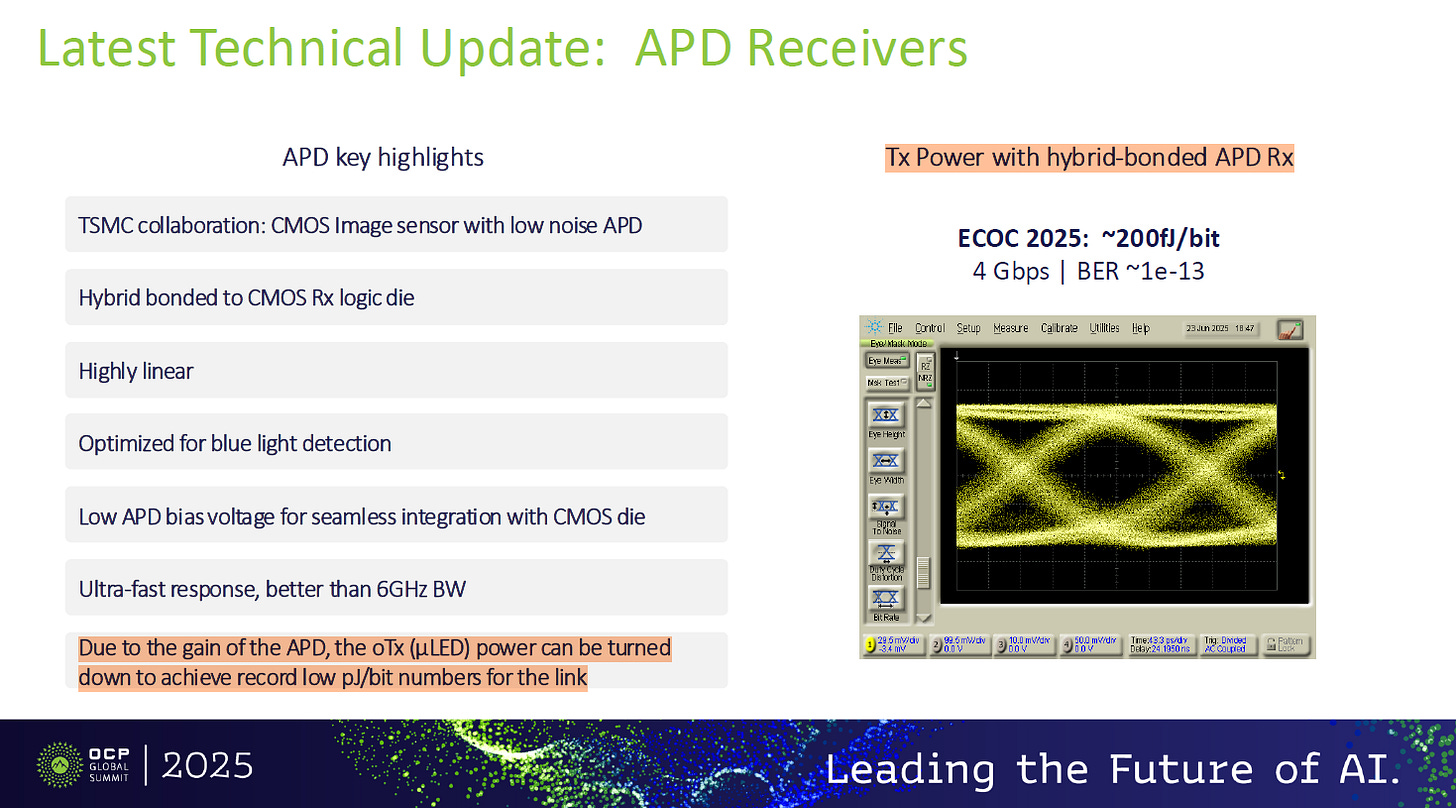
技術核心:從 PIN 轉向 APD (雪崩光電二極體)
變革點:接收端採用高靈敏度的APD取代傳統 PIN PD。
目的:利用 APD 的內部增益,讓發射端 (Tx) 的 MicroLED 可以降低發光功率運作,解決 MicroLED 在高電流下效率下降的問題。
關鍵數據與製程
能效:宣稱達到~200 fJ/bit (0.2 pJ/bit)。
註:此為純光學鏈路功耗(Driver+LED to APD+TIA),不含 UCIe Retimer 或數位層。
速率:單通道4 Gbps(採「低速多通道」並行策略)。
製程:與TSMC合作,針對藍光優化,並使用Hybrid Bonding將 APD 堆疊在 CMOS 晶片上。
市場定位
鎖定0.01m 至 10m(板級到機櫃級) 的中短距離互連。
試圖利用「高密度 (Gbps/mm)」與「低功耗 (pJ/bit)」的物理特性,在這個距離區間內挑戰傳統銅線 (Electrical) 與長距離雷射 (VCSEL/SiPh) 的地位
Avicena 透過換用更靈敏的接收器 (APD),讓發射端更省電,試圖在不包含複雜數位電路的前提下,展示出大幅優於現有標準的物理層能效數據。
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


