上星期2025 OCP Global Summit在San Jose盛大舉行,沒機會參加,還好友人給了一些會議資料提前研究(OCP最後會公開資料),分享個人的心得,歡迎討論。
上星期2025 OCP Global Summit在San Jose盛大舉行,沒機會參加,還好友人給了一些會議資料提前研究(OCP最後會公開資料),分享個人的心得,歡迎討論。
- Source: Ted Yu
- Published: 2025-10-23T08:16:13+08:00
- URL: https://ytyuted.substack.com/p/ep21-ocp-global-summit EP21. OCP Global Summit - Ted Yu
Pledge your support

EP21. OCP Global Summit

Oct 23, 2025
上星期2025 OCP Global Summit在San Jose盛大舉行,沒機會參加,還好友人給了一些會議資料提前研究(OCP最後會公開資料),分享個人的心得,歡迎討論。
1. OCP 社群協作與技術貢獻

這是今年OCP在台北舉辦APAC Summit的資料。
依據OCP 的 OSAI 戰略計畫白皮書。它清晰地將社群的所有努力匯集到這三個相輔相成的工作領域,共同打造一個開放、可擴展且高效率的 AI 未來
•DC Physical Infrastructure (實體基礎設施):專注於革命性的電源和冷卻,如圖中的 Mt. Diablo (800VDC 機櫃) 和 Deschutes CDU (液冷)。
•DC IT Infrastructure (IT 基礎設施):專注於伺服器和互連,如圖中的 Catalina Racks (伺服器) 和 Scale-up Ethernet (互連)。
•Systems Management (系統管理):專注於大規模叢集的管理、監控和維護。
三大工作領域中,與「硬體」直接相關、負責定義實體產品規格的是前兩個領域。
本次報告是依據這次Global Summit拿到的最新資料,介紹這兩個領域的發展資訊。
2. DC Physical Infrastructure
2.1. Mt. Diablo
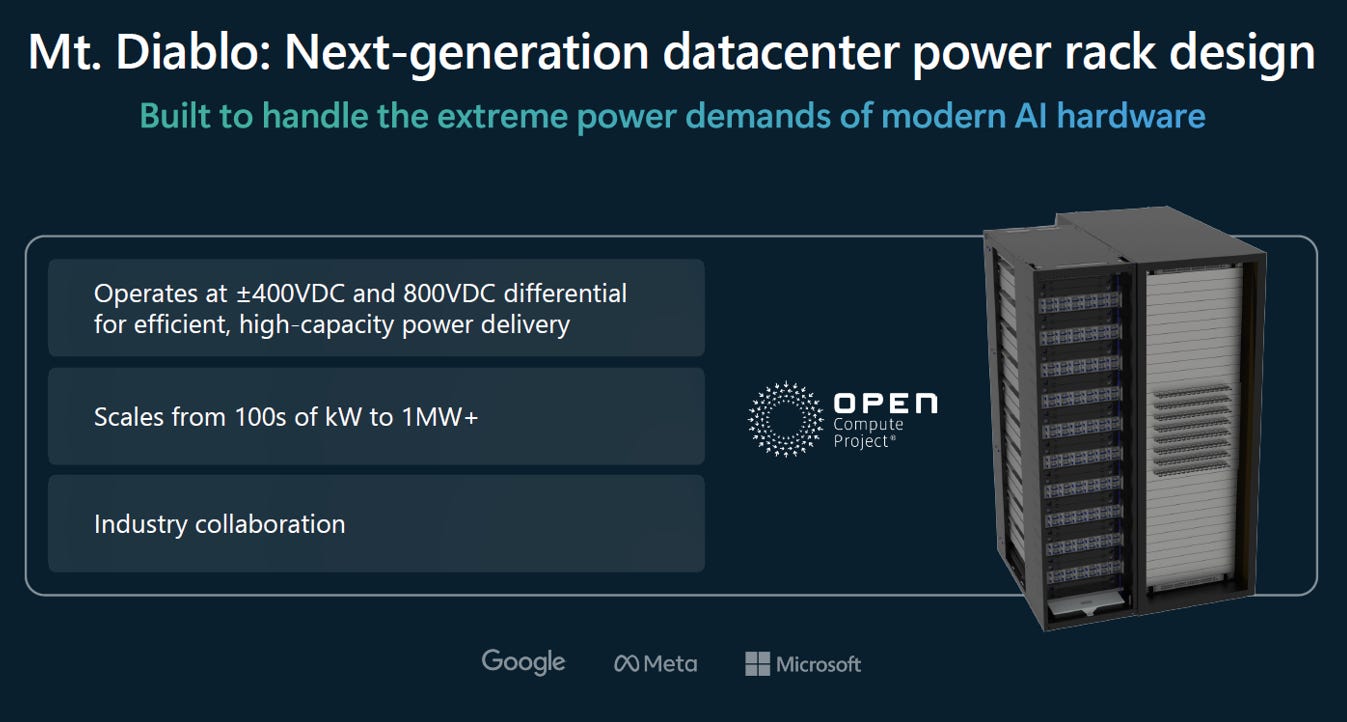
Mt. Diablo 的由來 (名稱)
地理位置:“Mt. Diablo”(暗黑破壞神山,或稱魔鬼山)是美國加州舊金山灣區東部一座真實的山峰。
命名原因:這是一個科技業常見的「代號 (Codename)」命名方式。專案的主要貢獻者,特別是Google和Meta(Facebook),其總部都位於舊金山灣區,Mt. Diablo 是當地非常著名的地標。以當地地標命名,是向這個專案的發源地致敬。
專案內容
高壓直流電 (HVDC) 供電:
核心技術是將機櫃的供電架構從傳統的,轉向高壓的+/-400 V直流電(800V直流電)。
這能提供800VDC,大幅提高供電效率、減少電力在傳輸過程中的損耗,並允許使用更細的電纜。
800VDC高壓供電架構,可以借用電動車(EV)高壓充電系統成熟的技術
極高的功率擴展性:
這套設計的規模 (Scales) 可以從「數百 kW擴展到 1MW+」(百萬瓦特)等級。
這對於應付未來單一機櫃就需要消耗極高功率的 AI 叢集至關重要。
開放的產業協作:
這不是單一公司的專有技術,而是由Google、Meta 和 Microsoft三大雲端巨頭共同協作,並貢獻給Open Compute Project (OCP)的開放標準。
這意味著整個行業(包括硬體製造商、伺服器品牌商)都可以採用此設計,有助於建立一個標準化的生態系,降低成本並加速創新。
大型 AI 資料中心(DC)對電力的影響和對策

功耗暴增:AI 機櫃的功耗持續飆升(從 kW 級邁向 MW 級),遠超過傳統的非 AI 伺服器。
巨大功率尖峰 (Power Spikes):AI 運算負載極不穩定,會產生巨大且瞬時的電力需求,對電網穩定性造成威脅。
應對策略
內部供電革新 (High-power delivery):
為了應付高功耗並提升效率,機櫃架構轉向 OCP 的Mt. Diablo標準,採用+/- 400V 高壓直流電供電。
外部電網革新 (Grid innovation):
資料中心必須建置電池儲能 (BESS) 和微電網。
目的:用電池來「吸收和管理」自己的功率尖峰,避免衝擊公共電網。
角色轉變:資料中心從單純的「電力消費者」,轉型為協助電網穩定的「供應者」或「調節者」。
總之,AI 需求正迫使資料中心從內到外(從機櫃到電網)全面標準化和革新其電力架構,以應對「高功耗」和「高波動」的雙重挑戰。
NVidia Kyber
NVIDIA 在會議中宣布其 AI 系統 (Kyber) 全面採用800VDC供電架構,並此架構與OCP Mt. Diablo標準相容。

具體簡介如下:
核心產品:這套架構將用於 NVIDIA 最新的Kyber 機櫃 (Rubin Ultra NVL576)。
採用標準:「OCP Mt. Diablo Electrically Compatible」(與OCP Mt. Diablo電氣相容) 下一代 AI 的供電標準。
建立完整生態系:NVIDIA 正聯合「從電網到晶片」的所有夥伴:
資料中心設計夥伴(如 Foxconn, CoreWeave, Oracle):負責建造800VDC資料中心。
電源架構夥伴(如 ABB, Schneider, Vertiv, Infineon):負責提供所需的800VDC電源元件。
NVIDIA 正聯合整個行業,將OCP Mt. Diablo標準商業化,以支援其 Kyber AI 系統的龐大電力需求。
2.2. 資料中心液冷系統
Google在會議中介紹資料中心液冷系統:
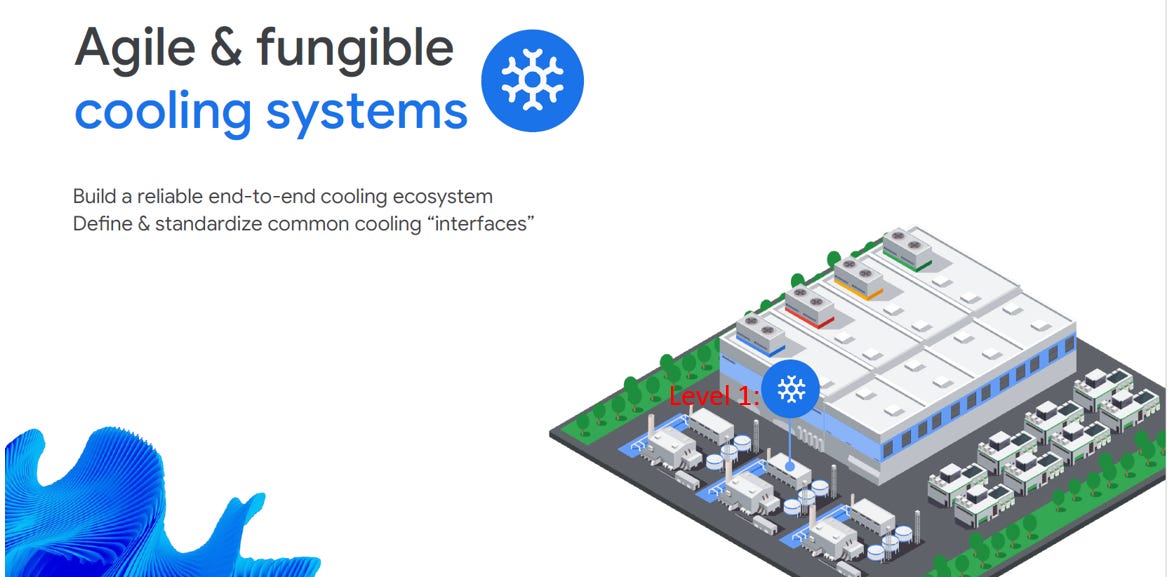
Level 1:資料中心設施層級 (Facility Level) - 發電廠與主幹道
組件:外部的冷卻水塔 (Cooling Towers)、冰水主機 (Chillers)。
功能:產生大量的設施冷卻水 (Facility Water),並透過巨大的主管道輸送到整個資料中心建築。
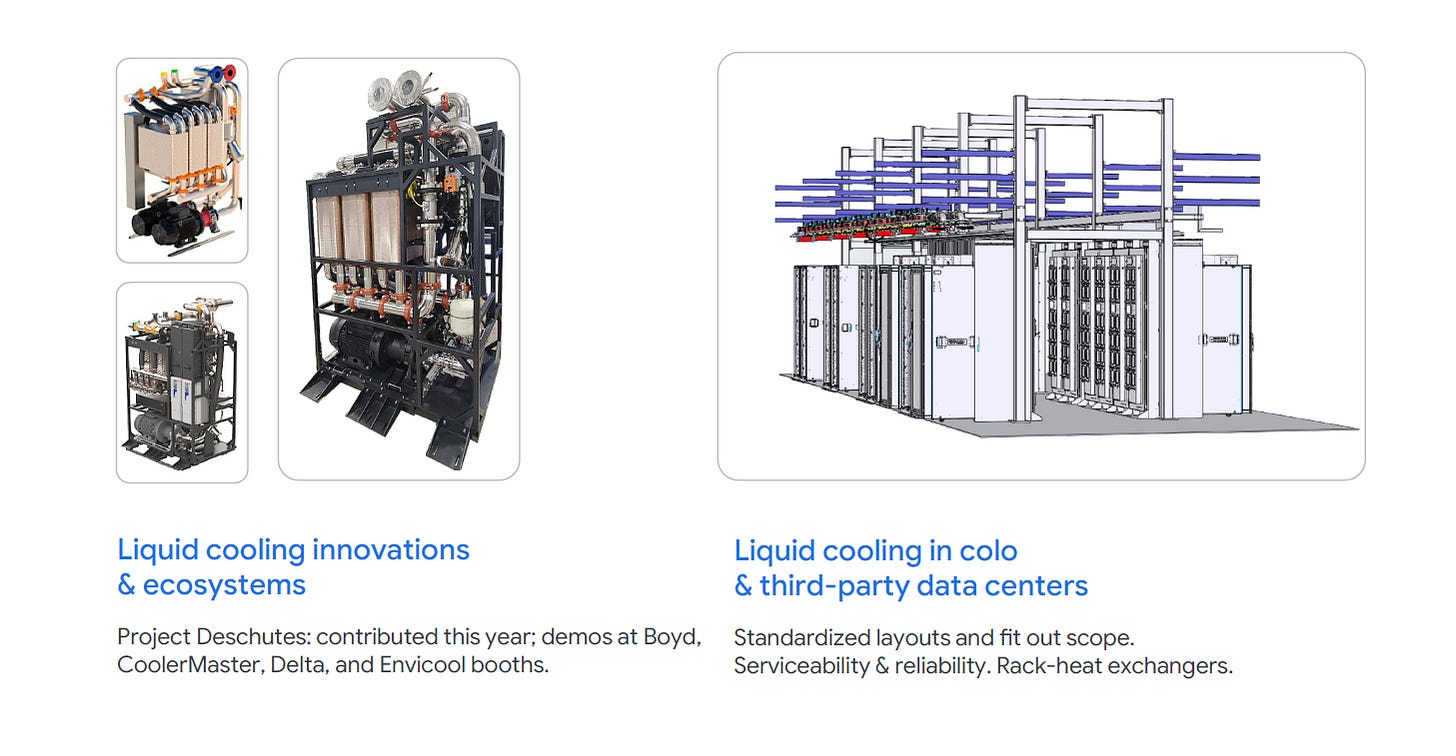
Level 2:機房分配層級 (Row/Zone Level) - CDU 的主要角色
組件:CDU (Coolant Distribution Unit)。
功能:CDU 就像是社區的「區域變電箱」。它連接到設施的主冷卻水管 (Level 1),然後透過熱交換器 (Heat Exchanger),產生一個更乾淨、溫度與壓力都受到精密控制的「二次迴路」。這個二次迴路裡的冷卻液,才是真正會流進伺服器機櫃的。
關鍵點:一台 CDU 通常不是服務單一機櫃,而是服務一整排 (a Row) 或一個區域 (a Zone) 的多個高密度機櫃。Deschutes CDU 的設計正是針對這個層級。
Level 3:機櫃層級 (Rack Level) - 最後一哩路
組件:機櫃內的歧管 (Manifolds)、軟管 (Hoses)、快拆接頭 (Quick Disconnects)。
功能:歧管就像是機櫃內的「電源排插」,它接收來自 CDU (Level 2) 的冷卻液,並將其分配給機櫃內每一台伺服器上的冷板 (Cold Plate)。
雖然像 Google(例如他們貢獻的Deschutes CDU)和 Meta 這樣的大型雲端服務商是 OCP 的主要推動者,但 OCP 的核心精神是「社群協作 (Community Involvement)」。
下面這張來自 Supermicro(美超微)的投影片就清楚地表明社群協作:
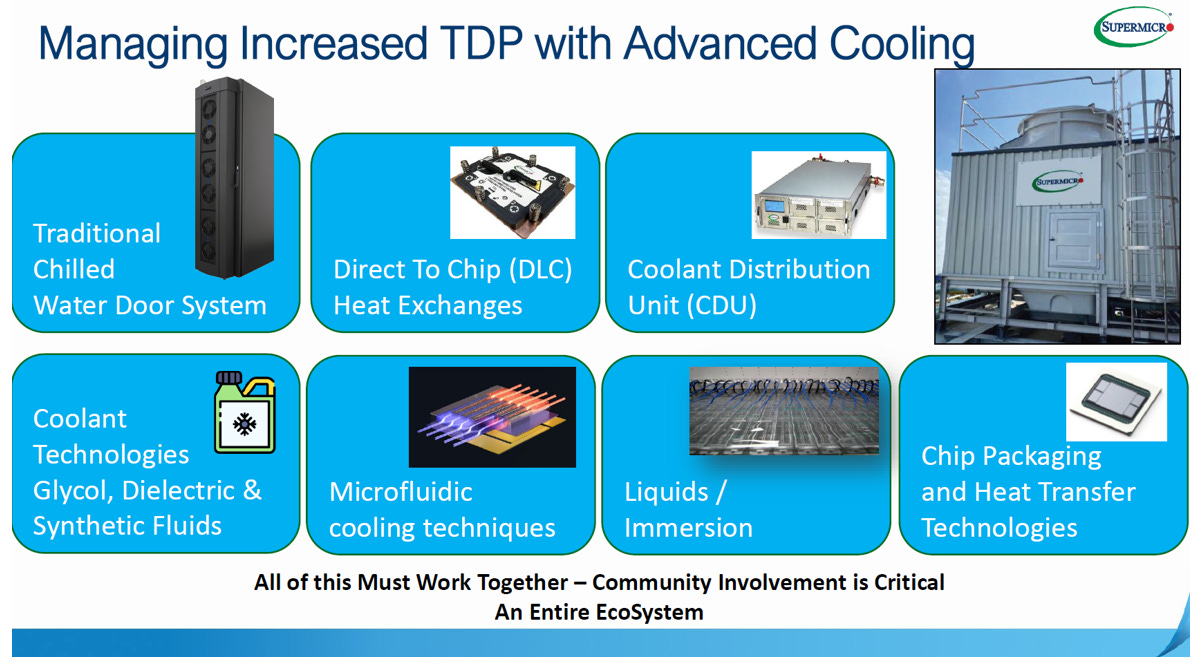
其他成員的積極參與:Supermicro 作為 OCP 的重要成員,也展示了他們在先進散熱領域的完整解決方案,從機櫃級(冷卻水門)、晶片級(DLC)、分配單元(CDU),一直到浸沒式(Immersion)散熱。
這是一個生態系:投影片的結論「All of this Must Work Together – Community Involvement is Critical – An Entire EcoSystem」(所有這些都必須協同工作 – 社群參與至關重要 – 這是一個完整的生態系)
共同解決難題:為了管理不斷增加的 TDP(熱設計功耗),OCP 需要像 Supermicro 這樣的硬體供應商,以及冷卻液、晶片封裝等各個領域的廠商共同投入和協作。
註: Deschutes CDU(Coolant Distribution Unit)是由Google主導、並在OCP(Open Compute Project)框架中公開的資料中心液冷標準模組。它的名稱源自美國俄勒岡州的 Deschutes 河,呼應 Google 在該地區的資料中心與冷卻技術研發起源。
3. DC IT Infrastructure (IT 基礎設施)
3.1. OCP MGX
什麼是 OCP MGX?
MGX是 NVIDIA 制定並貢獻給 OCP(開放運算計畫)的一個模組化伺服器設計規範 (spec)。
它定義了一套標準化的伺服器「積木」:包括主機板、GPU 模組、CPU 模組、網路卡等的尺寸、接頭和互連方式
Nvidia 關鍵轉捩點: from Chip to AI Intrastructure
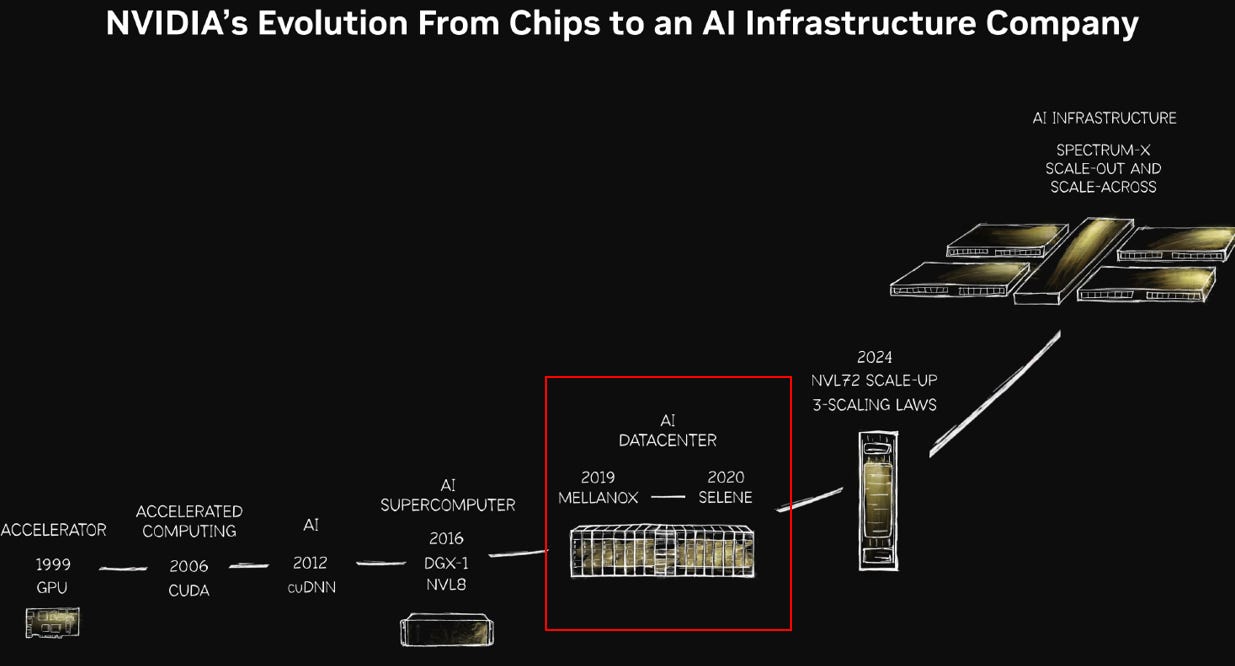
由於半導體有「光罩尺寸」的物理極限,單一晶片的算力已無法滿足 AI 需求。唯一的出路是「用群計算補單芯」,也就是透過超高速網路將成千上萬顆 GPU 連接成一台巨大的虛擬超級電腦。
關鍵行動:在這個趨勢下,「網路」變得和「晶片」同等重要。NVIDIA 在 2019 年收購 Mellanox,正是為了掌握 AI 工廠所需的「神經系統」(超高速網路),這是其轉型最關鍵的一步。
最終成果:這次收購讓 NVIDIA 從單純賣 GPU 的「零件商」,轉變為能提供「GPU + 網路」全套方案的系統供應商,建立了強大的技術護城河。而內部代號Selene 的SuperPod,就是這個成功戰略的最佳證明與產品藍圖。
NVIDIA 已從一家晶片公司,成功轉型為 AI 基礎設施的「全棧式」解決方案供應商。
NVIDIA 的下一代 AI 平台 “Vera Rubin” 將採用 OCP MGX 作為其基礎架構標準。
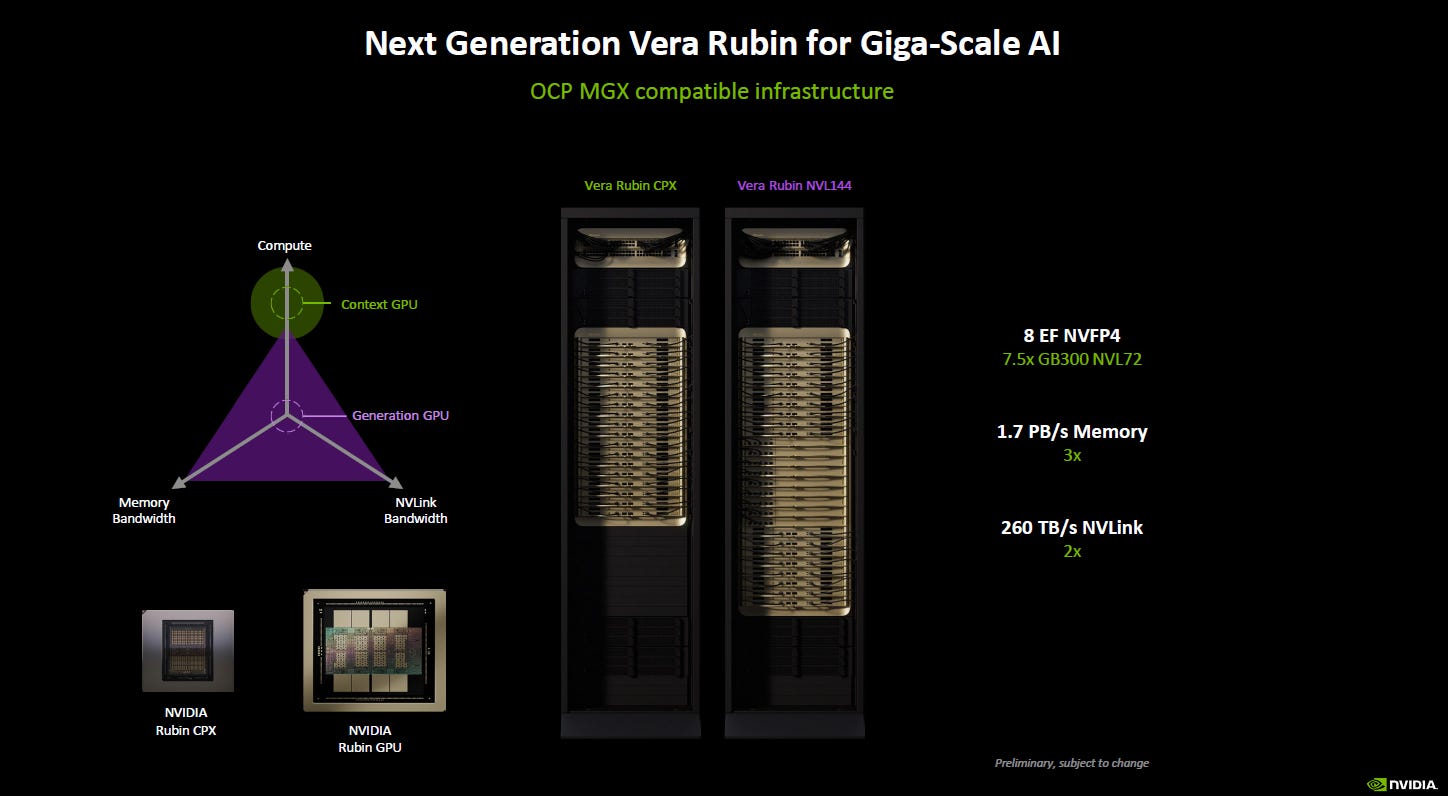
NVIDIA 透過將 MGX 貢獻給 OCP,成功地將「開放標準」與「自家最新的 AI 晶片 (Vera Rubin)」結合,旨在建立一個既開放又由 NVIDIA 技術主導的 AI 硬體生態系。
3.2. Ethernet for Scale-Up Networking(ESUN)
今年OCP Global Summit 上的重大新聞: 宣布成立ESUN (Ethernet for Scale-Up Networking),選擇用Broadcom 貢獻的SUE(Scale Up Ethernet)技術,參考EP17. SUE簡介。

SUE / ESUN(Ethernet for Scale-Up Networking)是 Broadcom 與 OCP 推動的開放式Ethernet Scale-Up Fabric。它在Ethernet PHY上重新設計協定層,不使用TCP/IP,直接以硬體實現低延遲、無損傳輸。
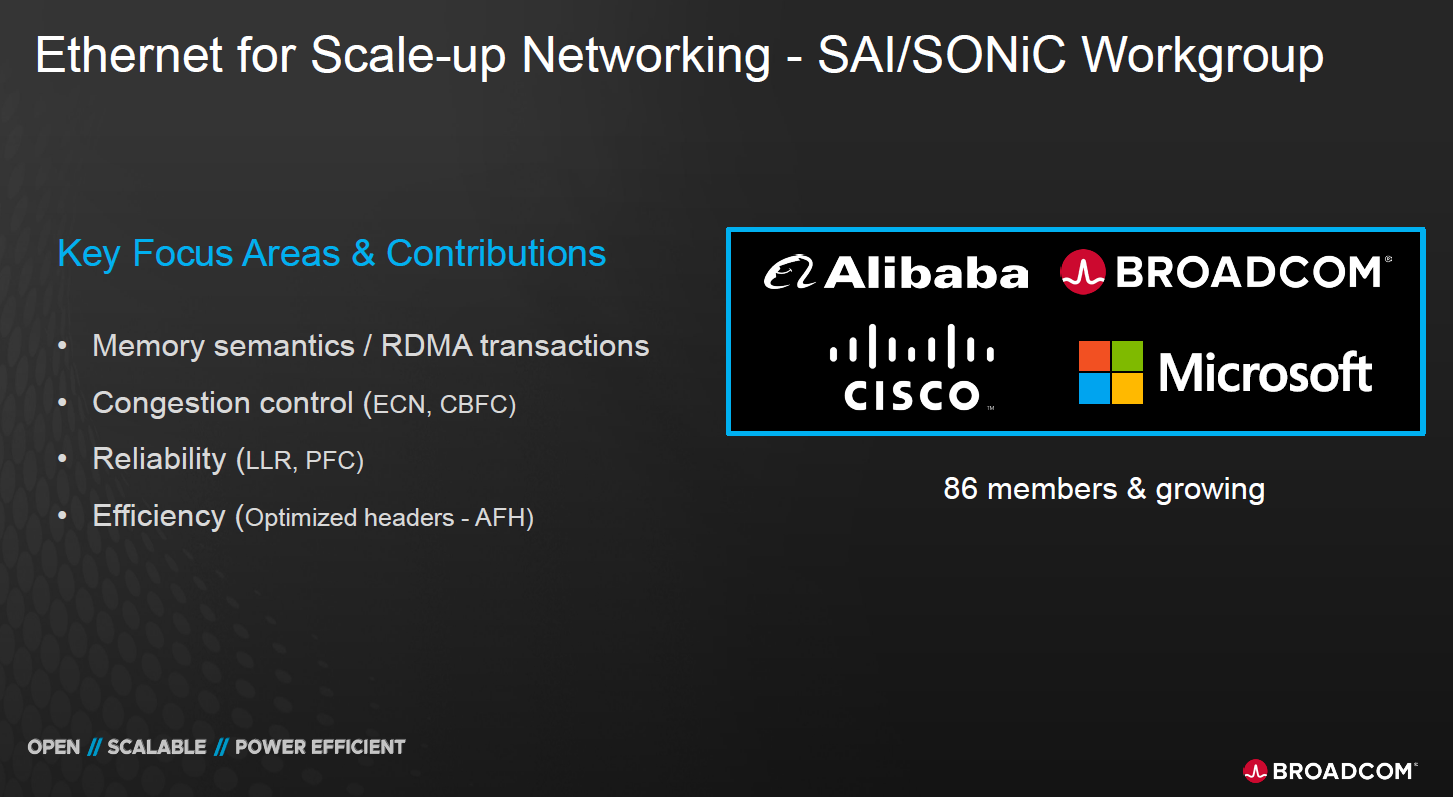
核心機制:
LLR:Link-Layer Retry(鏈路層重傳)
CBFC:Credit-Based Flow Control(基於信用的流控)
PFC:Priority Flow Control(優先級流控)
AFH:AI Fabric Header
整合生態:
Broadcom提供 ASIC
Microsoft SONiC+SAI API提供開放控制層
已有86會員參與標準化
總結:
ESUN = 以太網化的 NVLink
在硬體層提供 sub-µs 延遲與無損通訊
用於Rack / Multi-Rack的 AI Scale-Up 網路。
3.3. Scale-up 常見誤解
一般認為「UAL 和 SUE(或 ESUN)是兩個競爭的 Scale-Up 技術。」
兩者雖然都屬於Scale-Up範疇,但它們工作層級不同、傳輸協定不同、也服務於不同的互連層次
UAL 與 SUE/ESUN 並非競爭,而是 AI Scale-Up 堆疊中不同層級的互補技術:
UAL 負責最底層 chip-to-chip,SUE/ESUN 將以太網技術下探 rack 內,UEC 再向上連接 data center。
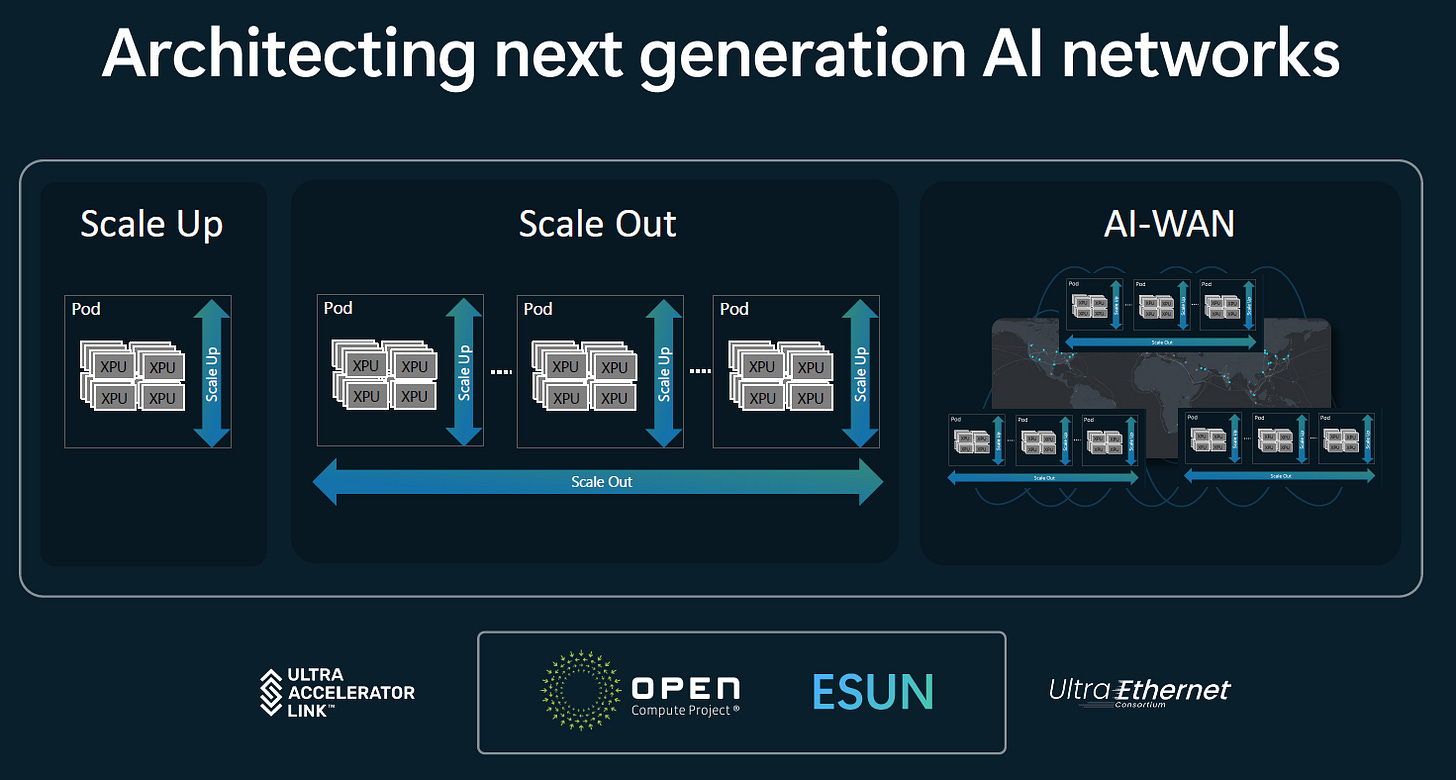
利用 Microsoft 在會議上的架構圖(“Architecting next generation AI networks”)展示了三個層級的 AI 網路架構演進,分別對應三個開放標準:UAL (Ultra Accelerator Link)、ESUN (Ethernet for Scale-Up Networking)、以及UEC (Ultra Ethernet Consortium)說明:
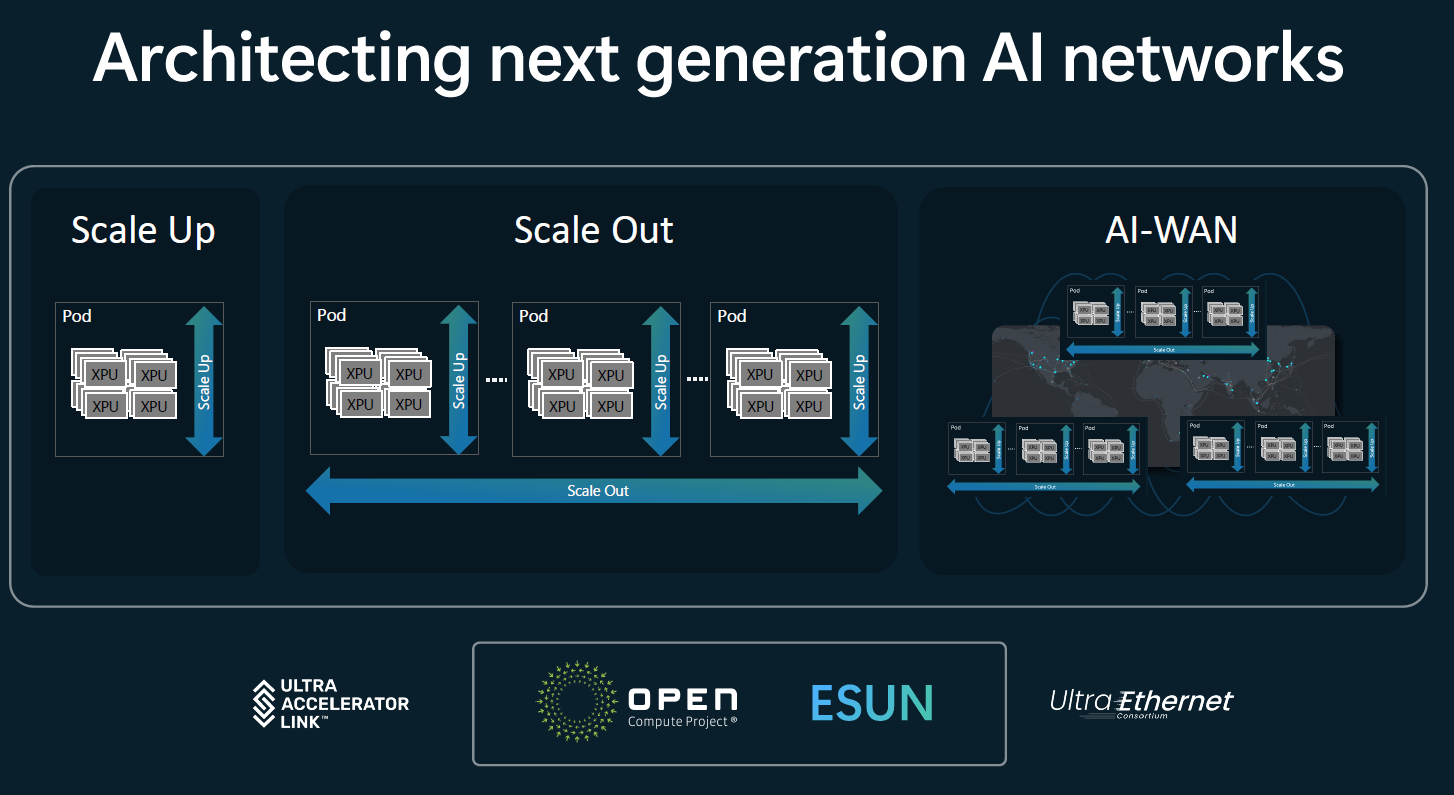
以下是三者的關係與定位整理:
UAL(Ultra Accelerator Link)— 晶片內與板級的 Scale-Up 互連
主導單位:AMD、Intel、Broadcom、HPE、Dell 等(UALink 推進聯盟)
功能定位:
專注於XPU(GPU / AI 加速器 / CPU)之間的直接互連,屬於Scale-Up 架構。
傳輸距離通常在晶片對晶片(Chip-to-Chip)或同板(Board-to-Board)範圍內(< 2 m)。
可視為NVIDIA NVLink的開放化對應版本,強調低延遲、高頻寬(數百 GB/s 等級)的近距離資料交換。
對應範圍
“Scale-Up” 區塊(圖左)
ESUN(Ethernet for Scale-Up Networking)— Broadcom 主導的以太化 Scale-Up
主導單位:OCP(Open Compute Project)與 Broadcom
功能定位:
目標是用Ethernet 取代專有互連協定,讓Scale-Up 也能以標準化 Ethernet為底層傳輸。
Broadcom 將自家SUE 技術捐贈給 OCP,建立 ESUN 聯盟,形成「以太網化的 Scale-Up」標準化組織。
代表從晶片層高速互連(UAL)過渡到基於 Ethernet PHY / MAC 的通用互連。
對應範圍
“Scale-Up” 與 “Scale-Out” 的交界(圖中)
UEC(Ultra Ethernet Consortium)— Data Center 級 Scale-Out / AI-WAN
主導單位:AMD、Intel、Arista、Cisco、Broadcom、Meta、Microsoft、HPE 等
功能定位:
專注於大規模 AI 叢集與資料中心之間的互連(Scale-Out / AI-WAN)。
改良 Ethernet,以支援 AI 工作負載所需的低延遲、無損傳輸(RoCE++)與可預測流量管理。
屬於「AI Fabrics」或「AI Scale-Out Fabric」的層級。
對應範圍
“Scale-Out” 與 “AI-WAN”(圖右)
三者的階層與關係總覽

這三者構成了從「晶片 → 板 → 機架 → 數據中心」的AI 網路垂直分層標準生態,共同支撐下一代 AI Fabric。
Broadcom完整的 AI Scale-Up/Out 解決方案:
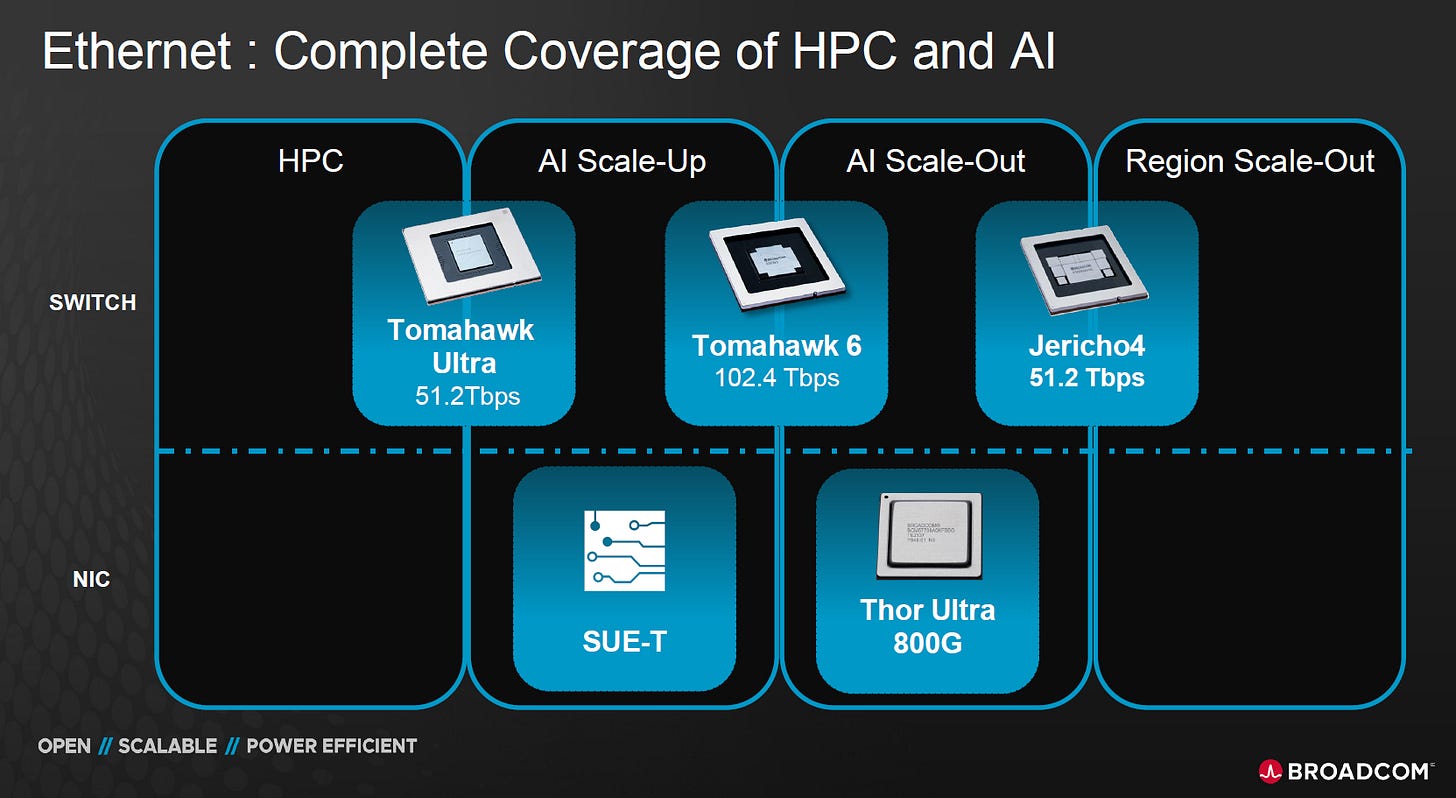
這張 Broadcom 圖展示了其在HPC、AI Scale-Up、AI Scale-Out、Region Scale-Out等不同網路層級的完整 Ethernet 解決方案,標註的icon(Tomahawk Ultra、Tomahawk 6、Jericho 4、SUE-T、Thor Ultra)確實各自代表不同層面的技術焦點:
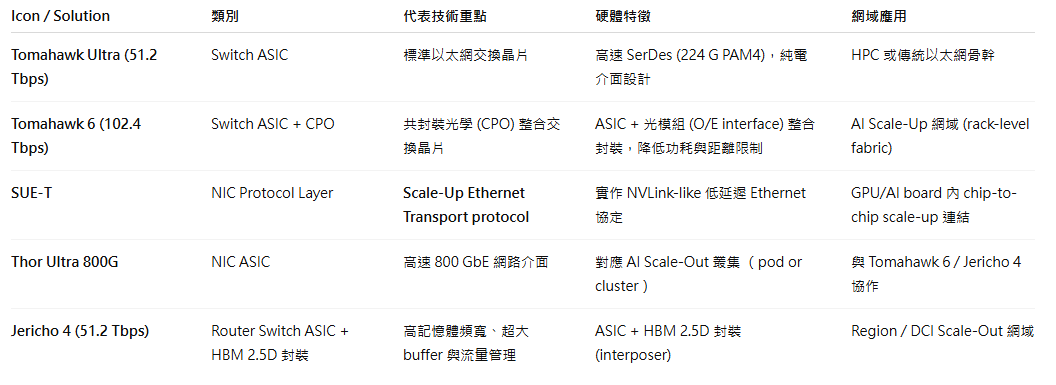
🧩圖中 ICON 含義解析:
Tomahawk Ultra / 6 系列→ 核心 switch ASIC; TH6 更進一步支援 CPO(Co-Packaged Optics)以縮短電路距離、提升能效。
Jericho 4→ 帶 HBM 的高層 routing switch(需要高速的Buffer),強調 2.5D 堆疊與 QoS 能力。
Thor Ultra→ 800 G NIC 晶片,用於 AI Scale-Out 伺服器間互聯。
SUE-T→ 「Scale-Up Ethernet Transport」協定層,對應 AI Scale-Up 架構(與 UAL 同級別概念)。
3.4. NVLink vs. SUE/ESUN
Ethernet Scale-Up Networking (ESUN)中距離的 Scale-Up 網域,可涵蓋多機櫃(multi-racks)、上千 XPU。

NVLink (NVL)超低延遲但僅限短距(單 Rack 內),無法延伸至這種多機櫃級規模。(屬於短距差動銅線(PAM4 56–112 Gbps 級),極限距離 ≈ 2 m)

註: 576 指的是 GPU die 數量,不是 GPU 卡(chip 或 module)數。在Rubin Ultra NVL576架構中,「Rubin Ultra」是4-die GPU 模組。
NVL576 的 Scale-Up 最大網域 = 一個 Rack 內的 NVSwitch Fabric Domain,
最多支援 576 顆 GPU dies(約 144 模組),不支援 multi-rack 延伸。
若要擴展到 > 576 GPU(例如 2048 XPU 級)scale-up domain,就必須使用 Ethernet Scale-Up Fabric(SUE / ESUN) 來連結多個 NVL Domain。
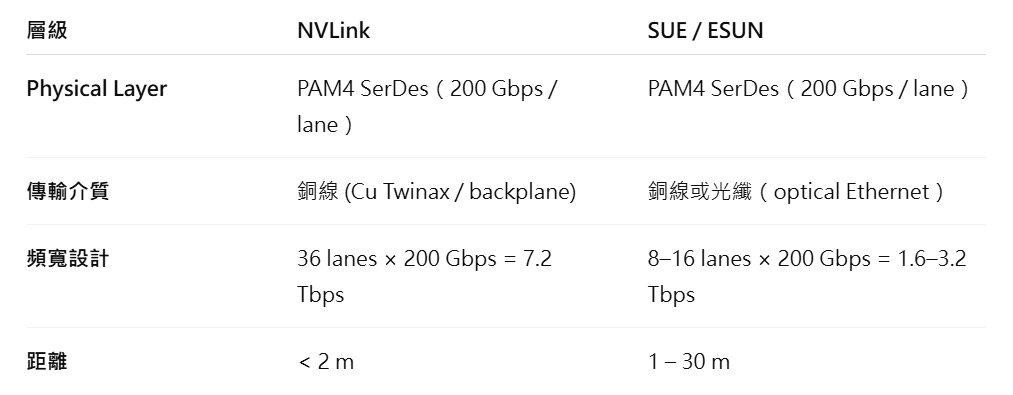
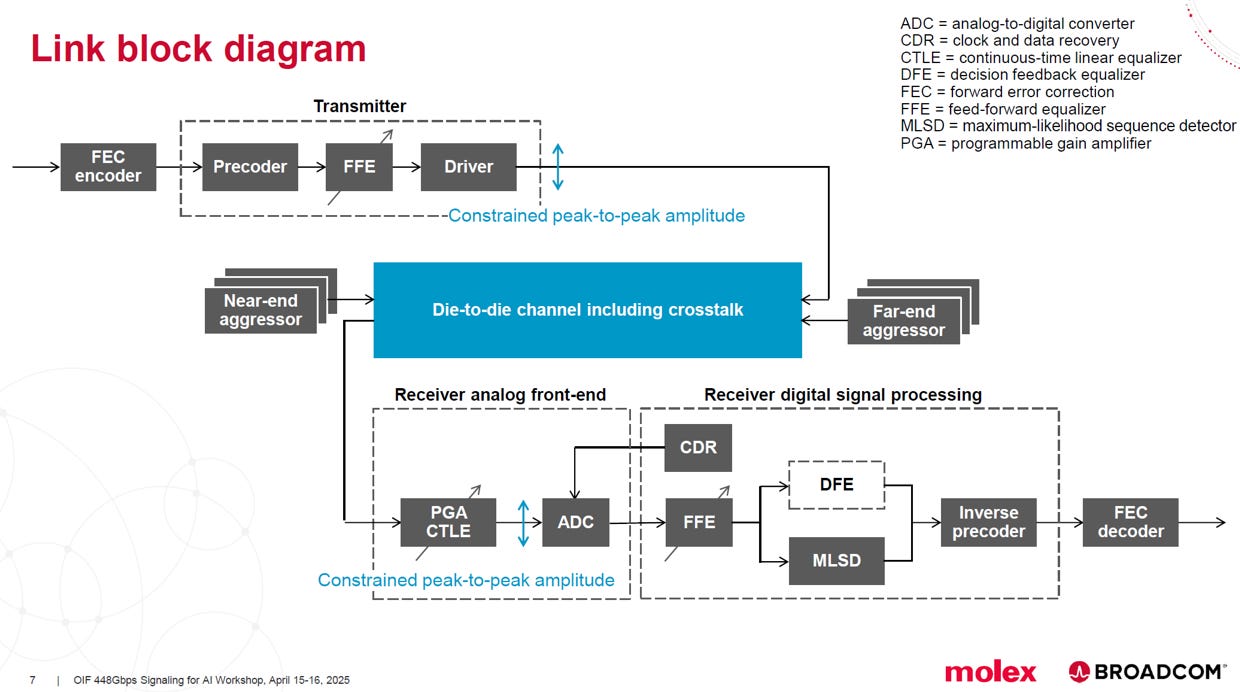
底層一致:SerDes 是共同語言
NVLink 5.0與SUE / ESUN都是建構在PAM4 高速 SerDes上。
都用到相同級別的224G SerDes PHY,差別只在傳輸介質(Copper, Optics),頻寬設計(lane的數目),距離遠近。
上層差異:協定哲學不同但相互借鏡
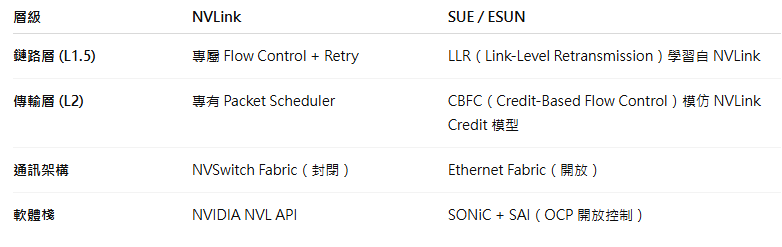
➡ Broadcom 在設計SUE時,確實「參考」了 NVLink 的低延遲理念;
而 NVIDIA 也在 Rubin / ESUN 生態裡「反過來借鑑」 Ethernet 的可擴展性與標準化方法。
根本差異:只是範圍與媒介不同
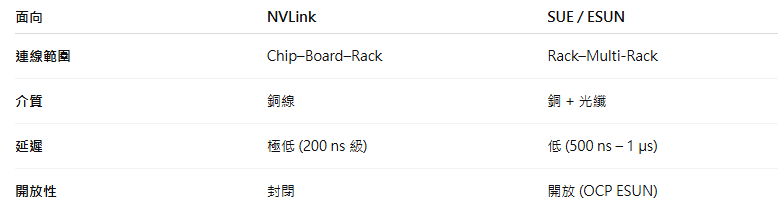
NVLink 與 SUE 共用相同世代 SerDes 技術,上層機制互相借鏡,差別只在 lanes 數量、傳輸介質與距離設計——天下技術本一體,相互學習與優化。
個人心得
硬體的彈性 (NVL72):NVIDIA 透過 NVLink 和 NVSwitch,在單一機櫃內(NVL72)創造了一個前所未有的「Scale-up 域」。這是一個巨大的工程成就,它將 72 個 GPU 變成了一個「單一節點」。
軟體的需求 (無上限):AI 演算法(特別是 Transformer 和 MoE 模型)具有極強的可擴展性。軟體開發者和 AI 研究者會立即「吃滿」硬體提供的任何資源。NVL72 很棒,但很快就不夠用了。
NVL576 上限:於是,NVIDIA 將這個架構擴展到互連的物理極限——576 個 GPU die的 NVLink 網域(Kyber Rack),這代表了「銅線電氣互連」(Copper) 的終極形態。
物理的屏障 (SI/Power/Thermal):
SI (訊號完整性):要維極高高的頻寬,銅線 (Copper) 已經到了極限(<2m@224Gbps or 448Gbps),雖然可用CredoAEC的方式跨機櫃,但要再擴展勢必需要光學 (Optics)。
Power/Thermal:一個 NVL72 機櫃的功耗就高達 120kW。要將 576 個GPU dies用 NVLink 緊密綁定,Kyber Rack可能是資料中心供電和散熱的極限挑戰。
結論:必然的演進 (只好用 ESUN 的方法)
既然 NVLink 這種「純粹的 Scale-up」方法已經達到了物理天花板 (576 GPU dies),但軟體還需要更大的規模 (e.g., 2000, 10000+ GPUs),唯一的出路就是做出取捨。
ESUN” (Ethernet Scale-Up Networking)就是這個「取捨」的具體實現。
放棄了「極致」的效能:無法匹敵 NVLink 的頻寬(少點lanes)和延遲(協定差異)。
它換來了「無限」的規模:透過使用光纖 (Optics),它可以輕易地將「Scale-up」的概念(即支援 All-to-All 等集體通訊)擴展到數千甚至數萬個 XPU。
「Scale-up Scaling」的定義正在被重新改寫。它不再是「物理上侷限於機櫃內的超高頻寬網路 (NVLink)」,而是演變為「一個效能夠好、延遲夠低,能讓超大模型(如 MoE)進行高效能 All-to-All 通訊的大規模乙太網路 (ESUN)」。
NVIDIA 畫出了一條效能的「高牆」(NVL576),而 OCP/ESUN 則試圖建造一條「高速公路」,雖然速限低於高牆內,但卻沒有盡頭。
4. 補充(Meta的觀點)
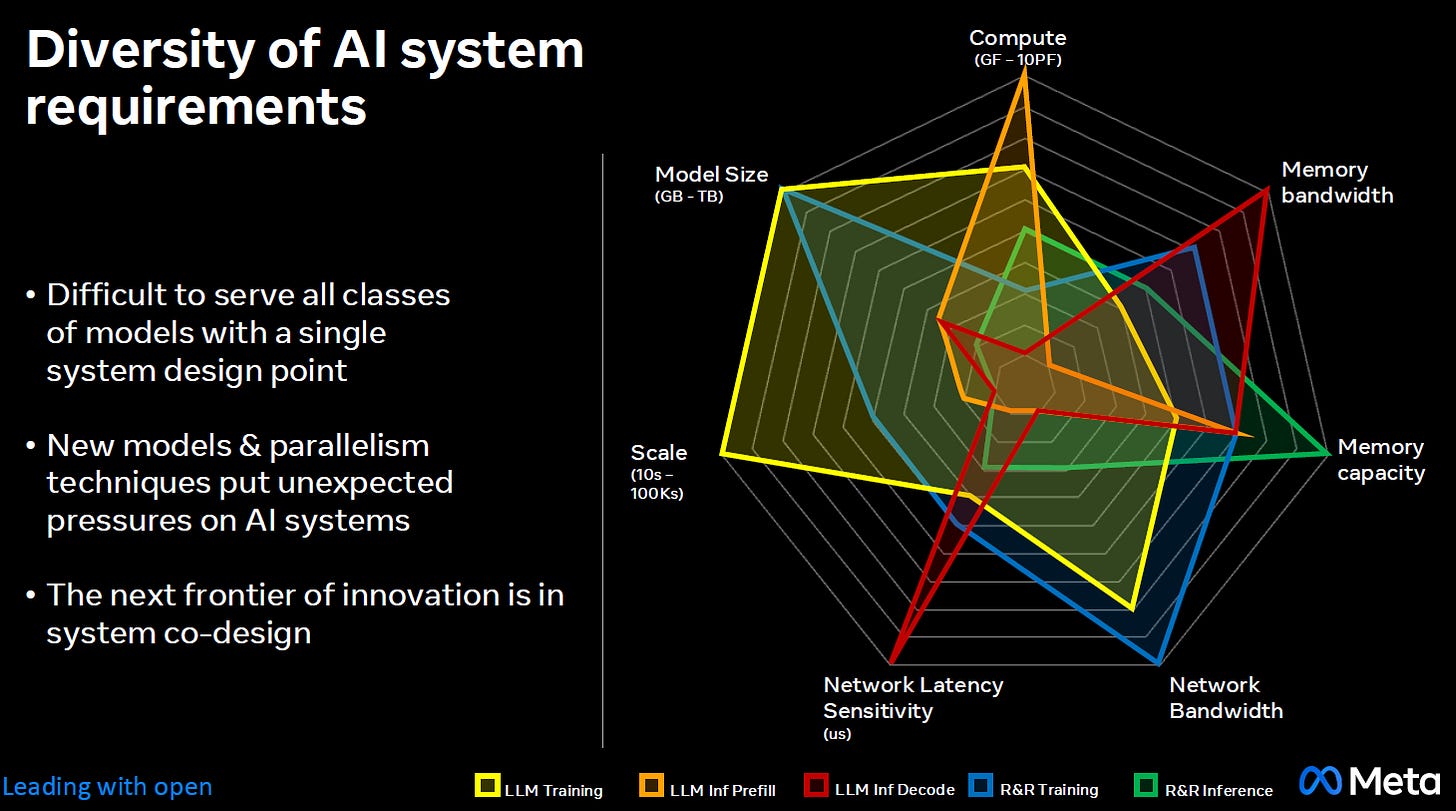
這張來自 Meta 的圖表清楚地說明:
AI系統需求極度多樣化:不同的AI工作負載(如圖表中的LLM訓練、推理、推薦模型(R&R)等)對系統資源(如運算力、記憶體頻寬、網路延遲)的要求截然不同且差異巨大。
單一設計不可行:由於需求的多樣性,很難用單一種系統設計來高效滿足所有類型的AI模型,沒有單一種網路設計能同時滿足所有 AI 任務。
未來在於系統協同設計 (System Co-design):創新的下一個前沿是「系統協同設計」。這意味著硬體和軟體必須共同演進、協同設計,以應對新模型和並行技術帶來的各種壓力
註: Nvidia還特別為LLM Inference Prefill的需求,開發了Rubin CPX(Context Processing aXcelerator)。CPX 的誕生是為了將 LLM 推論拆解成「Prefill」與「Decoding」兩個子任務,藉由 Rubin CPX和 Rubin GPU 協作,實現更高效率、更低成本的 AI 推論架構。
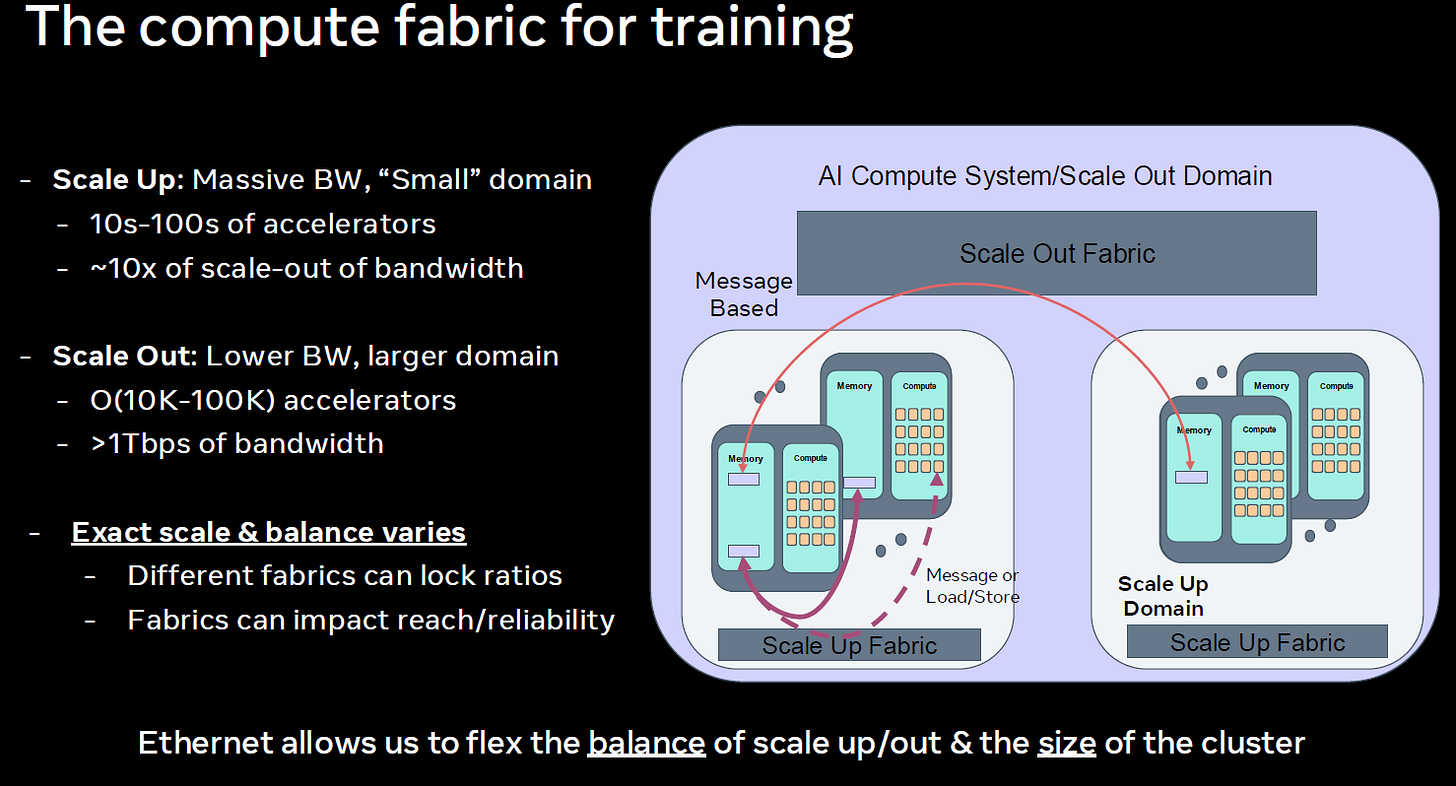
Meta 強調的是:
AI 系統有兩種擴展方式:
Scale Up (向上擴展):在單一節點(或機櫃)內,用極高頻寬把少量 (10s-100s) 的加速器(如 GPU)緊密綁定。這就像是打造一台超級電腦。
Scale Out (向外擴展):用網路將極大量(10K-100K) 的加速器節點連接成一個巨型叢集。這就像是打造一個資料中心規模的超級電腦。
不同 AI 任務需求不同:
不同的 AI 模型(如 LLM 訓練 vs. LLM 推論)對這兩種擴展方式的「配比」要求完全不同。
有些任務可能需要極致的 “Scale Up” 頻寬,有些則可能需要極致的 “Scale Out” 規模。
Meta 的結論:
Meta 需要一個彈性的網路架構,讓他們能夠自由調配 “Scale Up” 和 “Scale Out” 之間的平衡 (balance),以及整個叢集的總體規模 (size)。
他們指出:「乙太網路 (Ethernet) 讓我們能夠彈性地調整 scale up/out 的平衡以及叢集的大小。」
為了滿足多樣化的 AI 需求,他們不能被鎖定在單一、僵化的架構中。Meta之所以選擇乙太網路,是因為乙太網路的開放生態和技術,能提供這種架構上的彈性,讓他們能像「調配方」一樣,為不同 AI 任務客製化「Scale Up」和「Scale Out」的比例。
微軟、Meta、AMD、Intel、Broadcom 等公司大力推動這些開放標準 (Open Standards),如ESUN、UEC、UAL,就是為了建立一個更開放、更具成本效益、供應鏈更多元化的 AI 基礎設施。
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


