前幾回聊了制約AI算力的Communication Wall, Memory Wall, 這次介紹Thermal Wall。人工智慧晶片正面臨一道被稱為「熱牆」的隱形障礙,它不僅制約著晶片的性能和可靠性,也挑戰著封裝和系統級設計的極限。分享個人觀點,歡迎討論。
前幾回聊了制約AI算力的Communication Wall, Memory Wall, 這次介紹Thermal Wall。人工智慧晶片正面臨一道被稱為「熱牆」的隱形障礙,它不僅制約著晶片的性能和可靠性,也挑戰著封裝和系統級設計的極限。分享個人觀點,歡迎討論。
- Source: Ted Yu
- Published: 2025-10-09T07:31:04+08:00
- URL: https://ytyuted.substack.com/p/ep19-thermal-wall EP19. Thermal Wall - Ted Yu
Pledge your support

EP19. Thermal Wall

Oct 09, 2025
前幾回聊了制約AI算力的Communication Wall, Memory Wall, 這次介紹Thermal Wall。人工智慧晶片正面臨一道被稱為「熱牆」的隱形障礙,它不僅制約著晶片的性能和可靠性,也挑戰著封裝和系統級設計的極限。分享個人觀點,歡迎討論。
1. Power
1.1. AI needs Power
下圖中以地球為背景,展示主要城市與大型 AI 資料中心的電力消耗規模比較,說明現代資料中心的耗電量已接近甚至超越世界上最大的城市。

AI 訓練與推理所需的算力劇增,使資料中心的電力需求達到前所未有的規模。這張圖直觀地將主要 AI 中心與城市電力需求對比。

右上角的地圖顯示
👉「Richland Parish Data Center Site Footprint over Manhattan」—— 若將 Meta 2 GW 資料中心的佔地面積疊加在曼哈頓島上,幾乎覆蓋整個Manhattan市區,象徵其巨大的能源需求。
台灣整體電力規模
全台總供電能力:約 40 GW
峰值負載約 39 GW(夏季)
平均實際發電量約 35 GW 左右
各類發電方式典型輸出功率比較

1.2. Power Wall
下圖說明了自 1970 年以來微處理器發展所面臨的「Power Wall(功率牆)」現象,也就是電子元件的效能成長逐漸受到熱功耗與散熱能力的物理極限所制約。
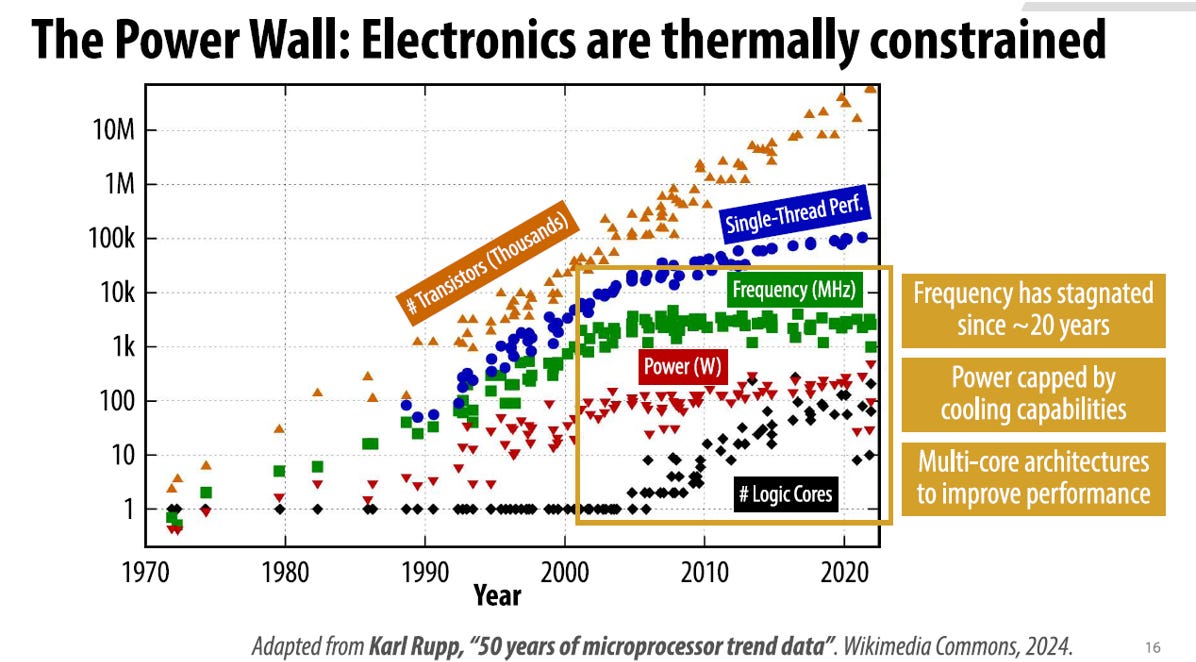
晶體管持續增加,但時脈停滯
雖然晶體管數量依摩爾定律持續呈現指數級增加,但自 2000 年前後開始,時脈頻率(Frequency)幾乎停滯在 3–5 GHz 左右。
主要原因是晶片的功率密度與熱通量已逼近冷卻技術的上限,若再提升時脈,將導致過熱與可靠度下降。
功率受限,效能難再線性提升
與此同時,處理器的總功耗(Power)也在相同時期達到平台期,無法再隨晶體管密度同步上升。
這代表即使製程節點不斷微縮、晶體管愈來愈多,實際運算效能仍受到散熱與能耗上限(Thermal Design Power, TDP)所限制。
多核心架構成為主要突破方向
為了繼續提升整體效能,產業於是轉向多核心架構(Multi-core architectures)與微架構層級的效能最佳化。
藉由平行化運算(parallel computing)與更高的指令效率,在不顯著增加時脈與功耗的前提下,仍能持續提升系統吞吐量。
從頻率驅動轉向平行化時代
總結而言,自 2000 年代以後,單執行緒效能的提升速度明顯放緩,而整體系統效能的成長主要依賴核心數的增加與架構創新。這代表「Power Wall」標誌著從頻率驅動(frequency scaling)轉向平行計算(parallelism)的時代轉折,也揭示出熱設計功耗與散熱能力已成為現代處理器演進的根本瓶頸。
1.3. Power Density
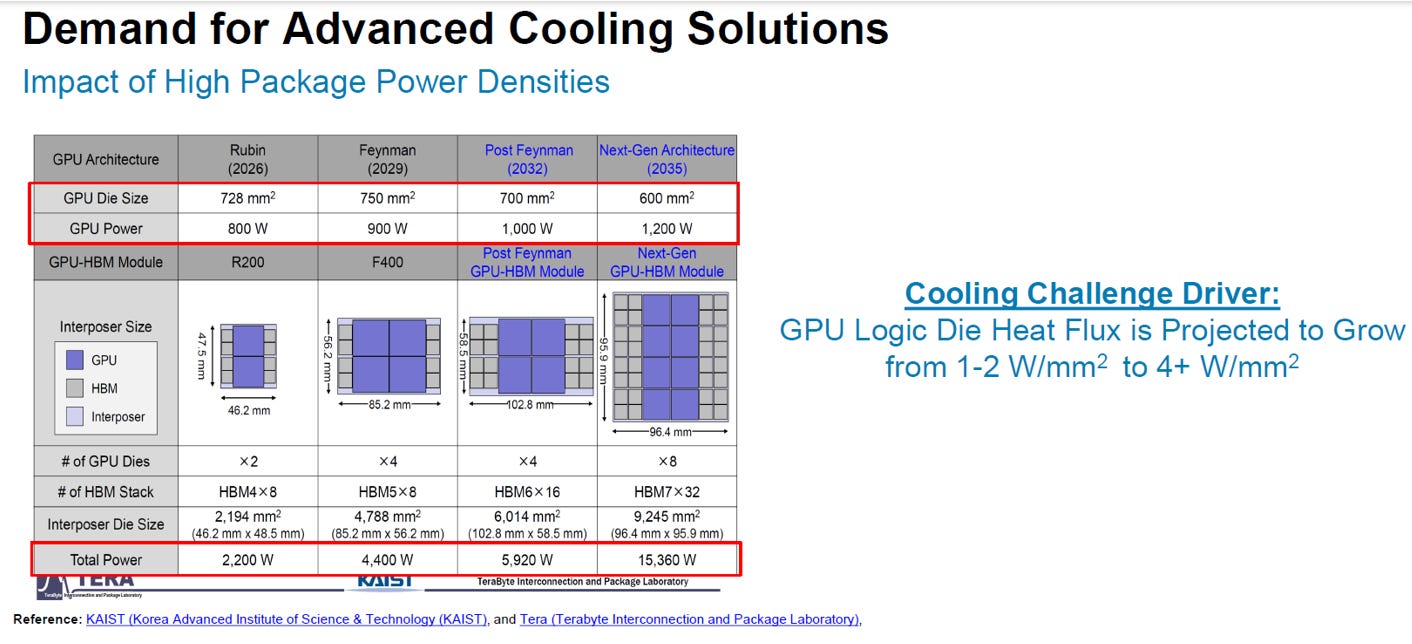
趨勢概述
隨著 GPU 架構從Rubin(2026)→ Feynman(2029)→ Post-Feynman(2032)→ Next-Gen(2035)演進:
晶片面積(GPU Die Size):從約 750 mm² 縮小至 600 mm²;
單顆 GPU 功率(GPU Power):則從 800 W 增至 1,200 W。
這表示單位面積上的功率密度(Power Density)幾乎翻倍,由原本的 1–2 W/mm² 提升至 4 W/mm² 以上。
散熱挑戰核心
由於 GPU 晶片尺寸縮小、運算密度持續提高,而整體功率又不斷增加,熱通量(Heat Flux)將從目前的1–2 W/mm² 上升至 4 W/mm² 以上。
這意味著未來封裝設計必須導入先進冷卻方案才能維持可靠性與效能。
2. Thermal
2.1. Thermal Wall 是 Power Wall 的根本原因
熱散不出 → 晶片溫度上升 → 必須限功耗 → 效能受限
因此,現代處理器不僅受電力供應限制,更受散熱能力決定效能上限。

兩者的關係可以簡化為能量守恆式:
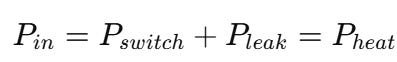
也就是說,晶片消耗的所有電功率終將轉化為熱能。
因此 Thermal Wall 是 Power Wall 的物理表現形式。
式中:
Pswitch(Switching Power,動態功耗)
來源:電晶體在「開關切換」時,充放電電容所消耗的能量,主要功耗來源
公式:

α:開關活動率(switching activity)
C:負載電容
V:工作電壓
f:切換頻率
Pleak(Leakage Power,靜態功耗)
來源:電晶體即使不切換,仍有漏電流
公式:

特性:
與製程微縮、閘極變薄密切相關。
溫度越高、閘極氧化層越薄,漏電越嚴重
2.2. 電晶體 — 底層器件
以TSMC N3E FinFET製程為例,說明底層器件:
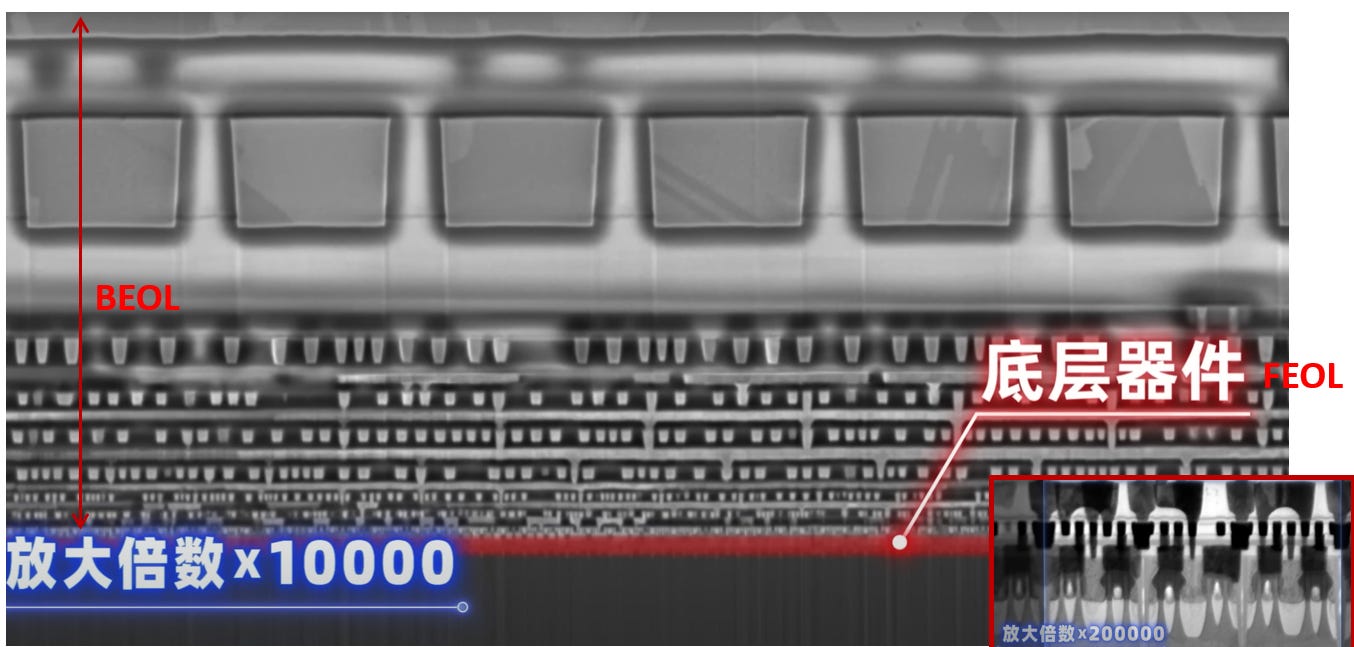
在晶片的功率密度約為1 W/mm²時,這是整體晶片的平均值,實際上底層的有源器件(FEOL,Front End of Line , 僅約100nm)功率密度遠高於平均,集中於晶體管與邏輯閘密集區。這些區域是主要的熱源(hot spots),若散熱設計不足,容易造成局部結溫上升。
由於Si 基板具有良好的導熱性(約 150 W/m·K),主要的熱流會先經由矽傳導;然而其上方的BEOL(Back End of Line) 金屬與介電層(SiO₂、SiCN、SiCOH 等)導熱性差,形成熱阻堆疊,導致熱量難以有效往上擴散。若熱無法及時排出,將導致thermal throttling(熱節流)現象,使電路必須降頻以避免過熱,進而限制整體性能與可靠性。
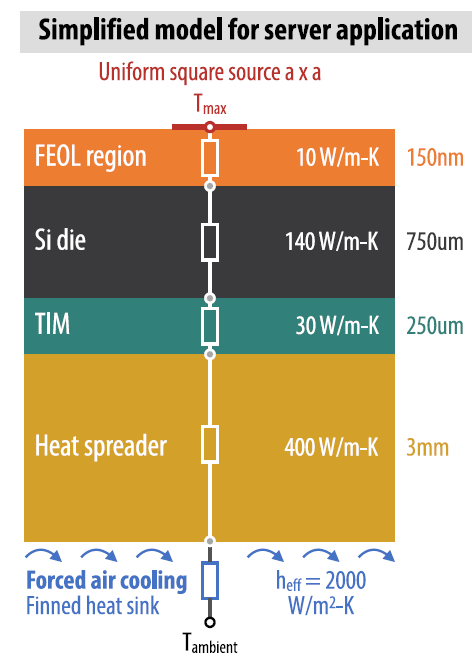
因此在高功率密度設計中,必須透過高效熱通路來強化散熱,使底層高功率器件的熱能能迅速傳導至散熱蓋(lid)與冷卻系統,避免熱積聚。

註: MOL(Middle of Line,中介層)位於 FEOL(前段製程)與 BEOL(後段製程)之間,主要功能是將晶體管的 Source、Drain、Gate 接點導出,連接到上方的金屬互連層。
2.3. Thermal basics

熱傳導與電傳導在數學上雖然形式相同(Fourier 定律與 Ohm 定律皆可寫成梯度與通量的比例關係),但兩者在物理性質上存在根本差異。
電傳導的導電率(σ)可跨達 18 個數量級,從絕緣體到金屬差異極大,並能透過摻雜或外加電場加以調整(如半導體);電流傳導具明確界線與可控性,可形成主動元件。
相對地,熱傳導的熱導率(κ)變化範圍約 3 個數量級,各種材料之間的差異不大,熱量在介面間的過渡較模糊,且整體為被動現象,無法主動控制;因此熱傳遞往往會擴散且受邊界條件強烈影響。
總結來說,熱傳導為被動且擴散性傳遞;電傳導則可主動控制且具明確導通界線,這正是兩者的關鍵差異。

Heat spreading(熱擴散)能將局部集中的熱流由垂直方向(1D)轉為橫向與垂直並行的三維傳導(3D),大幅降低熱阻與熱點溫度。
當高導熱材料位於熱源上方時,熱可先向外擴散再向下傳導,形成更廣的散熱面積;若導熱層過薄或導熱差,熱流受限於垂直方向,易造成局部過熱。
因此,良好的熱擴散結構(高導熱、足夠厚度、正確層次配置)是降低晶片熱阻與防止熱節流的關鍵。
3. Thermal Solutions
3.1. Cold plate
在高功率晶片中,熱量由底部晶片產生後,經由導熱材料與金屬蓋板逐層傳導,最終由冷卻板(或散熱器)將熱帶走。設計要點在於減少介面熱阻與提升熱擴散能力,避免局部熱點與效能降頻(thermal throttling)。

TIM(Thermal Interface Material,熱介面材料)是填充在晶片與散熱器之間的導熱材料,用來降低接觸熱阻、改善散熱效率。
由於晶片與散熱面之間存在微小氣隙(空氣導熱差, ~0.026 W/m·K),TIM 可填補這些空隙,讓熱能更有效地傳導出去,避免晶片過熱。
常見材料與導熱係數:

請參考Mikros的視頻介紹:
3.2. Micro Channel Liquid Cooling Plate(MCLP)
NVIDIA 主導的新一代散熱整合方案 — Micro-Channel Liquid Cooling Plate(MCLP)的概念。以下為簡要介紹:
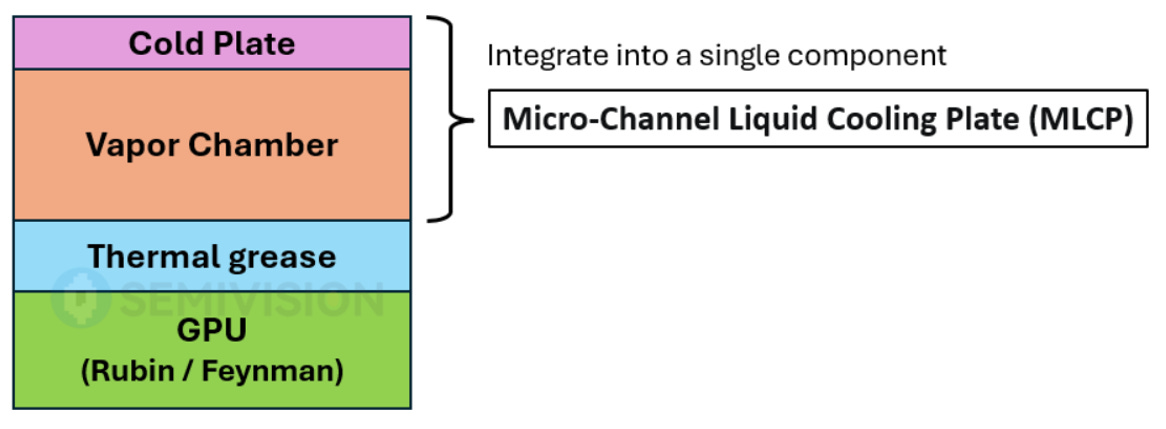
MCLP 的定義
Micro-Channel Liquid Cooling Plate(微通道液冷板)是將
Cold Plate(冷卻板)
Vapor Chamber(均熱板)
Thermal Grease(導熱介面層)
整合成單一高效率液冷模組,直接貼合於GPU(例如 Rubin / Feynman 系列)之上。
結構與原理
傳統架構中,熱流路徑如下:
GPU → Thermal Grease → Vapor Chamber → Cold Plate → 液體冷卻
在 MCLP 中
將冷卻液微通道直接靠近 GPU 熱源,
消除多層界面(TIM、Vapor Chamber 等)的熱阻,
並於冷板內部形成微米級流道(micro-channels),提升對流換熱效率。
冷卻液(通常為水或氟化液)流經微通道時,能迅速帶走熱量,使熱傳遞距離最小化、溫度梯度最低化。

NVIDIA 的主導角色
NVIDIA 為滿足Rubin / Feynman / NVL576 等高功率 GPU(>1 kW/chip)的冷卻需求,正推動MCLP 成為標準化液冷方案,與各大散熱供應商(如 Auras、Mikros、Invek等)合作,希望建立類似OCP的兼容生態。
NVIDIA 的目標是
統一模組規格(機械尺寸、流體接口、熱性能目標),
減少封裝與散熱堆疊高度,
降低組裝複雜度與熱阻,
並支援大規模資料中心液冷部署。
MCLP 是 NVIDIA 推動的高功率 GPU 散熱技術革新重點。它透過將冷卻流道與導熱結構一體化,實現極短熱傳路徑、極高換熱效率,為未來 >1 kW 級 AI GPU 提供可靠的熱管理方案,並成為資料中心液冷架構的重要基礎。
4. New thermal challenges
4.1. New Semi Technologies
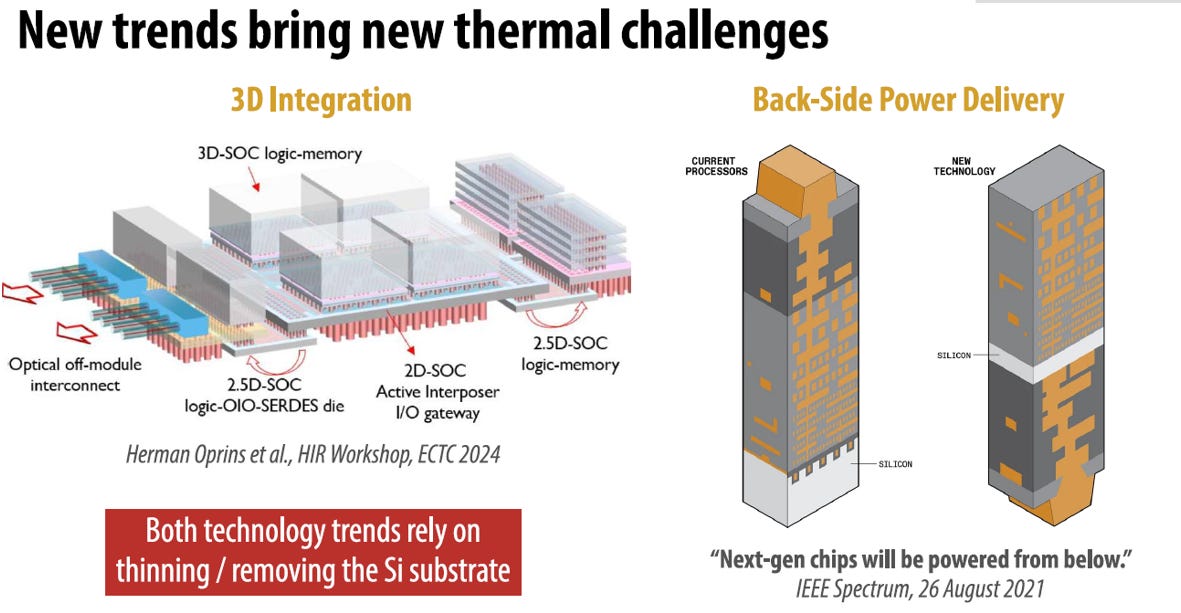
3D Integration(立體堆疊整合)
未來晶片採用3D-SoC與2.5D/3D 混合堆疊架構,將邏輯(logic)、記憶體(memory)、光 I/O(OIO)、SerDes等多層異質晶片垂直整合於同一封裝中。
此結構提高了晶片密度與資料傳輸效率,但也造成熱量集中、散熱受阻,特別是中層晶片難以直接接觸冷卻介面。
圖中指出部分區域透過Active Interposer或Optical off-module interconnect提升傳輸性能,但熱路徑變長、熱阻上升。
挑戰:3D 結構中的中層與底層邏輯層,熱難以上傳至散熱蓋或冷板,形成局部熱堆積。

Backside Power Delivery(背面供電網路,BSPDN)
傳統處理器採用Front-Side Power Delivery(FSPDN),電源線與訊號金屬層位於晶片正面。
新技術則透過矽基板背面穿孔(nano-TSV / backside via)進行供電,
將電源從下方注入晶片。
這樣可釋放前端金屬層(BEOL)供訊號使用,縮短路徑、降低 IR drop。
然而,此結構需要減薄或移除矽基板(Si thinning / removal),造成熱傳導面積減少,使垂直導熱能力下降,更難導出熱量。
👉挑戰:背面供電改善電性能,但削弱了熱傳導通道,使晶片更依賴上方散熱。
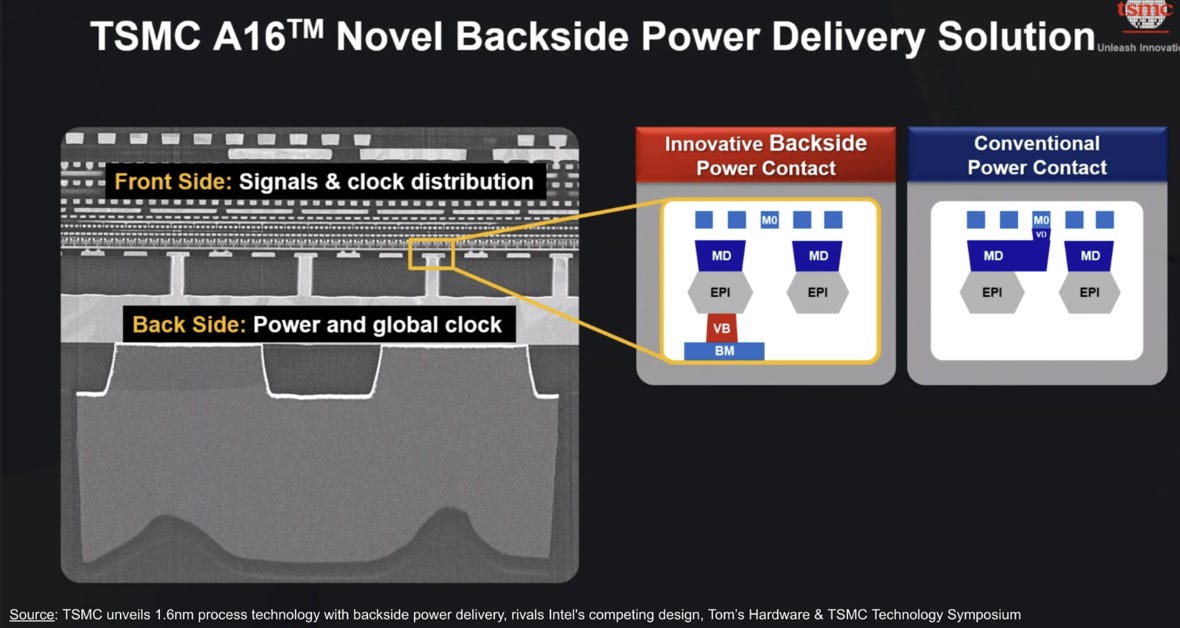
共通熱挑戰
這兩項技術(3D 堆疊與 BSPDN)都依賴矽基板減薄或移除,導致晶片下方導熱路徑變差、熱流更集中於局部,需開發新型散熱策略
4.2. Direct to Silicon Cooling
下圖展示了先進晶片散熱的三階段演進路線(Thermal 3-step roadmap):從傳統板級冷卻逐步邁向晶片級(Direct-to-Silicon)整合散熱。晶片散熱正從外部冷板,演進至封裝內液冷,最終實現直接矽面液冷(Direct-to-Silicon Cooling),每一階段皆透過消除熱界面(TIM)以降低熱阻、提升散熱效率。
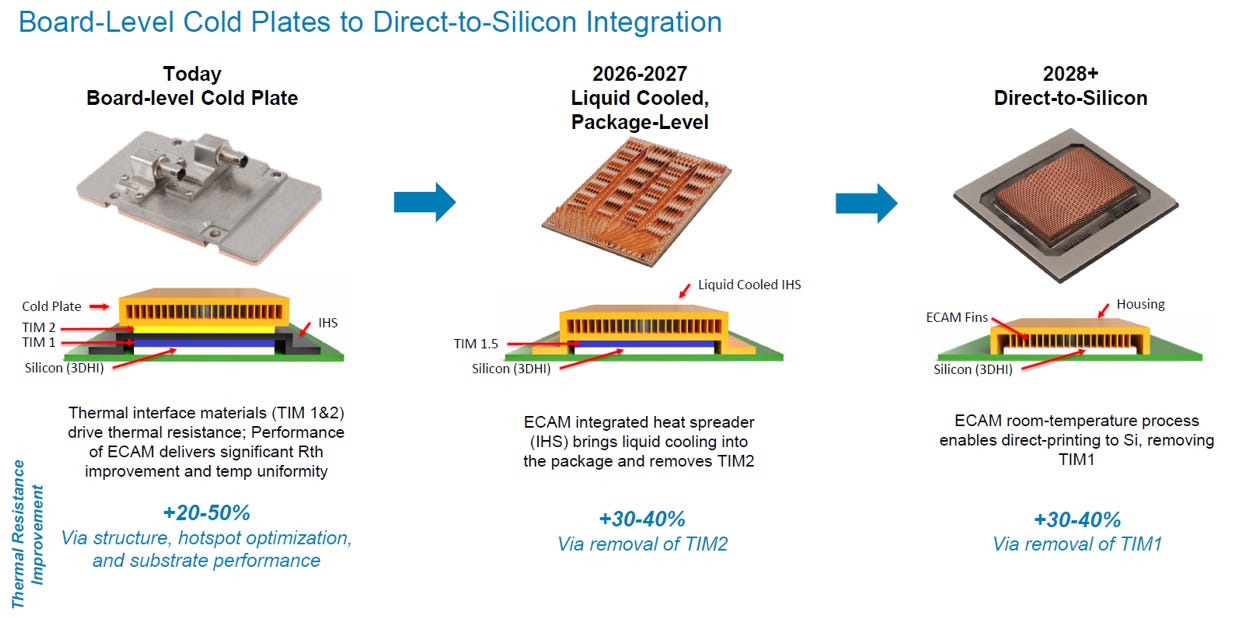
第一階段(Today)
Board-Level Cold Plate(傳統板級冷卻)
冷板(Cold Plate)位於封裝外部,經由兩層導熱介面材料(TIM1 + TIM2)與晶片相連。
散熱路徑長,界面熱阻大。
熱阻主要由結構厚度、熱點分佈與基板導熱性決定。
熱阻改善潛力:+20~50%
透過結構優化、熱點分佈設計與材料改良。
第二階段(2026–2027)
Liquid-Cooled, Package-Level(封裝級液冷)
整合式散熱蓋(IHS),在封裝內直接引入液冷通道。
移除 TIM2,冷卻液直接接觸 IHS 底部,大幅縮短熱傳路徑。
提升熱交換效率,封裝層內即可分散熱負載。
熱阻再降:+30~40%,來自移除 TIM2 的界面熱阻。
MCLP(Micro-Channel Liquid Cooling Plate)屬於第二階段
第三階段(2028+)
Direct-to-Silicon Integration(直接晶片液冷)
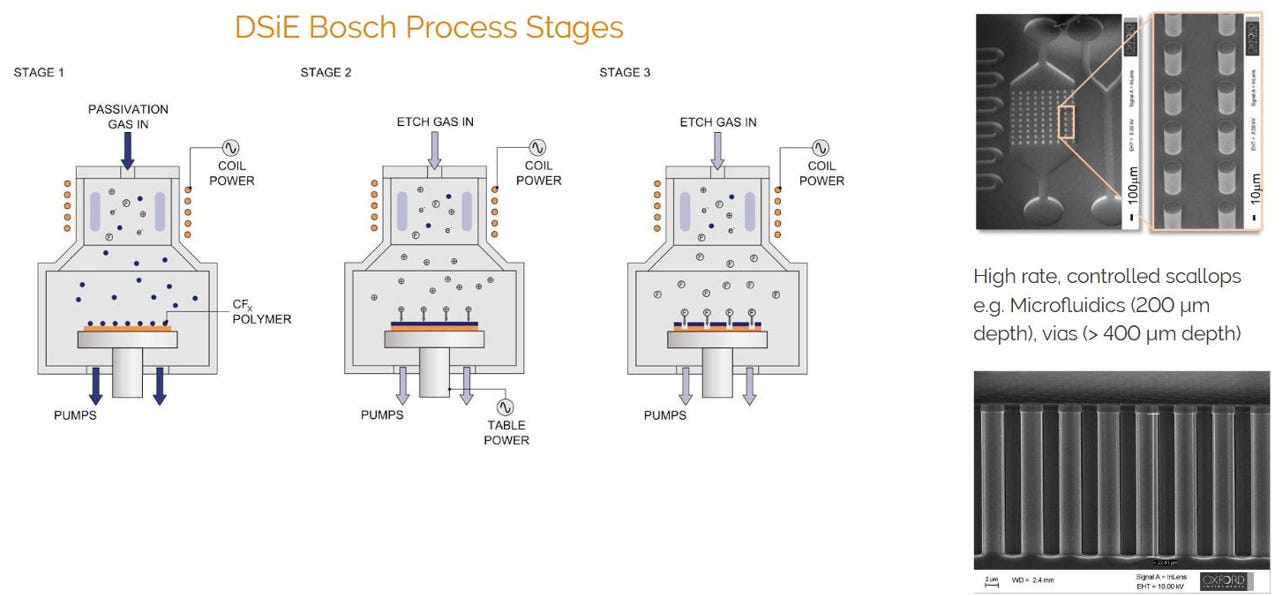
於矽晶圓上以蝕刻/雷射形成微流道結構,形成Direct-to-Silicon Cooling。
無需任何 TIM(移除 TIM1),冷卻液可直接與晶片矽表面接觸。
消除所有中間熱界面,實現最低熱阻與最高冷卻效率。
再降:+30~40% 熱阻,來自移除 TIM1,達到「矽直接冷卻」極限。
4.3. TSMC Direct to Silicon Solution
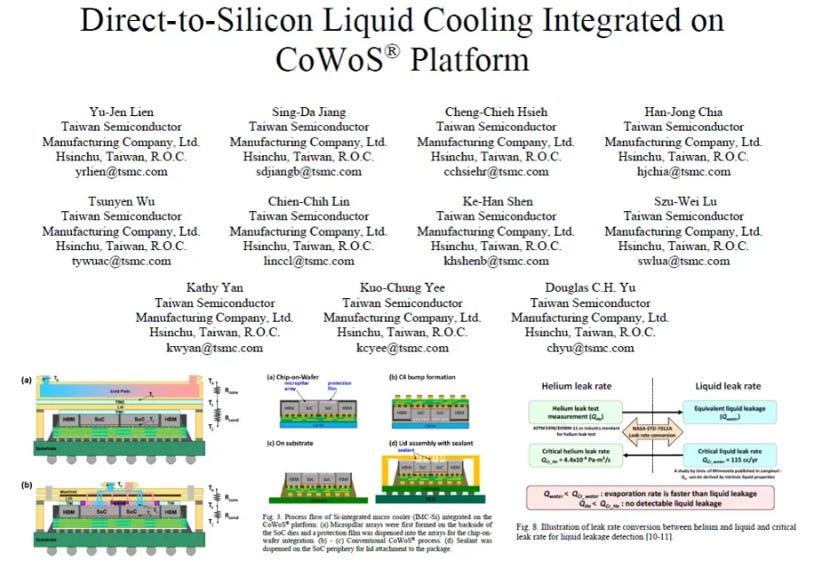
技術概念
TSMC 將微流道液冷結構直接整合於矽晶片背面,使冷卻液直接接觸(或極接近)晶片矽層,實現最短熱傳距離、最低熱阻(Rₜₕ)。與傳統相比,這已是進一步的Direct-to-Si Cooling,不再需要 TIM1/TIM2,也不再依賴獨立的冷板結構。
製程整合步驟
(a) Direct-to-Si 微流道形成流程:
CoWoS 晶片封裝完成後進行 Si thinning(薄化晶圓),
在背面以蝕刻/雷射形成微流道結構(Bosch Process)
以薄膜封蓋(lid formation)封住流道上層,
整合接頭與密封材料(sealant) 以防液體滲漏。
(b) 封裝後整體組裝:
液冷流道與 CoWoS 矽中介層緊密結合,
可與 HBM、邏輯晶片同時封裝於同一基板上,
實現封裝與液冷一體化的高整合平台。
可靠性驗證機制
Helium leak rate test(氦氣洩漏檢測):
用於驗證液冷流道封裝的氣密性。
Liquid leak rate test(液體滲漏測試):
驗證液體冷卻迴路在高壓運行下的穩定性。
→ 通過氣液臨界壓差測試(ΔP),確保封裝無滲漏。
4.4. Fabric8Labs new technology
Fabric8Labs是一家位於美國聖地牙哥的先進製造公司,專注於開發電化學增材製造技術(Electrochemical Additive Manufacturing,ECAM)。
該公司以電鍍原理為基礎,結合高解析度微電極控制與即時沉積演算法,能在室溫環境下直接沉積高純度金屬(如銅、鎳),形成微米級精度的三維結構。
Fabric8Labs 的技術可用於:
高導熱結構(微流道、銅鰭片)
半導體封裝與散熱模組(Direct-to-Silicon Cooling)
精密電子與感測元件製造
其核心優勢為無粉末、無熔融、無熱應力、材料利用率接近 100%,
被視為新世代半導體散熱與高密度封裝的關鍵製造平台。
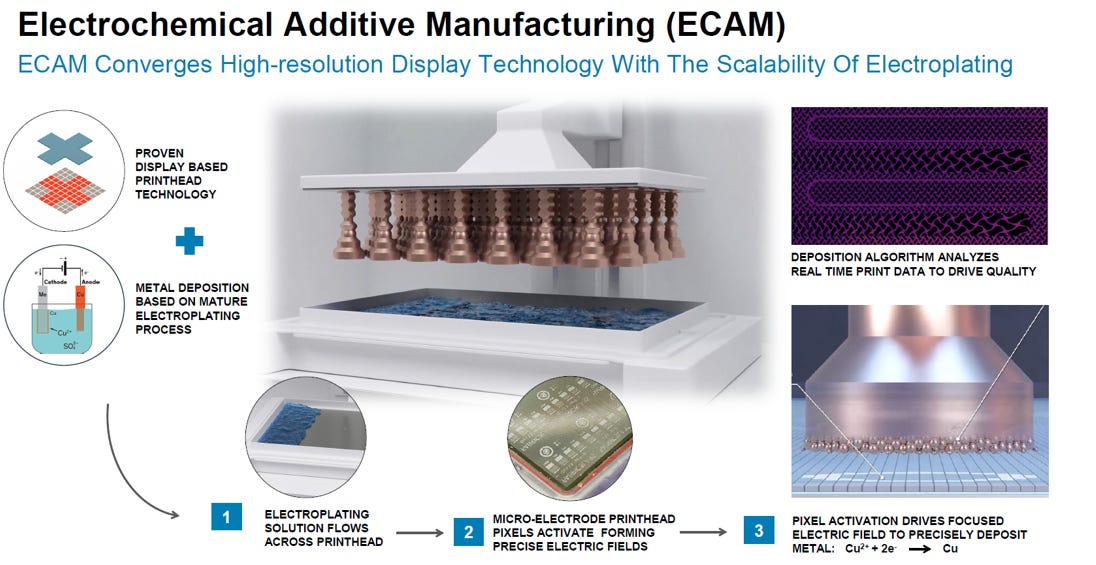
ECAM(Electrochemical Additive Manufacturing)是由Fabric8Labs開發的新型金屬增材製程,結合「高解析度印刷頭技術」與「電化學金屬沉積(Electroplating)」原理。
此技術透過微電極陣列(micro-electrode printhead)在液態電解溶液中精確控制局部電場,使金屬離子(如 Cu²⁺)在指定位置還原成固態金屬,達到常溫、無粉末、無熱應力的高精度金屬列印。
ECAM 可直接製作微流道、散熱鰭片與高密度導電結構,特別適用於 Direct-to-Silicon 液冷與高功率封裝散熱,被視為未來晶片級冷卻與高密度整合封裝的重要關鍵技術。

透過 ECAM 可直接列印符合晶片功率分佈的微流道設計,並由演算法自動生成最佳通道幾何。
這讓冷卻液能在高熱通區域形成更高流速與更佳熱交換,達到真正的「功率地圖導向散熱」。
關鍵優點
✅ 熱均勻性提升(Eliminates Hot Spots)
ECAM 可依晶片功率分佈定制流道,使冷卻液針對高功率區域加強散熱。
✅ 熱阻顯著降低(–38.6%)
改善熱傳導與流體對流效率,使散熱板整體性能提升。
✅ 高精度幾何控制
微米級列印能力能實現傳統機加工難以達到的流道形貌。
✅ 單相冷卻設計(Single-Phase Cooling)
結構穩定、易整合於封裝層內(MCLP 或 Direct-to-Si)。
Fabric8Labs 的 ECAM 液冷方案可依晶片功率地圖量身定制微流道,實現更低熱阻、更均勻的散熱表現,成功消除熱點,是 AI 晶片封裝散熱的下一代核心技術。
4.5. Thermal Supply Chain
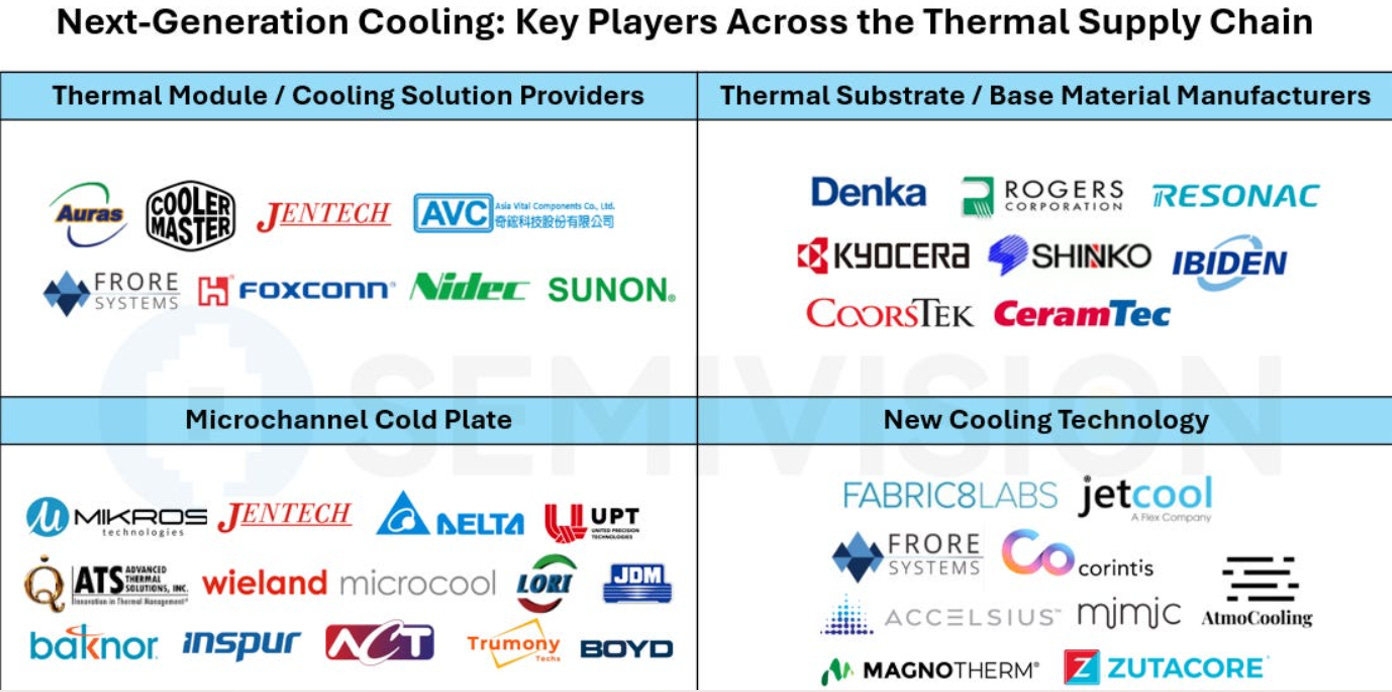
此圖揭示了從材料 → 基板 → 模組 → 系統的完整熱管理供應鏈。
傳統風冷模組正逐步被液冷與微通道冷卻技術取代,而新創公司正在推動封裝級、晶片級散熱(Direct-to-Si Cooling),以應對AI 晶片超過 1 W/mm² 的熱通量挑戰。
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


