Marvell專家, Mark Kuemerle, 在Hotchips 2025介紹他們解決Memory Wall的方法, 值得參考。摘要內容分享,歡迎討論。
Marvell專家, Mark Kuemerle, 在Hotchips 2025介紹他們解決Memory Wall的方法, 值得參考。摘要內容分享,歡迎討論。
- Source: Ted Yu
- Published: 2025-10-02T14:31:38+08:00
- URL: https://ytyuted.substack.com/p/ep18-memory-wall EP18. Memory Wall - Ted Yu
Pledge your support

EP18. Memory Wall

Oct 02, 2025
Marvell專家, Mark Kuemerle, 在Hotchips 2025介紹他們解決Memory Wall的方法, 值得參考。摘要內容分享,歡迎討論。
1. Memory Wall
Memory Wall(記憶牆)是指運算單元(如 GPU、TPU、XPU)性能提升速度遠快於記憶體容量與頻寬成長,造成資料傳輸延遲成為系統瓶頸。隨著大型 AI 模型參數量每兩年暴增數百倍,單卡記憶體無法容納整個模型,需頻繁進行跨卡資料交換,導致運算單元閒置、效能下降與能耗上升。這使 AI 發展從「算力受限時代」進入「記憶體與頻寬受限時代」,成為目前最關鍵的系統瓶頸。
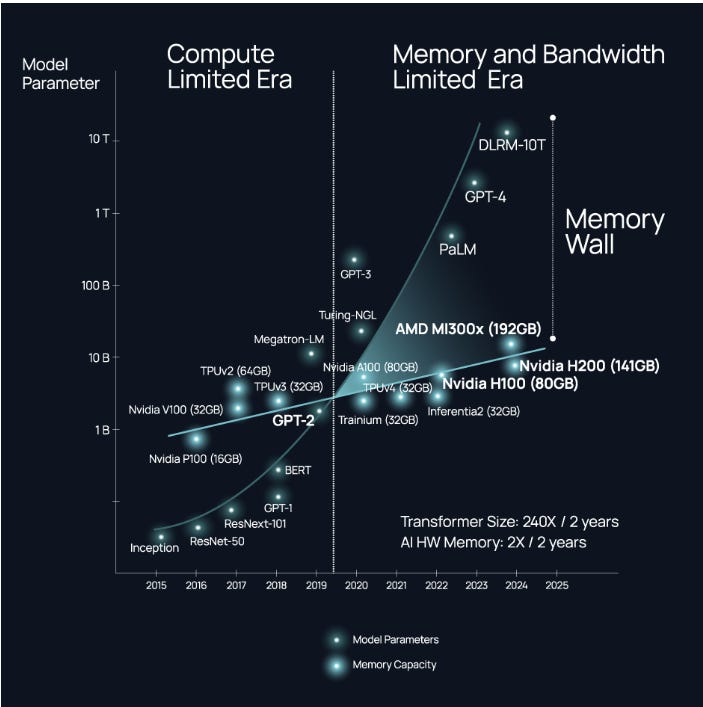
AI 晶片的記憶體架構可分為多層:SRAM、HBM(High Bandwidth Memory)、DDR,各自扮演不同角色。
SRAM:位於晶片內部,作為暫存資料與中介結果的快取層(Cache),具極低延遲與高頻寬,但容量有限。
HBM:與晶片共封裝(如 2.5D CoWoS),提供主運算所需的大容量與高頻寬資料存取,是訓練大型模型的主要工作記憶體。
DDR:位於外部,容量最大但延遲高,主要作為冷資料或批次輸入的儲存層。
AI 晶片必須透過D2D、SerDes等高速互連技術在這些記憶層間傳輸資料。記憶體架構決定模型能載入的大小、資料交換速度與整體能效,因此是 AI 系統性能與擴展性的關鍵核心。


AI 晶片的記憶體階層呈現「SRAM (快) → HBM (平衡) → DDR (大)」。
在Training中,HBM 是效能核心,SRAM 負責即時資料暫存;
在Inference中,SRAM 與 HBM 主導延遲與吞吐,DDR 提供擴充容量。
記憶體架構設計直接決定 AI 系統的運算效率與能耗表現。
2. SRAM
2.1. SRAM 的演進
從 1961 年Robert Noyce在 Fairchild 製作的第一個矽基積體電路(4 BJT):

早期的 SRAM 原型由雙晶體管交叉連接構成,可穩定保持邏輯「0」或「1」,是最早的可儲存電路形式。隨後,這一概念演變為現代6T 結構:由兩組交叉反相器(4T)形成記憶節點(Q、Qb),再透過兩個控制電晶體(N2、N3)與字線(WL)和位線(BL、BLB)相連,以進行讀寫操作。

上圖的 SEM 顯示現代 SRAM 單元僅約0.16 µm²,採用 FinFET 製程與高密度佈局。SRAM 不需像 DRAM 一樣刷新,速度快、延遲低,適合做為CPU/GPU/AI 晶片內部的快取記憶體,用於暫存激活值與中間結果,減少對外部 HBM 或 DDR 的頻繁訪問。
SRAM 是從早期雙晶體管儲存電路演化而來的高速度記憶體,其穩定結構與極低延遲使其成為 AI 晶片中最關鍵的「on-die 記憶層」。
2.2. Marvell Dense SRAM
Marvell使用 Dense SRAM(高密度靜態記憶體)的設計。
Dense SRAM 位於晶片核心區,屬於on-die memory,介於運算單元與外部記憶體(HBM與DDR)之間,透過D2D(Die-to-Die)與SerDes高速互連傳輸資料。與傳統 SRAM 相比,Dense SRAM 透過先進製程(如 FinFET、GAA)與緊密佈局,大幅提升單位面積儲存密度,同時保有低延遲與高頻寬特性。
在AI 加速器中,Dense SRAM 用於暫存 activation、梯度與中間張量,減少對 HBM 的頻繁訪問,提升能效與吞吐率。整體上,Dense SRAM 是連結「高頻寬 HBM」與「低延遲運算核心」的關鍵中介層,決定 AI 晶片的實際效能與資料重用效率。
Marvell 在 2 nm 節點的 dense SRAM(高密度靜態記憶體)研發成果:

Marvell 長期將自家SRAM IP佈局於各主要製程的首批 shuttle wafer(類似MPW(Multi-Project Wafer,多專案晶圓)),用以驗證新節點電晶體性能與製程穩定性。
這一代的2 nm dense SRAM採用TSMC 2 nm GAA(環繞閘極)技術製作,目標是在相同面積下提供更高的位元密度與更低的漏電功耗。其設計經過針對資料中心產品(XPU、Switch、NIC)優化,能在極高頻寬運算中提供低延遲的快取記憶功能。
從圖可見,多個 SRAM macro(SRAMxU)模組整齊排列,搭配 ESD 保護與 GPIO 介面區塊,代表這是用於先進製程平台測試的實體晶片布局。
整體而言,Marvell dense SRAM為 2 nm 時代的關鍵記憶體 IP,兼具高密度、低功耗與高可靠度,並成為 Marvell AI 加速器與通訊晶片架構的核心組件。
Marvell 自研 Custom SRAM在效能與能效上相較於一般可授權(licensable)SRAM 的明顯優勢。
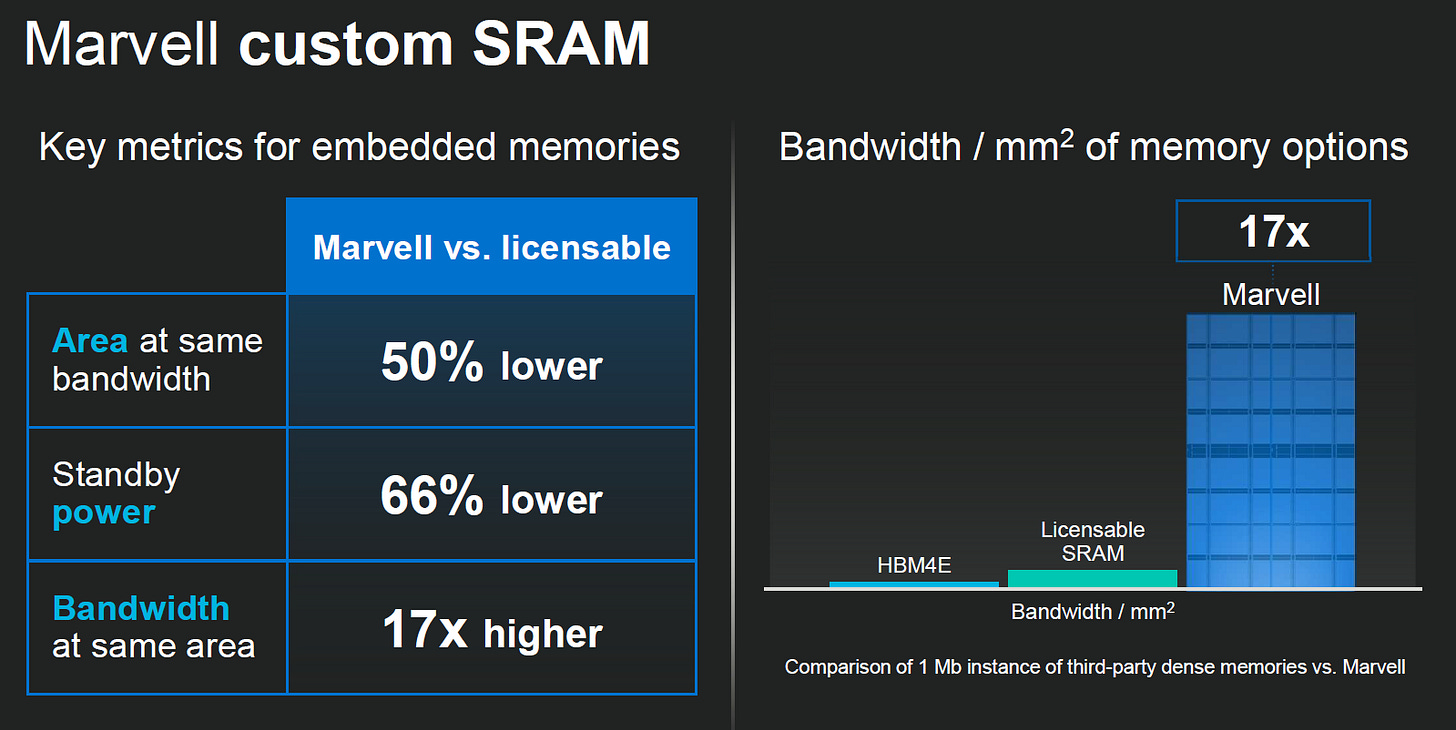
在相同頻寬下,面積減少 50%,代表單位晶片面積可容納更多記憶體單元,提升密度;待機功耗降低 66%,顯示其設計在低活動時能有效節能,適合資料中心與 AI 晶片長時間運作需求。最關鍵的是,在相同面積條件下,頻寬提升達 17 倍,遠超傳統 SRAM 與 HBM4E。
這些改進源於 Marvell 在 2 nm 製程下對 SRAM 結構與資料通道的最佳化,使其成為具備高頻寬密度、低功耗與高效率的嵌入式記憶體方案,特別適合應用於AI 加速器、Switch、NIC、XPU等高效能晶片。
Marvell Dense / Custom SRAM 之所以能達到 17× 頻寬提升的三個主要來源,分別來自三種設計手法的疊加效應:
1️⃣ Run Faster(提升運作頻率)
Marvell 透過先進電路與路徑最佳化,讓 SRAM 陣列與外圍讀寫電路能在更高頻下穩定工作。
頻寬提升約2–2.5×。
使用相同 bitcell 與 array 結構,但強化 pipeline、I/O buffer 與時脈樹設計。
優化 bitline / wordline RC 延遲,使大容量 SRAM 不隨面積增大而顯著降速。
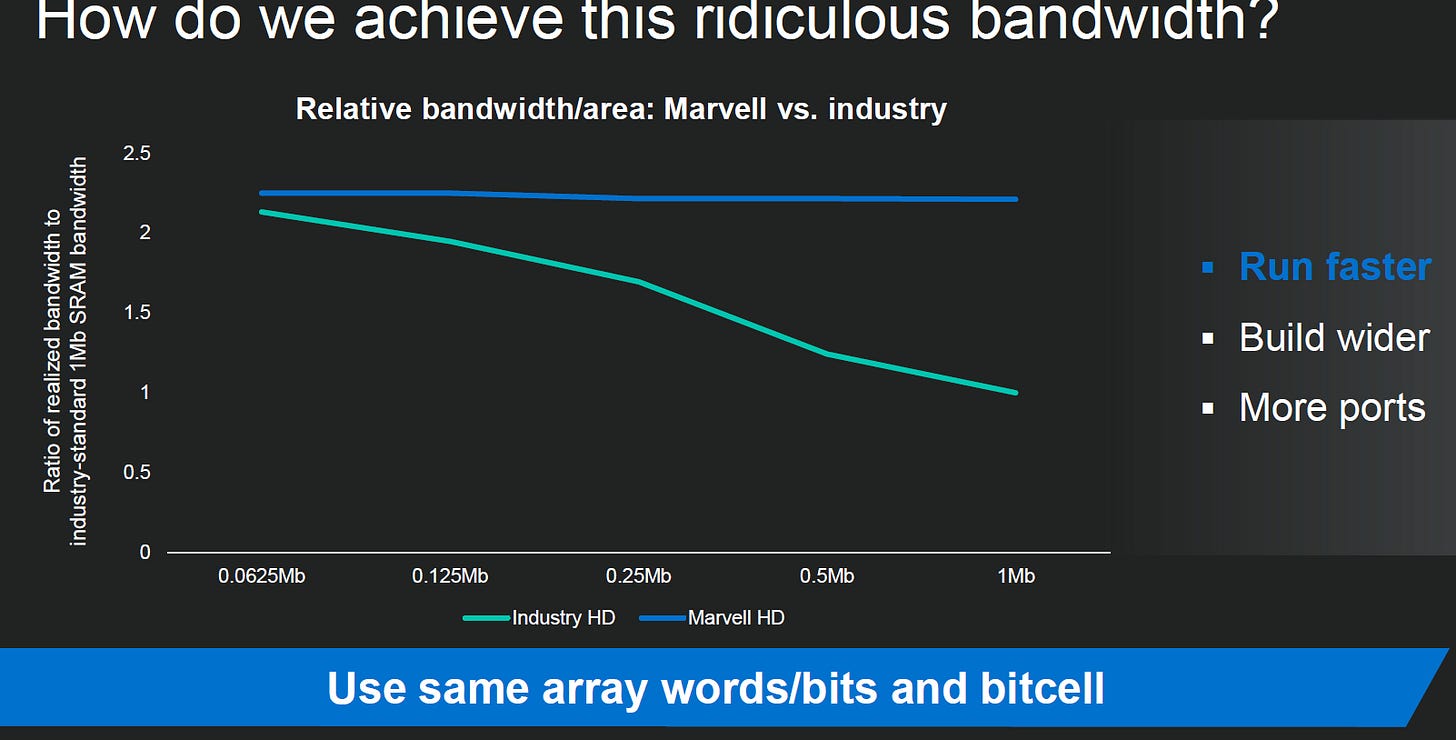
2️⃣ Build Wider(加寬存取位元寬度)
Marvell 採用更寬的資料路徑(bus width),在同一週期可讀寫更多資料字(words)。
頻寬再提升約3–4×。
相比一般 licensable SRAM 每次僅能傳輸 32–64 bit,Marvell macro 可達數百 bit。
利用 GAA 2 nm 製程高驅動能力,使大匯流排仍維持低功耗。

3️⃣ More Ports(多埠並行操作)
在高階應用(AI/XPU)中,Marvell 增加多個讀寫埠(multi-port),允許多資料流同時訪問。
頻寬再提升約2–3×。
多 port 架構使不同運算模組可並行存取 SRAM,不需 time-multiplex。
搭配區域化 bank 分割,維持低衝突率與高吞吐。

Marvell 的 17× 頻寬優勢來自三層並進的設計哲學——在相同面積下讓 SRAM跑得更快、資料通道更寬、同時可多路訪問。
這使其在 2 nm 節點成為業界頻寬密度最高的嵌入式記憶體之一
大廠如 Marvell、NVIDIA、AMD、Apple 等多採用自研dense SRAM macro,而非直接使用晶圓廠提供的standard SRAM compiler。主要原因在於標準 SRAM 著重通用性與製程良率,難以滿足高效能晶片的極端需求。
自研 SRAM 可針對晶片架構進行功耗、延遲與面積(PPA)最佳化,提升記憶體密度 20~40%,同時降低讀寫延遲與能耗。此外,大廠會加入特殊功能,如多埠存取、寬匯流排與區域快取分割,以支援 AI 訓練、HPC 或高速網通等特定應用。
另外,自研 SRAM 具跨製程重用性與差異化優勢,可在不同節點沿用同一 IP 架構,減少對 Foundry 的依賴。
2.3. AMD 3D V-Cache case
AMD 3D V-Cache是一種利用3D 垂直堆疊(3D Vertical stacking)技術的高密度 SRAM 快取架構。它將額外的L3 SRAM 快取晶片以TSV (Through-Silicon Via)與Hybrid Bonding技術堆疊在 CPU 運算晶片(CCD)上方,形成垂直擴充的快取層。
此設計可在不增加核心面積的情況下,大幅提升 L3 快取容量(例如 Ryzen 7000X3D 從 32 MB 擴充至 96 MB),降低資料存取延遲並提高命中率。
3D V-Cache 具備低功耗、高頻寬與高密度等優勢,特別適合遊戲、AI 推論與技術運算(HPC),讓 CPU 能更接近資料、減少外部 DDR 或 HBM 訪問需求。

AMD 3D V-Cache 著重提升 CPU 快取容量,以改善記憶體延遲與效能;
Marvell Dense SRAM 則聚焦於 2 nm 節點下的高密度與低功耗設計,成為 AI 與 資料中心晶片的關鍵 SRAM 解決方案。
3. HBM
3.1. 簡介
HBM(High Bandwidth Memory,高頻寬記憶體)是一種以3D 堆疊技術製成的高效能 DRAM,專為 GPU、AI 加速器與 HPC 晶片設計,用以突破傳統 DDR 記憶體頻寬不足的瓶頸(參考EP8. HBM technologies)

如圖所示,HBM 由多層Standard DRAM die(一般 DRAM 晶片)垂直堆疊,底部連接一層Custom base die,內含TSV(Through-Silicon Via,矽穿孔導通)與微凸塊(micro-bump)結構,將各層 DRAM 與邏輯層高速連接。整體再與主晶片(如 GPU 或 AI SoC)透過2.5D 矽中介層(interposer)相連。
HBM 具有極高頻寬(目前 HBM3E 可達 1 TB/s 以上)、低功耗與緊密封裝的優勢,但製造成本高、散熱挑戰大。
在現代 AI 系統中,HBM 是主要的「工作記憶體」,搭配 on-die SRAM 共同支撐模型參數、激活值與梯度的高速傳輸。

3.2. Custom HBM
Marvell Custom HBM是針對 AI 與資料中心應用重新設計的高頻寬記憶體架構,結合客製化 base die與AI 專用 D2D 互連(Die-to-Die PHY),以取代傳統 HBM–GPU 之間的標準介面。

如圖所示,Marvell 將HBM Memory Controller下移至邏輯基板(logic base die),並以D2D PHY直接連接運算核心,使資料傳輸更短、更高速,同時降低功耗與延遲。此設計同時整合RAS(可靠度、可用性、可維修性)、Telemetry(即時監測)與QoS(服務品質)等模組,以提升資料完整性與系統可觀測性。
整體而言,Custom HBM 不只是記憶體堆疊,而是將記憶體控制、協定、與高速互連電路整合到邏輯層的新一代封裝記憶體架構,具備更高的頻寬密度、更低延遲,特別適用於大型 AI 加速器與可擴充計算平台。

在傳統 HBM 中,整個堆疊(包含HBM Core Die與底部的Standard Logic Base Die)均由記憶體廠(如 Samsung、SK hynix、Micron)製造;GPU 或加速器僅透過 2.5D interposer 與其連接。
然而在Custom HBM 架構中,HBM Logic Base Die(邏輯基板)由 Foundry(如 TSMC)負責製造,並依客戶(如 NVIDIA、AMD、Marvell)需求客製化。這層邏輯基板可整合:
HBM Memory Controller、D2D PHY、QoS/RAS Telemetry;
甚至可加入部分AI 協同運算或資料搬移邏輯;
與 GPU/AI Chip 採同一製程節點(如 TSMC 5nm / 3nm / 2nm)以提升介面速度與能效。
此變革使 HBM 從「記憶體產品」轉為「系統共設計元件」,由 TSMC 扮演關鍵角色,整合HBM + GPU/AI Die + Interposer成為統一封裝平台。
其影響包括:
Foundry 主導權上升:TSMC 不僅製造 GPU,也製作 HBM 邏輯層,掌握整體信號完整性與功耗優化。
記憶體廠角色弱化:僅負責 DRAM core die 生產,無法完全控制整體模組。
系統整合度與頻寬提升:邏輯層與 GPU 採同製程,能支援更高頻 D2D 連線與更低延遲
總結來說,Custom HBM 將邏輯層設計權轉向 Foundry(TSMC),形成 GPU 與記憶體「共設計、共封裝」的新生態,是下一代 AI 與 HPC 記憶體整合的核心趨勢。
3.3. Cost Issue
HBM(高頻寬記憶體)在 GPU 總物料成本(BoM)中的占比快速上升趨勢。

從 NVIDIA 各代晶片可見:
A100 (80 GB)時代,HBM 佔整體成本約39%;
H100降至35%,主要因封裝與製程成本占比提升;
H200 (HBM3E)則上升至50%;
GB200 (NVL72)提升至51%;
GB300 (Rubin NVL72)預估將高達61%。
這代表在最新 AI 加速器中,HBM 已成為單一成本最高的元件,其價格隨容量(80 GB → 192 GB → 288 GB)與頻寬(3.0 Tb/s → 8 Tb/s)急遽上升。
隨著 AI 模型參數規模與記憶體頻寬需求持續增長,HBM 成本將主導整體 GPU 經濟性,推動產業發展出Custom HBM Base Die、Chiplet DRAM Controller等方案,以降低功耗並提升效能成本比
3.4. Nvidia Rubin CPX w/o using HBM
LLM 推論分為兩階段:
Context / Prefill:輸入長序列時的運算階段,屬Compute-bound。
Generation / Decode:逐 token 生成階段,屬Memory-bound。
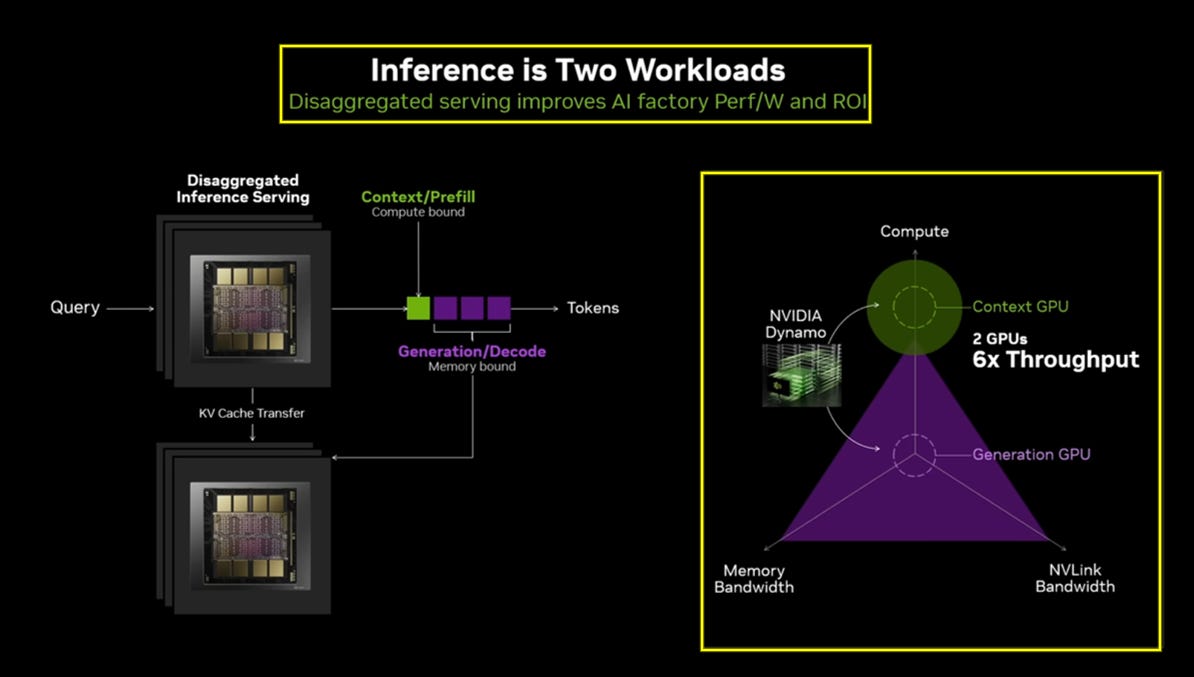
過去這兩個階段都由同一顆 GPU 負責,導致:
Compute 資源閒置於記憶體受限階段;
HBM 成本高但利用率不均;
整體功耗與效能效率下降
CPX 的設計目的:
將運算密集與記憶體密集分離(Disaggregated Inference):
由 CPX 處理前段運算(Prefill),
由 GB300 處理生成(Decode)。
降低 HBM 成本:
CPX 改採 外接 GDDR7(128 GB),省去 HBM 堆疊與封裝成本。
提升能源效率與效能利用率:
讓每顆 GPU 針對專屬任務最佳化,提升Perf/W。
改善資料中心 ROI 與可擴展性:
Context GPU 可重複利用於多模型前置運算,整體吞吐量提升最高達6×

CPX 的誕生是為了將 LLM 推論拆解成「運算」與「記憶體」兩個子任務,藉由專用 GPU(CPX + GB300)協作,實現更高效率、更低成本的 AI 推論架構。
4. High Capacity Memory
4.1. DRAM簡介
DRAM(Dynamic Random Access Memory)是一種利用一個電晶體(Transistor)與一個電容(Capacitor)組成的基本儲存單元。每個 cell 只能儲存 1 個位元(bit),即「1」或「0」。

電容(Capacitor):用來儲存電荷,形狀為柱狀結構,是實際的資料儲存節點(storage node)。有電荷代表「1」,無電荷代表「0」。
電晶體(Transistor, Access Device):作為開關控制電荷進出電容。當控制閘(Control Gate)導通時,電荷可經由位線(Digit Line)進出。
字線(Word Line):控制電晶體的開關(ON/OFF)。
位線(Bit Line / Digit Line):提供電荷傳輸路徑,用於讀取或寫入資料。
整體運作
當字線打開時,電晶體導通,位線可將電荷注入或取出電容;字線關閉時,電容中的電荷即被「封存」,代表儲存的位元值。
由於電容中的電荷會隨時間流失,因此 DRAM 需定期「重整(refresh)」以維持資料正確性。

DRAM 技術從 2D 向 3D 演進的路線圖


發展階段

技術重點
電容材料:由 ZrAlHfO → HfZrO 抗鐵電材料。
Word Line:改為低電阻金屬。
周邊電路:從 HKMG CMOS → FinFET。
封裝:導入Hybrid Bonding,支援 HBM4/5/6
趨勢總結
DRAM 正從平面(6F²)縮小至垂直(4F²),最終邁向3D 堆疊,
以提升密度、速度與能效,支撐 AI 與高頻寬記憶體(HBM)需求
4.2. DRAM access
傳統 CPU-based DRAM 架構(Base Case):
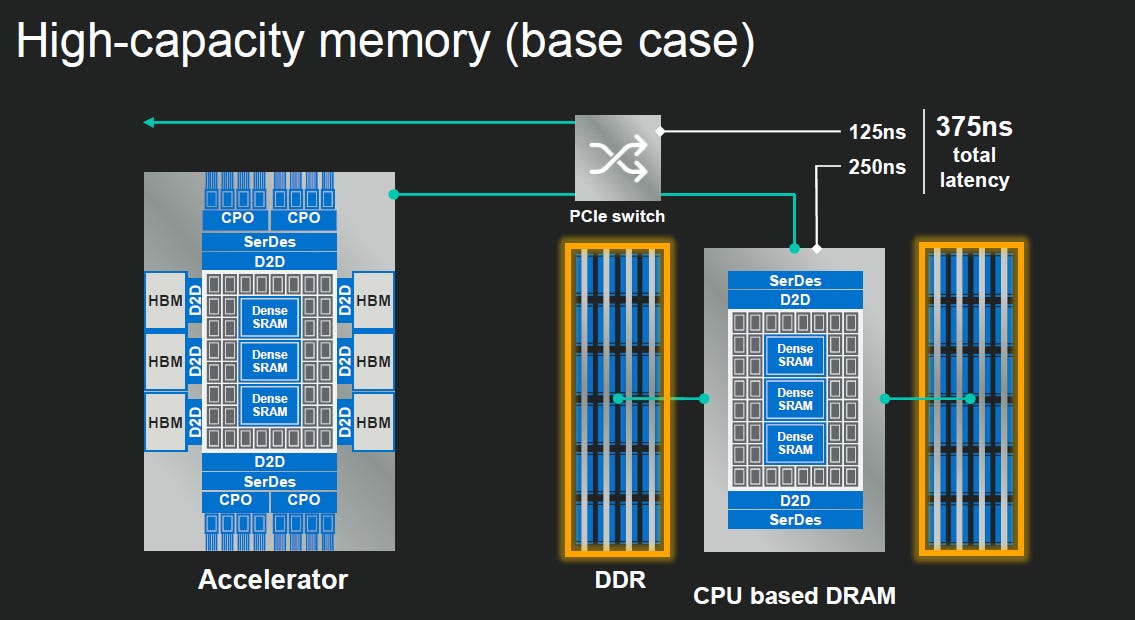
架構特點:
Accelerator(加速器)透過PCIe switch間接連接到 CPU,再由 CPU 控制外部 DDR。
整條路徑包含:
Accelerator → PCIe switch(125 ns)
PCIe switch → CPU + DDR(250 ns)
總延遲:約375ns
缺點:
經過PCIe 協定 + CPU 協調 + 多層 SerDes hop,導致高延遲。
資料流量須穿越 CPU,增加瓶頸與功耗。
不利於 AI/加速器的直接記憶體擴展需求。
Marvell Expander-based DRAM 架構(Expansion Case)

架構特點:
Accelerator 直接連接Expander-based DRAM,中間無需經過 CPU 或 PCIe switch。
Expander 晶片內建SerDes + Dense SRAM + 控制邏輯,可將 DRAM bus 封包化、校驗化並進行管理。
總延遲降至約 135 ns(縮短約 2.8 倍)
優點:
消除PCIe 協定 + CPU 協調,縮短傳輸路徑。
降低協定封裝與 coherency 負擔。
可讓加速器(如 GPU、TPU、NPU)直接存取大容量 DRAM。
更適合 AI 推理與大模型訓練中需要大記憶體池(Memory Pool)的場景。
延遲比較表

Marvell 的Expander-based DRAM透過移除 CPU 與 PCIe 層級,提供更低延遲、更高效率的記憶體擴充架構。這種設計特別適合AI Accelerator 直接訪問外部 DRAM的應用,可大幅提升記憶體容量與反應速度
Marvell Structera

Structera X = 記憶體擴展; Structera A = 記憶體擴展 + 運算融合
5. Summary
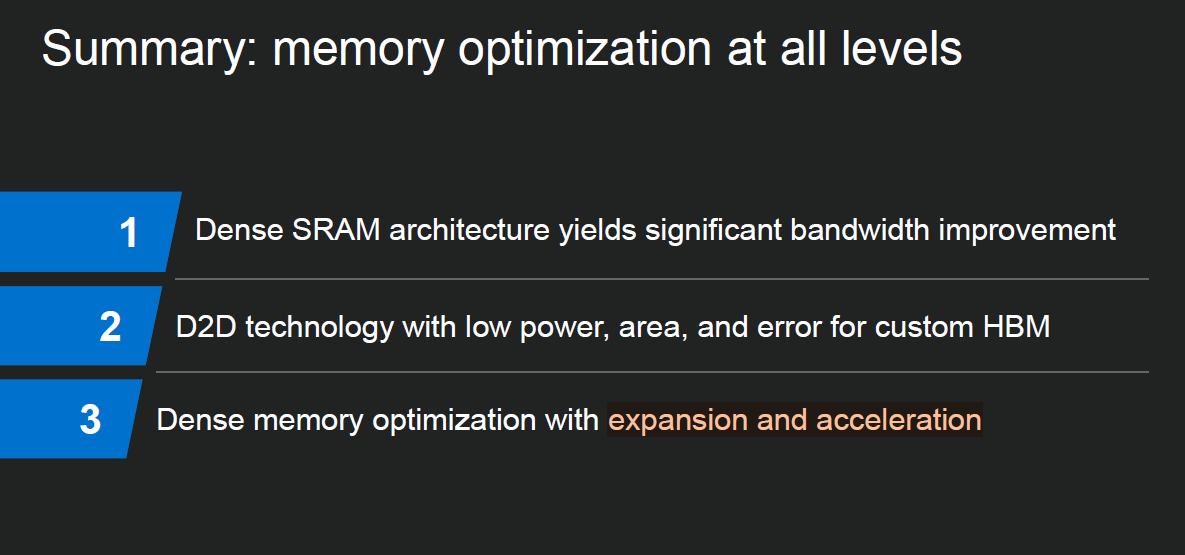
Marvell 的記憶體策略涵蓋SRAM 密度提升、D2D 互連優化的HBM、DRAM 擴展架構三層面,目標是打造一個兼具高頻寬、高容量、低延遲的整合式記憶體生態,用於 AI/HPC 系統的全域加速。
6. 補充資料
6.1. Nvidia 策略
2025平安夜的大消息: Nvidia 願意花 200 億美元去授權 Groq 技術並挖角其團隊,
這是Inference產品線的戰略性擴展(Strategic Expansion)。Nvidia 這一步看作是從「單一 GPU 打天下」轉向「針對不同推論場景的專用化分工」。
Nvidia 過去的邏輯是:「我的 GPU 最強,不管你是要訓練還是推論,都買我的 GPU 就對了。」 但現在,隨著 Agentic AI(代理人 AI)和 Real-time(即時)需求的出現,Nvidia 意識到光靠通用 GPU 架構(即使是降規的CPX)無法通吃所有市場,必須把產品線切得更細。
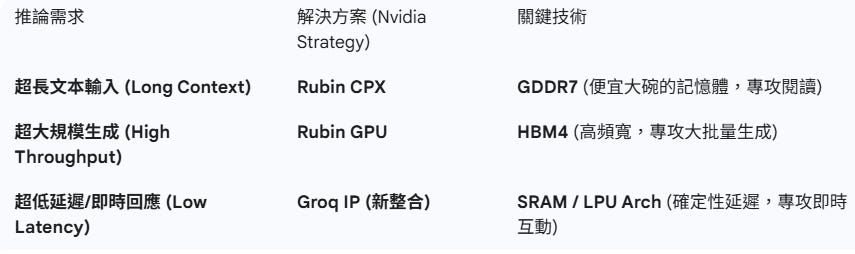
這筆交易確立了 Nvidia 未來在Inference(推論)市場的三大支柱,每一根支柱都針對不同的物理瓶頸:

為什麼這被視為「擴展」而非「取代」?
補足「物理上的短板」
Nvidia 的 GPU 架構(SIMT, Single Instruction Multiple Threads)天生是為了「並行處理(Parallelism)」設計的,這讓它在處理大量數據(Throughput)時無敵。 但是,AI 生成文字(Decode)是一個「序列過程(Sequential Process)」——你必須等上一個字出來,才能算下一個字。
GPU 的痛點:為了維持高效率,GPU 必須湊齊一大批使用者(Batching)才開始算。這就像公車,要等人坐滿才發車,導致單個使用者的等待時間(Latency)變長。
Groq 的優勢:SRAM 架構就像專屬電梯,來一個人就運一個人,完全不需要 Batching。這是架構層面的差異,Nvidia 無法透過軟體優化完全解決,只能透過「買下這種架構」來擴展產品線。
應對 “Agentic AI” (代理人 AI) 的崛起
這是最關鍵的市場變數。未來的 AI 不只是陪你聊天,而是要幫你「辦事」(訂票、比價、寫程式、部署)。
一個任務可能包含10 次以上的內部推理循環(思考 -> 搜索 -> 驗證 -> 再思考 -> 輸出)。
如果每一步都慢 500 毫秒,10 步就會慢 5 秒,使用者體驗會崩潰。
這時候,Groq 這種「零延遲」技術就從「奢侈品」變成了「必需品」。Nvidia 買下它是為了鎖定這個高階 Agent 市場。
防禦性擴展
如果 Nvidia 不買,Groq 的技術(SRAM-based AI)可能會被 Google (TPU 團隊原本就跟 Groq 有淵源) 或 Meta 買走。一旦這些巨頭掌握了比 GPU 更適合做即時推論的技術,Nvidia 的護城河就會出現裂縫。 透過這 200 億美元,Nvidia 直接把這個潛在的「顛覆者」變成了自己的「新產品線」。
總結
Nvidia 不再試圖用一種架構解決所有問題。
CPX是向下擴展,用便宜的GDDR7去吃量大、對延遲不敏感的「閱讀理解」市場。
Groq 技術是向側邊擴展,用昂貴的SRAM去吃對價格不敏感、但對速度要求極致的「即時互動」市場。
這讓 Nvidia 從單純的「賣鏟子(GPU)的人」,變成了「擁有全套工程器械(從怪手到精密電鑽)」的壟斷者。
6.2. Memory 對應
本次報告提到的SRAM、HBM、DDR 三層架構,完全對應了 Nvidia 現在把產品線拆分成Groq (LPU)、Rubin GPU、Rubin CPX的底層邏輯:
SRAM 層:極致速度,寸土寸金
技術點:
SRAM 位於晶片內部(On-die),擁有最低延遲(數 ns)和最高頻寬(數十 TB/s),但容量極小且昂貴 。
Marvell 正在開發Dense SRAM,透過先進製程(2nm GAA)和設計優化(Run Faster, Build Wider),試圖在有限面積下提升頻寬密度達 17 倍 。
對應戰略 (Groq / Nvidia LPU):
這解釋了Groq的技術路線。Groq 就是把這種昂貴的 SRAM 鋪滿整個晶片。
文件提到 SRAM 負責「即時計算快取」,這正是 Groq 擅長的Decode 階段(逐字生成),因為生成文字需要極低的延遲,不能等待外部記憶體。
HBM 層:吞吐量之王,AI 的工作馬
技術點:
HBM 是訓練大型模型的主要「工作記憶體」,透過 2.5D CoWoS 封裝,頻寬高(>1TB/s)但延遲比 SRAM 高 。
文件特別提到Custom HBM的趨勢:將記憶體控制器移到 Logic Base Die,由台積電(Foundry)製造,這讓 GPU 和記憶體結合得更緊密 。
對應戰略 (Rubin GPU):
這對應Nvidia 的旗艦 GPU(如 B100/Rubin)。
這是拿來做High Throughput(高吞吐量)任務的,例如訓練(Training)或者多人同時使用的 ChatGPT 服務。HBM 雖然貴,但比 SRAM 便宜多了,是目前的甜蜜點
DDR/GDDR 層:容量換成本,CPX 的戰場
技術點:
DDR 位於外部,容量最大(數 TB),但延遲最高(百 ns 以上),頻寬最低 。
關鍵佐證:Nvidia Rubin CPX採用128GB GDDR7而非 HBM,目的是為了降低成本 。
Disaggregated Inference(分離式推論)的概念:把Compute-bound的 Context/Prefill 階段交給 CPX(GDDR),把Memory-bound的 Generation 階段交給 GPU(HBM) 。
對應戰略 (Rubin CPX):
CPX是為了「省錢」和「處理長文本閱讀(Prefill)」。因為讀書(Prefill)是一次讀進去,對頻寬延遲不敏感,用便宜的GDDR7就夠了。
總結
記憶體階層(Memory Hierarchy)決定 AI 系統架構
Groq (SRAM):解決文件提到的Latency瓶頸(比較了 375ns vs 135ns 的延遲差異,SRAM 會更低)。
Rubin GPU (HBM):解決Bandwidth瓶頸(Memory Wall 的核心問題)。
Rubin CPX (GDDR):解決Capacity/Cost瓶頸(HBM 佔 BoM 成本已高達 61% 的問題
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


