AMD專家Darrin Vallis在HotChips 2025介紹Scale-up網路架構,摘要他的報告分享, 歡迎討論。
AMD專家Darrin Vallis在HotChips 2025介紹Scale-up網路架構,摘要他的報告分享, 歡迎討論。
- Source: Ted Yu
- Published: 2025-09-18T07:38:41+08:00
- URL: https://ytyuted.substack.com/p/ep16-scale-up EP16. Scale-up網路架構 - Ted Yu
Pledge your support

EP16. Scale-up網路架構

Sep 18, 2025
AMD專家Darrin Vallis在HotChips 2025介紹Scale-up網路架構,摘要他的報告分享, 歡迎討論。
1. AI/ML 網路
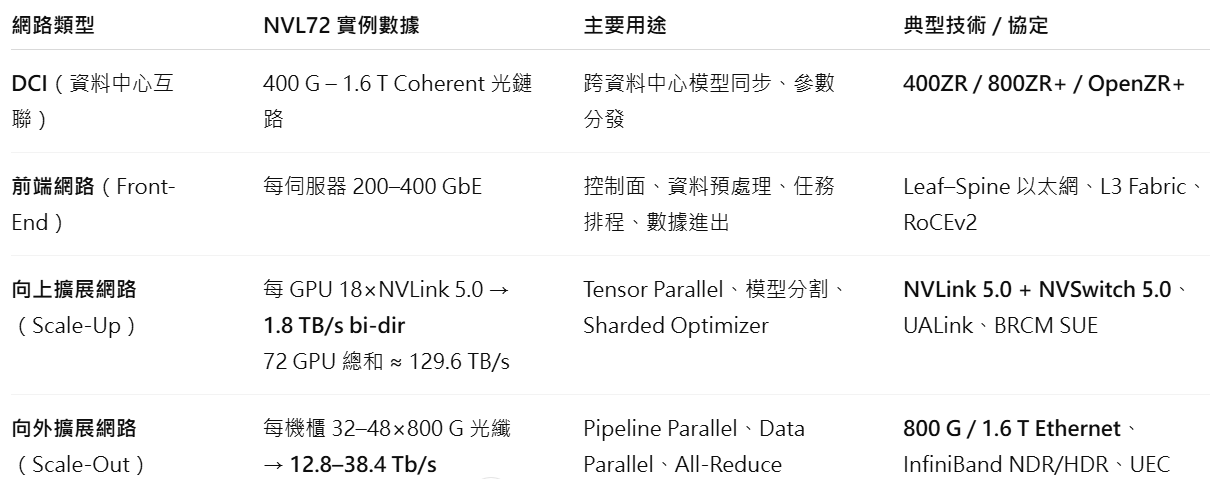
典型 AI / ML 資料中心的三層網路結構,包含前端(Front-End)、向上擴展(Scale-Up)與向外擴展(Scale-Out)網路:
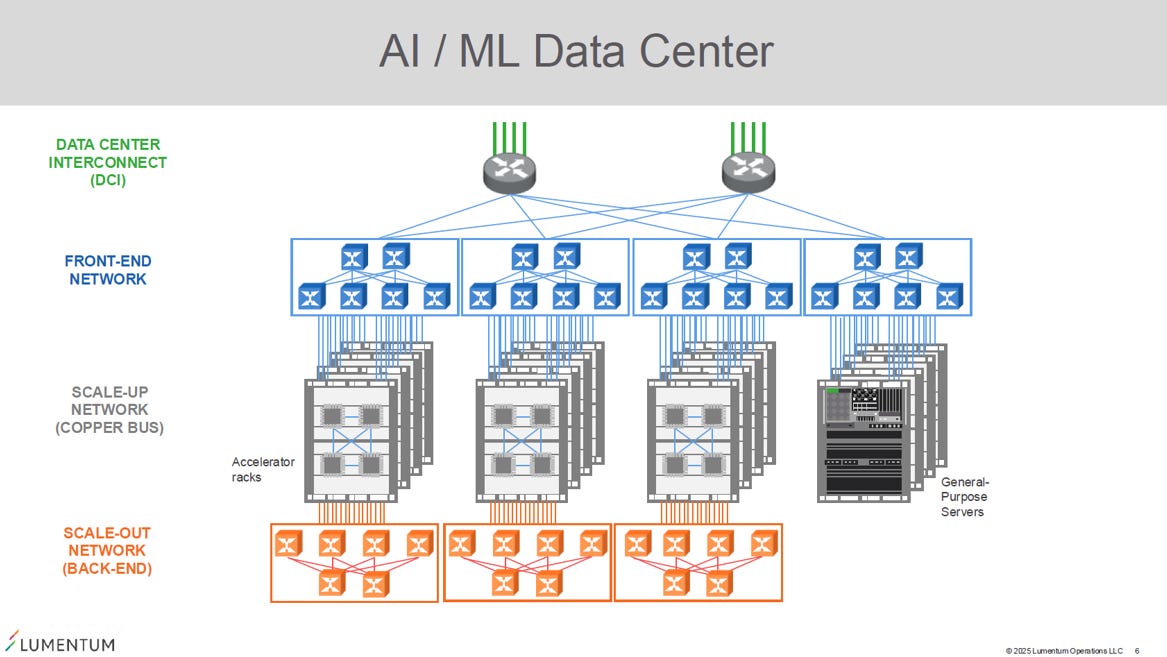
資料中心互聯(DCI)
功能:連接不同資料中心,用於分散式訓練、模型備份、推理結果彙整
速率:典型採用 400G/800G Coherent
延遲需求:不是最關鍵,通常容忍毫秒級延遲
典型協定: 400ZR / 800ZR+ / OpenZR+
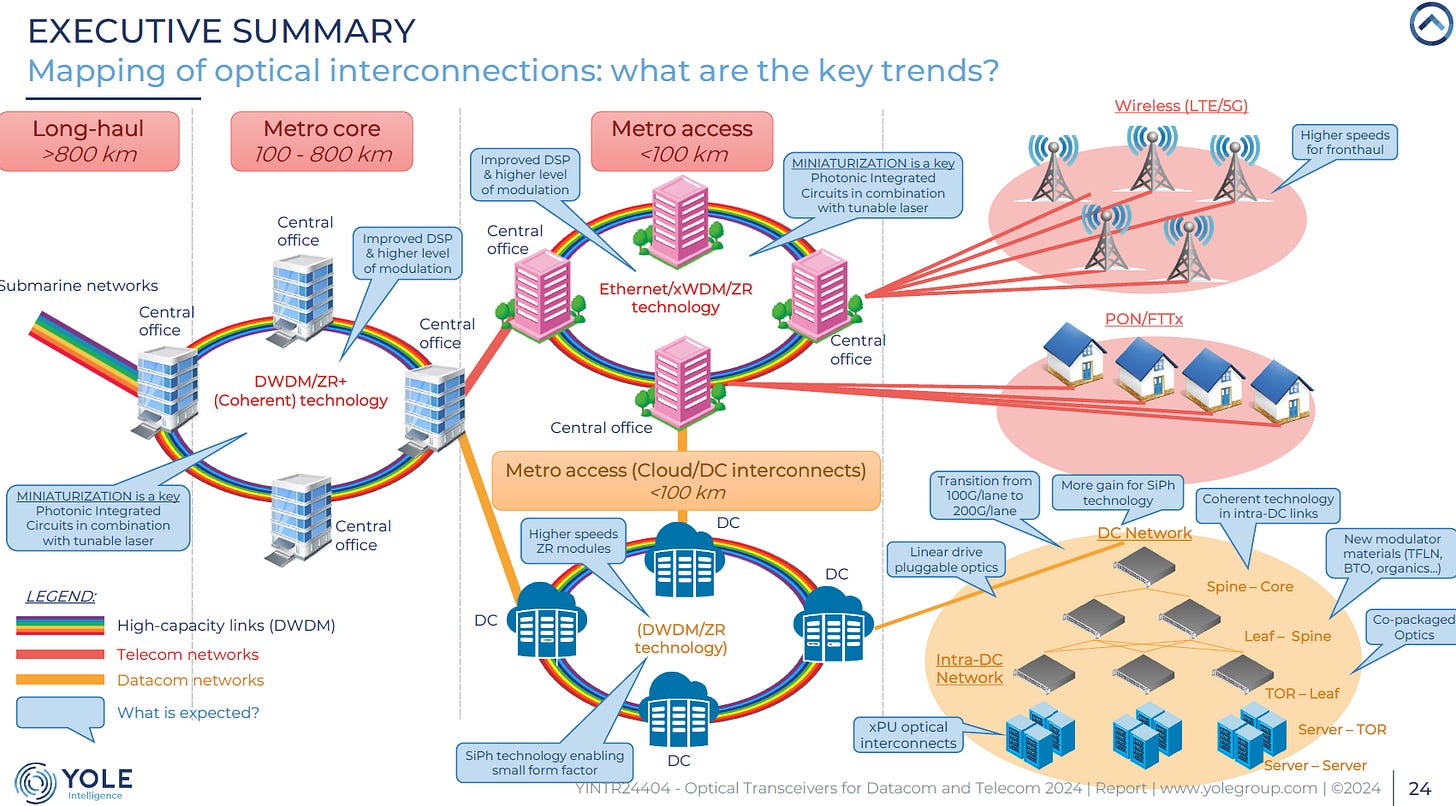
參考Yole的經典光通訊網路架構圖:
前端網路(Front-End Network)
用途:控制流量、任務分配、資料預處理
NVL72規模下速率:
每台通用伺服器通常配備2× 100/200/400GbE
整體前端網路僅佔總流量的 1–10%
拓撲:Leaf-Spine 架構(L3 Fabric),以太網為主
典型協定: Leaf–Spine 以太網
向上擴展網路(Scale-Up Network)
用途:機櫃內 GPU-to-GPU 通訊,用於 tensor parallel
NVL72 配置:
72 顆 GPU → 透過 18 個 NVSwitch 互連
每顆 GPU 連接 18 條 NVLink,每條 NVLink 5.0 有兩條 200 Gb/s lanes構成
單 GPU ↔ NVSwitch 總頻寬 = 18 × 2 × 200 Gb/s × 2( bi-dir) ≈ 14.4 Tb/s = 1.8TB/s(bi-dir)
延遲:小於300 ns,遠低於以太網
典型協定:NVLink、UALink、BRCM SUE
向外擴展網路(Scale-Out Network,Back-End)
用途:跨機櫃 GPU-to-GPU 通訊,用於梯度同步、Pipeline Parallel、MoE gating
NVL72 規模下速率:
每機櫃提供32–48 個 400G/800G 光纖鏈路→ 對應多達12.8–38.4 Tb/saggregate bandwidth
需要確保高 bisection bandwidth,以防 All-Reduce 被網路瓶頸拖慢
典型協定: InfiniBand、UEC(Ultra Ethernet Consortium)
Broadcom 將Backend定義為Scale-Up + Scale-Out的總和,不只包含跨機櫃以太網/IB/UEC,還納入機櫃內 NVLink、UALink、SUE 等互連,強調整個GPU-to-GPU fabric都屬於Backend。
傳統定義Backend = Scale-Out,這樣更清楚,避免把 Scale-Up 混在一起誤解。
More Explanation

下方的 SCALE-UP FABRIC
GPU ↔ GPU 直接用N 條專用高速 lanes相連
代表NVLink _NVSwitch / UALink / SUE _Tomahawk Ultra這類機櫃內低延遲互連
用於Tensor Parallel、Pipeline Parallel(機櫃內)
上方的 SCALE-OUT NETWORK
每顆 GPU 經由 NIC 出去,連到大規模交換網(Clos, Leaf-Spine, Fat-Tree)
代表Ethernet (RoCEv2, UEC)或InfiniBand
用於Data Parallel、Pipeline Parallel(跨機櫃)
FE NIC(右邊)
連到前端網路(Front-End),處理控制面、資料載入
三種平行策略與網路對應關係
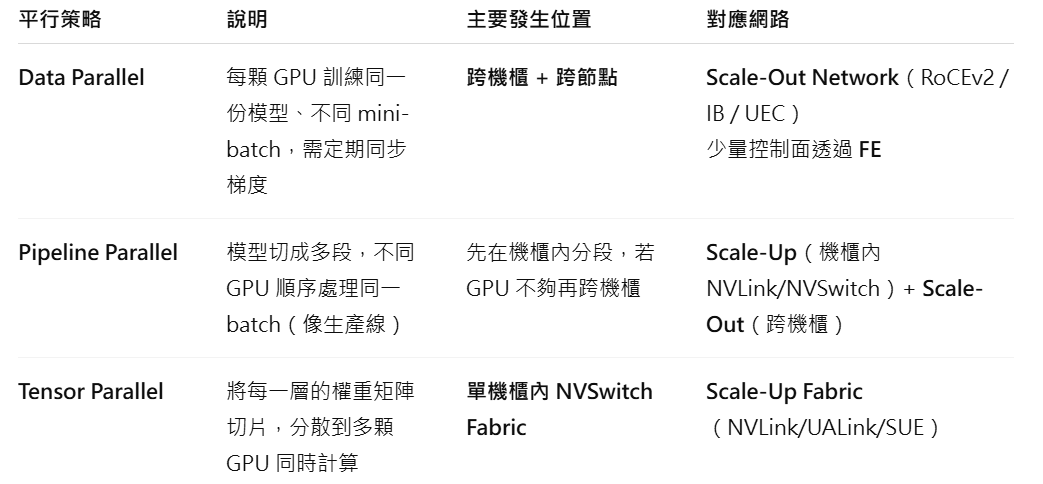
關於這三個平行策略,請參考EP15.
這圖中GPU經由NIC接到Scale out network。 但NVIDIA 的實際設計是GPU → CPU → NIC → Scale-Out,而不是 GPU 直連 NIC。
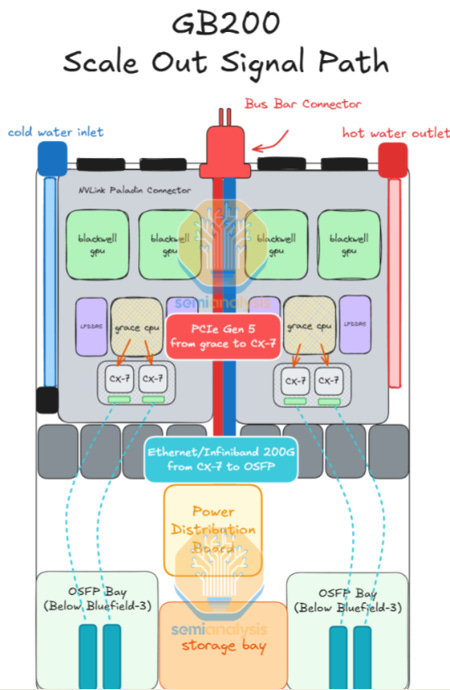
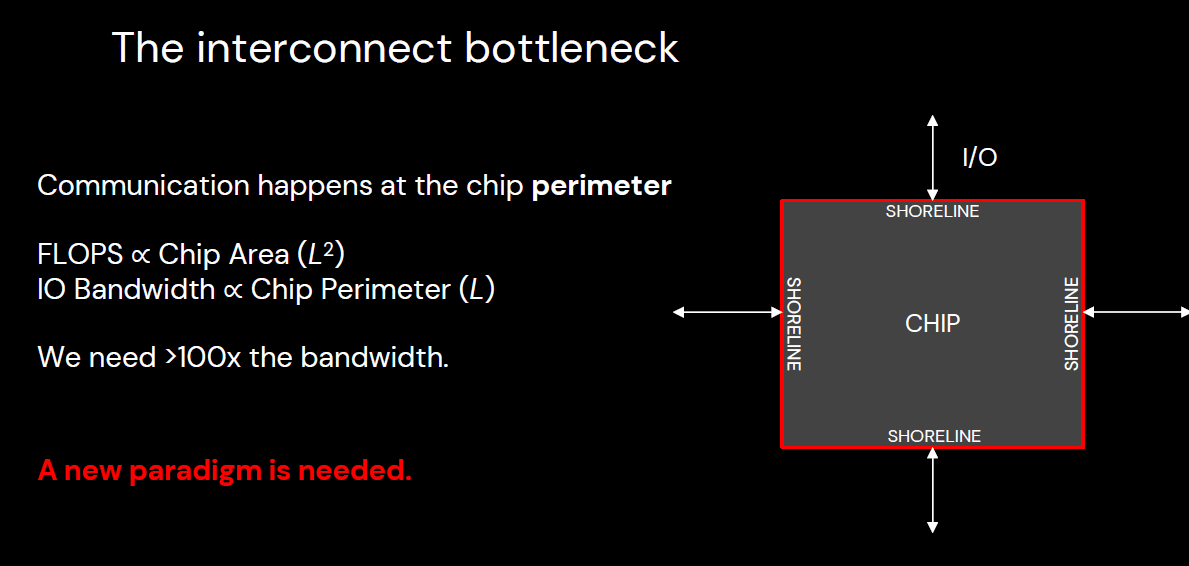
NVIDIA 不讓 GPU 直連 NIC,主要是因為 GPU的shoreline 資源有限,優先留給 HBM 和 NVLink;相比 Intel Gaudi 等「GPU+NIC 一體化」設計,NVIDIA 更重視 Scale-Up 帶寬,將 Scale-Out 流量交給 CPU+NIC 處理,再用軟體(NCCL、GPUDirect)降低 overhead。
2. Scale-up Topology
設計原則: 盡可能保持單層(1 hop),減少延遲→ 保證 Tensor Parallel 和 Local All-Reduce 的效率最大化
2.1 Switch Radix
Radix = 一顆交換器(switch 或 NVSwitch)的可用埠數
Switch 的「連接能力」,越高代表單顆 switch 可以同時接更多裝置或提供更寬的總頻寬。
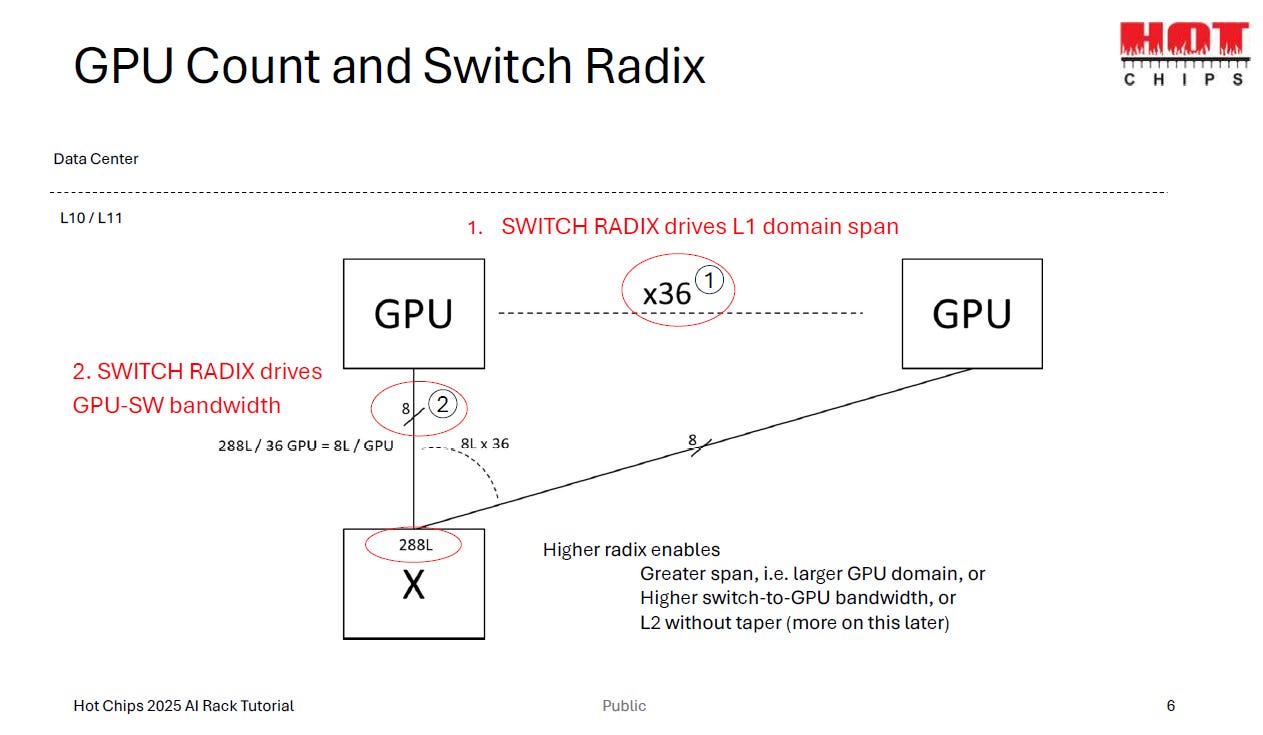
Switch Radix 決定 L1 Domain 規模
Radix = switch 上可用的總連接埠數
如果 switch 有288條lanes,可以接288 ÷ 每 GPU 使用的 lanes 數 = 可支援的 GPU 數
圖中例子:每 GPU 8 lanes → 288 ÷ 8 =36 顆 GPU
Radix/Lanes 越多,單層可容納的 GPU 越多,可以避免多 hop,減少延遲
Switch Radix 決定單 GPU ↔ Switch 的頻寬
288L 分給 36 GPU → 每顆 GPU 得到 8 Lanes
如果要每顆 GPU 有更多帶寬,需要更高 Radix 或更多 Lanes
高 Radix 的好處
Greater span:可以形成更大的 L1 domain(更多 GPU 在同一 switch fabric)
Higher per-GPU bandwidth:可以給更多頻寬
可避免 L2 switch / taper:保持 flat fabric、單 hop,延遲最低
高 Radix = 大規模單層 GPU 全互連 + 更高 GPU-to-Switch 頻寬 → 減少 hop 數、降低延遲,是 Scale-Up Fabric 最核心的設計目標。
2.2 Scale-up for larger domains(144 GPUs)
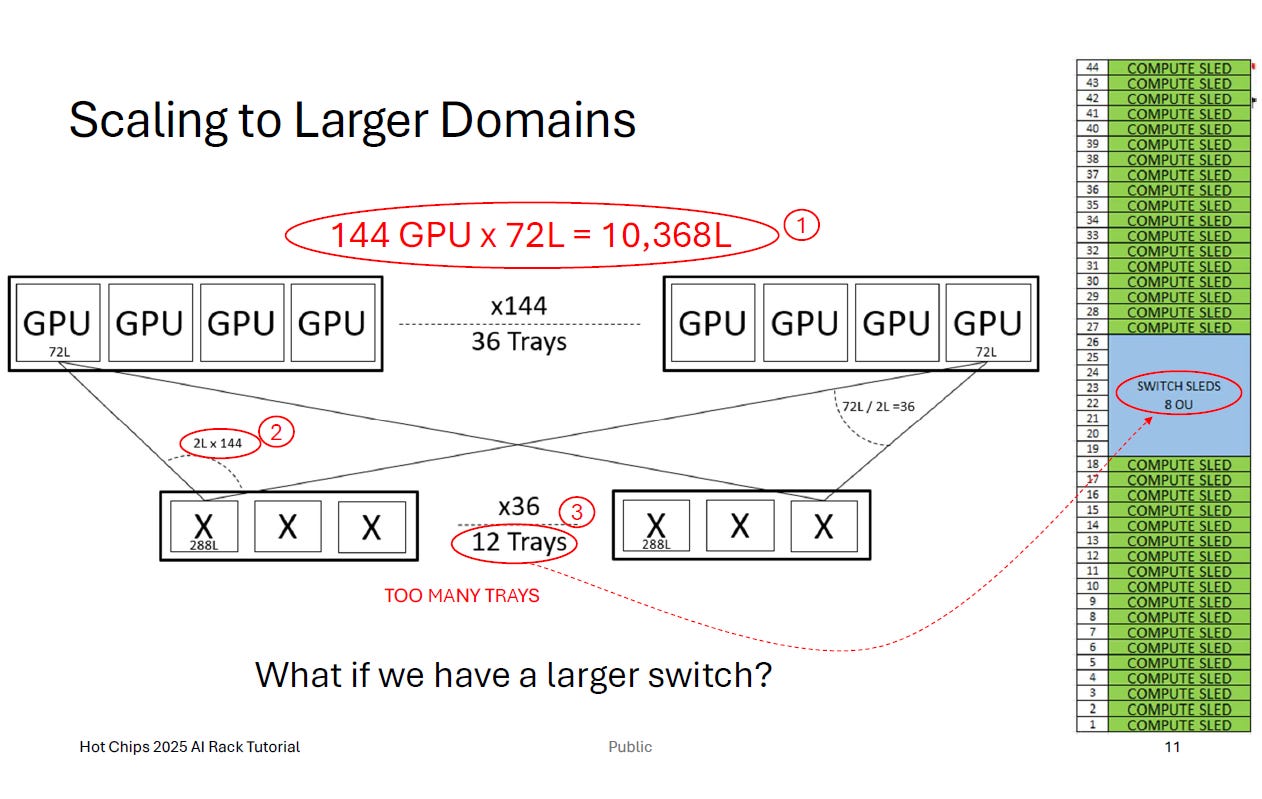
GPU 端需求
144 GPU × 72 lanes =10,368 lanes
表示要支援 144 GPU 全互連,就必須提供這麼多 lanes 的 switch capacity
Switch 端配置
每顆Switch = 288 lanes→ 可提供 288 ÷ 2 = 144 ports(假設每 port x2 lane)
要接滿 144 GPU,需要 144 GPU × (72 ÷ 2) port = 5,184 ports
所以需要的 switch 數量 = 5,184 ÷ 144 =36 顆 switch
實際問題
36 顆 switch =12個 switch trays(每 tray 裝 3 顆 switch)
結果整個 rack 裡要塞12個 tray 只放 switch →太多 tray、占用太多高度 (OU)
右邊圖示意:只有第 19~26 OU 是 switch,其他全是 GPU compute sled。8OU < 12OU,沒有多餘的空間。
更高 radix 的 switch
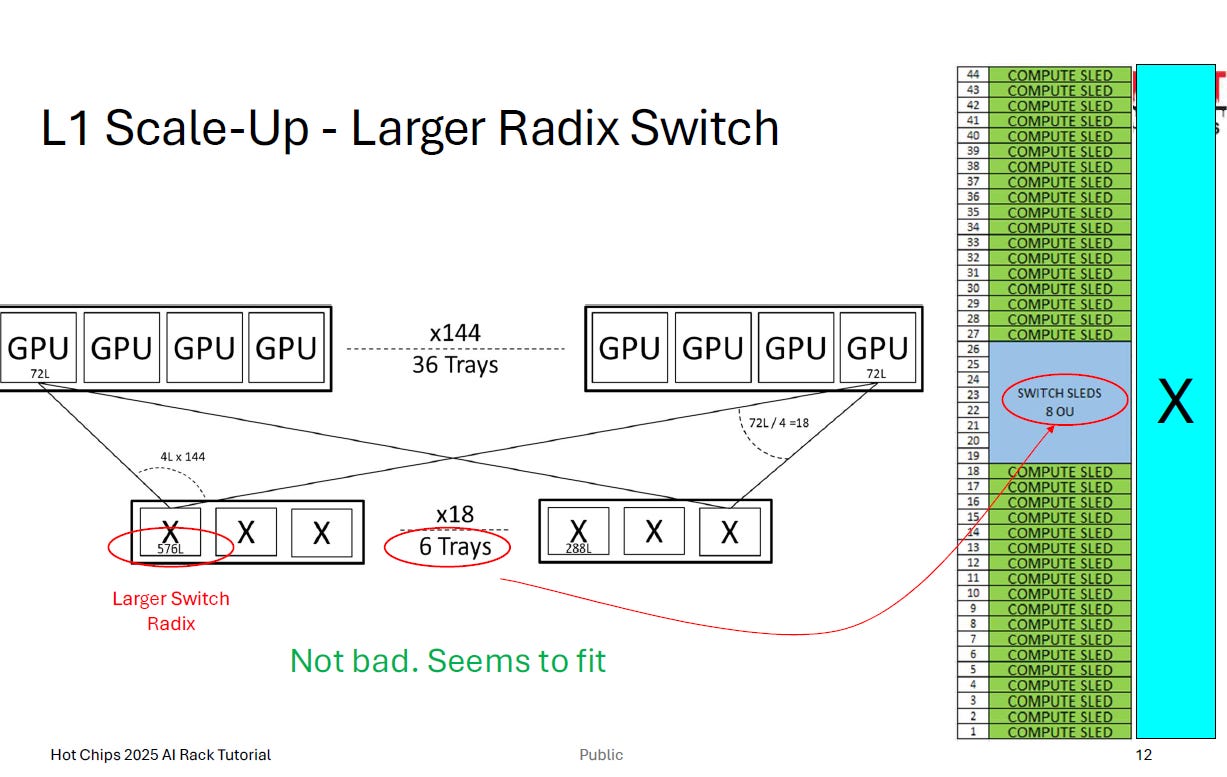
Switch = 576 lanes
需求:144 GPU × 72 lanes/GPU =10,368 lanes(要做單層 full-mesh)
供給:每顆 switch 提供576 lanes⇒ 需要的 switch 數 = 10,368 / 576 =18 顆
配線分攤:每顆 GPU 的 72 lanes 會平均分到 18 顆 switch ⇒每 GPU 對每顆 switch 用 4 lanes
實體佈局:若每個 tray 放 3 顆 switch ⇒ 18 / 3 =6 個 switch trays(前例 12 trays 減半)。
意義:Radix 加倍(288L → 576L)=所需 switch/托盤數減半 →機櫃空間、佈線體積、功耗/散熱與成本都降,仍維持單層(1-hop)non-blocking。
576L 高 Radix switch 讓 144-GPU 的 L1 domain 用 18 顆 switch、6 個 trays 就能完成,而且每 GPU 對每顆 switch 只需 4 lanes
如果這顆 576L switch 每 lane 都跑 200 Gb/s,它能提供115.2 Tb/s 單向吞吐量,230.4 Tb/s 全雙工吞吐量,足以支撐 144 GPU 的 full-mesh L1 domain。
實際問題

高 Radix switch 雖然減少了 switch tray 數量,但總 lanes 依舊龐大→ 布線、連接器、信號完整性、功耗散熱都是巨大的系統級挑戰。
2.3 Signal Integrity 問題
距離計算
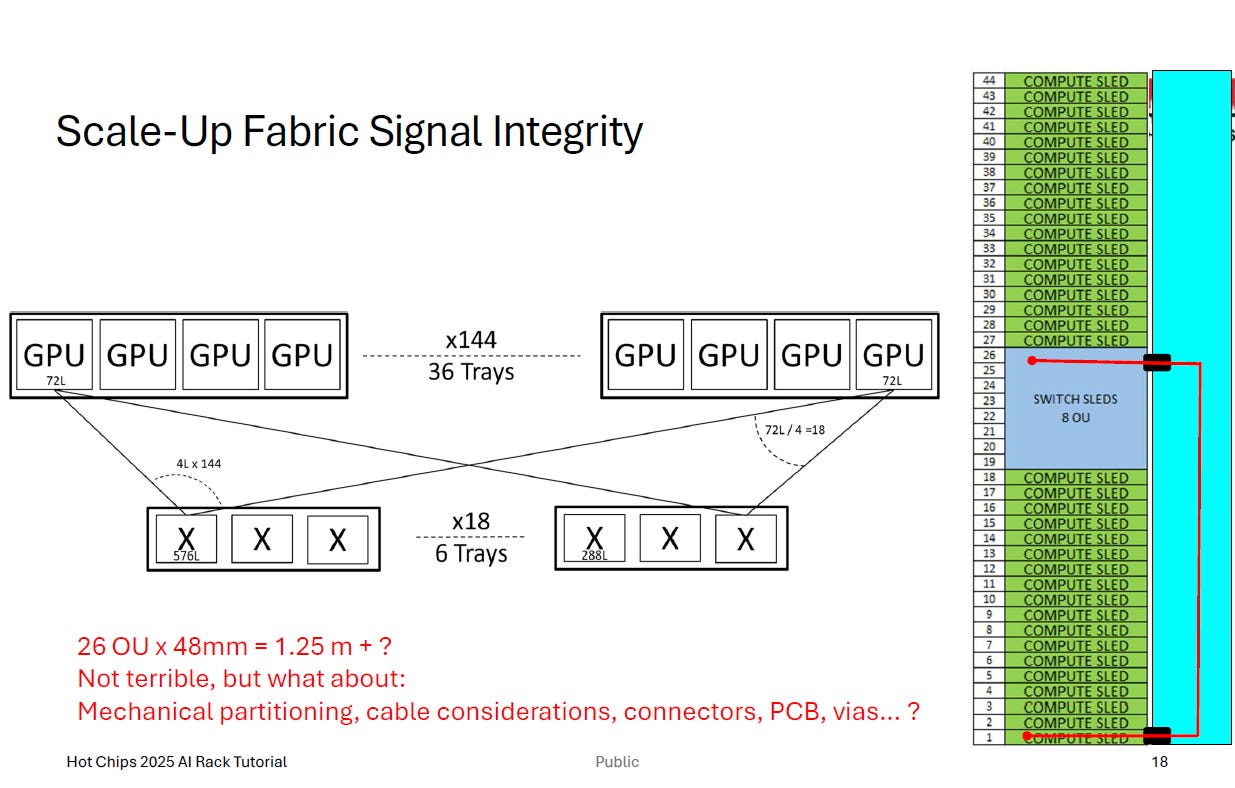
右下角紅字:
26OU×48mm≈1.25m
也就是從機櫃上方的 GPU sled 拉到 switch sled,單向距離超過1.2公尺
對於 200 Gb/s PAM4、28–30 dB 通道 budget,非常接近極限
Mechanical Partitioning:GPU sled、switch sled 分得很開,走線需跨 tray
Cable Considerations:1.25 m 以上可能要用高級 twinax
Connectors / PCB Loss / Vias:每個接插件、via、彎折都增加插入損耗
可能需要 Retimer:但 retimer 帶來功耗、熱、成本
設計取捨
雖然從計算看來距離「還不算太可怕」,但當 lanes 達到上萬條,任何 SI margin 不足都會造成大規模 BER 上升
越多 retimer = 越多功耗與散熱需求,降低系統效率
Channel 損耗預算

PCB Loss
212 G PAM4:1.27 dB/in
224 G PAM4:1.4 dB/in
每顆 via ≈ 1.5 dB → 多層板設計要非常小心避免過多 via
12 inch PCB trace → 15.24 dB 損耗(212G PAM4)
Copper (Twinax) Loss
27 AWG twinax:約 8.875 dB/m(0.23 dB/in)
2 m copper cable → 17.75 dB 損耗
如果用更細線徑 (30–32 AWG),損耗更大(11.6–13.4 dB/m)
Connectors
每個 connector 損耗 < 1 dB 到數 dB,不同供應商差異很大
多級連接器鏈路損耗可高達 10 dB 級別
示意鏈路
GPU → PCB → Connector → 2 m twinax → Connector → Retimer → Switch
僅 PCB + cable 就已經消耗 > 33 dB
再加上 connector 損耗、margin,很可能超過 35 dB
設計原則
224 G PAM4 的 loss budget 僅 30–32 dB,這條鏈路已經非常吃緊
高 Radix、大 domain 設計下幾乎必須使用retimer
Retimer 雖解決 SI,但增加功耗、成本、熱設計 → 系統設計必須做取捨
Marvell’s excellent design
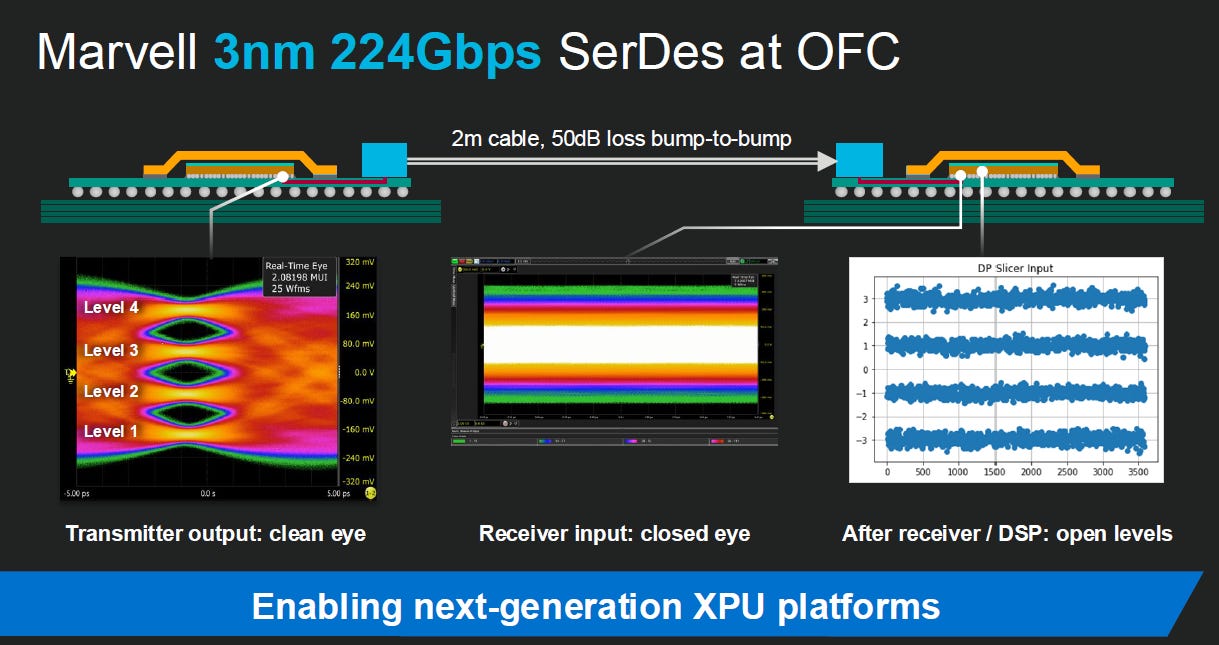
Marvell’s Demo顯示2 m cable、50 dB bump-to-bump IL仍能開眼,這比 CEI-224G-MR spec (~30 dB) 高出許多 → 顯示 DSP margin 大,設計優秀。
3. More than L1
3.1 L2 Scale-Up 架構說明
如果GPU的數目超過L1 Switch的容量,要達到All to All的互聯,必須要用L2 架構。

L1 Local Domain 架構:
組成:
每個 L1 domain 由36 顆 GPU + 18 顆 switch組成
每顆 GPU 提供72 條 lanes,總計2,592 lanes連接到 L1 switch 群組
每顆 switch 具備288 lanes,18 顆 switch 形成封閉網狀拓撲,確保 GPU 之間能全互連(all-to-all)。
Port 使用分配:
約一半 ports 用於連接 GPU(形成域內互聯)
另一半 ports 預留,專門用於對外連接 L2 switch
這樣做確保日後能透過 L2 層級把多個 domain 串接成更大規模的系統
L2 Switch 層的引入:
當系統規模超過單一 L1 domain 容量時,需要用L2 switch 層把多個 L1 domain 串接起來,形成更大規模的全互聯
新增連線
每個 L1 domain 釋出2,592 lanes接到 L2。
四個 L1 domain 需要合計10,368 lanes連到 L2 switch。
新增 switch
必須建置36 顆 L2 switch(每顆 288 lanes)來承接所有連線
這等於在原本 L1 switch 數量基礎上,再增加一倍以上的 switch 總量
設計挑戰與成本:

核心結論:
可擴展性:L2 層可以突破單一 L1 domain 的規模限制,支撐更大叢集
代價高昂:Switch 數量 ×3、Lanes ×2,功耗、散熱、SI、延遲全都惡化
設計取捨:L2 scale-up 雖然可行,但不如單一大型 L1 domain 高效,除非規模必須超過 L1 容量,才值得採用。
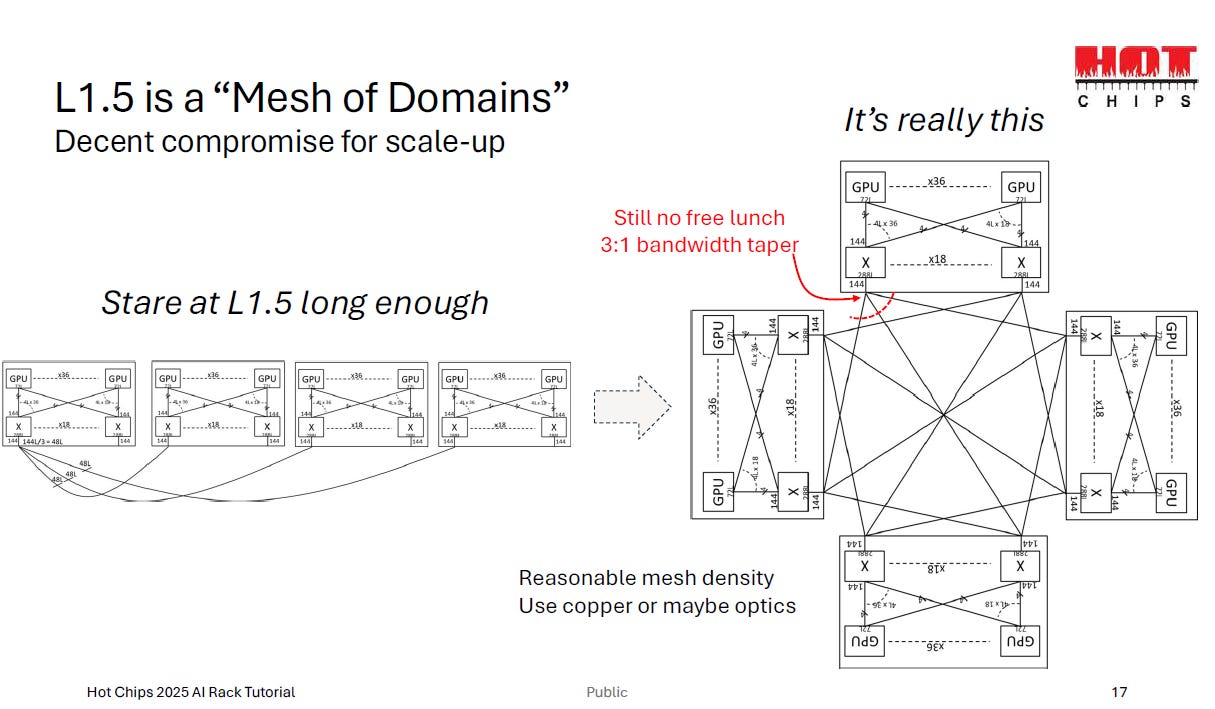
3.2 L1.5 Scale-Up 架構說明
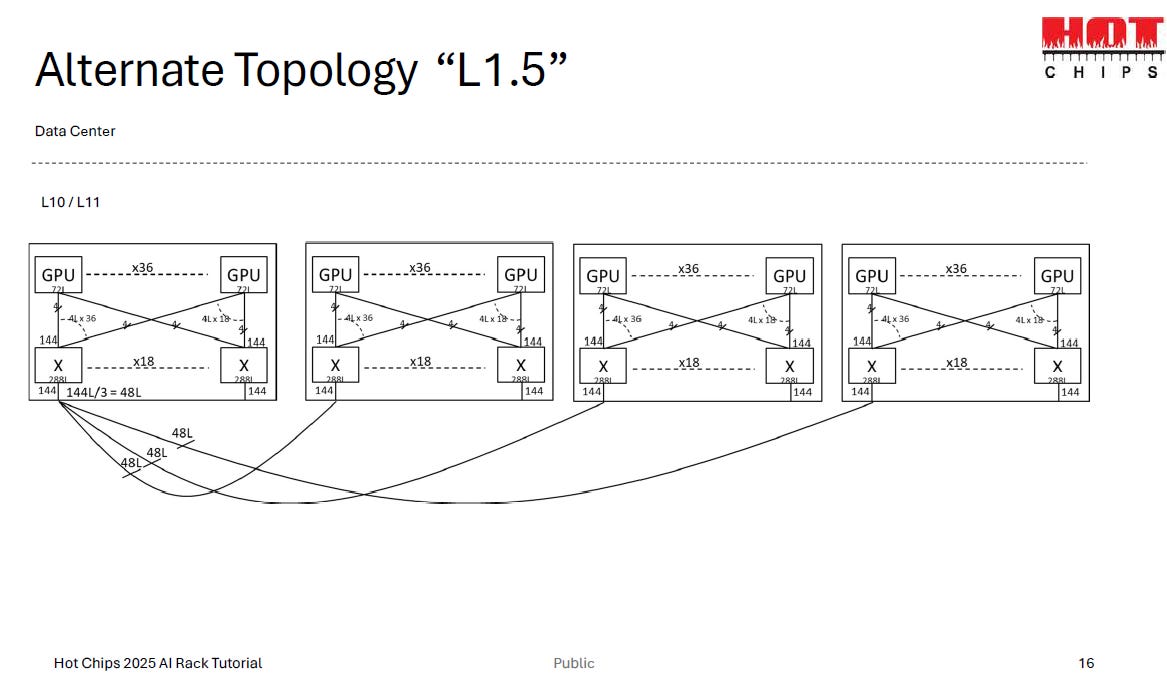
L1.5 拓撲(Mesh of Domains)
設計背景
當系統需要超過單一 L1 domain(18 switch + 36 GPU)的規模時,有兩個選項:
傳統 L2 Scale-Up:在 L1 之上加一整層 L2 switch,形成分層網路
L1.5 拓撲:把多個 L1 domain 直接用 point-to-point 互連,形成扁平化的「mesh of domains」
L1.5 被提出作為折衷方案,減少 L2 switch 層數與額外硬體數量
架構說明
L1 switch port 分配
每顆 L1 switch 有144 條 lanes對外可用。
這 144 lanes被平均切成 3 組,每組 48 lanes
每一組分別連接到不同的其他 L1 domain,因此:
每個 L1 switch 都直接與3 個相鄰 domain建立 point-to-point 連結。
形成mesh 拓撲,而非集中到單一 L2 switch。
L1.5 Mesh 拓撲特性
每個 L1 domain都與多個相鄰 domain 直接相連,形成部分互連的網狀結構
遠端頻寬受限:每個外部連結只有 48 lanes,形成3:1 帶寬 taper(domain 內到 domain 外的頻寬縮小 3 倍)。
架構優勢

核心結論
L1.5 拓撲的重點就是「每顆 L1 switch 平均把外部 ports 分配給 3 個鄰居 domain」,形成合理密度的 mesh 互連。
這種設計:
節省大量 switch、機架空間、佈線與功耗。
適合多數工作負載(流量多半集中於本地 domain)。
但對於需要全對全、超大規模同步的 workload,會有跨域頻寬不足的風險。
4. Scale-Up 架構的關鍵要點

決定訓練效率:Scale-Up 帶寬與延遲直接影響模型訓練時間與效能。
複雜度來自三要素:GPU 數量、Switch Radix、Scale-Up Fabric 頻寬
受限於機房現實:受制於空間、佈線、散熱與 SI(訊號完整性)挑戰。
技術突破是關鍵:>212 G SerDes、低功耗高速 DSP(Marvell’s case)。 或用CPO(Co-Packaged Optics) 取代銅纜,將顯著改善可擴展性。
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support

