AMD專家Frank Helms在Hotchips 2025,用簡單易懂的方式,介紹AI並行演算法的演進和Rack集群計算的重要性。摘要他的內容分享,歡迎討論。
AMD專家Frank Helms在Hotchips 2025,用簡單易懂的方式,介紹AI並行演算法的演進和Rack集群計算的重要性。摘要他的內容分享,歡迎討論。
- Source: Ted Yu
- Published: 2025-09-11T08:27:25+08:00
- URL: https://ytyuted.substack.com/p/ep15-the-hot-chip-is-a-rack EP15. The Hot Chip is a Rack - Ted Yu
Pledge your support

EP15. The Hot Chip is a Rack

Sep 11, 2025
AMD專家Frank Helms在Hotchips 2025,用簡單易懂的方式,介紹AI並行演算法的演進和Rack集群計算的重要性。摘要他的內容分享,歡迎討論。
1. 從 AlexNet到大語言模型的演進
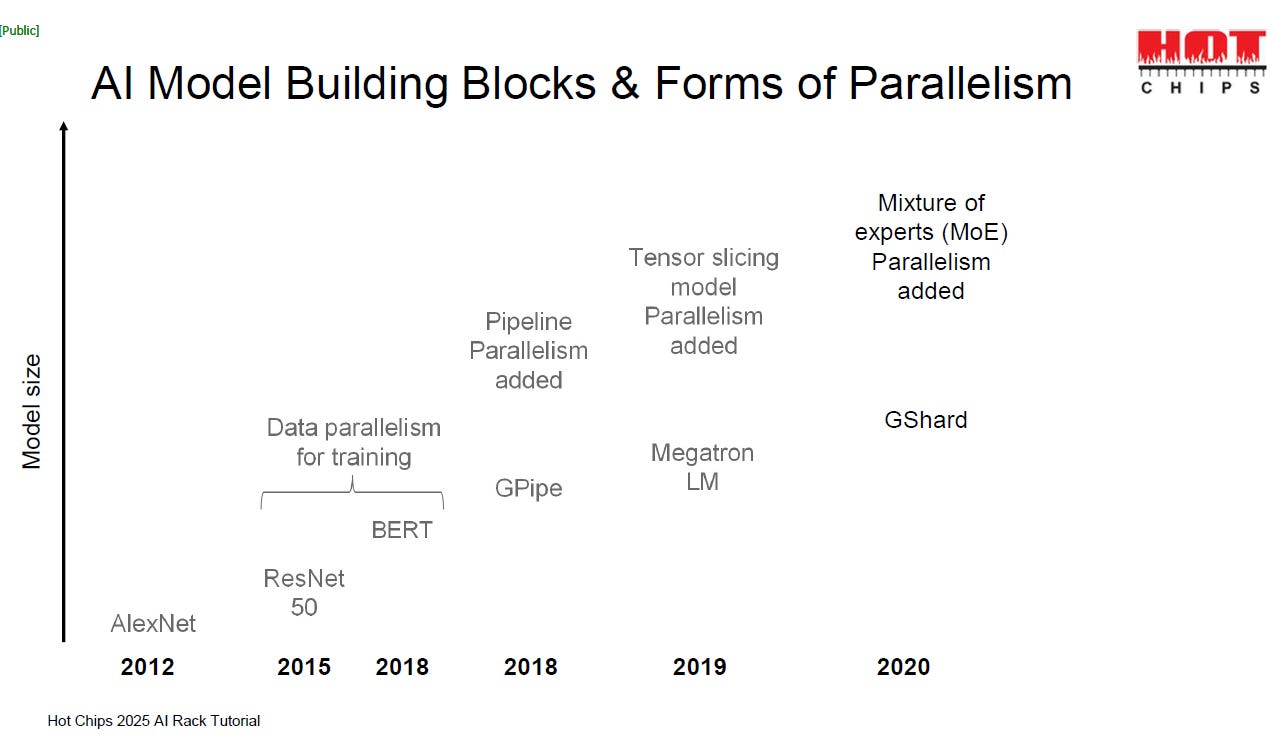
AI 模型一路成長到超大規模
從AlexNet開始,只要用兩張 GPU 就能搞定;模型變大後,出現了Data Parallel,多張 GPU 各跑一份資料;再來模型塞不進單卡,就用Pipeline Parallel(分層跑)和Tensor Slicing(把矩陣拆開來算);到了超大規模時,才引入MoE,只啟動部分專家來降低運算與能耗。
AlexNet(2012):小模型、單/雙 GPU、FP32;基本不需要複雜並行。
Data Parallel:模型放得進單卡,但算力/資料量不夠 → 多卡各跑不同資料,最後AllReduce同步權重。
Pipeline Parallel:模型太大放不進單卡 → 依層切給不同節點串接執行,提升吞吐但有管線泡泡與跨節點延遲。
Tensor Slicing(模型並行):把大型矩陣在多卡上切片同算,強擴展但需要高帶寬、低延遲的scale-up互聯。
MoE(稀疏專家):只啟動少數「專家」參數來推理/訓練,兼顧參數規模與計算/能耗效率;需高效路由與廣播/聚合。
1.1. AlexNet(2012)
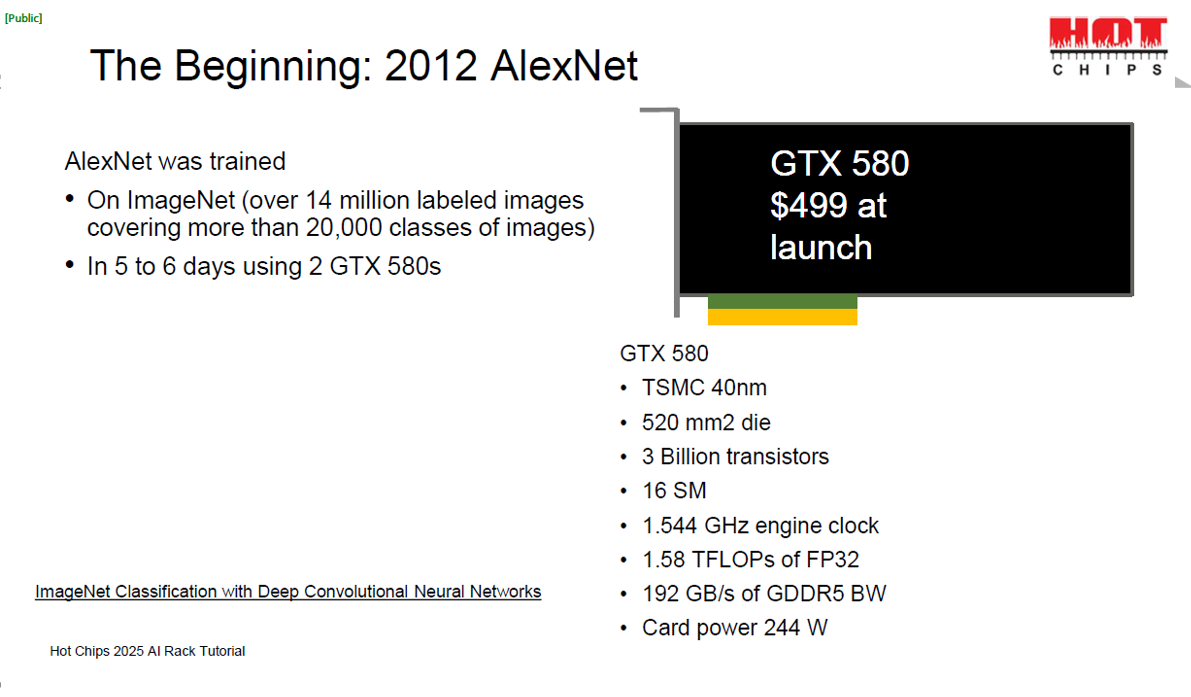
AlexNet 的特色
模型規模:約 6000 萬參數。
訓練數據:ImageNet(1400 萬張標註圖片,2 萬多類別)。
突破點:
使用 GPU 進行大規模深度學習訓練(首次震撼業界)。
引入ReLU(Rectified Linear Unit)激活函數,加速收斂。
使用Dropout防止過擬合 (每次訓練,都隨機讓部分神經元「暫時不工作」)。
採用卷積神經網路(Convolutional Neural Network, CNN)模型,有效捕捉圖像特徵。
訓練成本:花費5–6 天,靠兩張 GTX 580 完成
AlexNet 是深度學習的分水嶺 —— 它靠兩張 GTX 580 GPU,首次在 ImageNet 上大幅超越傳統方法,掀起了 AI 的黃金十年。
1.2. Data Parallelism(資料並行, 2015)
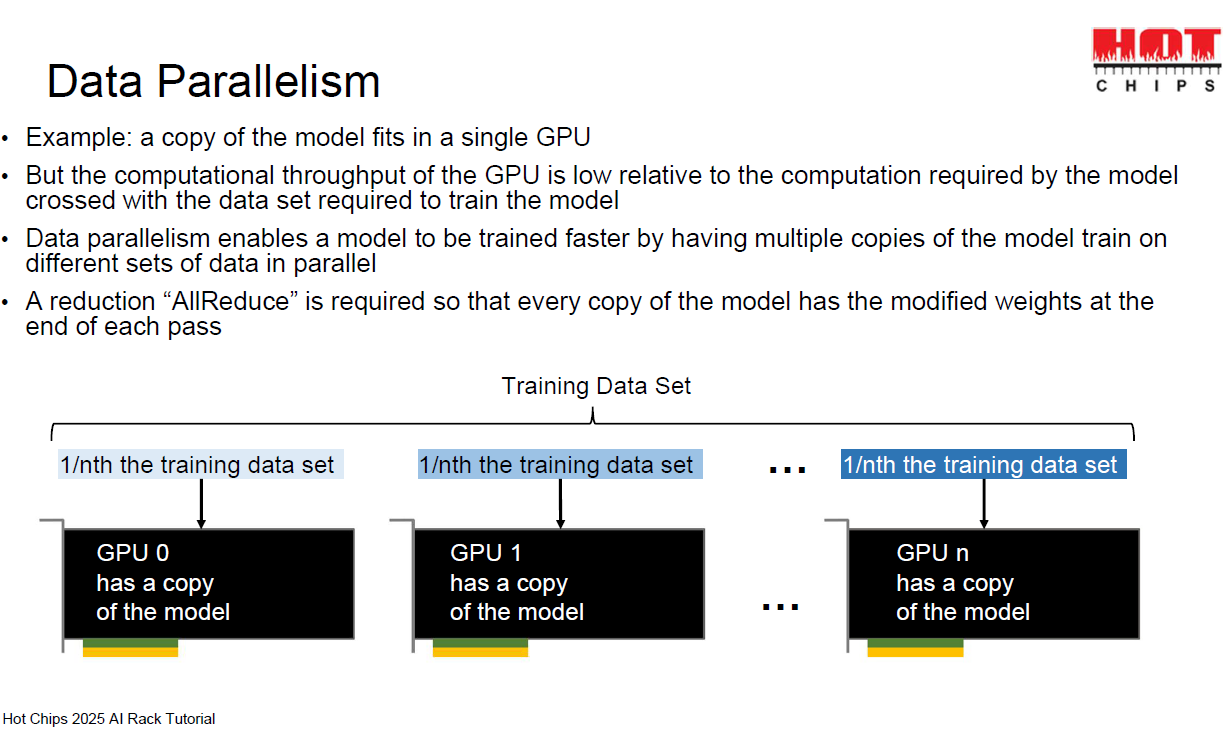
核心概念:
每張 GPU 都放一份完整的模型
訓練資料集被分成多份(比如 n 份),每張 GPU 負責其中的一份。
各 GPU 同時計算梯度,最後透過AllReduce把權重更新同步起來
優點:
很容易實現(因為模型本身能放進單卡)。
多張 GPU 就能縮短訓練時間。
限制:
模型大小必須能放進單卡記憶體。
GPU 間需要頻繁通訊(AllReduce),可能成為瓶頸。
一句話總結:
Data Parallelism = 一人一本書(模型),大家各自讀不同的章節(資料),最後互相對答案(AllReduce),讓訓練更快。
什麼是AllReduce?
Reduce:把多個 GPU 算出來的結果(例如梯度)收集起來,加總或平均。
Broadcast:再把這個結果發回給所有 GPU。
AllReduce = Reduce + Broadcast → 每個 GPU 最後都拿到相同的結果。
1.3. Pipeline Parallelism(流水線並行, 2018)
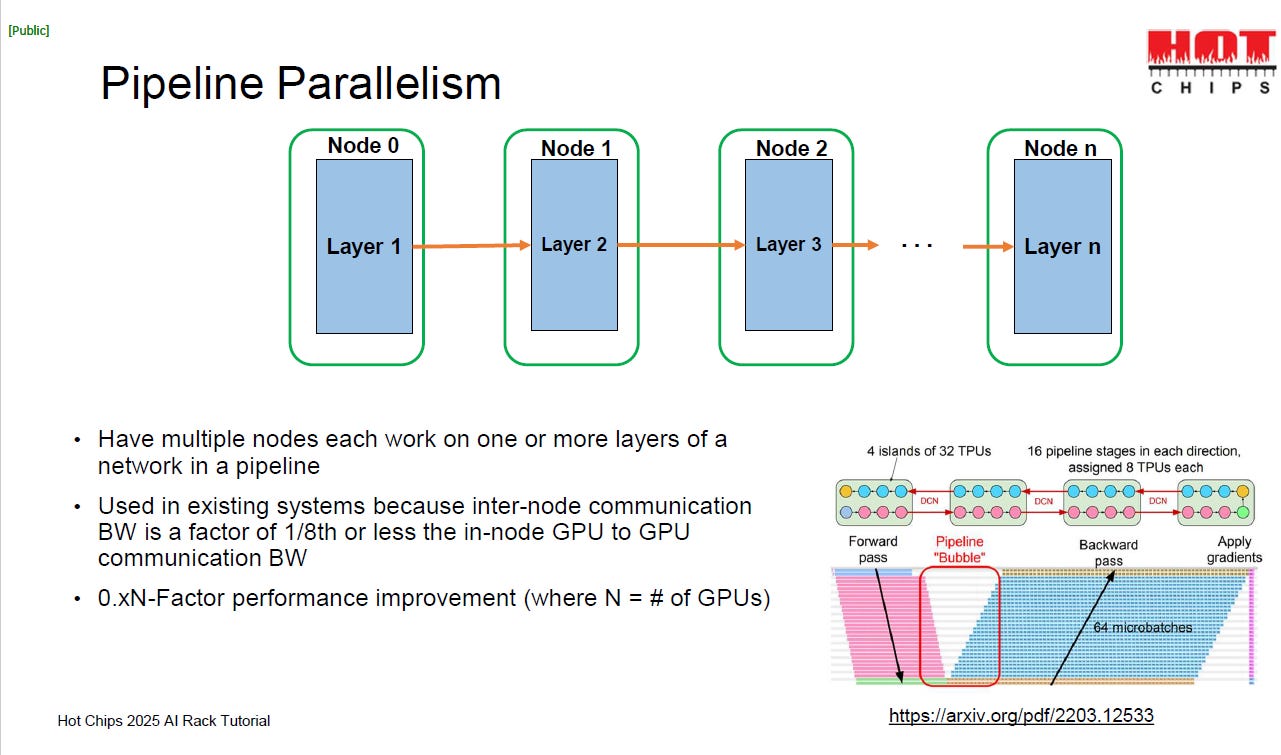
核心概念:
因為模型太大,一張 GPU 放不下,所以必須拆開來跑。把模型的不同層分配到不同的 GPU/Node 上。
資料就像「產品」一樣,沿著流水線一站一站往前傳:
Node 0 算 Layer 1,
Node 1 算 Layer 2,
Node 2 算 Layer 3,
依此類推。
特點:
能讓超大模型被切開,分散到多張 GPU 訓練
前向傳遞 (forward pass) 和反向傳遞 (backward pass) 都是沿著流水線走。
缺點是會產生Pipeline Bubble(流水線空檔),需要小批次 (microbatch) 來填補。
一句話總結:
Pipeline Parallelism = 把模型切成多段,交給不同 GPU 串起來算,就像工廠的生產線。
1.4. Tensor Slicing Model Parallism(張量切分並行, 2019)
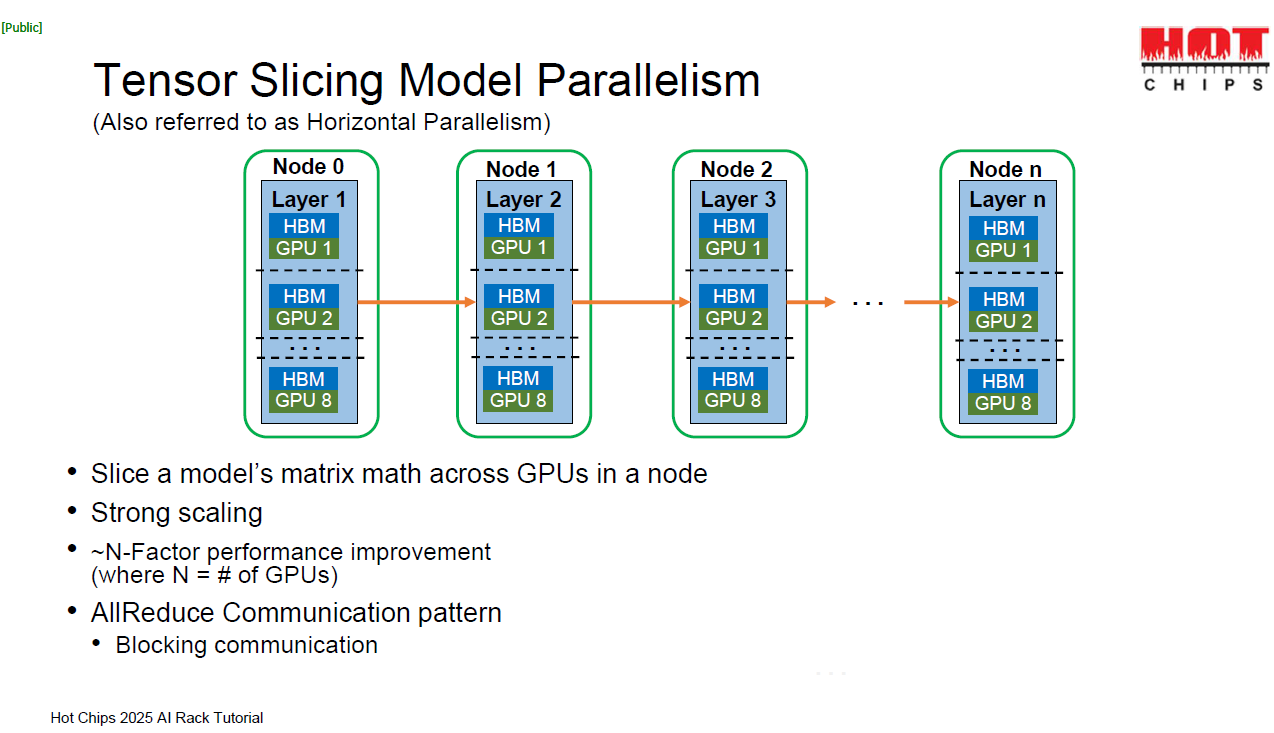
核心概念:
把模型裡的大矩陣運算(例如 Transformer 裡的 Attention、前饋網路的矩陣乘法)切開,分散到多張 GPU 上同時計算。
每張 GPU 都算一部分(slice),最後再用AllReduce把結果合併。
特點:
能有效解決 單張 GPU 記憶體不足的問題,因為一個矩陣拆開後就能分散到多卡存放。
適合需要 大矩陣乘法 的模型(典型是 GPT、Megatron-LM)。
計算幾乎能隨 GPU 數量線性加速,但 通訊成本很高(AllReduce必須頻繁同步)。
一句話總結:
Tensor Slicing = 把模型裡的大矩陣拆開,交給多張 GPU 一起算,再同步結果,讓巨型模型能夠被訓練。
1.5. 並行演算法關係
三者比較:

Data Parallel:算不同資料 → 最簡單、通訊需求低。
Pipeline Parallel:切層串起來 → 解決模型太大問題。
Tensor Slicing:拆矩陣一起算 → 最強大,但需要超高頻寬低延遲。
在這裡blocking communication的意思是:
👉GPU 必須等到通訊完成,才能繼續做下一步計算
Tensor Slicing:每張 GPU 都算出部分矩陣結果,最後要AllReduce 合併。
在合併完成前,其他計算不能繼續 →blocking。
Pipeline Parallel:下一層要等上一層結果傳過來,才能開始計算 →blocking。
Data Parallel:雖然也需要AllReduce,但因為每張 GPU 可以先在自己的資料上跑完整個 batch,最後再同步,blocking 影響較小。
三者協作:
實務上 Data、Pipeline、Tensor Slicing 三種並行方式必須協作。
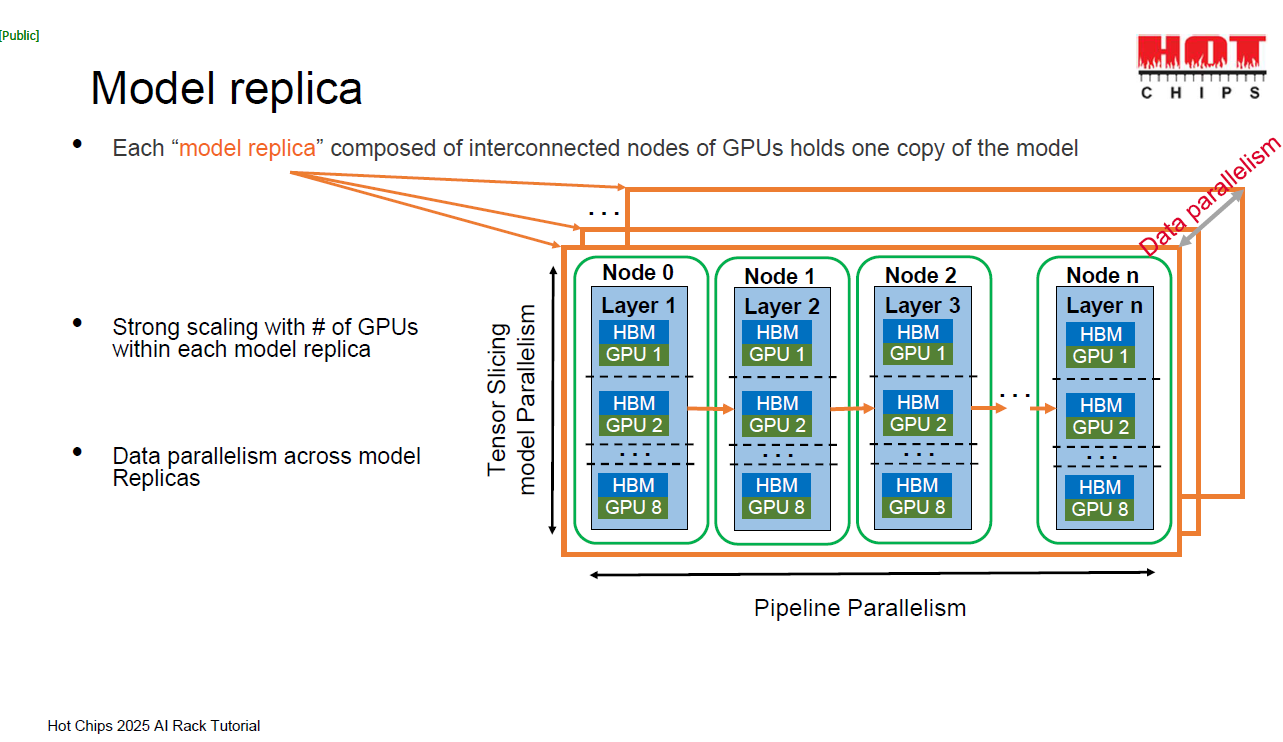
單個 model replica
在一個 replica 裡,每層 (Layer)被分配到不同 Node → 這是Pipeline Parallelism。
每個 Node 內部的矩陣計算又分散到多顆 GPU → 這是Tensor Slicing。
多個 model replica
不同 replica 之間再用Data Parallelism,各自處理不同的資料子集,最後再透過AllReduce同步。
白話理解
Pipeline:把模型切段,分給不同工人。
Tensor Slicing:一段工作太重,再找多個工人分工。
Data Parallel:整條流水線複製多份,大家同時處理不同的資料,最後對答案。
在真正的超大規模 AI 訓練中,必須同時用上 Data + Pipeline + Tensor Slicing,才能把模型撐起來,單靠其中一種並行方式是絕對不夠的。
1.6. 協作範例
以Megatron Turing NLG (MT-NLG)為例,這是 2021 年 NVIDIA 與 Microsoft 發表的 530B 參數語言模型,基於 Transformer。

第一層:Rack 內部
Tensor Slicing:每個 Node 內的 GPU 用高速互聯一起分工大矩陣運算。
這樣一個 Rack 就能訓練超大模型的一部分。
Note:
Megatron Turing NLG實際使用的是 NVIDIA NVLink + NVSwitch,因為作者來自AMD,所以投影片上寫Infinity Fabric™為例。
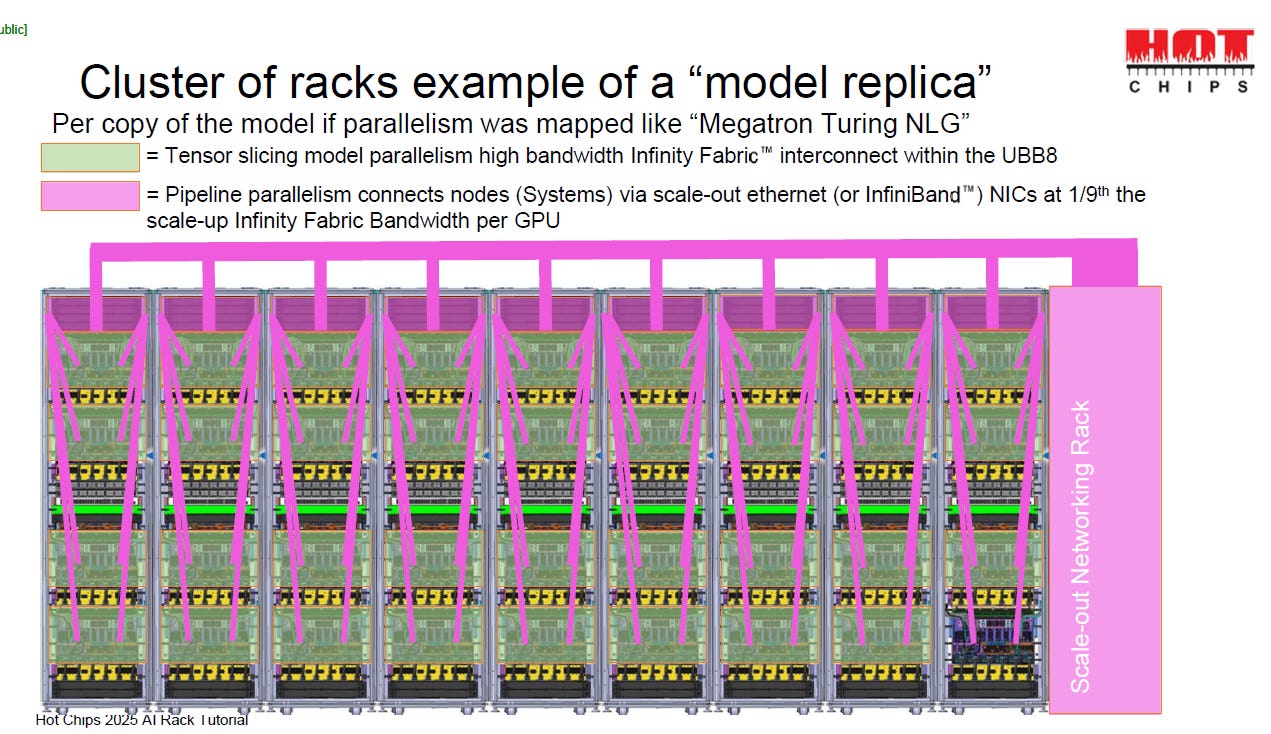
第二層:Rack 之間
Pipeline Parallelism:不同 Rack/Node 各自負責模型的不同層,資料沿著流水線傳遞。
像工廠生產線一樣,層與層之間靠 InfiniBand / Ethernet 串接。
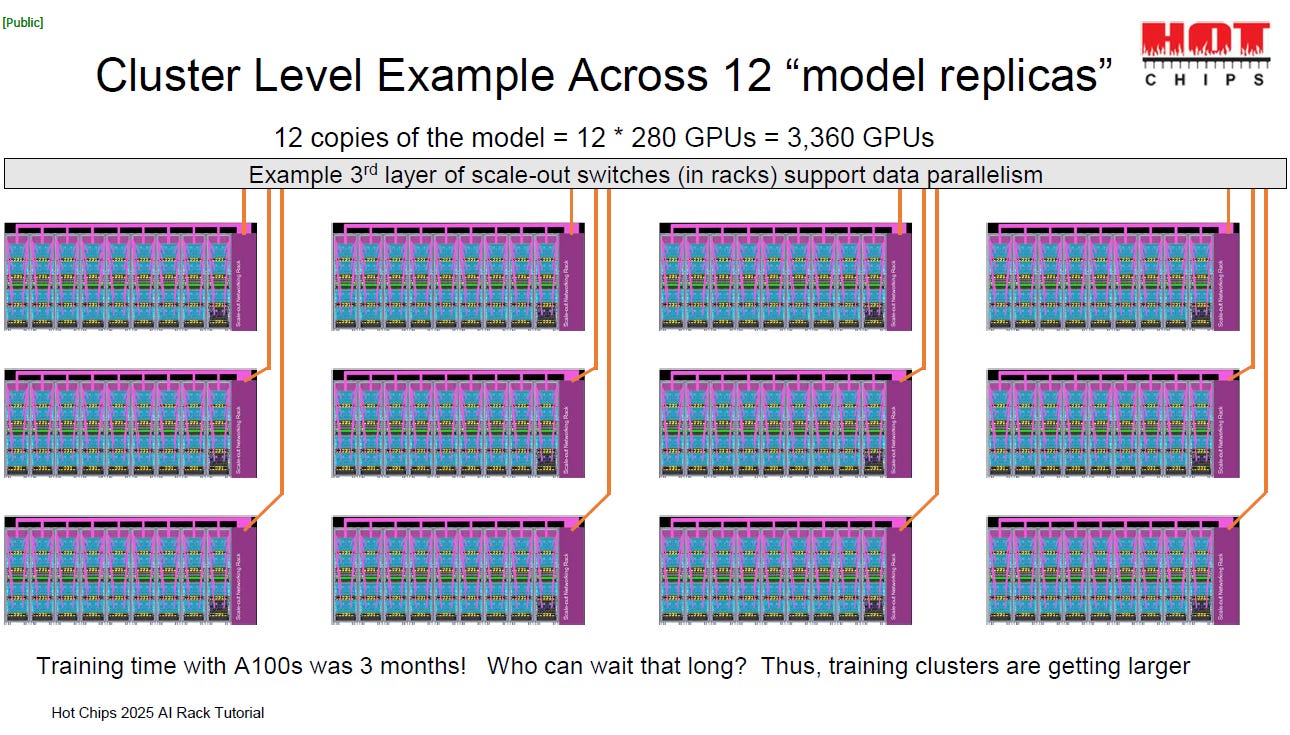
第三層:多個 Replica
Data Parallelism:整個模型副本(Replica)被複製多份,分配到不同的叢集,各自跑不同資料子集,最後用AllReduce同步。
例如圖中 12 個 model replicas = 3360 GPUs。
2. MoE(Mixture of Experts專家混合模型)
2.1. MoE vs. vs. Dense Model(稠密模型)
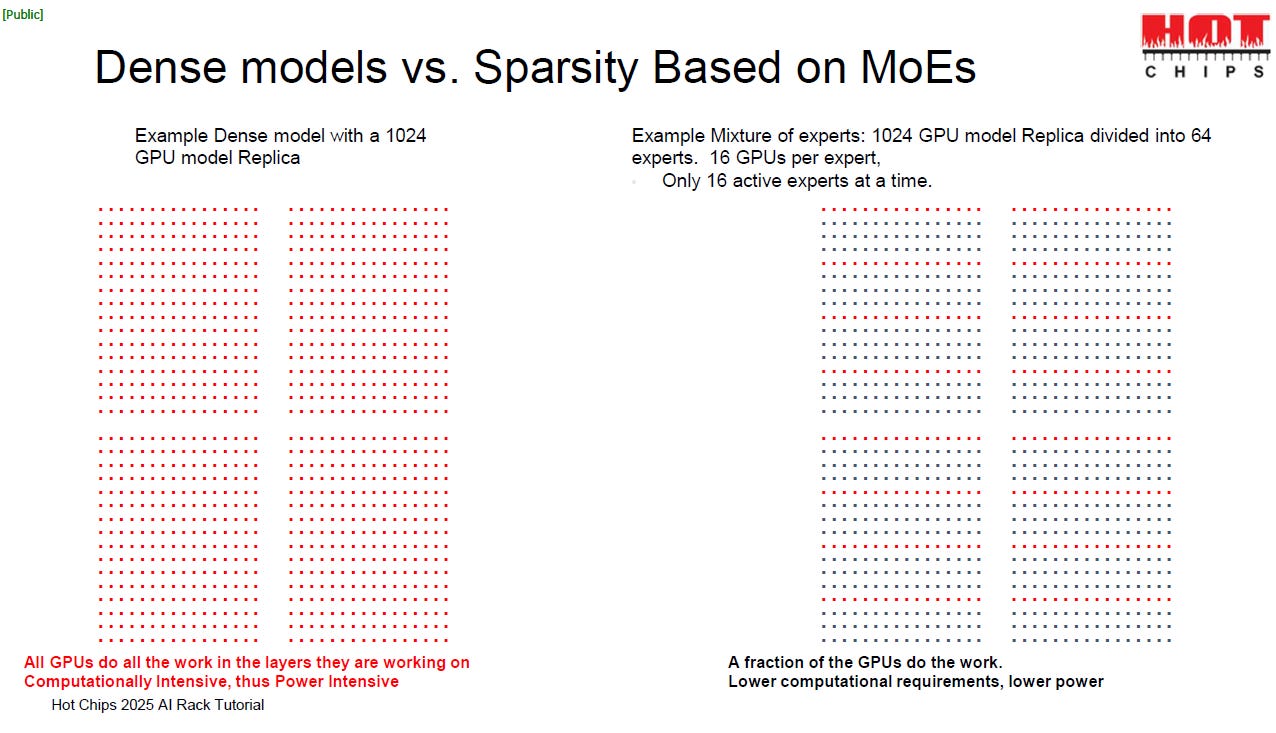
作者用廚藝做比喻,用簡單易懂的方式解釋MoE(Mixture of Experts)和 Dense model的差異:

Dense Model(稠密模型)
所有 GPU 都在工作,每一層都要全數參與
就像一個餐廳所有廚師都會煮所有菜:美式、法式、日式、印度菜,每次客人點單,全體廚師一起做。
結果:計算量 100%,耗電量也 100%。
缺點:計算太重,效率低,能耗大。
MoE(專家混合模型)
把模型分成多個「專家模組」,每個只擅長一部分。
就像餐廳有專門廚師:日本菜師傅、義大利麵師傅、印度咖哩師傅。
客人點餐時,只派對應的專家上場,不是所有廚師同時煮。
結果:同樣規模的模型,計算時只動用部分參數,耗能少、速度快。
優點:能把參數規模做得超大,但推理和訓練計算量卻顯著下降。
一句話總結
Dense = 全員上陣,算力與能耗 100%;
MoE = 只叫專家上場,計算變稀疏,省算力也省電。
2.2. DeepSeek

DeepSeek MoE(較早版本)
採用大專家 (Large Experts)。
比如:按洲別分 → 「美國+墨西哥」、「歐洲多國」、「亞洲多國」。
問題:專家太大 →需要 Tensor Slicing,要跨多顆 GPU 來算→ scale-up 通訊成本高、效率差。
DeepSeek-V3
採用細顆專家 (Fine-grain Experts)。
比如:直接分「漢堡、壽司、Pizza、義大利麵、點心…」這種更小的專家。
好處:每個專家小到能塞進單一 GPU →不用再切片,避免跨 GPU 通訊→ 訓練效率高、能耗低。
把專家切得很細雖然減少了跨 GPU 通訊,但帶來路由開銷大、負載不均、顯存碎片化與訓練複雜化的新挑戰。
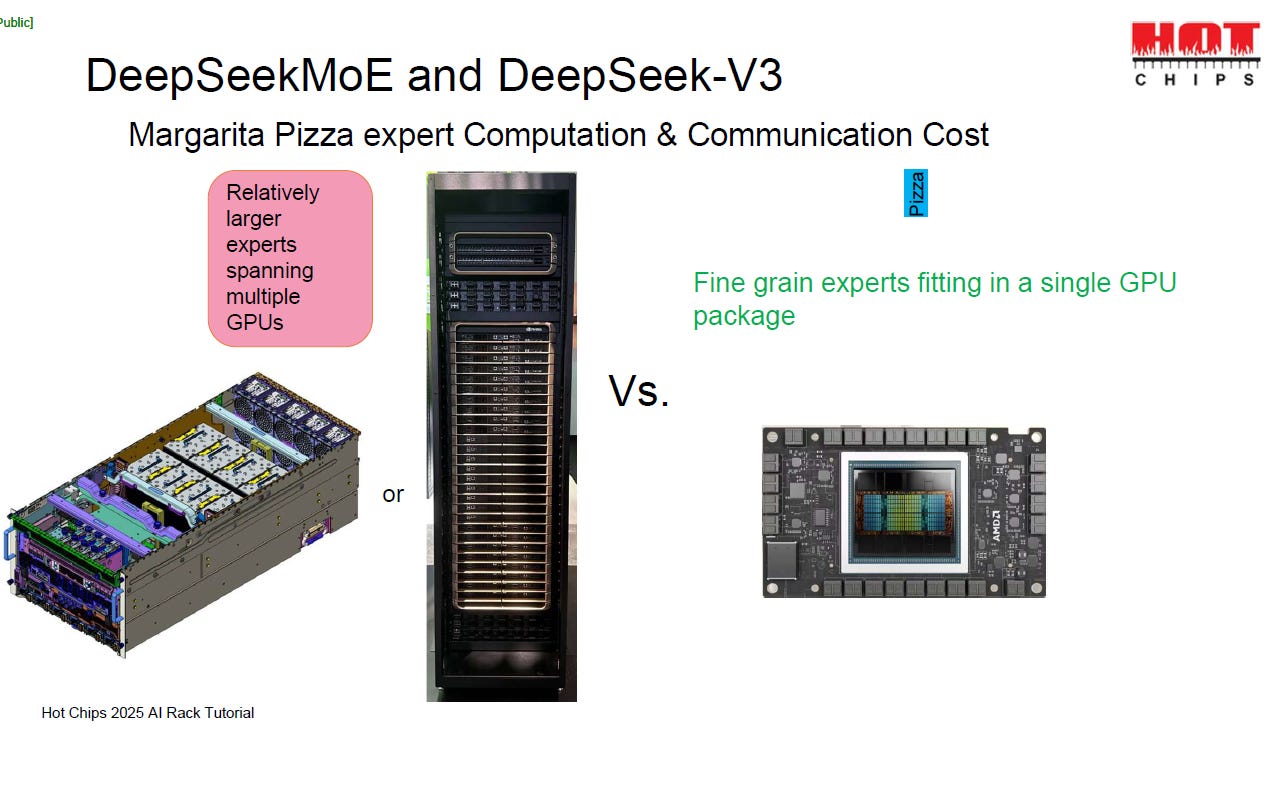
左邊:DeepSeek MoE –大專家
Relatively larger experts→ 每個專家規模很大。
一個專家必須跨多顆 GPU 或整個機櫃才能完成運算。
缺點:需要Tensor Slicing + 大量跨 GPU 通訊,計算與通訊成本高
右邊:DeepSeek-V3 –小專家
Fine-grain experts→ 每個專家被設計得足夠小。
可以直接塞進單一 GPU package中,不需要跨多卡。
優點:避免大量通訊,效率更高、能耗更低。
DeepSeek MoE → 大專家跨多 GPU,通訊開銷高;
DeepSeek-V3 → 小專家塞進單卡,效率與能效更優。
3. Rack as superchip
3.1 製程短板
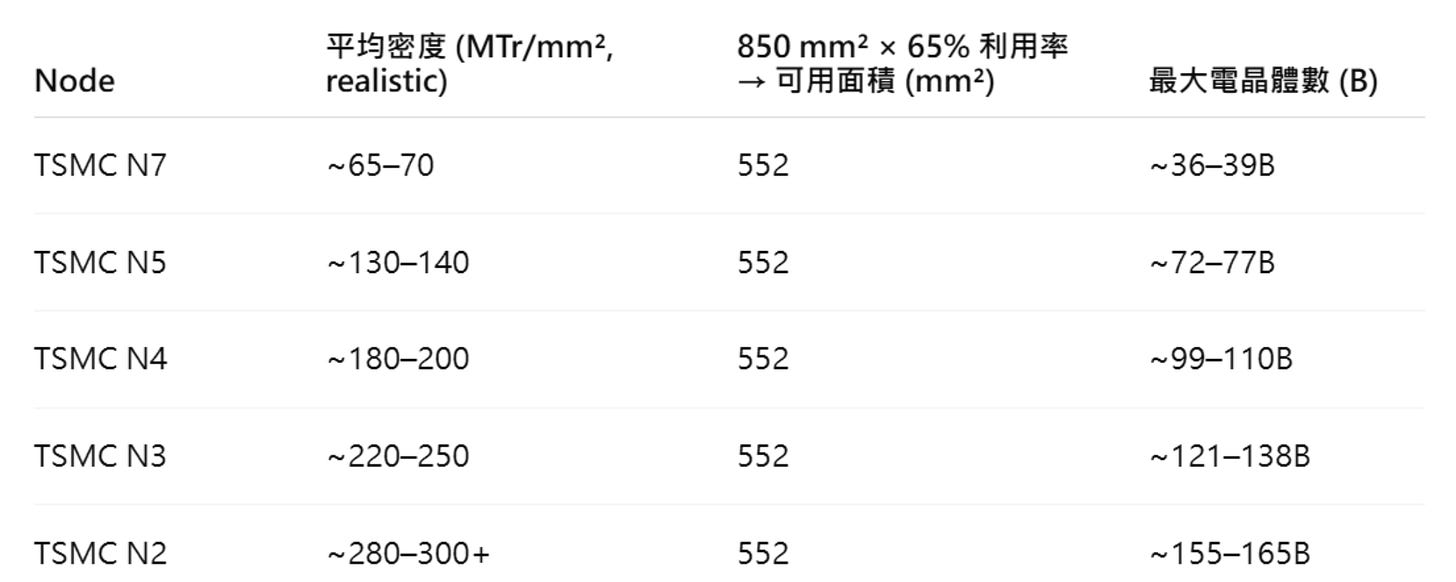
Reticle 限制:目前 EUV/ArF 曝光機的最大曝光區域大約是 26 mm × 33 mm ≈ 850 mm²。單一 die 無法突破這個物理上限:

缺陷密度問題:即使能做更大 die,良率會急劇下降,成本無法接受
功耗與散熱:單 die 功率難以超過 1 kW,否則無法在封裝內散熱。
👉 這些限制導致「超級單晶片(Superchip)」短期內無法實,參考EP12, EP13的介紹。
3.2. 解決方法
單卡 (先進製程 + 封裝)
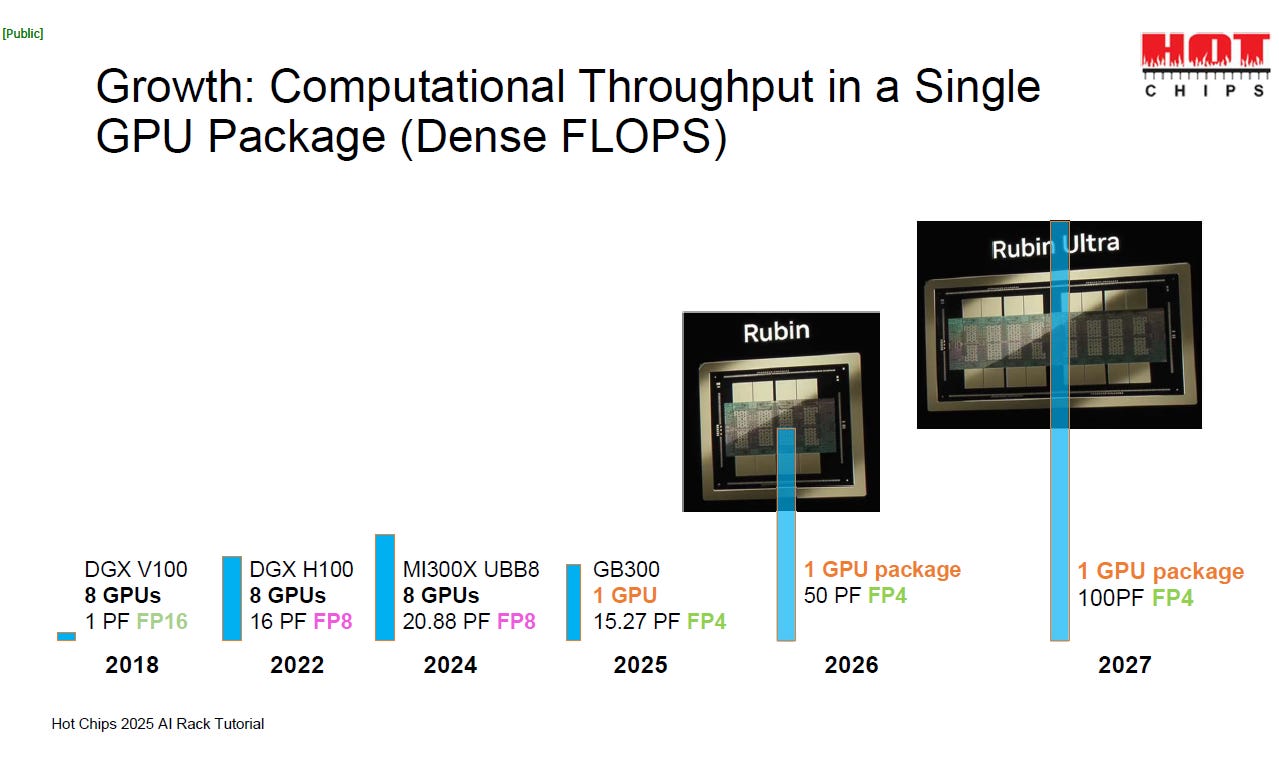
Rubin / Rubin Ultra → 即使用了先進製程 + 2.5D/3D 封裝,單 GPU 封裝能達到50 PFLOPS~100 PFLOPS (FP4)。
這對晶片設計來說已經是極限,但遠遠不及 LLM 訓練需求 (ExaFLOPS ~ ZettaFLOPS)。
機櫃級 (Scale-up Domain)
把多顆 GPU 封裝放進一個 Rack (例如 GB300 NVL72),透過NVLink/NVSwitch做高速互聯。
這樣才能把單卡算力進一步「聚合」成 Rack 級別的算力池

數據中心級 (Scale-out Domain)
再把數十到上萬個 Rack 用RDMA over InfiniBand / Ethernet連接起來。
這就是典型的三層互聯架構:
In-package→ Reticle 內部 (CoWoS/SoIC)。
Scale-up→ Rack 內 GPU 間高速連結 (e.g., NVL 5 1.8 TB/s )。
Scale-out→ 數據中心間 (0.2 TB/s 級別,但要連到數萬 GPU)。

未來百萬級 XPU (GPU + TPU + NPU) 集群將是超大模型訓練的必然需求:
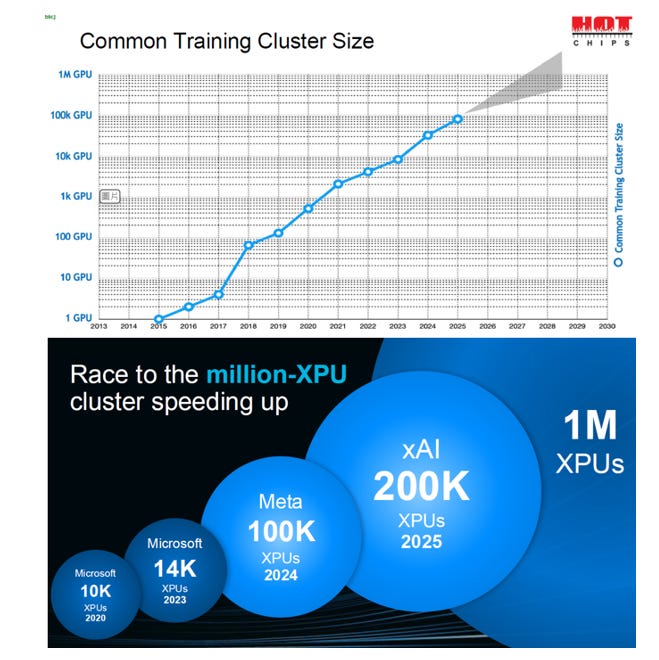
先進製程和封裝能把單 GPU 推到百 PF 級,但 AI LLM 的需求在 ExaFLOPS~ZettaFLOPS,只能靠成千上萬 GPU Cluster 協作來填補差距。
所以在Hotchips 2025,專家們提出
The Hot Chip is a Rack = 因為製程與封裝的極限,未來的「超級晶片」其實就是一整個機櫃 (Rack, scale-up domain) 當作基本計算單位。
這和華為任老所說 “用數學補物理、非摩爾補摩爾、群計算補單芯片”的策略一致。
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support


