在先前的報告中曾提及 SoW-X(System-on-Wafer, eXtreme) 技術,但當時對其中 ‘W’ 的涵義說明或許不夠明確。近日友人提供了 TSMC 於 IEEE ECTC 發表的論文,基於該資料,我進一步釐清了此一涵義,特別整理如下,供各位參考與討論。
在先前的報告中曾提及 SoW-X(System-on-Wafer, eXtreme) 技術,但當時對其中 ‘W’ 的涵義說明或許不夠明確。近日友人提供了 TSMC 於 IEEE ECTC 發表的論文,基於該資料,我進一步釐清了此一涵義,特別整理如下,供各位參考與討論。
- Source: Ted Yu
- Published: 2025-08-28T10:10:11+08:00
- URL: https://ytyuted.substack.com/p/sow-x EP13. SoW-X 簡介 - Ted Yu
Pledge your support

EP13. SoW-X 簡介

Aug 28, 2025
在先前的報告中曾提及SoW-X(System-on-Wafer, eXtreme) 技術,但當時對其中 ‘W’ 的涵義說明或許不夠明確。近日友人提供了 TSMC 於 IEEE ECTC 發表的論文,基於該資料,我進一步釐清了此一涵義,特別整理如下,供各位參考與討論。
1. SoW(System-on-Wafer)的定位
1.1 TSMC Advanced Packaging的技術
從TSMC 3DFabric Technology Portfolio 得知Advanced Packaging有三大類技術:
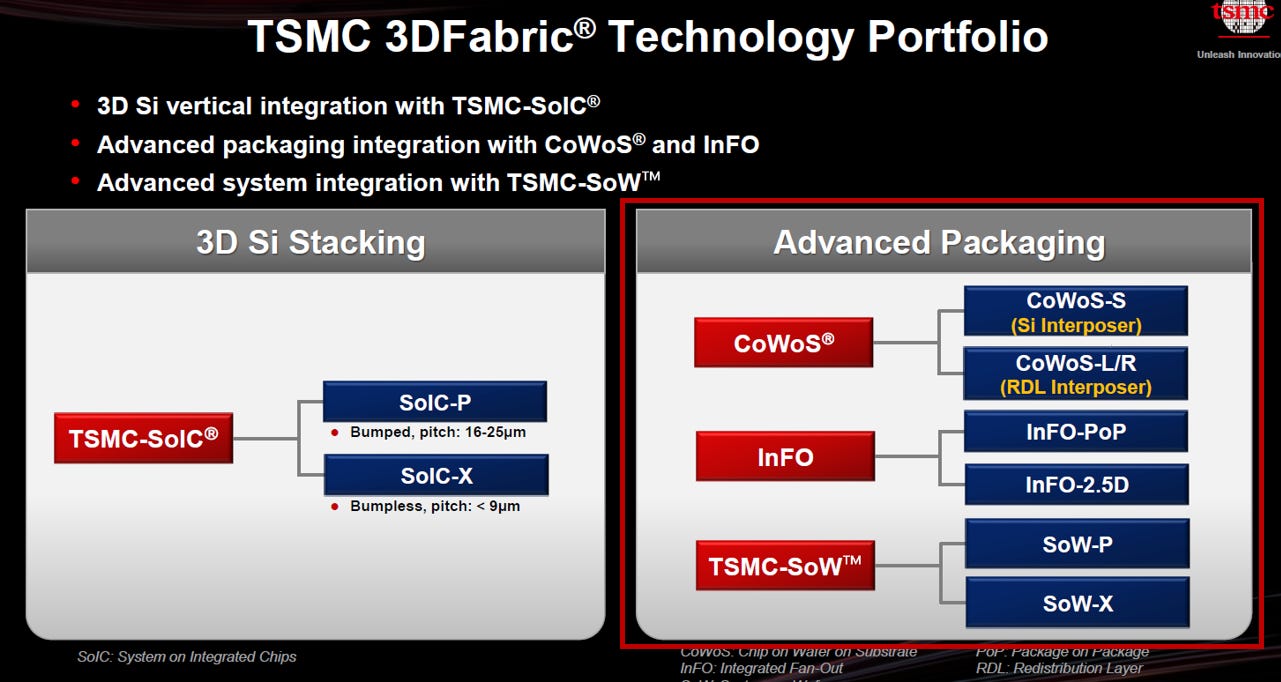
CoWoS® (Chip-on-Wafer-on-Substrate)
相對成熟,核心在矽中介層 (Si interposer, CoWoS-S)與有機 基板 (CoWoS-L/R)。
特點是能夠在>100mm 尺寸基板上進行大規模邏輯 + HBM 整合
InFO (Integrated Fan-Out)
相對成熟,特點是不使用矽中介層,而是以再配線層 (RDL) 與封裝模塑料形成扇出結構。
衍生出InFO-PoP、InFO-2.5D與InFO-SoW,逐步推進到晶圓級系統
SoW (System-on-Wafer)
屬於「先進系統整合 (Advanced System Integration)」,尚在開發中
目標是 wafer-scale(晶圓級)系統,突破單一 reticle 限制,能夠支援>40 reticle die + >60 顆 HBM。
從2024 TSMC的資料,是把SoW (System-on-Wafer)定位成CoWoS 的替代 / 補充方案

標題就直接寫:“An Option Besides CoWoS — System-on-Wafer (TSMC-SoW™)”。
意思是SoW 並不是要取代 CoWoS,而是提供另一個選項,特別是當系統規模擴大到 CoWoS 可能難以支撐時。
關鍵數據
SoW 支援>40 reticle、>60 顆 HBM,是 wafer-scale integration。
計算效能提升>40X(相較 2023 baseline CoWoS)。
技術來源
明確提到SoW leverage CoWoS + InFO
InFO-SoW 已進入量產,CoW-SoW 預計 2027 MP
從2025 TSMC的資料,已經把SoW-X 定位成 CoWoS 的繼承者 (successor),而不只是替代選項:
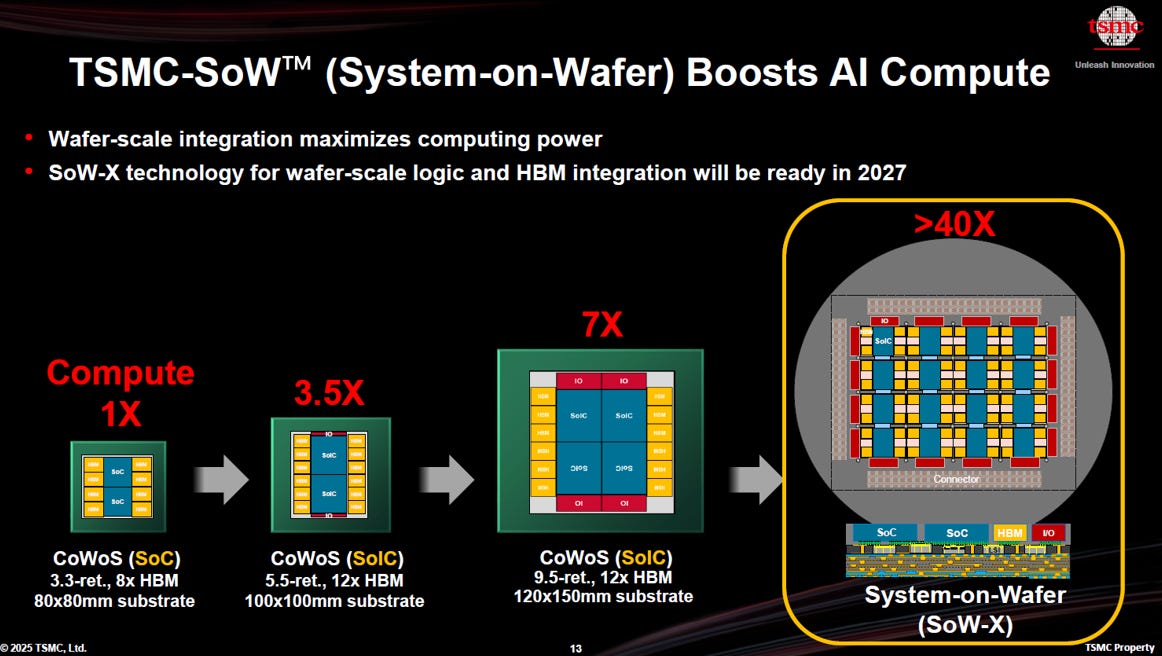
投影片標題:TSMC-SoW™ (System-on-Wafer) Boosts AI Compute
明確指出:
SoW-X是針對wafer-scale logic + HBM integration的技術
預計2027 ready
CoWoS 的繼承者不只 SoW-X,其實還有提出 CoPoS、CoWoP 這些方案(參考前期EP10. 的報告)。
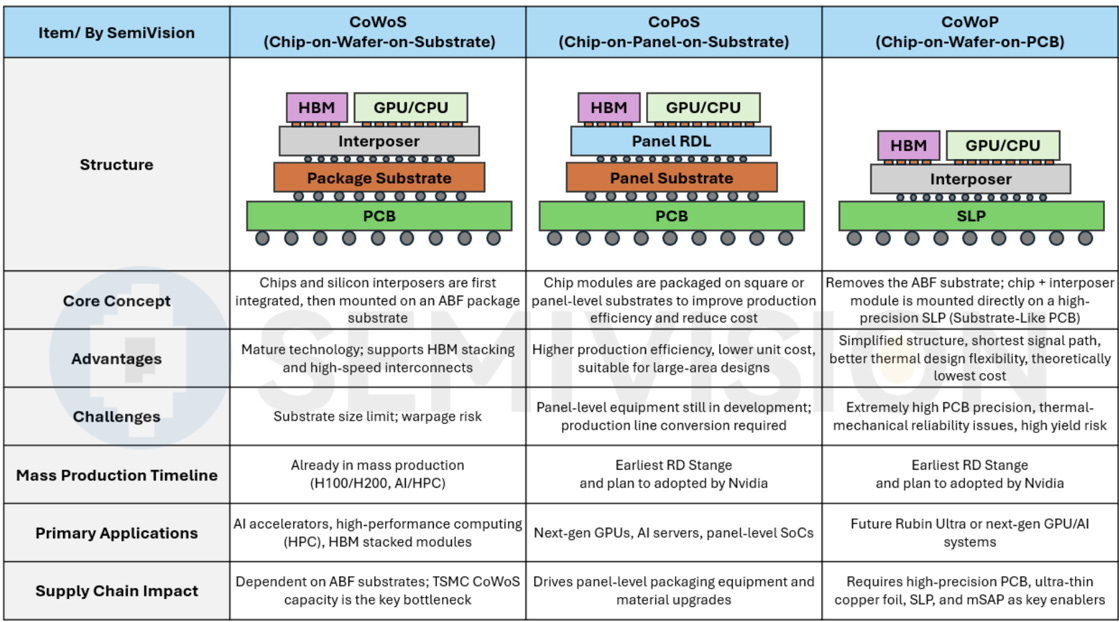
但TSMC 對外公布的 roadmap 裡,CoWoS 的繼承者就是 SoW-X。
其他像CoPoS、CoWoP,目前可以理解為探索性的 parallel options,但不是公開的「正式繼任者」。
1.2. Nvidia 採用的技術
Nvidia GPU Roadmap:

對應到TSMC Advanced Packaging:
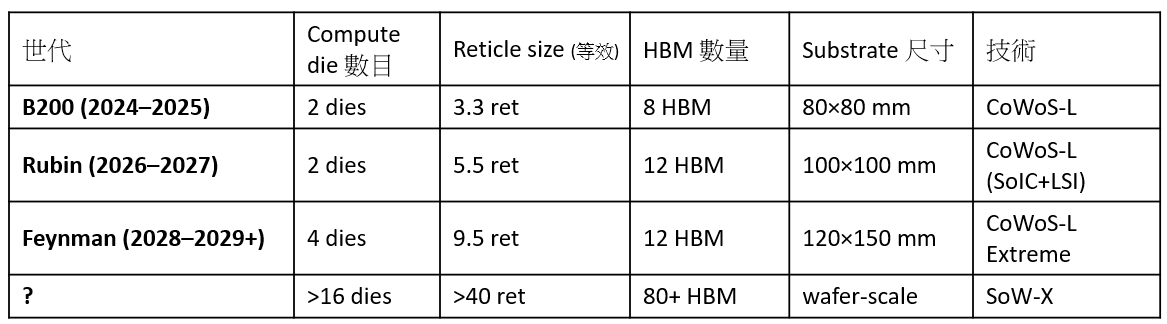
這條路線顯示,CoWoS-L 仍是短中期主力,而 SoW-X 將在 2030 年左右成為新的封裝架構典範。
NVIDIA 在 HPC/AI GPU 的封裝策略上,隨著算力與記憶體需求的提升,逐步從 CoWoS-L 往更大 reticle 拼接與更多 HBM 堆疊演進。最終在 TSMC 路線圖中,將進一步走向 SoW-X (System-on-Wafer)技術,實現 wafer-scale compute。
1.3. SoW(System-on-Wafer)的W意思
從TSMC 於 IEEE ECTC 發表的相關資料,W是指reconstructed wafer, not silicon wafer

目前業界真正做到整片 silicon wafer 當成單一晶片的,幾乎只有Cerebras WSE (Wafer-Scale Engine)系列:
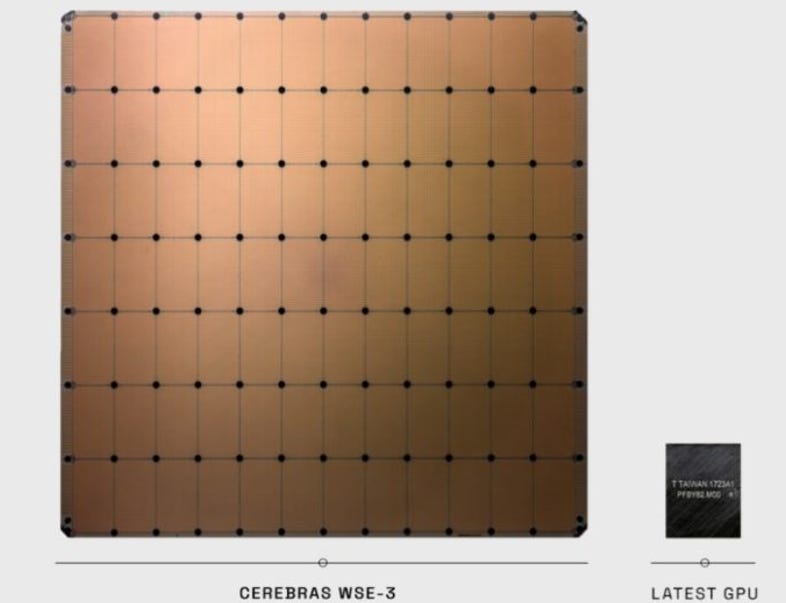
Cerebras WSE-3應該是透過stitching (光罩拼接)技術,來解決reticle size 限制。
WSE-3 擁有850,000 個核心,晶片面積≈46,225 mm²(接近整片 wafer)
良率靠冗餘結構保證,不必要求 100% 無缺陷。
2. SoW-X Structure
2.1. CoWoS-L 的C4 Bump 可靠度
不同介面使用的鍵結方法:

IMC: InterMetallic Compound (金屬間化合物)
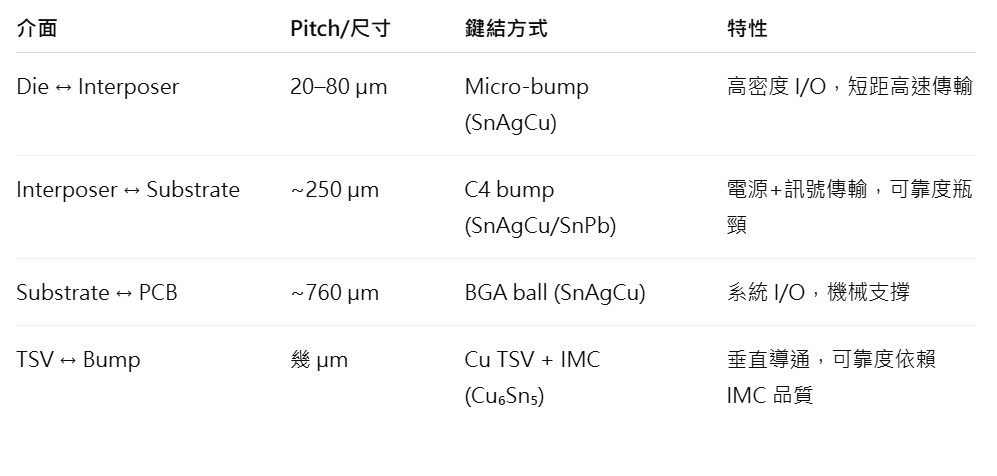
C4的定義:
C4是Controlled Collapse Chip Connection的縮寫
最早由 IBM 在 1960–70 年代發明,用來取代金線鍵結 (wire bonding)
本質上就是一種焊球接合技術 (solder bump bonding),把晶片直接透過錫球 (solder balls)鍵結到基板 (substrate) 或中介層 (interposer)
C4 Bump 可靠度問題:
論文在描述 SoW-X 架構優勢時,直接點名傳統CoWoS-L在「超大尺寸封裝」時的問題:
“…enhanced system power efficiency and theelimination of C4 joint difficulties during the on-substrate (oS) process for a super large-size package.”
當CoWoS-L 封裝尺寸變大,需要大量C4 bump與基板連結
封裝面積擴大後,C4 bump 面臨機械應力、翹曲 (warpage)、熱膨脹 mismatch等可靠度問題。
這是 CoWoS-L 無法再無限放大的「直接瓶頸」
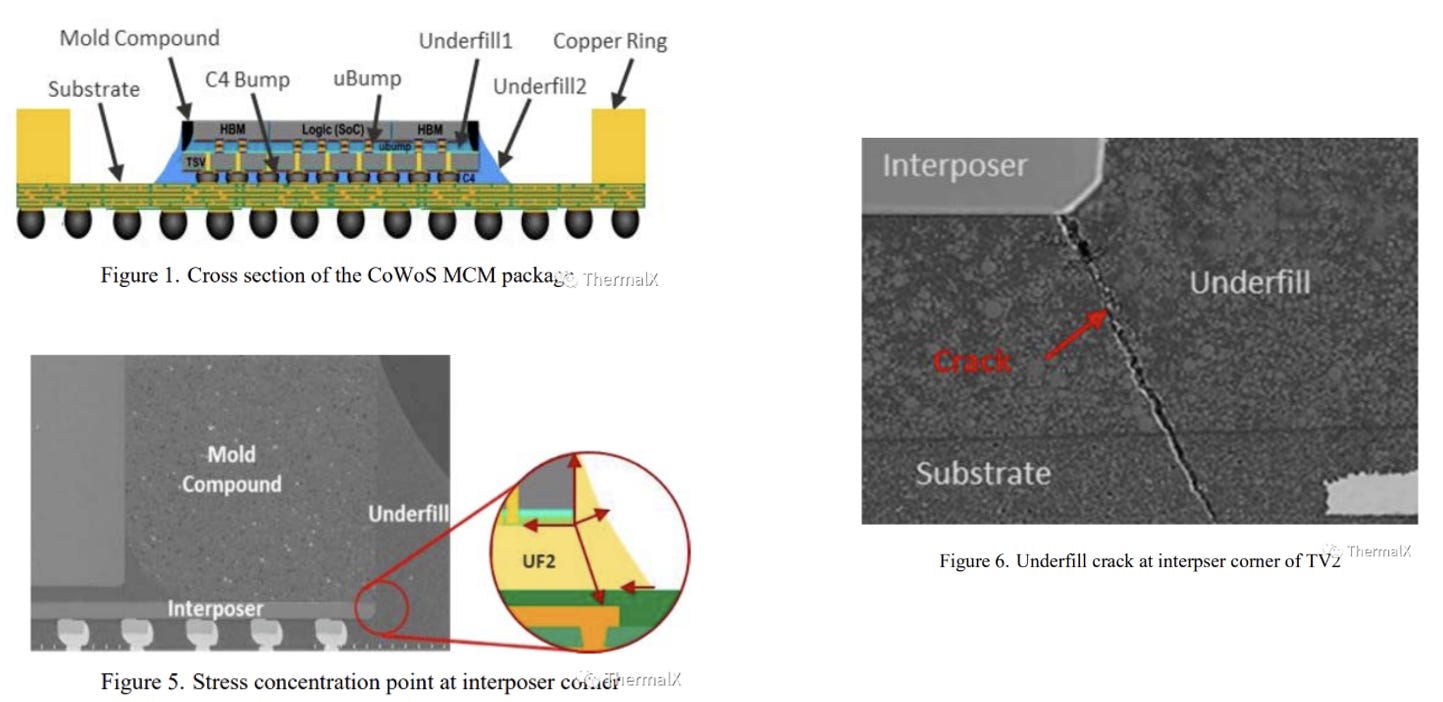
熱膨脹係數 (CTE) 不匹配 → 長期熱循環下易產生疲勞、裂紋、可靠性下降
2.2. Reconstructed Wafer由來
SoW-X 為晶圓級 2.5D/3D 異質整合平台:結合InFO_SoW(系統級扇出)與CoWoS-L(有矽穿孔之在機板/載板樣式 LSI 互連)的優點:
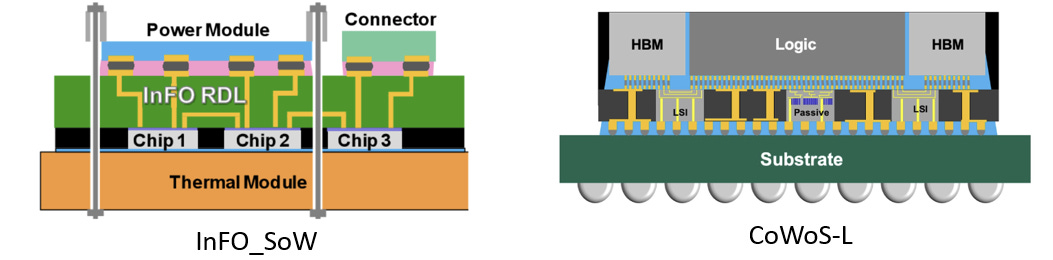
來自 CoWoS-L 的元素
LSI (Local Silicon Interconnect):用矽橋 (silicon bridge) 提供高密度 ASIC ↔ HBM / ASIC ↔ ASIC 互連
eDTC (embedded Deep Trench Capacitor):整合在 LSI 內,用來改善 PDN 穩定性
UCIe 高密度 die-to-die 介面:N–S 方向 ASIC 間透過 LSI/UCIe 連線
👉SoW 承襲 CoWoS-L 的局部高密度矽互連技術。
來自 InFO_SoW 的元素
再構晶圓 (Reconstituted Wafer):將多顆dies 嵌入模塑材料中,重組成 wafer 尺度
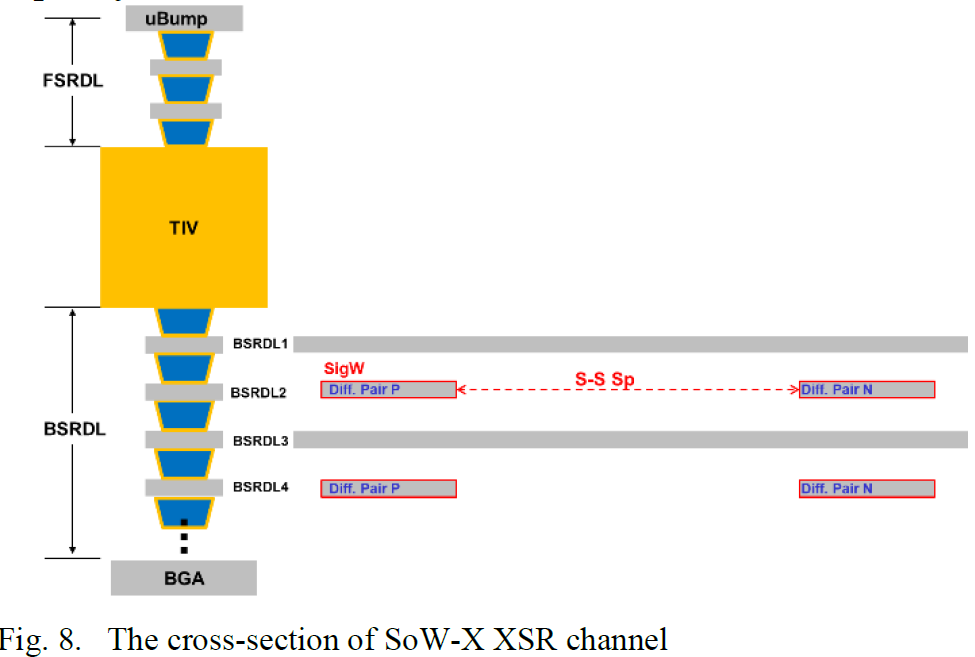
雙面 RDL(Redistribution Layer): FSRDL(FrontSide RDL ) + BSRDL(BackSide RDL)
-前側 (FSRDL):PI(Polyimide),fine-pitch routing,ASIC ↔ HBM/IO 短距離連線
-背側 (BSRDL):ABF-like dielectric,支援 224G SerDes 長距走線 + kW 級供電
TIV (Through Insulator Via):把上下兩面 RDL 與 LSI 連接起來
•👉SoW 承襲 InFO_SoW 的 wafer-level fan-out 架構
Reconstructed wafer(重構晶圓):
包含front-side RDL (FSRDL)、back-side RDL (BSRDL)、TIV、LSI (eDTC):

為何要「前 PI、後 ABF」?
•前側 (fine pitch):PI → 解決 微米級 routing(ASIC/HBM/IO die 間的密集連線)
•後側 (coarse + power):ABF → 支援 毫米級高速通道 & 千瓦級供電。
•STCO(System-Technology Co-Optimization) 規劃:其實就是 把 chiplet 細 pitch routing 放在前面 (PI),把 system-level I/O 和電源放在背面 (ABF),兩者藉由 TIV (Through Insulator Via) 和 LSI 溝通。

•FSRDL 用 PI → 為了做細 pitch、高密度 chiplet 互連。
•BSRDL 用 ABF → 為了支撐厚 Cu、大電流供電 & 長距 SerDes。
ABF(Ajinomoto Build-up Film)來自味之素的產品:

2.3. Reconstructed WaferPlacement (以論文為例)
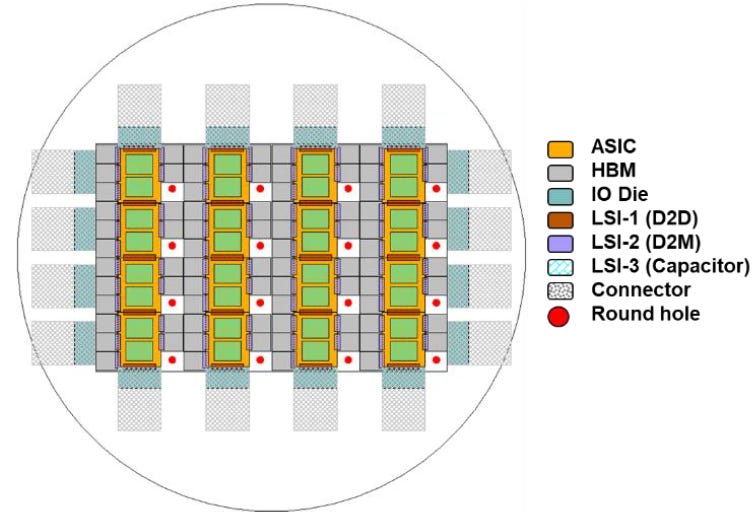
ASIC (運算核心)
採 4×4 排列,共 16 顆 ASIC。
以垂直 (N–S) 方向為主要通道,利於冷卻與 UCIe 互連
HBM4 (高頻寬記憶體)
緊鄰 ASIC,配置在E–W 方向,方便對應到 LSI-2 (D2M, die-to-memory)
IO Die (外部 I/O)
放在 wafer 邊緣,連接到connector + SerDes,提供 wafer-to-wafer / rack 級延伸
LSI (Local Silicon Interconnect)
LSI-1 (D2D):ASIC ↔ ASIC 橋接
LSI-2 (D2M):ASIC ↔ HBM PHY
LSI-3 (Capacitor):嵌入 eDTC,改善 PDN
Round holes:機械固定孔,用於冷卻板與結構支撐
2.4. Signal Arrangement (訊號路徑規劃)
短距離互連 – Parallel 接口 (UCIe, HBM PHY)
介面:UCIe / HBM4 PHY
形式:Parallel bus(多線同時傳輸,寬 I/O)
應用:
ASIC ↔ ASIC(近距離 N–S 方向,距離 < 300 µm)
ASIC ↔ HBM(距離 < 6.5 mm,E–W 方向)
特性:
通道數多(數千 I/O pins)
單線速率:~32 Gb/s (UCIe),~8 Gb/s (HBM4)
能耗:~0.4–0.5 pJ/bit (UCIe),2.6 pJ/bit (HBM4)
延遲低,頻寬密度高,最接近「SoC on-die bus」體驗
設計意圖:
平行介面在短距離時具備極佳能效與頻寬,適合 SoW-X 內部的核心運算 ↔ 記憶體。

長距離互連 – SerDes 接口 (224G XSR)
介面:224G XSR SerDes (BSRDL routing)
形式:Serial high-speed link(單通道極高速率,需串並轉換)
應用:
ASIC ↔ ASIC(E–W 方向,跨越兩排 HBM,距離 ~30 mm)
特性:
單通道速率 224 Gb/s
通道數較少,但 aggregate 帶寬可達 ~5 TB/s (per ASIC-to-ASIC link)
能耗:~1.2–1.5 pJ/bit
通道需保持 ≤ –6 dB 損耗 @ 56 GHz Nyquist
設計意圖:
平行匯流排在 30 mm 長距下難以維持 SI/PI → 改用 SerDes 減少線數,降低 routing 複雜度與損耗。
外部互連 – SerDes I/O (224G XSR via IO Die)
介面:224G XSR SerDes (Connector I/O)
形式:Serial high-speed link
應用:
IO Die ↔ Connector ↔ 外部纜線 ↔ 隔壁 SoW-X 或 Rack 系統
特性:
單 IO die 整合 ~100 條 224G SerDes → ~5 TB/s
多 IO die 圍繞 wafer → 提供80 TB/s external bandwidth
通道損耗需求更嚴苛 (≤ –10 dB, ~50 mm routing + connector)
設計意圖:
提供 SoW-X ↔ SoW-X / Rack 級連線,實現 AI 超級電腦集群。
電源與地 (Power/Ground Delivery)
路徑:VRM → Backside RDL (厚 Cu 多層) → ASIC/HBM/IO
強化:LSI-embedded eDTC (深槽電容) → PDN 阻抗降低 ~50%
目的:確保 ~17 kW wafer-scale 系統的穩定供電,避免訊號抖動與電壓 droop。

Parallel vs. SerDes 在 SoW-X 中的角色

Marvell 也特別highlight這兩種傳輸模式:

3. STCO(System-Technology Co-Optimization)
論文有特別提到STCO,這和DTCO(Design-Technology Co-Optimization)的差異解釋如下:
DTCO (Design-Technology Co-Optimization)
指「設計—製程協同最佳化」
目標:讓電晶體與電路設計與製程技術同步考慮,避免單方面推進造成效能或良率受限。
核心場域:前端設計 (logic cell, SRAM, standard cell)與FEOL/BEOL 製程的配合
STCO (System-Technology Co-Optimization)
指「系統—技術協同最佳化」
目標:把系統架構需求 (AI/HPC workload, memory hierarchy, interconnect topology, power delivery, cooling)與封裝/製程平台一起規劃。
核心場域:異質整合 (2.5D/3D, SoIC, SoW-X, CoWoS),強調封裝 + 電路 + 系統一體化。


在傳統的晶圓代工模式裡,最重要的關鍵字是DTCO(Design-Technology Co-Optimization,設計–製程協同最佳化)。它的核心精神是讓設計與製程互相配合,例如晶體管結構、金屬層互連、標準元件庫的設計,這些都需要與先進製程節點(如 FinFET 或 GAA)緊密結合。以往的代工廠主要專注於這個層次:怎麼在同樣的節點上榨出更多性能、更低功耗與更高密度。
然而,隨著 AI 和 HPC 系統變得越來越龐大,僅靠單一晶片的縮放已經不夠。這時候出現了STCO(System-Technology Co-Optimization,系統–技術協同最佳化)的概念。STCO 不只考慮單一晶片,而是把晶粒分割(chiplet)、先進封裝(CoWoS、SoW-X)、甚至整個系統架構一起納入設計流程。換句話說,最佳化的單位不再是「一顆 SoC」,而是「一個系統」。
在SoW-X的論文裡,可以清楚看到這種轉變:
訊號互連:UCIe 被用於短距 ASIC 與 HBM 之間的平行互連,而跨越 30 mm 的長距 ASIC-to-ASIC 則交由 224G SerDes 負責。這種分工不是單純的電路設計問題,而是系統級帶寬、延遲與能耗的最佳化結果。
電源設計:SoW-X 在 LSI 中內建深槽電容(eDTC),並且在 wafer backside 透過厚銅 RDL 與 VRM 模組進行大電流分配,這些設計確保了單 wafer 高達 17 kW 功耗的電源完整性。
散熱架構:TSMC 甚至連冷卻流道方向(N–S vs. E–W manifold)都納入 STCO 分析,最後證明 N–S 流向能讓 hotspot 溫度降低 12 °C。
這些例子說明,TSMC 不再只是一家單純的製程供應商,而是逐漸往系統解決方案提供者的角色靠近。過去它的優勢在於DTCO,現在它也開始強調STCO,把晶片、封裝、電源、散熱、互連,甚至應用需求都一併納入考量。
[Reference]
“SoW-X_A_Novel_System-on-Wafer_Technology_for_Next_Generation_AI_Server_Application” by TSMC P.C Shih,. etc, 2025 IEEE 75th Electronic Components and Technology Conference (ECTC)
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support
