前幾天OCP在台舉辦了APAC summit,其中TSMC Dr.
前幾天OCP在台舉辦了APAC summit,其中TSMC Dr.
- Source: Ted Yu
- Published: 2025-08-21T10:39:14+08:00
- URL: https://ytyuted.substack.com/p/ep12-semi-technologies EP12. Semi Technologies Update - Ted Yu
Pledge your support

EP12. Semi Technologies Update

Aug 21, 2025
前幾天OCP在台舉辦了APAC summit,其中TSMC Dr. Hou的Keynote值得一讀(鏈結在Reference)。OCP能開放會議資料值得讚揚。
這次報告只介紹這張經典的Picture,包含許多資訊。分享一下個人心得,歡迎討論。
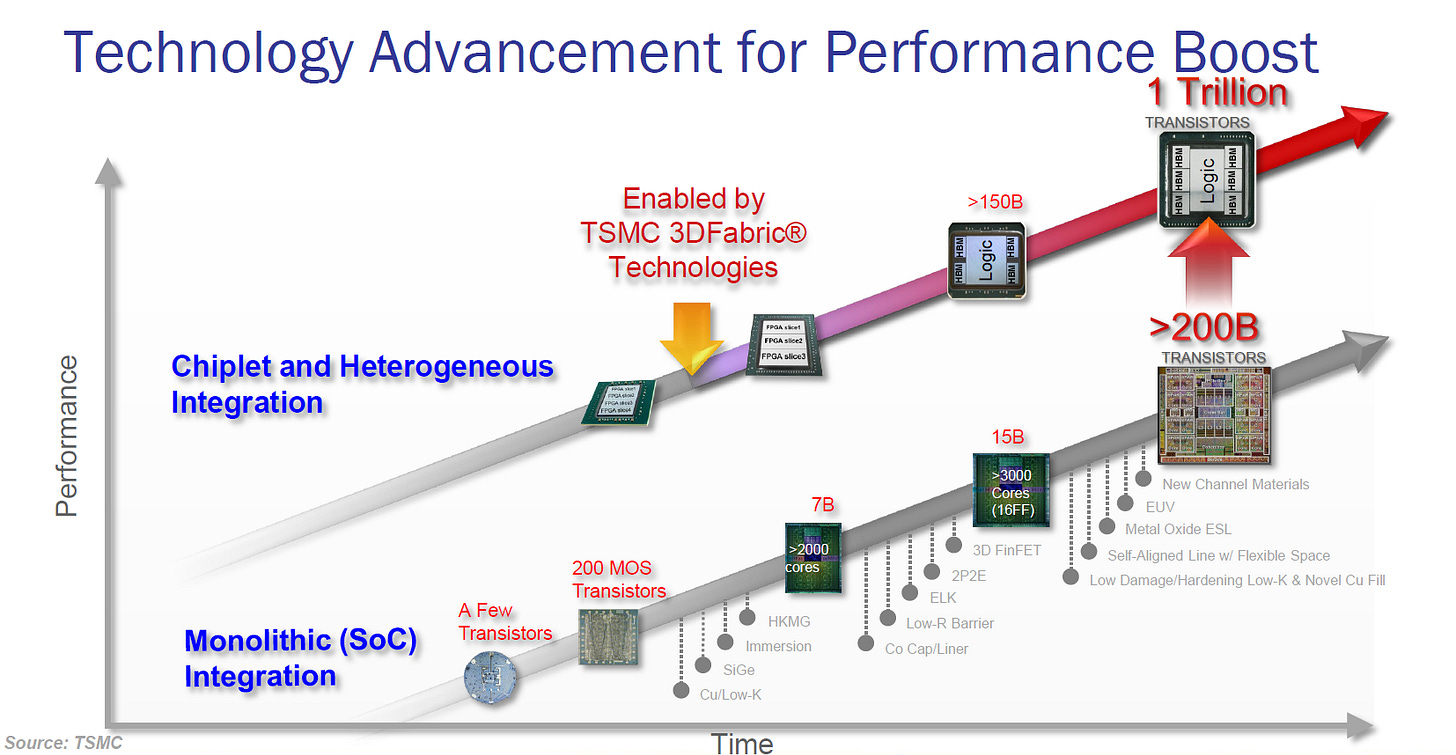
1. More Moore and More than Moore
這張圖有兩條發展路線: 下方"Monolithic Integration"是製程節點的進化,上方"Chiplet and Heterogrenous Integration”則是先進封裝。兩條路線都強調電晶體數量。
Marvell 也引用這張經典的圖,說明自家產品發展路線:
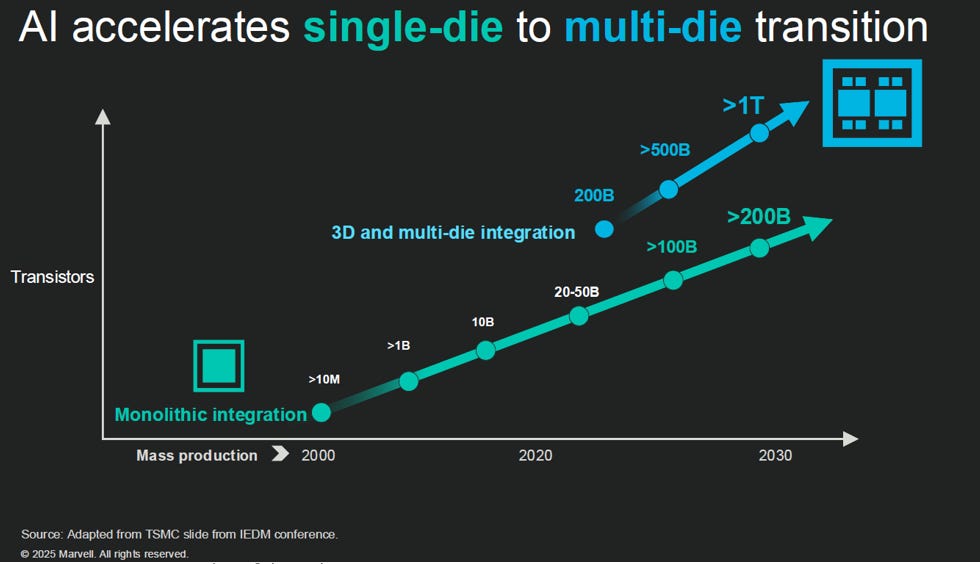
摩爾定律在advanced node (先進節點,~16nm 之後)已難以僅靠幾何縮放延續,因此產業轉向等效縮放(新材料如 High-k/Metal Gate、新結構如 FinFET、GAA)來維持性能與密度進步;同時,也透過Heterogeneous Integration (HI,異質整合)——例如 2.5D/3D 封裝、HBM、CPO ——將多種晶片與功能整合於單一系統,以突破單純晶體管縮放的限制。

現今所謂的摩爾定律 2.0,更強調透過系統級的電晶體整合與效能提升,來大致維持每兩年的倍增趨勢,而不再依賴單一晶片的幾何縮放。
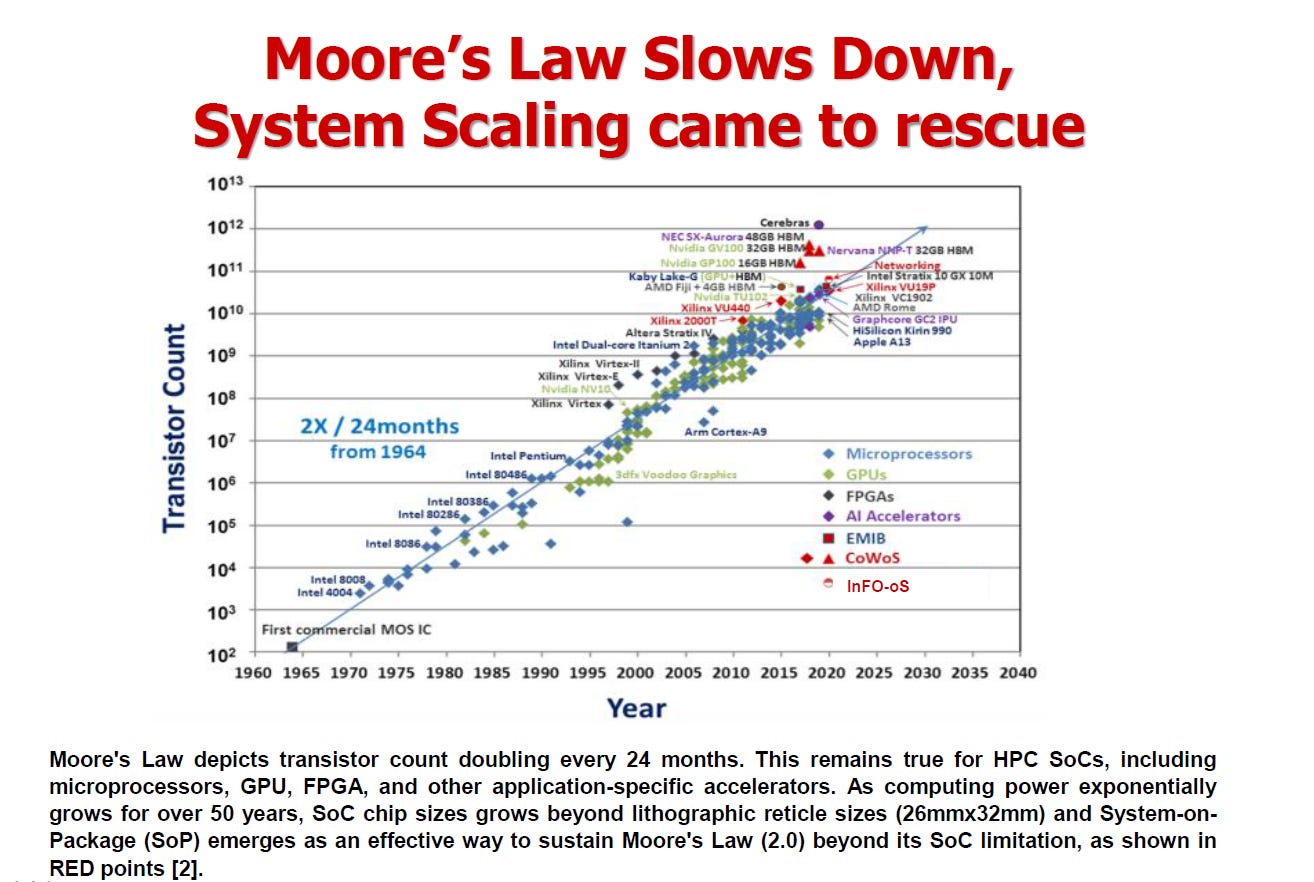
早在2010 ITRS(International Technology Roadmap for Semiconductors)就已提出「More Moore + More-than-Moore」的雙軌策略:

More Moore:持續推進先進節點,延續摩爾定律。
More-than-Moore:異質整合與功能多元化
這兩條路徑在 AI/HPC 領域已逐漸落實:一方面透過 5nm 甚至更先進節點的 FinFET/GAA 持續推進 More Moore;另一方面則依靠 CoWoS、InFO、SoIC 等異質整合封裝,將 GPU 與 HBM 記憶體、光學互連及專用加速器結合,形成高效能系統,推動今日的摩爾定律 2.0。
2. Monolithic Integration: Transistor Number
2.1. 起點

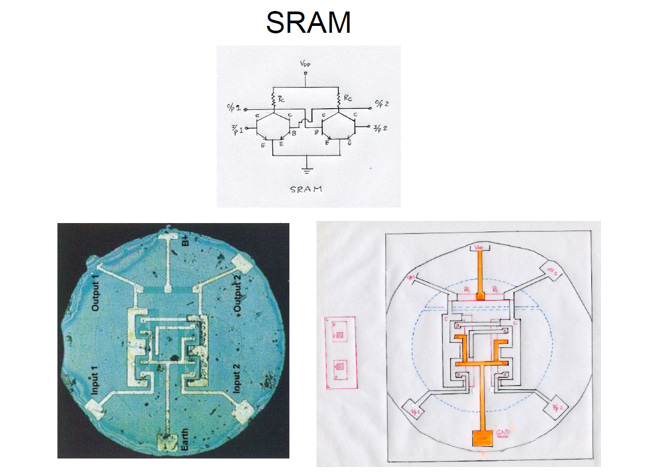
Monolithic Integration 起點是4個BJT組成的SRAM IC。
2.2. 目標(> 200B)
2.2.1. 製程結點(Node)與電晶體數 (Tr) 的關係
製程結點定義的演變
早期 (90 nm, 65 nm, 45 nm …):「node」大致對應到最小閘長 (gate length)或金屬半間距。
進入 22 nm 之後,node 名稱變得更像「行銷名稱」而不是單純幾何尺寸,通常由Foundry 自行定義,並不能直接對應到一個實際的 CD (Critical Dimension)。
電晶體密度 (MTr/mm²) 的推估
電晶體數量 =(可用面積 mm²) × (平均密度 MTr/mm²)
其中平均密度取決於:
Node 技術本身(越先進 → 越高密度)
SRAM vs. Logic 比例(SRAM density > Logic density)
設計利用率(floorplan、保護帶、yield margin)

Reticle size 限制
在光刻機 (scanner) 裡,曝光區域有限。
目前 ASML 的ArF / EUV scanner,單一reticle field大約26 mm × 33 mm ≈ 850 mm²。
這意味著:單顆裸晶 (die) 不能超過 850 mm²(除非用多重曝光 / stitching,但實務上幾乎不用在先進邏輯)。

電晶體數 (Tr number)上限推估
以reticle limit = 850 mm²來推算不同 node 的上限電晶體數:

所以> 200B的目標可能需要更先進的製程(A16, A14)。
2.2.2. Blackwell 電晶體數 (Tr)的估算
官網的數據: 兩個Reticle size的die,TSMC N4工藝,每個die有104B個電晶體。但沒有提Logic和SRAM的比例,這會影響電晶體密度的推估。
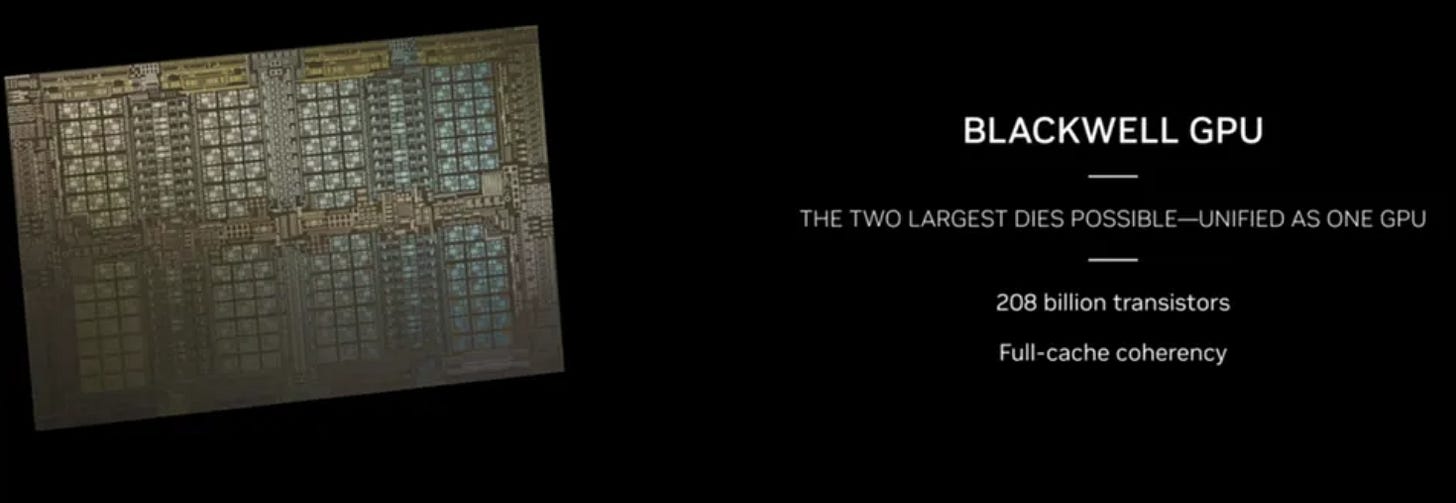
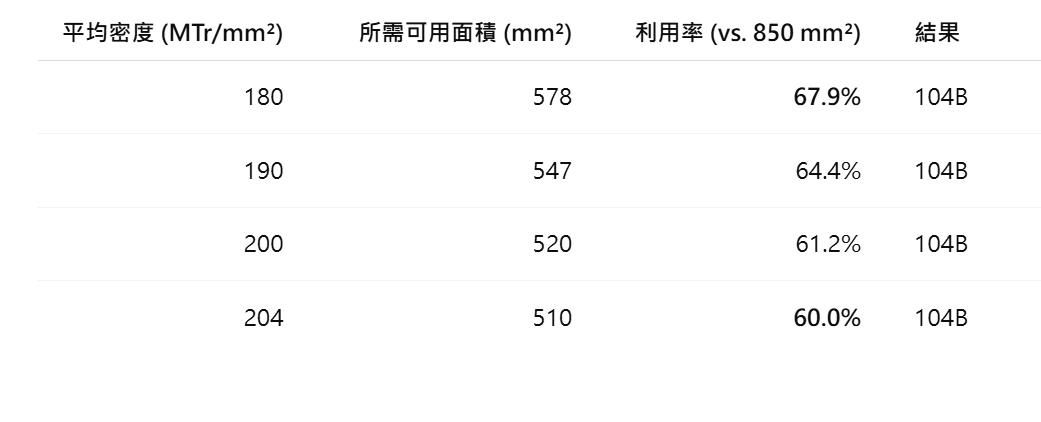
要達到~104B,必須假設更高的利用率 (~68%)或更高的平均密度 (~200 MTr/mm²)。
這兩種情境在真實設計中都是可能的:
若 Blackwell SRAM 區域佔比大 → 接近 204 MTr/mm²
若 floorplan/繞線優化佳 → 接近 68% 利用率
3. Monolithic Integration: Technologies
3.1. 關鍵製程結點技術
在圖中有標註14個關鍵製程結點技術,整理如下:
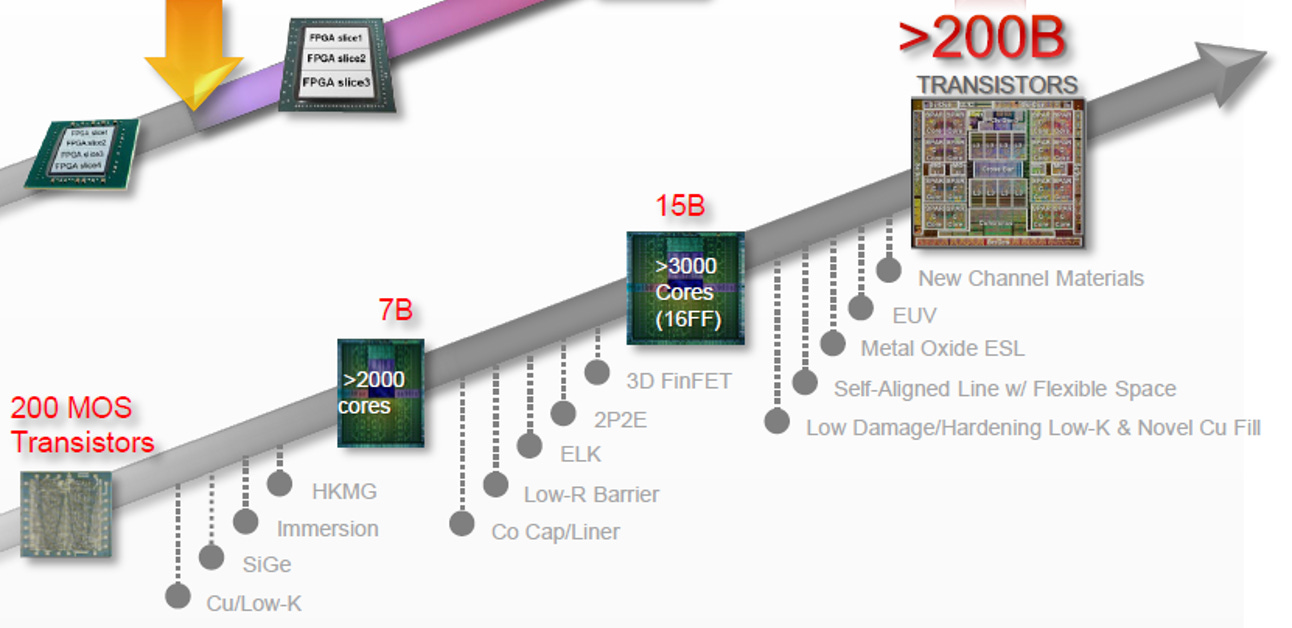
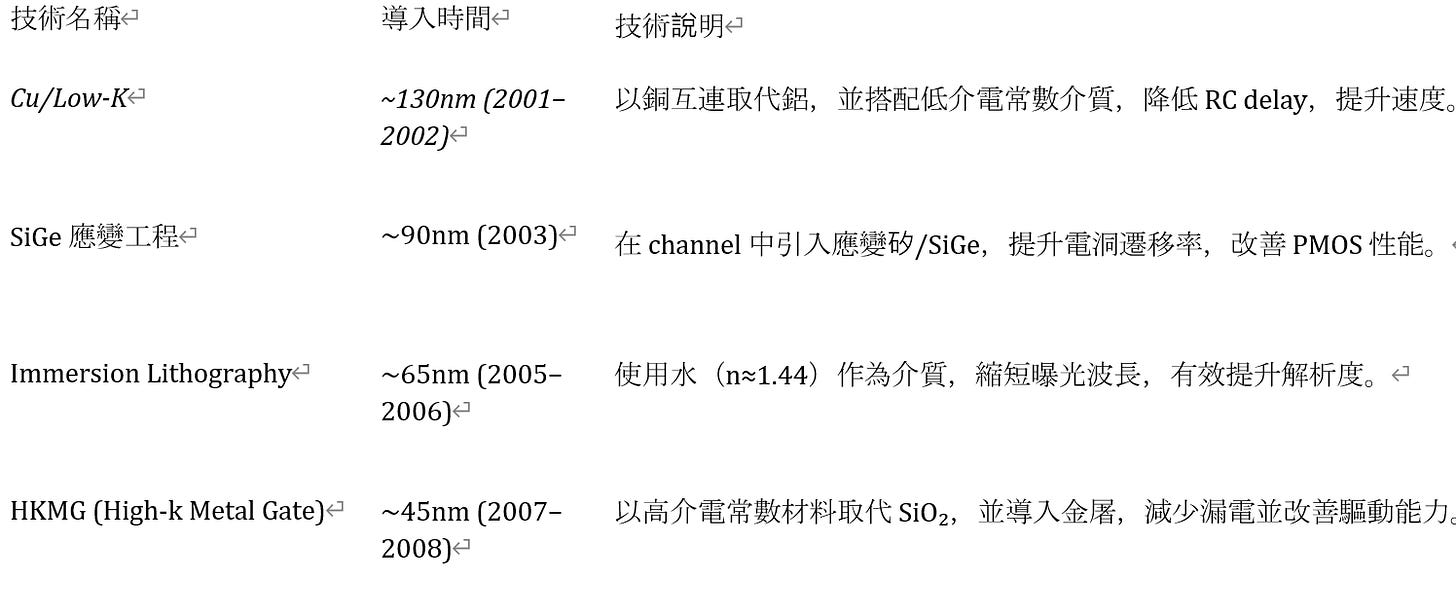
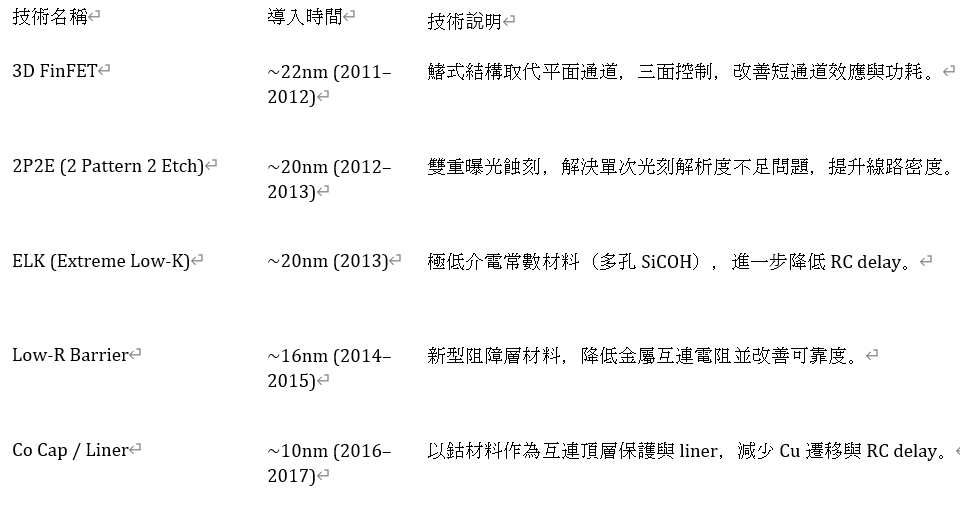

之前EP4.介紹半導體博主三圈教練,精心製作的小米玄戒O1微觀世界。 也提到幾項重要技術的突破,值得參考(鏈結在Reference)。
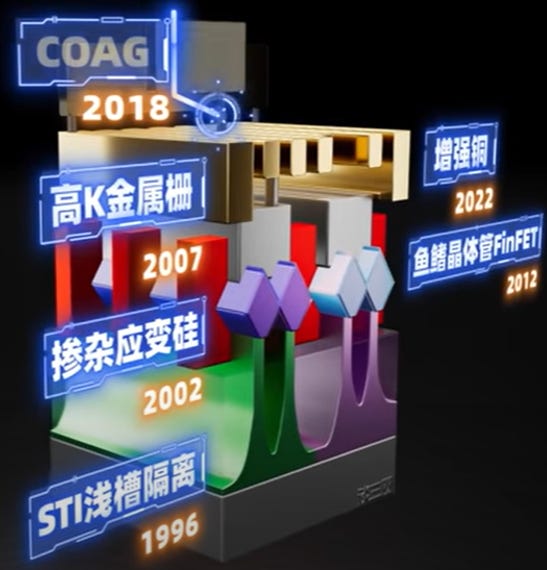
3.2. RC Delay
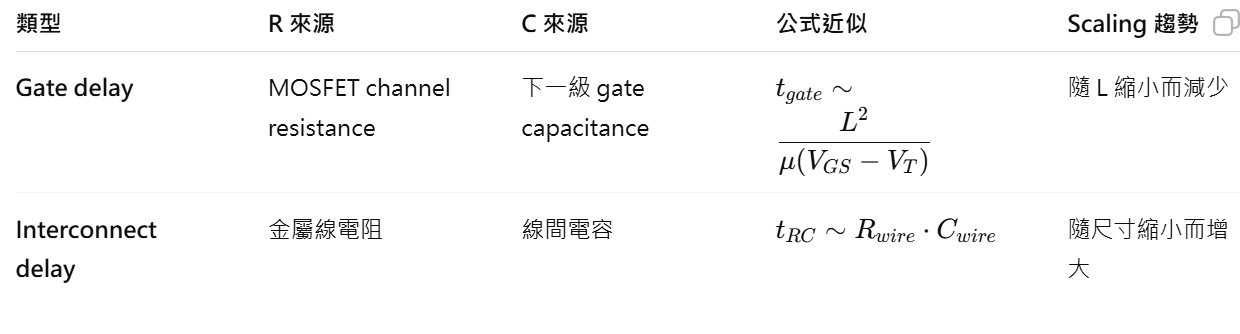
與系統工程師相關的是RC delay,至少有6項和改善RC delay有關。RC delay 主要來自BEOL(Back End Of Line) 的金屬線阻值 (R)與低-k 介電材料的電容 (C)和Gate delay:

Gate delay =device RC delay
Interconnect delay =wiring RC delay

Gate RC vs. Interconnect RC:

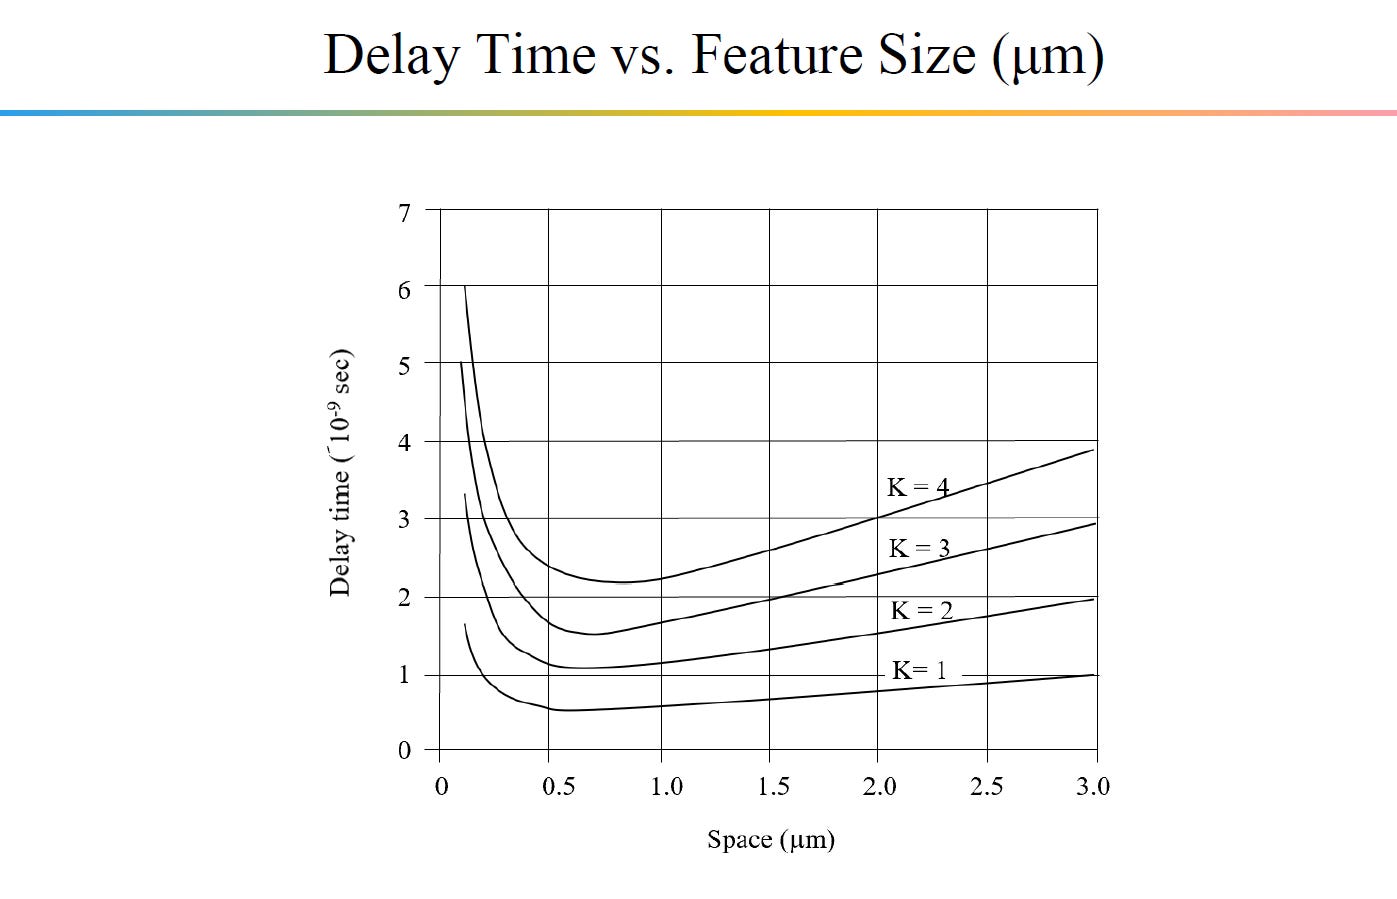
介電質K值的影響
HKMG(High-k Metal Gate)對Gate delay的影響
HKMG 的 High-k 材料雖然增加了 Cox,看似會增大電容,但同時提升了驅動電流、降低了 MOSFET 的 on-resistance,最終使 Gate delay 減少(參考上面slide推導):

其關鍵在於:High-k 可在物理厚度較厚時仍維持小 EOT(Equivalent Oxide Thickness),兼顧低漏電與高性能,因此比傳統 SiO₂ 更能縮短 Gate delay。

3.3. Metallization的選擇
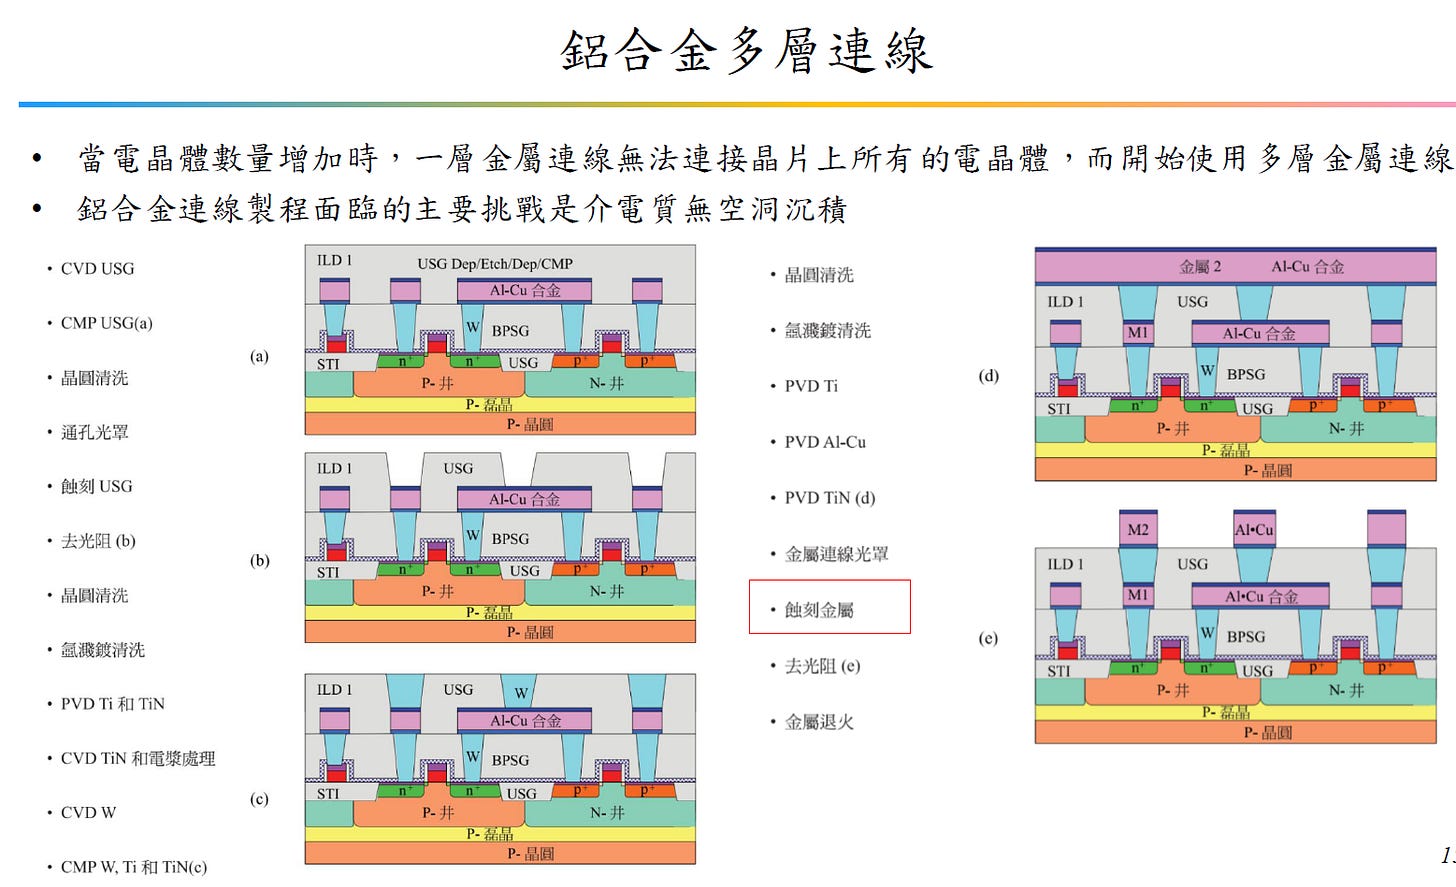
早期金屬化用Al,因為容易蝕刻、製程成熟;但Cu電阻更低、可靠度更好。由於 Cu 難以蝕刻且會汙染矽,必須依靠Damascene + CMP + barrier技術,才在 0.25 µm 節點開始取代 Al,降低RC delay。雖然 Ag 導電性最好,但 擴散 + 電遷移 + 製程不相容,使它不適合作為 IC 金屬化材料。

為什麼最初選用 Al
製程相容性:Al 容易蒸鍍、濺鍍,並且能以乾蝕刻形成線路 → 適合當時的光刻/蝕刻技術。
良好導電性:雖然電阻率高於 Cu,但在微米級線寬下差異不算致命。
可靠度:加上1% Si可防止 Al 與 Si 接觸處產生「spiking」,提升接點穩定性。
工藝簡單:減成式(subtractive)蝕刻即可完成,搭配 Ti/TiN 作為黏著層與阻擋層即可。
Al 面臨的限制
隨著製程進入亞微米(sub-micron):
RC 延遲變大→ Al 電阻率較高,線寬縮小後導線電阻急遽增加。
電遷移 (Electromigration) 嚴重→ 高電流密度下 Al 原子易移動,導致空洞或斷線。
多層互連需求→ IC 從單層金屬 → 多層金屬,Al 電阻不足以支撐 GHz 時脈。
Cu 的導入(1990s 後期)
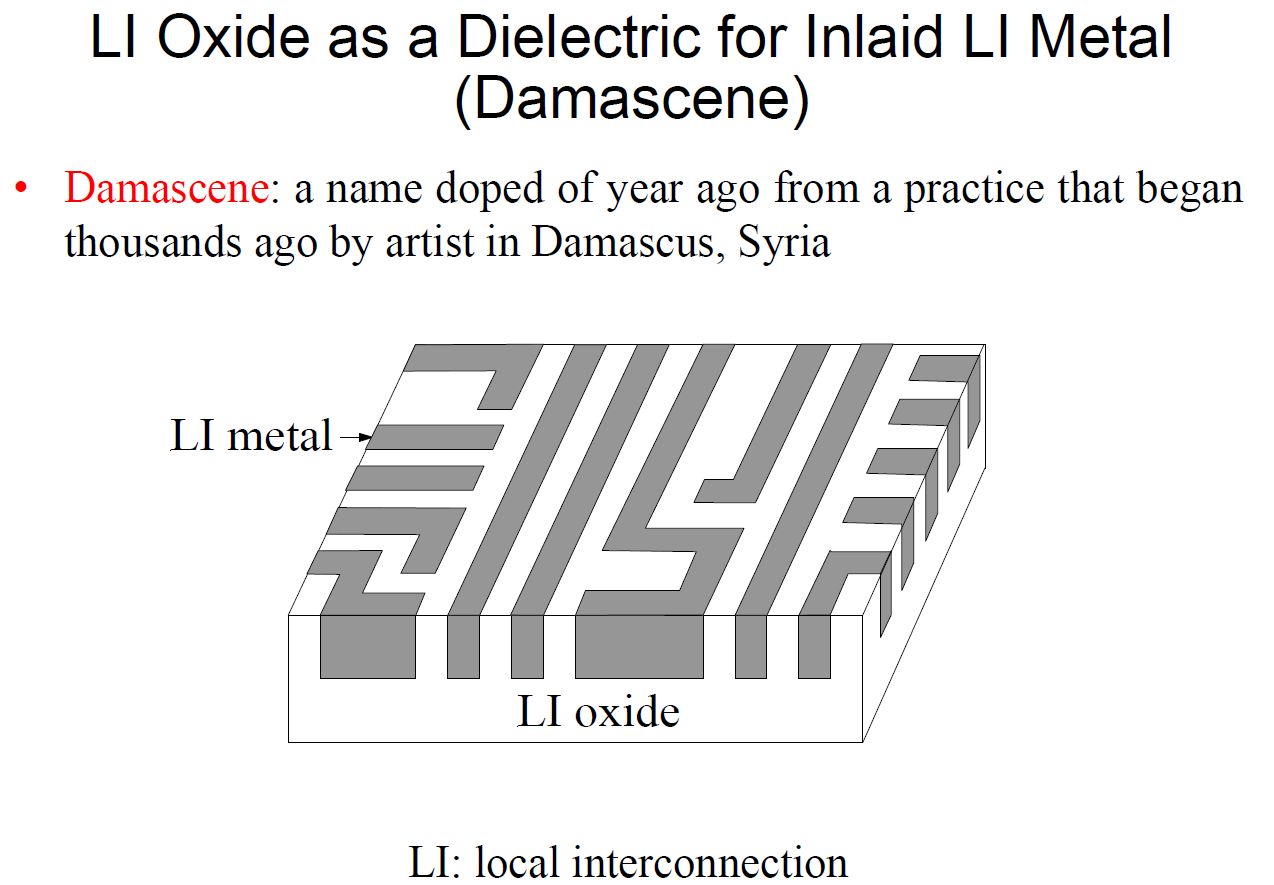
IBM 在 1997 年率先導入 Cu,並以dual damascene工藝實現。
優勢:
電阻率降低 ~40%,RC 延遲顯著改善。
電遷移耐受性更好 → 高電流下壽命延長。
與低-k 材料(SiCOH 等)結合,整體互連延遲更低。
Cu 帶來的製程挑戰
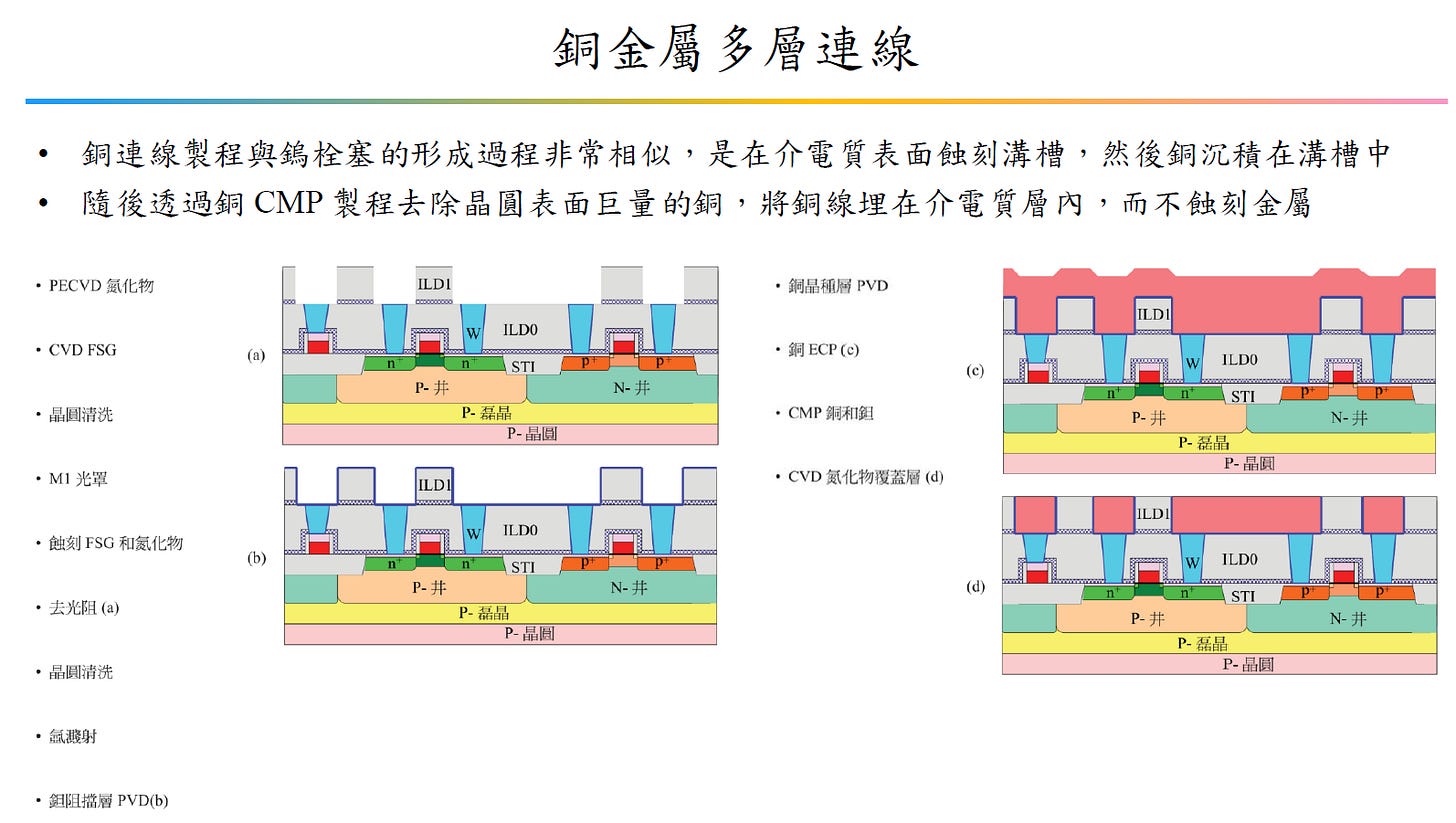
不能乾蝕刻:因此改採「加成法(damascene)」→ 先刻介電,再電鍍填充。
容易擴散:Cu 原子會快速擴散到 Si 與 SiO₂ 中 → 需要 Ta/TaN/Ru/Co 等阻擋層。
整合複雜:電鍍 + CMP → 較高的製程成本與複雜度。
導線連接層的範例

3.4. Dielectric 的選擇
互連介電材料最早用SiO₂ (k≈3.9),後來為降低 RC 延遲,先改為FSG (k≈3.5),再進一步導入SiCOH low-k (k≈2.7–3.0)。隨著節點演進,又採用多孔 SiCOH (ELK, k≈2.2–2.5),但機械強度不足。近年則在關鍵金屬層引入Air Gap (k≈1.0),並探索聚合物與新型多孔材料。

圖中ILD(Inter-Layer Dielectric)是晶片金屬層間的絕緣層,用於隔離金屬、降低RC延遲並維持可靠性。
SiO₂ 時代
傳統介電層:SiO₂,介電常數 k ≈ 3.9。
優點:熱穩定性高、機械性質佳、成熟的製程兼容性。
缺點:隨著金屬線 pitch 縮小,RC 延遲 (wire delay)成為瓶頸 → 必須降低 k。
Low-k 材料 (SiCOH)
主流 Low-k:SiCOH(碳氫摻雜矽氧化物),k ≈ 2.7–3.0。
作法:在 PECVD 製程中引入有機基團 (–CH₃) 取代部分 –OH,降低極化。
優點:與 Cu damascene 相容、機械強度尚可。
缺點:仍偏高,RC 延遲問題未徹底解決。
Extra/Extreme Low-k (ELK)
ELK:Porous SiCOH,k ≈ 2.2–2.5。
方法:在 SiCOH 中引入孔洞 (porosity),以降低有效介電常數。
優點:k 值顯著降低。
缺點:
機械強度降低(孔洞使結構脆弱,CMP/封裝難度大)。
吸水性高→ 增加漏電與可靠度風險。
整合挑戰:plasma 損傷、密封孔洞困難。

關於銅製程和low-K材料,可以參考”學習隨身聽Learning Everywhere”,有一篇”【晶片演進史】從鋁到銅/Low-K:改變晶片效能的關鍵技術!”(NotebookLM整理),鏈結在Reference。
3.5.半導體與CCL low-k 材料的比較
整理半導體(semi)low-k 材料與CCL(copper clad laminate, 銅箔基板)low-k 材料的比較,方便理解兩者差異:
使用場域
Semi low-k
應用於IC BEOL(Back-End-Of-Line)金屬互連層的介電材料。
典型為SiCOH(Si–C–O–H 系 amorphous oxide)、多孔 SiCOH(ELK),再到新一代 air-gap 結構。
目標是降低 RC delay、抑制功耗、提高速度。
CCL low-k
應用於封裝基板 / PCB (package substrate, high-speed PCB)。
材料多為有機聚合物(epoxy resin、BT resin、polyimide、PTFE…),並摻入填料。
目標是降低訊號傳播延遲、提升高速訊號完整性(SI)。

機械性質與可靠性
Semi low-k
多孔化會導致脆性增加、熱機械強度下降。
必須克服CMP 損傷、金屬應力、封裝熱循環。
CCL low-k
聚合物材料天生柔軟,有一定韌性,但吸水率與熱膨脹係數 (CTE)較高。
PTFE 雖然 k 低,但軟且難加工,需要加強填料或玻纖布。
為何兩者不能共用
半導體 low-k (SiCOH/ELK)無法用在 CCL:
太脆,無法承受PCB 鑽孔 / 壓合 / 熱循環。
成本過高,且不適合大面積基板製造。
CCL low-k (PTFE, LCP)無法用在 IC BEOL:
熔點 / 玻璃轉移溫度太低,無法承受>400 °C 的 BEOL 製程。
無法與金屬互連達到nm 級圖形控制。

4. Chiplet and Heterogeneous Integration(HI)
4.1. TSMC HI Roadmap
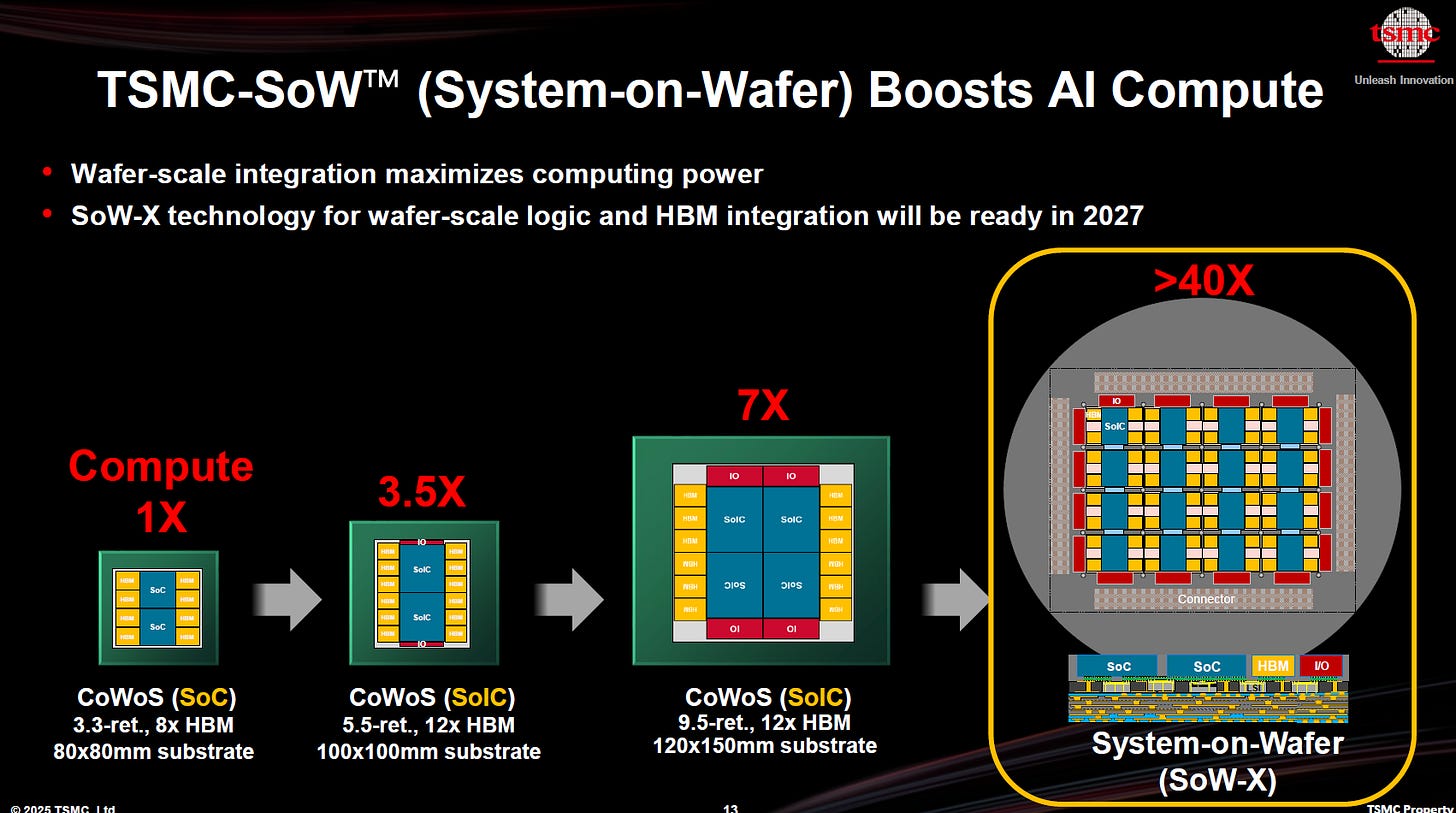
CoWoS:
單顆大 GPU die(如 Blackwell B200 ~104B Tr.)+ 多顆 HBM。
做到 9.5 reticle,大約可以到 0.5–1Ttransistor 級別。
SoW-X:
Wafer-scale system,可放進數十顆 SoC + 數十顆 HBM。
理論上可承載 10–100T transistor
可看作是CoWoS 的終極版,跨越了 reticle 與 substrate 尺寸的瓶頸。
4.2. 未來目標
GTC 2025以 wafer 為背景,展示一個「虛擬集成系統」(Grace Blackwell NVLink72) 的概念。

130T (130 萬億) Transistors ?
單一Blackwell GPU(B200 die)大約在104B(千億級)transistor 左右(用 N4,reticle size 約 850mm²,實際利用率 ~510mm²,密度 ~180MTr/mm²,之前也算過)。
這裡展示的「Grace Blackwell NVLink72」系統,是把72 顆 GPU + 18 顆 NVLink switch + 2592 Grace CPU cores + 576 HBM + 72 NIC + 18 DPU全部算進去,把整個系統級(System-scale)的 transistor 數量相加。
這張圖裡的130T,更像是一個「marketing 數字」+ 未來目標的宣示,告訴完整 virtual AI superchip 已經達到百萬億transistor 的規模,未來藉由SoW-X工藝實現。
[Reference]
https://www.opencompute.org/events/past-events/2025-ocp-apac-summit#keynotes
放大20万倍,这是3纳米芯片最深层的秘密【玄戒O1解剖报告】
從鋁到銅/Low-K:改變晶片效能的關鍵技術!
Support Ted Yu
Launched a year ago
Master in EE EE experience more than 20 years, including BB CPE, 5G wireless, high speed data, ..., etc. Now focusing on communication of data centers
Pledge your support
